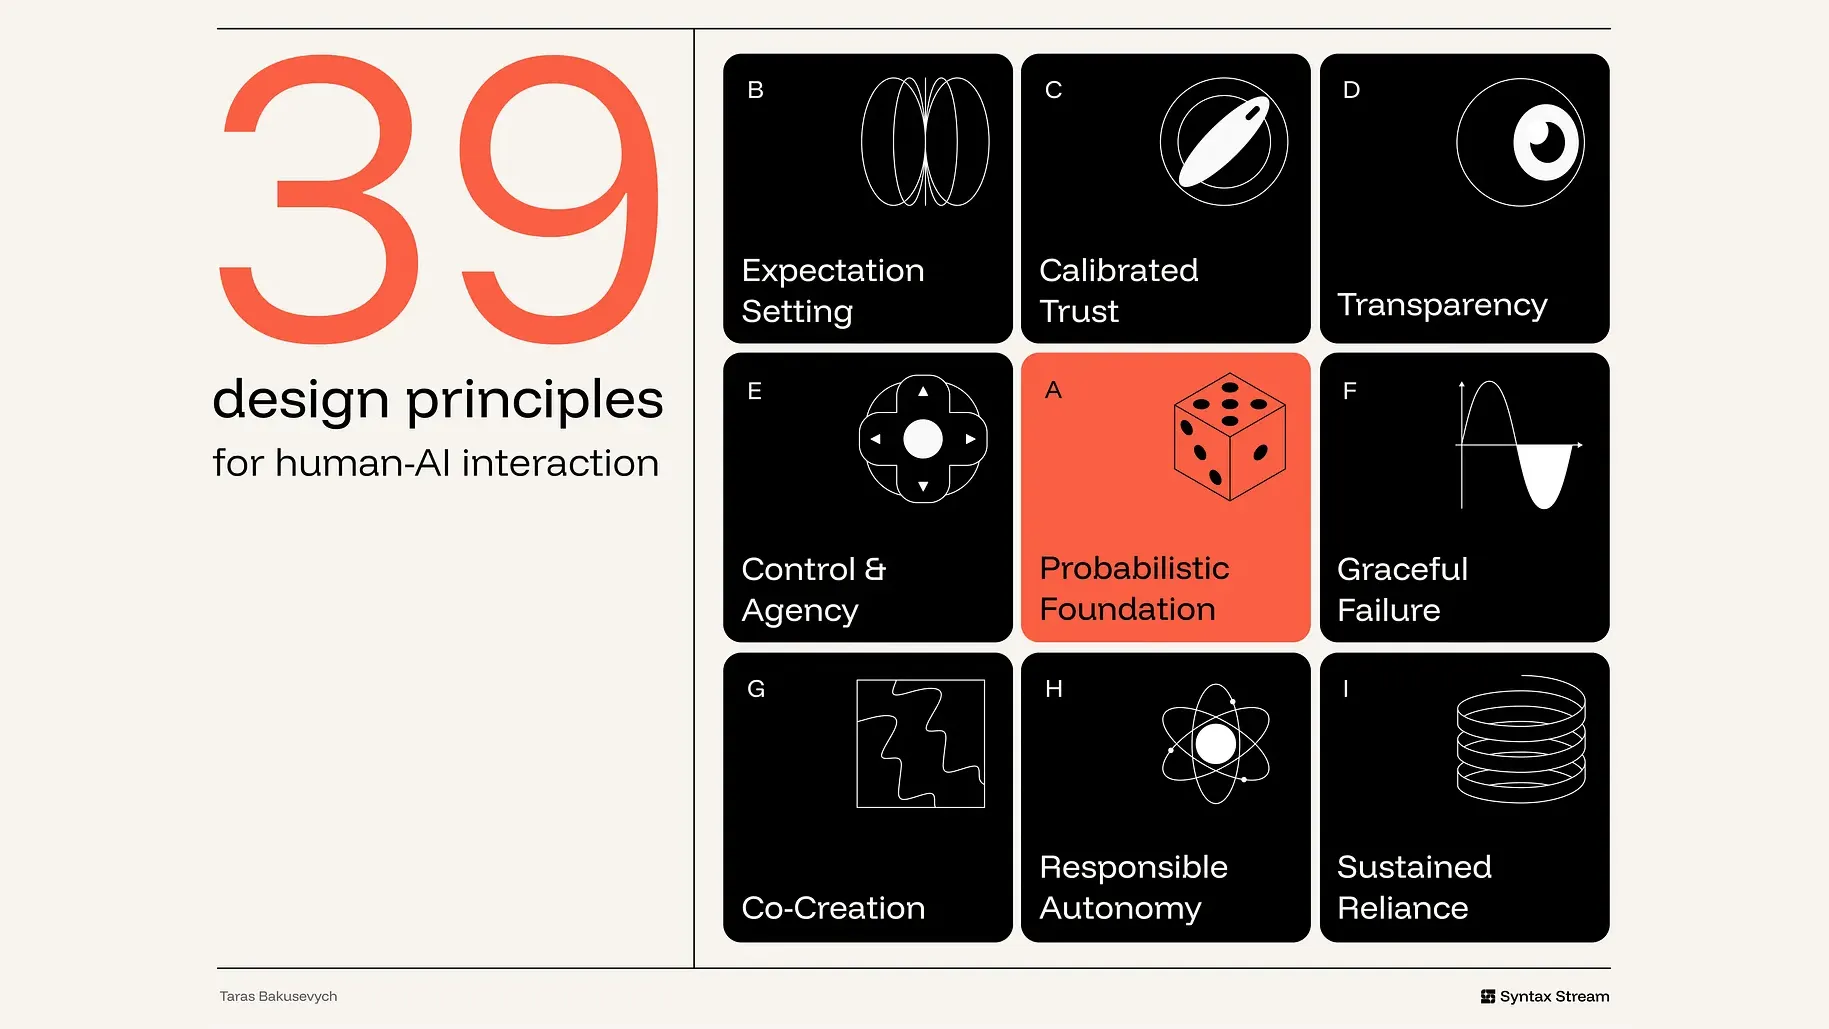
AI製品デザインにおける最大の難題:39のヒューマンAIインタラクション設計原則
デザイナーのTaras Bakusevychが、ヒューマンコンピュータインタラクション(HCI)、混合イニシアチブ(Mixed-Initiative)システム、自動化への信頼に関する諸研究を統合し、39のAIインターフェース設計原則を提唱した。本稿ではこれらをマイクロソフトが定義する製品ライフサイクルに沿って再編し、原文の根拠と限定条件を一つひとつ照合した。
- 従来のインターフェースは「ボタンを押せば確定的な結果が1つ返る」ことを前提としていたが、大規模言語モデル(LLM)はそうではない。同じモデルでもインターフェースが異なれば、優れたアシスタントにも危険なブラックボックスにもなり得る。製品の体験はモデルの性能だけで決まるものではない。
- マイクロソフトの18のガイドラインは、ヒューマンAIインタラクションを「使用前」「使用中」「AIが誤ったとき」「時間経過に伴う変化」の4段階に分類し、「AIが誤ったとき」の重みが最も高いと指摘している。AIにおいてエラーはエッジケースではなくデフォルトの状態だからである。本稿はこの4段階に沿って39の原則を再編しているため、原文の番号を踏襲した結果、番号の跳躍が生じる。
- すぐに実践できる4つの具体策:画面上の「答え」という表現を「下書き」に変える。結論に出典の上付きインデックスを付与し、確認コストを一瞥で済むレベルまで下げる。可逆性に応じてAIのアクションを自動実行、通知、チェックポイント、人間主導の4段階に分ける。空の入力欄にはテンプレートを配置し、ユーザーが空白を前に途方に暮れないようにする。
- 原文にも不十分な点はある。「依存関係が健全であるかを測定する」原則では、従来の指標の多義性を指摘するにとどまり、代替指標を示せておらず、全文の中で唯一製品事例が記載されていない項目となっている。
デザインの専門家であるTaras Bakusevychが、SubstackにてヒューマンAIインタラクションに関する長文記事 39 Principles for Designing Human–AI Interaction(ヒューマンAIインタラクション設計のための39の原則)を発表した。この記事は、大規模言語モデル(LLM)を製品に実装する際のインタラクションの骨格を整理し、現在のAI製品デザインが直面している最大の難題を浮き彫りにしている。すなわち、「私たちは『確定的(デターミニスティック)』なソフトウェアの設計に慣れ親しんできたあまり、『確率的(プロバビリスティック)』な統計システムを前にして途方に暮れている」という現実である。
従来のソフトウェアのインターフェースは確定的である(同じボタンを押せば常に同じ結果が得られる)。その根底にある前提は振る舞いの予測可能性だ。ボタンには固定された関数が結びつき、ワークフローの状態は明確で、エラーは事前に網羅して回復できる。しかし、大規模言語モデルの本質は確率統計システムであり、同じ入力に対してもタイミングによって全く異なる出力が返される可能性がある。同一のモデルであっても、組み合わせるインターフェースや誘導方法次第で、効率的なアシスタントにもなれば、危険に満ちたブラックボックスにも感じられる。製品の最終的な体験は、決してモデル単体の基本性能だけで決まるものではない。したがって、AI製品デザインの中核的な課題はもはや絶対的な完璧さを追求することではなく、「ユーザーがAIを適切に信頼し、活用できるように支援すること(Appropriate Reliance:適切な依存/依拠)」にある。
この変化は、従来のインターフェース設計規範では到底答えを出せない問いを突きつけている。
- システムはいつ能動的に提案し、いつ問いかけを行い、いつ直接実行に移るべきか?
- 不確実性を画面上でどのように表現すれば、ユーザーの盲従や完全な不信・放棄を防げるのか?
- 1つの回答を生成する際、どの程度の根拠を添えるべきか?
- AIの自律性が高まるにつれ、リスクの高低に応じてどのようにアクションの境界線を引くべきか?
これらは決して瑣末なビジュアルの装飾ではない。ユーザーが出力の品質を正確に判断できるか、エラーから円滑に回復できるか、そして極めて重要な意思決定に直面した際にも人間が真のコントロール権を保持し続けられるかを決定づける要素である。
このデザイン体系全体の究極のテーマは1つしかない。「いかにしてユーザーとAIの間に『適切な依存』を構築するか?」。脆弱な生成結果を盲目的に過信することもなければ、数回の失誤によって完全に製品を放棄することもない、健全な関係性の構築である。
理論的源流:ヒューマンAIインタラクションにおける4つの礎石の上に立つ
このフレームワークは突如として生み出されたものではなく、ヒューマンコンピュータインタラクション(HCI)、混合イニシアチブシステム、自動化への信頼(Automated Trust)、説明可能AI(XAI)、責任あるAI(Responsible AI)の各領域における既存の研究に深く根ざしている。原文では、これら39の原則を支える4つの核となる思想的源流を整理している。

-
フロンティアモデルの行動規範
OpenAIの Model Spec やAnthropicの Claude Constitution に代表される規範である。これらは画面インターフェースではなくモデル深層の生成挙動を制約するものだが、システムの本質を誠実に提示すること、商業的意図の隠蔽を拒絶すること、人間の最終的な監督権を担保することなどの面において、従来のHCI古典が触れてこなかった空白を埋めている。 -
混合イニシアチブ・インタラクション(Mixed-Initiative Interaction)
Eric Horvitzが1999年に打ち立てた理論的礎石に由来する。人間と機械が意思決定権を共有する協調プロセスとしてヒューマンコンピュータインタラクションを捉え、システムが「いつ自律的に実行すべきか」「いつ提案にとどめるべきか」「いつ身を引くべきか」「いつ明確化のための質問を投げかけるべきか」を判断するための厳密な方法論的支柱を提供した。 -
業界の実践ガイドライン
Googleの PAIRガイドブック(People + AI Research Guidebook)やIBMによる生成AIの6大原則である。これらはエンジニアリング実践における直接の参照軸となっている。すなわち、実際のユーザーニーズから成功基準を定義すること、事前に期待値を設定すること、データソースを透明に開示すること、変動性を受け入れること、人間と機械の共創を中心にデザインを組み立てること、そして生成システムの不完全性に十分備えることである。 -
マイクロソフト:ヒューマンAIインタラクションの18のガイドライン(Microsoft 18 Guidelines for Human-AI Interaction)
マイクロソフトはヒューマンAIインタラクションを4つの自然なフェーズに区分した。使用前(Before use)、使用中(During use)、AIが誤ったとき(When the AI is wrong)、時間経過に伴う変化(Over time)である。この中で最も高い重み付けがなされているのが「AIが誤ったとき」である。AIシステムにおいて、エラーはたまに起きる例外的なエッジケースではなく、システム運用の標準的な常態(デフォルト状態)だからである。
本稿はマイクロソフトが明かしたこの客観的法則に沿い、単調な羅列を排して、原著者が提唱した9つの次元・39のデザイン原則を、AIの製品ライフサイクル全体を貫く設計とガバナンスのネットワークとして再構築する。(注:照合・参照の便宜を図るため、以下の各原則は原著者の元の番号を厳密に保持している。ライフサイクルに沿って再編したため、番号に跳躍が生じているが、内容の欠落ではない。)
中核フレームワーク(The Framework)
インターフェースの責務は、システムの介入度合いを明確にし、ユーザーが重要な出力を理解・検証できるように支援し、常にコントロール権を保持させ、誤り訂正をサポートし、影響の大きなシナリオにおいて自律権を厳格に制約することにある。著者はこれらの責務を9つの次元に分類している。
- 確率的基盤(Probabilistic Foundation):推論、生成、そして変動性のためのデザイン。
- 期待値設定(Expectation Setting):能力、限界、およびAIの介入度合いを早期に明示する。
- 信頼のキャリブレーション(Calibrated Trust):ユーザーの依存の度合いをシステムの信頼性に合致させる。
- 透明性(Transparency):必要なときに推論ロジックと根拠を検証可能にする。
- コントロール権と主体性(Control & Agency):受容、却下、編集、取り消し、およびオーバーライド(手動介入)を簡単かつ直接的なものにする。
- 優雅な失敗(Graceful Failure):不確実性、エラー、および人間へのエスカレーションからの回復を可能にする。
- 協調的共創(Co-Creation):生成結果を最終決定ではなく「下書き」として扱う。
- 責任ある自律性(Responsible Autonomy):影響の代償、可逆性、および権限付与に基づいてシステムの行動を制約する。
- 持続的な依存のガバナンス(Sustained Reliance):時間の経過とともに品質、ドリフト、説明責任の所在、およびシステムの変更を持続的にガバナンスする。
中核となる前提:確率的基盤
大規模言語モデルの振る舞いは、ハードコードされたプログラムロジックというよりも、確率分布を出力する確率的サービスに近い。インターフェースにとっての至上命題は、このバラつきや変動に逆らうのではなく、それらを前提としてデザインすることである。
1. AIが相対的な優位性を持つシナリオでのみ使用する
AIが最も強みを発揮するのは、入力が曖昧で意図が不明確な場合、無から有を生み出すコンテンツ生成が必要な場合、あるいは膨大な情報を横断して要約・帰納する場合である。逆に、絶対的な精度、厳密な再現性、または確定的制御が求められるタスクでは、AIのパフォーマンスは往々にして最も悪くなる。
プロダクトの対比:プロジェクト管理ツール Linear は、文脈や曖昧なセマンティクス(文脈的意味)を多く含む部分にAIを導入している。例えば、長大なディスカッションの要点抽出、重複・関連チケットの検出、トリアージの支援、ワークスペースの履歴を横断したQ&A検索などである。しかし、真に正確性と信頼性が要求されるモジュール——ステータスの遷移、担当者の割り当て、優先度、開発サイクル、権限、およびワークフローの中核的状態——においては、確定的な従来のUIコントロールを一貫して厳格に維持している。
2. 生成の多様性のためにデザインし、変動性に抗わない
企画立案や研究課題の定義といった探索的・生成的なタスクでは、同一のプロンプトから完全に許容可能でありながら方向性の全く異なる複数の回答が生成されることがある。このような多様性は欠陥ではなく、多くの場合それこそがAIの価値そのものである。

インターフェースは、1回の出力を唯一の最終決定とみなすことをユーザーに強いるのではなく、この変動性を活用できるように設計されるべきである。有効な手法としては、複数の生成ドラフトの提示、再生成アクション、代替案の保存、バージョン履歴、並列比較、および直接編集などが挙げられる。執筆、ネーミング、ビジュアルデザイン、アイデア出しなどの探索的タスクでは、完璧に見える単一の答えを提示するよりも、複数の道筋を直接提示する方がはるかに価値が高い。これにより、ユーザーは「単一の結果を受動的に良し悪し判断する」姿勢から、「異なる方向性を横断的に比較し、必要に応じてブラッシュアップする」姿勢へと移行できる。
プロダクトの対比:Midjourney はプロンプトに対して毎回4枚の候補画像からなるグリッドを固定で返し、確率的な変動をユーザーにとっての比較と選択の空間へと巧みに変換している。
3. タスクの特性に応じてインタラクション形態を一致させる
すべてのAI機能を無理やり対話ダイアログ(チャットボックス)に押し込んではならない。インタラクション形態は、ユーザーの入力モード、中核的な目標、および出力結果に伴う影響の代償と正確に一致させる必要がある。要求がオープンであるほどインターフェースは明確化と反復をサポートすべきであり、結果の影響が大きいほどインターフェースは精査とコントロールをサポートすべきである。
- 軽量で低リスクなタスク:AIはインラインの提案やスマートなデフォルト値という形で暗黙的に現れるべきである。
- 探索的・発散的なタスク:マルチターンの対話が、継続的なやり取りを通じてユーザーの曖昧な意図を徐々に明確化するのに役立つ。
- マルチステップまたは高影響のタスク:システムは実行計画、チェックポイント、確認のタイミング、および明確な停止・取り消し・ロールバックの経路を提供しなければならない。

プロダクトの対比:Notion は、本文の段落に対する迅速なリライトをテキスト行内で直接呼び出せるようにし、一方でオープンエンドな複雑な質問はサイドバーの専用対話型AIパネルへと誘導している。
第1フェーズ:インタラクション発生前(合理的な期待値の確立とシステムの可視化)
ユーザーは、モデルが生成した最初の1行を読むよりも前に、すでに頭の中でシステムに対する期待を形成している。この期待がシステムの実際の能力と乖離していれば、混乱や失望は避けられない。
次元:🪧 期待値設定(Expectation Setting)
4. システムができることを宣言し、それ以上にその限界を宣言する
能力だけを述べて境界を定めないのは不完全である。ユーザーは、システムが何を支援するために設計されているかを知る必要があるだけでなく、精度、網羅性、または信頼性の面でどのような限界を抱えているかを明確に把握する必要がある。

プロダクトの対比:ChatGPT は自身を汎用的なアシスタントと位置づけ、質問への回答、ドラフト作成、要約、推論を得意としている。しかし、アクセス権を持たない外部リソース——例えばローカルファイル、個人のメール、カレンダー、ワークスペース、リアルタイムの外部Webページ、プライベートシステムなど——に依存するタスクについては、そうしたデータを呼び出す権限がないことを明確に説明しなければならない。
5. 「白紙のキャンバス」問題に対処する
何もない空の入力欄はユーザーに何の有効なシグナルも伝えず、かえって経験の浅いユーザーを途方に暮れさせる。

最初の一歩のハードルを下げるためにガイダンス要素を用いるべきである。プロンプトの例、推奨される操作、テンプレートのプリセット、入門的な質問、最近のタスク、あるいは構造化された入力フォームを提供する。優れたガイダンス要素は、AIの実際の能力範囲を示すこと、操作開始時の認知的摩擦を大幅に低減すること、そしてユーザーが心の中に抱く曖昧な意図をより構造化して表現できるように支援すること、という3つの役割を果たす。
プロダクトの対比:Canva Magic Design は、ユーザーがプロジェクトの説明を入力した瞬間に、キャンバス上にさまざまなレイアウトのプリセットテンプレートを直接展開し、空白のページを前にアイデアを練る無力感を解消している。
6. 出力物を「終着点」ではなく「出発点」と位置づける
生成結果に対するインターフェースの命名や提示方法は、ユーザーがそれをどのように扱うべきかを直接暗示する。「下書き(Draft)」、「提案(Suggestion)」、「要約(Summary)」、「推奨(Recommendation)」、「初期レビュー(Review)」といった表現を用いることは、その成果物が精査、調整、推敲を必要とするものであることをユーザーに明確に伝える。反対に、安易に「答え(Answer)」、「完了(Complete)」、「終了(Done)」と名付けることは、システムが本来持つべきではない確実性と終局感を暗示してしまう。
プロダクトの対比:Gmailに内蔵されたGemini機能は、メール作成を支援するものを「下書き(Draft with Gemini)」と位置づけており、直接送信できる完成原稿とは定義していない。これは、ユーザー自身が通読し、修正を加え、最終的に自ら送信ボタンを押す必要があることを明確に意味している。
7. AIの関与を明示的にラベリングする
コンテンツがAIによって生成、要約、再構成、並べ替え、または推奨されたものである場合、ユーザーが一目で識別できるようにすべきである。同様に、画面上のどのコンテンツが完全に人間によって執筆されたものか、どれが無修正の生データか、どれがシステムによって生成された解釈であるかを明確に把握できる必要がある。AIの関与を密かに隠すことは重大な責任の曖昧化を招き、ユーザーが生成モデルの捏造した要約を一次情報源そのものだと誤認することにさえつながる。

プロダクトの対比:Meta は、Facebook、Instagram、Threadsにおいて、完全にAIによって生成された画像、動画、投稿、あるいは大幅なAI編集が施されたものに対して一律で AI info ラベルを付与し、それらのコンテンツが純粋な人間の創作や実際のレンズを通じた撮影ではないことを視聴者に注意喚起している。
8. ユーザーの専門度に応じて説明の深さと制御権限を適合させる
インターフェースがどれほどの透明性を提示し、どれほどの介入摩擦(確認の手間)を設け、どれほどの自律権を付与すべきかは、現在それを使用しているのが誰であるかによって異なる。
- 初級ユーザー:十分なガイダンスと強固なセーフティガードレールを必要とする。
- 専門家:プロセスの深い精査、手動オーバーライド機能、きめ細かなパラメータ設定を必要とする。
- コンプライアンス監査人:完全なアクティビティログ、出所追跡のメタデータ、再現検証可能な環境を必要とする。
プロダクトの対比:GitHub Copilot において、初心者は複雑な設定を一切必要とせず、キーを1回押すだけで完結するグレーのゴーストテキスト補完を利用できる。熟練エンジニアはエージェントモード(Agent Mode)に入り、推論モデルを自律的に切り替えて詳細な指示を設定できる。一方、企業の管理者やコンプライアンス監査人には専用の管理ダッシュボードが用意され、提案の採用率や組織レベルのコードポリシーログを監査できるようになっている。
9. システムの本質を誠実に提示し、過度な擬人化を厳禁する
システムが感情、個人的な経験、人間的な判断力、あるいは本来備わっていない認知能力を持っているかのように暗示しては絶対にならない。確率システムを過度に人格化することは、エンジニアリング上到底責任を負えない高い期待をユーザーに抱かせるだけでなく、人間と機械の責任の所在を完全に曖昧にしてしまう。あたかも共感力を持つ人間と対話しているかのようにユーザーに錯覚させるが、実際に対峙しているのは特定の設計に従って動作する限界の明確な統計システムに過ぎない。システムには、偽りの人格の偽装ではなく、明確で実用的な役割が与えられるべきである。

アンチパターン(反面教師):ライアンエアー(Ryanair) は、画面上でRYTAを「AI旅行アシスタント」と誠実に表記していたものの、その後の設計で境界を完全に踏み外した。アシスタントに実在の人間の顔写真アイコンを配し、一人称かつ主観的な言い回し(例:「私は〜すべきだと思います」)を用い、フライト遅延の最新情報案内では架空のスタジオから本物そっくりのAI「バーチャルニュースキャスター」に状況を報道させた。このデザインは背後にある統計システムを過度に擬人化し、生身の人間による専門の運行チームがリアルタイムでサポートしているかのような誤解を乗客に与えた。このような錯覚は責任の所在を著しく希薄化させ、その語り口の裏には往々にしてアップグレードサービスの購入を促すアップセルが潜んでいた。
次元:🔍 透明度(Transparency)
ブラックボックスのシステムは合理的に信頼されることがない。ユーザーがシステムの信頼性を検証する手がかりを一切見出せないからである。インターフェースの役目は、推論ロジックを検証可能にクリアにしつつ、選別されていない生のログ情報でユーザーの注意力を埋没させないことにある。
16. 理解可能性に関する5大中核疑問に答える
透明性が低すぎるとユーザーは根拠のない推測に陥り、高すぎると大量の視覚的ノイズを生み出して検証のコストをユーザーに強いることになる。デザインは、ユーザーがAIの生成物に直面した際に抱く最も重要な5つの疑問に的確に応えなければならない。
- このAIは先ほど具体的に何をしたのか?
- どのような情報を根拠として使用したのか?
- なぜ現在のような結果を出力したのか?
- なぜ別の選択肢を選ばなかったのか?
- ユーザーが入力を変更した場合、結果はどう変化するのか?

プロダクトの対比:開発プラットフォーム Base44 は、AIエージェントの各ステップの操作を明確に検証可能にしている。インターフェースには、エージェントがどのコードファイルを作成し、どのコンポーネントを導入し、どのデータレコードを変更したかが明記され、これら一連のアクティビティログが右側のアプリのリアルタイムプレビューと連動する。ユーザーは生成を続行するか公開ボタンを押すかを決める前に、システムの動作と変更の実質を一目で確認できる。
17. 段階的開示(プログレッシブ・ディスクロージャー)を用いて説明を提示する
説明は階層化して提供されるべきである。メインのワークフローには、意思決定を支援するのに十分な、最も簡潔で重要な情報だけを載せるべきだ。簡潔な理由、主要な情報源、実行ステータス、重要な警告、あるいは信頼度の手がかりなどである。ユーザーがより深く精査したい場合にのみ、必要に応じて深層の情報を展開できるようにする。計算手法、前提条件、完全な参考文献、ツールの呼び出し軌跡、モデルの限界に関する説明、完全なプロセス履歴、ライフサイクル全体の監査ログなどである。
プロダクトの対比:Arc Search の Browse for Me 機能は、初回表示時には簡潔な要約結果のみを提示するが、下部には常に詳細を確認するための展開可能な導線が用意されており、掘り下げて確認したいユーザーが検証できるようになっている。
18. マルチステップ操作に対して計画と実行の軌跡を提示する
AIエージェントが複数のステップにわたって推論と操作を行う場合、インターフェースはそれらのステップをリアルタイムでレンダリングしなければならない。目に見える実行計画は、システムが「今どのように進めているか」「なぜそうしているのか」にその場で答え、システムが誤った方向に進み始めた際にユーザーが早期にブレーキを踏めるようにする。実行前に行動計画を提示し、実行中には有意義な動的進捗(どのステップが完了したか、どのツールが呼び出されたか、どのデータが読み取られたか、どのような判断が下されたか、どの高リスクなアクションが人間の承認を待っているか)を示し、実行後にはどの資産が変更されたかを説明し、明確な取り消しまたは再確認の導線を提供する。

重要なマルチステップのタスクを実行するエージェントを、静かに回転するローディングアニメーションの背後に隠しては絶対にならない。
プロダクトの対比:Cursor のPlanモードでは、エージェントはコードを書き始める前に要求を具体的な実装ステップへと分解し、変更が予想されるファイルやシステムモジュールを明確にリストアップして、コードベースが実際に変更される前にエンジニアが計画を精査・調整できるようにしている。これにより、エージェントの作業軌跡が最も価値あるタイミングで可視化される。
第2フェーズ:インタラクション進行中(コントロールの保持と人間と機械の協調)
混合イニシアチブシステムにおいては、人間と機械が共にステアリングを握っている。インターフェースのルールは極めて明快である。人間が操作を引き継ぎたいと思った瞬間、コントロール権は摩擦なくシームレスに返還されなければならない。
次元:🎛️ コントロール権と主体性(Control & Agency)
19. 提案を受け入れやすくし、それ以上に無視しやすくする
AIからの提案は、ユーザーの作業フローを中断させてはならない。受け入れ、無視、部分的な修正、取り消し、再生成、完全な差し戻しのいずれであっても、作業のリズムを崩すことなく完了できるべきであり、何層ものモーダルウィンドウやドロップダウンメニューを探し回るのではなく、できればキーを1回叩くだけで済むのが理想である。AIの提案を拒否するためのコストは、ほぼゼロでなければならない。 この点は、アクティブな作業スペースに直接埋め込まれる高頻度の提案(コード補完、文章の続きの提案、スマートフィルなど)において特に決定的な意味を持つ。

プロダクトの対比:GitHub Copilot では、グレーのゴーストテキストが表示された後、Tab を押せば受け入れられ、不要な場合は Esc を押すかそのままキーボード入力を続ければ提案は即座に消え、コーディングの思考が中断されることはまったくない。
20. 重大な曖昧さがあるときは能動的に質問し、盲目的な推測を避ける(ただし過剰な割り込みは厳禁)
システムが安全な範囲内で曖昧さを解消できない場合、自信満々な誤った答えを出すよりも、簡潔で具体的な確認の質問を1つ投げかける方がはるかに優れている。Horvitzの協調インタラクション原則に従い、モデル自身が解決できない不確実性を対話によって解消すべきである。優れた質問は極めて具体的であるべきであり(例:「どちらのアカウントに適用すべきですか?」)、「より多くの背景情報を教えていただけますか?」といった空虚な要求であってはならない。

ただし、ここには極めて重要な逆の制約がある。確認の質問をデフォルトの動作にしてはならない。現在の曖昧さが低リスクであったり、修正が極めて容易であったり、最終結果に実質的な影響を与えない場合は、システムは直接処理を続行し、同時にどのような仮定を置いたのかをインターフェース上に明示すべきである。
プロダクトの対比:Claude は、曖昧さが最終的な出力に実質的な変化をもたらす場合にのみ質問を投げかける。やたらと推測するのではなく、現在の曖昧な点を明確に指摘し、ユーザーが選択できる明確で構造化された分岐の選択肢を提示する。
21. グローバルな環境設定とマイクロな単発コントロールを同時に提供する
ユーザーには、目の前にある個別の生成結果を精緻に調整する手段と、AIシステムとの長期的な協調の仕方を規定する手段の双方が必要である。
- マイクロな単発コントロール:その場での単一結果のトーン、長さ、形式、適用範囲、参照元、詳細度を調整したり、選択した特定の段落に対して部分的な再生成を実行したりする。
- グローバルな環境設定:システムの長期的なデフォルトの振る舞いを定義する——システムが記憶してよい内容、アクセス可能なプライベートデータ、継続的に監視できる対象、どのようなトリガー条件で自律的に行動できるか、どのような長期的嗜好を毎回のインタラクションにデフォルトで適用すべきか。

プロダクトの対比:ChatGPT のパーソナライズ設定パネルは、個別のプロンプトとグローバルな長期的設定を完全に切り離している。ユーザーは製品レベルでデフォルトの会話トーン、フォーマットの規範、カスタム指示を事前設定でき、新しい対話を開くたびに背景の要件を機械的に繰り返し入力する必要がない。
22. ユーザーの注意のリズムに合わせて介入する
適切な提案であっても、間違ったタイミングでポップアップすれば単なる邪魔になる。デザインは、集中を妨げる注意のコストと提案そのものの潜在的価値を天秤にかけなければならない。中断によって生じる注意力のコストが、もたらされる実際の利益を上回る場合、システムは自制を保つべきである。タイマーによってランダムに出現し、存在感を誇示するような邪魔者になってはならない。
プロダクトの対比:Gmailの Smart Compose は、ユーザーがメールを入力している最中にカーソルの後ろに静かに寄り添う形でフレーズの補完候補を自然に提示する。補助を提供しつつも、タイピングのリズムを不躾に寸断することは決してない。
23. AIインタラクションのアクセシビリティと知覚可能性を確保する
AI機能の導入によって、プロダクトが元々持っていたアクセシビリティ(支援技術への配慮)を犠牲にしたり損なったりしてはならない。AIによって動的に生成された変更、インラインマークアップ、出典の引用、リスク警告、音声対話、視覚的推論、さらにはエージェントの実行軌跡に至るまで、多様な入力デバイスや支援技術(スクリーンリーダーやフルキーボードナビゲーションなど)を使用する人々、異なる視覚能力を持つ人々、異なる認知負荷に直面している人々が、障壁なく知覚し操作できなければならない。
AI領域におけるアクセシビリティの不全は、往々にして非常に見えにくい。例えば、生成されたテキストが本文を静かに書き換えた際、スクリーンリーダーが視覚障害のあるユーザーに変更を読み上げないケースがある。あるいは、インラインに挿入された引用の上付きインデックスにキーボードフォーカスが全く当たらないケース、完全な音声対話フローが発声できない・話しづらいユーザーを排除してしまうケース、AIが自動生成した画像代替テキスト(alt text)が文章としては流暢であるものの実際には間違っているケースなどである。

プロダクトの対比:専門的な支援アプリ Be My Eyes(および内蔵のBe My AI)では、ボランティアによるリアルタイムビデオ、企業の公式カスタマーサポート、そしてAIによる画像描写が同一アプリ内に統合されている。AIはカメラが捉えた現実のシーンを迅速に画像解析して音声で読み上げる。一方、ユーザーがより高度な判断や権威ある確認を必要とする場合、あるいは安全上のリスクが潜む複雑な現実の状況に直面した場合には、生身の人間のオペレーターへスムーズに引き継ぐ導線が常時用意されている。
(注:Be My Eyesは、マルチモーダル入力と人間によるバックアップを活用して視覚障害者コミュニティに現実世界での支援を提供する完結したプロダクトである。この原則がさらに強調しているのは、主流ソフトウェアの内部にあるAIインターフェース要素——コードの差分比較、上付きインデックス、ステータス通知など——も同様にアクセシビリティの技術標準を満たさなければならないという点である。)
24. システムが誰のルールに従っているのかを明示する
システムの挙動がユーザーの現在の入力以外の外部要因によって制約されている場合、その制約の力学をインターフェース上で可視化しなければならない。制限の原因となっているのは、ユーザー個人の環境設定かもしれないし、企業の管理者ポリシー、基盤となる安全性やコンプライアンスのルール、プライバシーの境界、システム技術上の制約、あるいは商業的なプロモーション配信かもしれない。これらのルールの性質は全く異なるため、ユーザーは今見ている回答が何に起因して導かれたものなのかを明確に区別できなければならない。
プロダクトの対比:Google My Ad Center は、特定の広告がなぜ配信されたのかをユーザーにわかりやすく説明し、パーソナライズ設定の調整を可能にしている。商業的な有料レコメンデーションとオーガニックな検索結果を厳格に区別し、ユーザー体験のどの部分が広告設定によって形作られているかを明快に伝えている。
次元:🤝 人機共創(Co-Creation)
ユーザーは創造的な協働者(コラボレーター)であり、受動的に情報を受け取るだけの存在ではない。生成された結果は、あらゆるフェーズにおいて高い可塑性を保ち続ける必要がある。
29. 生成された成果物の可塑性を保つ
生成されたテキスト、画像、計画、表、コード、要約、デザインカンプは、誕生した瞬間から二次的な加工を施すための「作業用原材料」とみなされるべきであり、変更できない最終成果物とみなしてはならない。

ユーザーは現在のインターフェース上で直接本文を修正したり、一部分を範囲選択してそこだけのリライトを要求したり、特定の断片のみを再構成したり、異なるバージョンを並べて比較したり、全体の構造を変更したりして、現在の状態から作業を前進させられるべきであり、すべてを投げ出してゼロからやり直す必要があってはならない。
プロダクトの対比:Gemini Canvas は、生成されたプレーンテキストを瞬時に対話型のワークスペースへと変換する。ユーザーはドキュメント内で直接文字を入力したり、マウスで特定の段落をハイライトしてGeminiにその部分だけの書き直しを要求したり、長さを縮めたりトーンを調整したり、さらにはフォーマット変換ツールを用いて既存の内容をワンクリックで別の媒体へと再構成したりできる。
30. 探索のペースを落とすのではなく、慎重な判断を促すために「確認の摩擦」を導入する
従来のUX原則は「あらゆる抵抗とフリクション(摩擦)を排除すること」を一貫して提唱してきた。しかしAIの時代においては、ユーザーが意思決定を行い、プランを承認し、外部に公開し、あるいは正式に送信・提出するという重要なチェックポイントにおいて、能動的に「確認のための摩擦」を導入しなければならない。一方で、初期の発散的な探索フェーズでは徹底してスムーズさを保つべきである。重要な節目でユーザーを立ち止まらせて精査させることは、自動化バイアス(Automation Bias:機械の出力を過信・盲従すること)に起因する事故を食い止めるのに効果的である。しかし、発散的な探索フェーズでそのような抵抗を増やすことは、純粋に創造性に対する足枷となってしまう。
プロダクトの対比:Salesforce は、外部の顧客に向けたコミュニケーション内容や重大な事業運営上の意思決定に関わる場面の手前に綿密なレビューポイントを導入し、高リスクなAIアクションに対して人間による明示的な検証を義務付けている。日常的な画面の操作性を損なうことなく、極めて重要なアクションの送信直前で確実にブレーキをかける設計となっている。
31. ユーザーが意図をより容易に表現できるように支援する
AIシステムは、ユーザーが要求を明確に表現できたときに最高のパフォーマンスを発揮する。人間と機械の協調における新たなパラダイムは「意図駆動(Intent-driven)」である。人間が「何を望むか」を定義し、モデルが「どのように実現するか」を探索する。インターフェースは直感的な視覚的コントロールを通じて、意図を表現するためのハードルを下げるべきである。

インターフェースは一般のユーザーに対して、分かりやすい視覚的コントロール、直感的な実例、構造化された入力パネルを提供すべきであり、誰もが難解でマニアックなプロンプトの呪文を学習しなければならない状態を強いてはならない。
プロダクトの対比:Midjourney の Creation controls パネルは、プロンプト構文の奥深くに隠されていたアスペクト比、スタイル化の強度、奇妙さ(Weirdness)、生成のバリエーション幅、モデルのバージョン番号、生成速度などのパラメータを、直感的なスライダーやトグルスイッチへと完全にマッピングしている。ユーザーは自然言語による描写を自由に記述しつつも、--ar 16:9 のような難解なパラメータのコードを暗記する必要から解放されている。
次元:⚖️ 信頼のキャリブレーション(Calibrated Trust)
信頼のキャリブレーション(調整)が目指すのは、AIに対するユーザーの信頼の度合いを、そのタスクにおけるシステムの真の信頼性へと限りなく近づけることである。
10. 主張、ツールの呼び出し、および引用データに出典を提供する
孤立した主張は、ユーザーの信頼を前借りしているに過ぎない。出典が添えられた主張であって初めて、検証可能性が生まれる。インターフェースは、結論の根拠となった元の参考資料を提示するだけでなく、モデルがどのドキュメントを照会し、どのツールを呼び出し、どのシステム入力を読み取ったかをも提示すべきである。明確なメタデータ情報を伴うインラインの引用は、インタラクションを「私を信じてください」という姿勢から「どうぞ検証してください」という姿勢へと完全に転換させる。

プロダクトの対比:Perplexity は、出所の提示を回答フォーマットそのものに組み込んでいる。テキストが生成される際、重要な記述の横には明確な数字の上付きインデックスが埋め込まれ、クリックまたはホバーすることで取得元の外部Webページへ直接遡ることができる。これにより、ユーザーはAIがまとめた要約から、その背後にある一次情報源へと容易に辿り着くことができる。
11. 空虚な信頼度スコアではなく、客観的な事実の出所を優先して提示する
これは直感に反する原則かもしれない。研究によると、信頼度を示す数値は——それが全く無意味な架空の数値であったとしても——誤った答えに対するユーザーの信頼を高めてしまう可能性がある。
条件が許す限り、抽象的なスコアを提示するのではなく、具体的な証拠を提示することを常に優先すべきである。論点を裏付ける元の段落、変更されたコードの差分行、取得されたデータベースのエンティティレコード、使用された特定のドキュメント、あるいは背後で呼び出されたツールの実行詳細を示すことである。
プロダクトの対比:学術文献アシスタント Consensus AI は、特定の学術的論争に対して結論を出す際、客観的に見えて実際には誤解を招きやすい総合信頼度パーセンテージのメーターを示すのではなく、回答の下にその主張を裏付ける査読付き学術論文の項目を直接展開する方法をとっている。
12. ユーザーの検証コストを極限まで圧縮する
検証にかかるコストが十分に低くなって初めて、信頼のキャリブレーションは現実のものとなる。生成内容を照合するためにユーザー自身が再調査を行わなければならないとすれば、ユーザーは確認そのものを放棄し、完全な盲従に陥るか、あるいは利用をやめてしまうかのどちらかである。変更差分のハイライト、引用リンクの直接配置、変更箇所の核心の明示——検証にかかるコストは、再調査ではなく「一瞥(ひとめ見ること)」程度に抑えられなければならない。

プロダクトの対比:NotebookLM では、AIの回答はユーザーがアップロードしたドキュメント群に完全に準拠している。ユーザーが本文中の引用インデックスにマウスを合わせると、インターフェース上に引用された元ドキュメントの抜粋が直接ポップアップ表示される。インデックスをクリックすると、左側のパネルで瞬時に元ドキュメントが展開され、ハイライトされた該当箇所へと直接ジャンプするため、ユーザーの検証コストはわずか一瞥の動作で完了する。
13. システムに隠された裏の意図を持ち込んではならない
AIは、ユーザーが現在明確に指示したタスクのために誠心誠意機能しなければならず、プラットフォーム側が裏で密かに仕込んだ商業的目標を背後に潜ませてはならない。滞在時間を引き延ばすための設計、アクティブ率を吊り上げるための意図的な遅延、追加購入の誘導、商業的利益のためにユーザーを本来の意図と異なる意思決定へ誘導することは厳に慎まなければならない。
これは単なるビジネス倫理の問題にとどまらず、人間と機械の信頼の生命線である。ユーザーがアシスタントを信頼して頼る前提には、「このアシスタントは純粋に目の前の目標達成を手助けしてくれている」という前提がある。そこに隠された私利が垣間見えた瞬間、その依存関係の基盤は一瞬にして崩壊する。
アンチパターン(反面教師):Amazon Alexaの By the way シナリオ。ユーザーがスマートスピーカーに極めてシンプルで明確な質問をし、スピーカーが回答し終えた直後に、求めてもいない提案を唐突に追加してくるケースである。このようなインタラクションは、アシスタントがユーザーの当面の目標のために機能しているのではなく、プラットフォームのアクティブ率や継続利用のために動いているという印象を与えかねない。
14. 追従・迎合を排し、健全な反論のためのインターフェースの足がかりを用意する
ユーザーに無条件で同意し、歓心を買うことしか知らないモデルは、最も疑念を抱くべき場面でかえって信頼を過度に吊り上げてしまう。ユーザーのリクエストに誤った前提条件、非論理的な推論、欠落した証拠、危険な操作指示、あるいは明らかな常識の不備が含まれている場合、システムは反論し、軌道修正する能力を持たなければならない。
システムが異論を唱えられるようなインタラクション設計を用意する。脆弱な論理構成にフラグを立てる、反対の視点からの論拠を提示する、「この結論には偏りが含まれている可能性があります」と明確に警告するなどである。おもねり(追従)の本質は、耳当たりの良いトーンによって作り出される過剰な依存である。
Sharmaらによるトップカンファレンス論文 Towards Understanding Sycophancy in Language Models は、詳細なデータを用いて、なぜモデルが自然に客観性を保つことを期待できないのかを明らかにしている。

- 追従は局所的な欠陥ではなく、根底にある学習メカニズムに起因する体系的なものである:研究でテストされた5種類の主要な商用アシスタントは、さまざまなタスクにおいて体系的な迎合傾向を一様に示した。デフォルトのメカニズムが本質的に同意する側に偏っているため、客観的な反論は意図的な設計によって強制的に注入されなければならない。
- ユーザーから疑問を投げかけられると、モデルは瞬時に屈服して誤りを認める——それも、ユーザーが最もキャリブレーションを必要としているまさにその瞬間に:研究によると、モデルが最初に正解を出していた場合でも、さらにはモデル自身がその回答に高い確信を持っていると表明していた場合であっても、ユーザーが何気なく疑問を口にしただけで、モデルは最大98%の質問において誤って自分が間違っていたと認めてしまった(wrongly admit mistakes)。ユーザーの主観的な疑念の一言が、正しい事実を容易に誤った答えへとねじ曲げてしまうのである。
- 根深い病根は人間のフィードバックメカニズムにあるため、インターフェースは「ユーザー自身が見抜けるだろう」と高を括ってはならない:実証データによると、人間の評価者と選好モデル(Preference Model)の双方が、無視できない少なからぬ割合において、真に客観的で正しい回答よりも、自信満々に書かれた迎合的な回答を好むことが示されている。選好モデルは95%の頻度でユーザーに迎合する追従的な回答を選好した。最も見分けるのが難しい認知の誤謬テストのサブセット(hardest misconceptions)においてさえ、追従を好む割合は約45%に達した。これこそが、反追従(アンチ・サイコファンシー)をインタラクションデザインの次元にまで引き上げなければならない根本的な理由である。学習の評価基準となる選好モデル自体がお世辞や阿諛追従に報酬を与えている以上、インターフェースが誤った前提を明示的にブロックしたり反例を提示したりしなければ、盲従は必然的に蔓延してしまう。
プロダクトの対比:Anthropic Claude は、モデルの行動規範(憲法)レベルで的を絞った制約が課されている。ユーザーの質問に誤った前提が含まれていることを検知すると、明確に異論を表明し(例えば "actually, that's not accurate…" と率直に述べる)、耳当たりの良い嘘を重ねるのではなく、礼儀正しく根拠を示して論理の破綻を指摘する。
15. クリエイターと著作権の帰属を尊重する
出力結果が特定の素材によって形作られている場合、AIシステムは明確な帰属関係を維持しなければならない。システムは、借用した独自のアイデア、特徴的な表現、または著作権で保護された素材を、あたかも自分自身が無から生み出した新たな成果であるかのように装ってはならない。検索結果、ユーザーがアップロードした私的データ、商用ライセンスで保護されたコンテンツ、パブリックWebのデータのいずれに基づいている場合であっても、インターフェースは適切なタイミングでその参照元を明確に提示すべきである。
著作者のクレジット、出典へのリンク、引用メタデータ、コンテンツの明確な再利用境界、および完全な複製・盗用に対する警告を提供することは、ユーザーが生成結果を責任を持って利用するための法的・道徳的最低ラインである。
プロダクトの対比と現実の論争:Adobe Firefly - 出典追跡はあるものの、許諾メカニズムは論争に直面している。肯定的な実践として、Adobeは出所追跡を製品の一部として組み込んでおり、Fireflyが生成したビジュアル資産はコンテンツ認証情報(Content Credentials)の付与をサポートし、その資産がAIによって生成されたことと作成・生成時のメタデータを記録している。しかし学習データの源流においては、このアプローチは依然として多くの独立系クリエイターやAdobe Stockのコントリビューターから公然の批判を受けている。自身のオリジナル作品が実質的な同意のないまま、あるいは明確なオプトアウトの仕組みが提供されないままモデルの学習に直接使用されたとして、激しい抗議がなされている。この事例は、著作権の出所追跡とクリエイターの利用許諾を巡る言説において、業界が今なお抱える深刻な断絶を浮き彫りにしている。
第3フェーズ:エラーと境界(フォールトトレランスの最低ラインと自律性のガバナンス)
著者はマイクロソフトのヒューマンAIインタラクション指針を論評する際、最も重みのある一言を述べている。「エラーは例外的なエッジケースではなく、AIのデフォルトの常態である。」 失敗が不可避である以上、AIシステムにおける失敗経路の設計への投資は、成功経路と同じくらい入念かつ緻密でなければならない。
次元:🩹 優雅な失敗(Graceful Failure)
25. システムのエラーによる被害の拡大半径を制限する
「優雅な失敗」とは、まずインターフェースが物理的なレベルでエラーの波及範囲を封じ込め、1回の生成エラーによってシステム全体の土台が破壊されるのを防ぐことを意味する。
これは、単に Undo ボタンを用意するようなレベルをはるかに超えている。
- 通常のテキストを生成したのであれば、削除すれば済む。
- しかしデータベースのレコードを変更するのであれば、完全な変更履歴が必要となる。
- 実際の顧客に向けたメールをトリガーするのであれば、送信前に完全なプレビューを提供しなければならない。
- システムを横断して自律的にコードを実行するエージェントであれば、完全な実行ログとシステム全体を巻き戻せるロールバック機能を備えていなければならない。
回復メカニズムを設計する際、測定されるべきはそのエラーがもたらし得る現実世界の破壊的結果であり、エラーが発生したその瞬間の画面上の1アクションにとどまらない。

プロダクトの対比:Replit Agent は、ユーザーに代わってコードを変更しフルスタックアプリを構築する際、各ステップを実行する前にスナップショットチェックポイント(Checkpoint)を作成し、コードの差分と動作プレビューを明確に表示して、ワンクリックのロールバック機能を提供する。AIが手を加えているのは稼働中のコードベースそのものであるため、生成が破綻した場合でも、開発者は被害の程度をいつでも確認し、ワンクリックで以前の安定したバージョンへ復元できるようになっている。
26. 根拠が薄弱なときは出力の精度を能動的に下げ、人間の再確認が必要な箇所を特定する
システムが高い確実性を持って結論を出せない場合、決して無理をして正確さを装ってはならない。
誠実で有用なシステムは、一歩身を引いて、より安全で低精度な表現形態をとるべきである。
- 具体的な一点の推定値ではなく、幅を持たせた範囲(区間)を用いる。
- 断定的な単一のラベルではなく、該当する可能性のある確率的カテゴリを用いる。
- 全知全能を謳う要約ではなく、部分的な不完全な要約を用いる。
- 確定的な結論に見せかけるのではなく、いくつかの潜在的な代替案を提示する。
インターフェースが目指すべきは、客観的な証拠がある分だけ正確さを表現し、決してそれ以上踏み込まないことである。虚勢を張って出力を水増しするくらいなら、小さな一歩を精密に完了させる方がはるかに良い。

プロダクトの対比:Grammarly は文章の提案を行う際、確信度の高い客観的なスペル・文法の修正と、確信度の低いソフトな文体・トーンの提案とを明確に区別している。複雑な文体や文脈が完全には判然としない段落に直面した際、決して独断で強制的なリライトを行わず、著者が自ら判断すべき提案の選択肢として提示し、人間が確認すべき重要文を明示する。
27. 人間へのハンドオフ(引き継ぎ)フローを入念に設計する
AIが自身の能力の限界を検知したとき、確信度が急落したとき、あるいは高リスクで複雑なシナリオに直面したとき、タスクを人間に委ねる操作は決して不躾な中断であってはならず、ましてやユーザーをゼロからやり直させるような袋小路に放り込んではならない。引き継ぎの際にそれまでのすべての文脈を喪失してしまうようなハンドオフは、それ自体が重大なシステム障害である。
高リスクまたは部門横断的な業務フローにおいて、引き継ぎは高度に構造化されていなければならず、人間の担当者に対して以下の情報を完全に引き渡す必要がある。インシデントの中核的な背景要約、システムが現在不確実性を抱えている論点、未解決の争点、AIが先ほどまでに実行した前提アクション、読み取ったプライベートデータ、そしてシステムが推奨する人間の次のアクション案である。
プロダクトの対比:カスタマーサポートシステム Intercom Fin は、安全かつ高い確信度で解決できない顧客の要求に直面した際や、高リスクなサービスのトラブルに遭遇した際、能動的に会話を有人のサポートチームへとエスカレーションする。AIは単に仕事を投げ出すのではなく、顧客の中核的な要求と文脈の診断分析をまとめたチケットをサポート担当者のワークスペースに整然と提示し、スムーズなバトンタッチを実現している。
28. 悪意を前提としない善意の出発点で拒否経路を設計する
システムがユーザーのリクエストを拒絶することも、インタラクション体験の不可欠な一部である。設計の出発点は、ユーザーは合理的な業務上の意図を抱いているとデフォルトで見なすことであり、真の安全防壁、法規制遵守、プライバシーのレッドライン、組織のポリシー、または不可抗力な現実的リスクに直面したときにのみブロッキングを発動させるべきである。
システムが支援を提供できない場合、以下の3ステップのクローズドループに従わなければならない。
- どのような制約が存在するかを明確に示す。
- 平易な言葉で簡潔に説明する。
- コンプライアンスを満たす目標に最も近い、安全な代替経路を能動的に提示する。
重要な情報を黙って隠蔽したり、操作が正常に完了したかのように装ったり、ましてやユーザーを出口のない絶望的な状況に追い込んだりしてはならない。 ユーザーは何が起きたのかを理解し、安全かつコンプライアンスを遵守した形でタスクを前進させる方法を知る必要がある。
プロダクトの対比:ChatGPT の安全拒否メカニズムは、ユーザーのリクエストがレッドラインに触れた際、ユーザーを悪意ある攻撃者と決めつけて頭ごなしに遮断するのではなく、現在の境界線がどこにあるのかを説明し、コンプライアンスに沿った議論の切り口を提示することで、安全な予防策や一般的な原理の解説、健全なトラブルシューティングの方向へとユーザーを導く。
次元:🛡️ 責任ある自律性(Responsible Autonomy)
AIエージェントが自律的に行動する権限が大きくなるほど、インターフェースはガバナンスと防衛の中枢としての役割を帯びるようになる。いかなる場合も、人間が最高裁定権を握り続けていることを保証しなければならない。
32. 「アクションの可逆性」と「被害の代償」に基づいて自律権を段階的に制約する
AIは、異なるシステムコンテキストにおいて同等レベルの行動の自由を享受してはならない。潜在的な被害が取り返しのつかないものである場合、ワークフローは常に人間主導で強固に維持されなければならない。
システムの振る舞いは、厳格に4つの段階的ラダーに分類されるべきである。
- 自動実行(Auto-run):代償が極めて小さく、完全に可逆的な操作にのみ適用する。
- 通知(Notify):中程度の影響を持つ操作に適用し、システムが実行した後に非同期でユーザーに知らせる。
- チェックポイント(Checkpoint):不可逆または高代償な操作に適用し、人間の明示的な承認を待って初めて実行する。
- 人間主導(Human-led):操作が重大で実質的な破壊をもたらす可能性がある場合、AIは支援のみを行い、全プロセスは人間自身の手によって進行されなければならない。
ユーザーがいつでも停止できず、事後確認もできず、完全にロールバックすることもできないエージェントは、真の意味での自動化ではなく、単なる完全な制御不能状態(暴走)に過ぎない。
プロダクトの対比:ターミナル向けのコーディングエージェント Claude Code では、システムが文脈を分析する際にローカルファイルを読み取る行為は低リスクで可逆的な操作とみなされ、デフォルトで自動実行される。しかし、ディスク上のファイルを永久に削除したり、OSのターミナルでシェルスクリプトのコマンドを実行したりする場面になると、システムは即座に停止して安全チェックポイントをポップアップ表示し、エンジニアが手動で承認を確認するまで待機する。
33. データアクセスを明示的に宣言し、オンデマンドで承認させ、いつでも取り消し可能にする
ユーザーは、AIが自身のどのデータにアクセスでき、どのような理由でアクセスしているのかを明確に把握していなければならない。これには、個人のプライベート情報、企業内のナレッジベース、一時的にアップロードされたファイル、対話履歴、利用履歴や行動ログ、位置情報、カレンダーの予定、送受信メール、顧客ファイル、およびタスクの実行やパーソナライズの最適化に用いられるあらゆる文脈が含まれる。
データアクセスの境界を拡大する前には、必ずユーザーの許可を求めなければならない。また、システムはいつでも権限を精査、制限、ワンクリックで取り消しできるコントロールセンターを提供しなければならない。
プロダクトの対比:Apple Intelligence はそのアーキテクチャにおいて、個人のコンテキストデータへのアクセスロジックを明確に定義している。処理の大半はユーザーのローカル端末内で完結するか、プライバシー保護機構を備えたクラウド演算によって処理される。製品レベルでは、データアクセスの境界がバックエンドの見えないブラックボックスに埋もれることなく、インタラクション体験の一部として直感的に提示されている。
34. 現在の利用者以外の第三者のプライバシーを厳格に保護する
前述の原則が「製品を現在利用しているユーザーのデータ」を保護するものであるのに対し、本原則が保護するのは製品を利用していない世界中のあらゆる第三者のプライバシーである。
生成AIは、情報の統合、断片の関連付け、長期的な推論、およびWeb全体の要約に関して極めて強力な能力を持っている。たとえ個々の断片的なデータがインターネット上で公開情報であったとしても、AIによって複数のソースを横断して統合されると、極めて機微な個人の立体像が一瞬で構築されたり、極めてプライベートな私生活が露呈したり、情報が悪用されやすくなったりする。
システムは、オンライン上に散らばる断片的な情報を他者に対するプライバシー監視ツールへと統合してはならず、第三者個人に対する身元調査や匿名性の解除(ディ・アノニマイゼーション)の試みに断固として抵抗しなければならない。
プロダクトの対比:Google ストリートビュー(Google Street View Maps) は、撮影車が世界中のどの街路をスキャンしようとも、画面に映り込んだ無辜の通行人の顔や自動車のナンバープレートに全自動でモザイク処理を施す。これらの通行人はストリートビューに登録して利用したこともなければ、撮影されることに同意したこともない。ストリートビューが対象としているのは知覚レベルの個人識別情報のマスキングであり、生成AIはさらに一歩進んで複数の情報源を跨ぐ暗黙のセマンティックな人物プロファイリングの推論を防ぐ必要があるが、両者の最低ラインは完全に一致している。すなわち、画面の前に座っていない第三者のプライバシーを厳格に守り抜くことである。
35. 指示、データ、ツール、操作の信頼境界を厳守する
これはエージェント設計における最も重要なセキュリティアーキテクチャの防壁である。エージェントが何を読み取ることを許可され、何に従わなければならず、どのような能力を呼び出すことができ、どのような変更をもたらし得るのかを明確に定義すること。外部から取得したコンテンツ——顧客から送られてきたメールであれ、外部からスクレイピングした公開Webページであれ、第三者がアップロードしたドキュメントであれ——が、システムの挙動を支配する「指示」へと密かに変貌することは決して許されない。

インターフェースと基盤アーキテクチャは、概念と権限の双方において4つの高い壁を築かなければならない。
- 指示(Instructions):システムが真に従うべき、かつ唯一従うべき中核的な命令。
- データ(Data):システムが実行過程で参照、抽出、処理できる情報。ただし、システムはその中に含まれるいかなる命令や要求にも絶対に従ってはならない。
- ツール(Tools):システムが承認の下で呼び出すことができる機能や能力(読み取り専用に限らず、例えばAPIを呼び出してメッセージの下書きを作成することもツールに該当する)。
- 操作(Actions):システムが外部世界に実質的な変化をもたらし、状態を永続的に変更し得る行動。
プロダクトの対比:Claude Connectors は、AIアシスタントが企業の外部エコシステム(メール、カレンダー、クラウドドキュメント、チームチャット、開発者ツールプラットフォームなど)に接続することを可能にしている。その権限体系は、アシスタントが「何を見ることができるか」と「何をすることができるか」を厳格に区別している。Slackコネクタにおいては、メッセージ履歴の検索、スレッドの閲覧、ユーザーの公開プロフィールの確認などの読み取り専用ツールは Always allow(常に許可)として設定できる。しかし、インタラクティブなツール(例えばアシスタントがメッセージの下書きを作成するような場合)については、人間の承認を必須とするように設定可能である。
第4フェーズ:長期的な進化と測定(持続的な依存とシステムの測定)
AI製品のリリース・公開は、インタラクションデザインのゴールでは決してない。基盤となるモデルは進化を続け、ユーザー側の認識も常に変化していくため、長期にわたる健全な依存関係を維持するには、明確なユーザーフィードバックの導線、待機時の体験、リソース消費、評価指標、システム依存のアップグレード、そして明確な説明責任の所在に関する定常的なガバナンス体制を構築する必要がある。
次元:📈 持続的な依存(Sustained Reliance)
36. 最終的な「結果」だけでなく、「待機」のプロセスを入念にデザインする
レイテンシ(遅延)は、生成AIにおいて避けては通れない本質的な代償である。
応答が遅いこと自体が直ちに劣悪な体験を意味するわけではない。しかし、何の説明もない長時間の空白の待機は、システムに対するユーザーの信頼を一瞬で粉砕する。待機中、ユーザーはシステムが現在具体的に何を行っているのか——資料を検索中なのか、論理的推論の最中なのか、外部ツールのAPIレスポンスを待っているのか、それとも完全にフリーズして停止しているのか——を明確に把握できなければならない。
待機状態を中核的なインタラクションとして丹念に磨き上げる。適切なタイミングでのタイプライター風テキストのストリーミング出力、明確なステップが存在するタスクにおける多段階の進捗分解、検索の実行・ツールの呼び出し・巨大な添付ファイルの解析・エージェントのステップ進行時におけるリアルタイムのステータス表示などを実施する。そして処理に過度の時間を要する場合は、安全な途中のキャンセルボタンを必ず提供するか、バックグラウンドでの非同期処理への移行を許可しなければならない。 待機プロセスをデザインするのは、派手なアニメーションで装飾するためではなく、未知の停止に直面したユーザーの心に生じる不安を払拭するためである。

プロダクトの対比:Perplexity は、従来の単調なローディングスピナーを排し、待機プロセス全体を動的で明確なフェーズへと分解している。Searching → Reading sources → Writing answer(検索中 → 情報源の読み込み中 → 回答の執筆中)と推移し、バックグラウンドでWebページを取得する際には、読み込み中の情報源サイトをリアルタイムで画面上部にリスト表示する。これにより、待機時間そのものが透明性の高い実行プロセスの報告へと変わる。
37. コンピューティングエフォート(計算資源の消費努力)が意思決定を左右する場面ではそれを可視化する
AIとのインタラクションは決して無償ではない。その背後には実際の金銭的コスト、応答時間、物理的な消費エネルギー、APIのレート制限クォータ、クレジットポイントの消費、あるいは企業の調達予算が絡んでいる。
インターフェースのあらゆる場所でToken消費量や請求額をくどくどと表示し続ける必要はない。しかし、製品デザインがユーザーに対して頻繁な再生成のトリガー、膨大なコンテキストの入力、複数のバリエーションの並列実行、長時間常駐する自動エージェントの実行、あるいは高コストなツールの呼び出しを促している場合、計算にかかる負荷と代償を適切に可視化し、ユーザーのインタラクション行動を前向きに導く必要がある。

プロダクトの対比:ClaudeのEffort(思考努力度)制御ドロップダウンメニュー は、5段階の離散的な設定(Low / Medium / High(デフォルト)/ Extra / Max)を提供し、ユーザーが現在のタスクを解決するためにモデルがどれだけの計算リソースを投入すべきかを自律的に選択できるようにしている。インターフェースはこのトレードオフをユーザーにわかりやすく説明している。努力度を引き上げれば深い推論と極めて詳細な成果物が得られるが、その代償として毎回の応答時間が長くなり、アカウントの利用クォータの消費が大幅に加速する。ユーザーの意思決定に影響を与えるべきまさにその節目——迅速な回答を求めているのか、深い推論なのか、それとも費用対効果の高いエコノミーモードなのか——においてのみ、計算コストという判断材料を前面に引き出している。
38. 使用量の数値を一面的に美化するのではなく、依存関係の健全性を測定する
アクティブ率の高さや呼び出し回数の多さは、AI機能が良好に機能していることの証明には全くなっていない。従来のインターネット製品が追い求めてきた成長指標は、AIを前にすると正反対の意味合いを併せ持つ二面的な複雑性を呈することが多い。
- 高い提案採用率:システムのアウトプットが極めて正確であることを示すかもしれないが、ユーザーが習慣的な盲従に陥り、精査することなく鵜呑みにしている可能性も同様に孕んでいる。
- 高い再生成率:ユーザーが多様性の空間を健全に探索していることを示すかもしれないが、システムの初回生成の品質が極めて拙劣であり、ユーザーが何度も再試行を余儀なくされている状況を暴露している可能性も同様にある。
- 極めて長いセッション滞在時間:ユーザーが深い協創に没入していることを示すかもしれないが、ユーザーが誤謬の深みに嵌まり、苦痛に耐えながらエラーの修復を繰り返している、あるいは不健全で非効率な依存を生み出していることを意味している可能性も同様に考えられる。
データ指標の中核的な使命は、毎回のインタラクション数値を極限まで釣り上げることではなく、人間と機械の協調における依存関係が理性的かつ健全な状態にあるかどうかを客観的に洞察することである。
(注:原著者はこの項目において従来の指標の二義性を指摘するにとどまり、代替となる指標を提示しておらず、全文の中で唯一製品事例が記載されていない項目となっている。この空白自体が注目に値する。「人間と機械の協調が健全であるか」をどのように測定すべきかについて、現時点で業界にはまだ共有された共通の解が存在しないのである。)
39. モデルの更新とデータドリフトのためにデザインする
今日綿密にチューニングされた完璧なインターフェースであっても、次回のモデルのバージョンアップによって成り立たなくなる可能性がある。モデル基盤のホットアップデート(無停止更新)によって、インターフェースが結んでいるエンジニアリング上の契約が音を立てずに崩壊してはならない。
中核的なソフトウェアライブラリのアップグレードを扱うのと同様の姿勢で、大規模言語モデルの刷新に向き合わなければならない。インタラクション体験のバージョン管理を行い、ベンチマーク評価セットを構築してシステムの振る舞いの期待値を固定し、モデルが更新されるたびに信頼のキャリブレーションとユーザーの依存度指標を厳格に回帰テスト(リグレッションテスト)して精査する必要がある。
プロダクトの対比と実装上の限界:コードエージェントツール Cursor は、画面上にモデル選択の切り替えスイッチ(Model selection)を用意し、開発チームが背後のコーディングエージェントを駆動するモデルを自律的に指定できるようにしている。このようにモデルへの依存関係を可視化し、制御可能にすることは、変化を捉えるための第一歩である。さらに深い領域においては、エンジニアリングチームは自動化されたベンチマークテストや依存バージョンの固定を組み合わせることで、モデルがアップグレードされようとダウングレードされようと、製品全体のインターフェース・インタラクション契約が盤石であり続けるように担保しなければならない。
明日から実践できる低コストな4つのアクションと推進ロードマップ
39もの詳細な項目からなる長大なデザインフレームワークを読み終えた後、多くのプロダクトチームが最初に感じるのは「何から手をつければよいかわからない」という戸惑いであろう。(注:以下の4項目は原文に元からあるリストではなく、本稿が39の原則を踏まえて抽出した低コストな実践の足がかりである。)もしこの39の原則の中から、最もコストが低く、かつ人間と機械の信頼の亀裂を瞬時に修復できる変更を選ぶとすれば、あらゆるチームが明日から実行できるアクションは以下の4つである。
-
インターフェースの表現のトーンを書き換える(原則6)
今すぐ製品の画面全体を見直し、生成結果の横にある確定的な終局感を漂わせる単語(「答え」「完了」など)を、批判的な精査を促す単語(「下書き」「提案」「候補」など)に置き換える。ほんのわずかな単語の転換が、最終的な意思決定と確認の責任を人間の側にしっかりと留め置くよう無意識に働きかける。 -
検証のための動線を極限まで圧縮する(原則10 / 12)
生成されたプレーンテキストの塊をユーザーに投げつけるだけで終わらせてはならない。第1段階で動的なグラフ表示が難しい場合であっても、引用した事実の横にインラインで出典の上付きインデックスを配置したり、テキスト修正時にDiff(差分)をハイライト表示したりして、ユーザーの確認コストを「検索による再調査」から「マウスホバーによる一瞥」へと引き下げる。 -
エージェントに対して明確な4段階の自律権ラダーを描く(原則32)
製品がAIにトリガーを許可しているすべてのアクションを洗い出し、「可逆性」と「被害の代償」に基づいて4象限のマトリクスに厳密に分類する。読み取りや無害な探索は自動実行(Auto-run)を許可し、中程度の影響を伴うものは実行後に静かに通知(Notify)し、データの削除・有料APIの呼び出し・外部へのメッセージ送信など不可逆な操作はすべて断固としてチェックポイントを設けて承認制(Checkpoint)とし、極めて危険な操作は全工程を人間が主導(Human-led)する。セーフティラインを越えて密かに実行されることを決して許してはならない。 -
テンプレートを用いて最初の空の入力欄を埋める(原則5)
むき出しの空の入力欄を前に、ユーザーを途方に暮れさせてはならない。高品質なプロンプトの具体例、利用シーンに応じたテンプレート、あるいは構造化されたクリック選択スイッチを3〜5個配置し、ユーザーが入室した最初の1秒でシステムの能力の境界線を理解できるようにし、極めて低い認知コストで最初の協調作業を開始できるようにする。
システム論的な進化の視点から見ると、マイクロソフトのヒューマンAIインタラクション指針の原文は、4つのフェーズの中で「AIが誤ったとき(When AI is wrong)」の重みが最も高いと指摘したにとどまり、具体的な推進順序までは規定していない。この判断に基づき、本稿では小規模なチームがAI製品を構築する際により現実的となる以下の推進ロードマップを推論として提示する。
まず「使用前」の期待値確立(原則4、5、6、9)と、「AIが誤ったとき」の防衛ライン(原則25、28、32、35)に着手する。
統計システムにおいて、エラーは避けることのできない物理法則だからである。まずは土台となるガードレールとロールバックの仕組みをしっかりと固め、最悪の結果が生成されたとしてもビジネスの最低ラインを突き破らない状態を担保して初めて、チームは「使用中」や「時間経過に伴う変化」という深い領域へと足を踏み入れ、段階的開示、注意のリズム、マルチモーダルな共創といった、より緻密な取り組みに手を広げることができるのである。
実践用持ち帰り資料
Markdown をスクロールして確認し、コピーしてチーム向けに調整できます。
Markdown を読み込み中…
記事のテイクアウェイ・パック
現場ですぐに使える2つの実務ツール:プロダクトを39の原則に照らして点検できるセルフチェックリストと、AIアクションの自律性を4段階に分類するワークシート。