関数名を変えるだけで、14種類のモデルが同じコードを読む際のトークン消費を最大3分の2削減できた
- 関数に付ける名前次第で、AIが修正するときに読むファイル数が19個にも459個にも変わります。Modemは1,680回の対照実験でこのコストを明らかにしました
- 根本原因はここにあります。AIはコードを探すのにプレーンテキスト検索を使います。コンパイラが描く依存関係グラフも、シンボルを解析する言語サーバーもありません。Claude Codeチームは初期にベクターデータベースを試しましたが、結局捨てました
- 名前を一発で見つかるものに変えると、14種類のモデル・ツール組み合わせ全てでトークン消費が減少。最大削減ケースでは平均7万→2.4万トークン。中央値で3割削減。しかも、自信満々に間違えるケースはゼロになりました
- 節約できた検索予算は、そのまま判断力に変わります。同じ8ラウンドの調査予算でバグ探しをさせたところ、弱いモデルは巨大ファイルでは8個中3個しか見つけられませんでしたが、コードを分割しリネームした後は8個全てを発見。失敗したレビューのほとんどは誤った回答をしたわけではなく、予算を全てファイル探索に費やし、結論にたどり着けていませんでした
AIは一体どうやってコードを探しているのか?(基本メカニズム)
コーディングAIに「この関数名を変えて」と頼むと、彼らはまずあなたのリポジトリを検索します。
この「検索」には何ら高度な仕組みはありません。リポジトリ全体のテキストを走査し、指定した文字列が含まれる行を探します。エディタでCtrl+Fを押すのとまったく同じです。この操作はコマンドラインではgrepと呼ばれ、数十年前から存在します。AIが使うのはその高速版ripgrep(コマンドはrg)です。
彼らはコンパイラに依存関係グラフを尋ねたり、言語サーバーにシンボルを解決してもらったりはしません。彼らが認識するのは文字通り表記だけです。検索し、ヒット箇所の前後を読み、足りなければ別の言葉で再検索します。
これは特定のツールが怠けているわけではありません。Claude Codeチームは初期にベクターデータベース方式を試しましたが、結局捨てました。プレーンテキスト検索の方が優れていたからです。学界発のSWE-agentも同じ結論に至っています。モデルに与えられているのは専用のキーワード検索ツールだけで、それ以上に派手なものはありません。
パスも検索語になります。「session broker(セッション仲介)はどう動くの?」と尋ねると、AIはsession-broker、sessionBroker、session_brokerの3つの綴りでファイル名を検索します。session-broker/というディレクトリは、最初の一行を読む前から、すでに一度ヒットしているのです。
AIはこのループを回っています。検索し、ヒット箇所の周辺を読み、足りなければ別の言葉で再検索し、十分になればようやく編集を始めます。
つまり、この連鎖の中に、コードを書く人間が完全にコントロールできる入力が一つあります。それは、あなたのコード内の語彙とファイル名が、優れた検索語になり得るかどうかです。
このコストを計算したのがModemです。この会社は2025年初頭に創業し、コードを全てAIで書くことを決定しました。1年間でTypeScriptアプリコード36万行、テストコード32万行を生成し、その99.9%をモデルが作成しました。以下の知見と1,680回の対照実験は、すべてこの1年間の成果です。
名前が曖昧だと、どれほどのコストになるのか?
では、「優れた検索語」とそうでない場合、具体的にどれだけ違うのでしょうか。彼らは3つの関数で比較しました。
これら3つの関数は機能が完全に同じで、どれも外部サービスを呼び出すAPIクライアントを作成します。違いは名前だけです。
export function create(apiKey: string) { ... }
export function createClient(apiKey: string) { ... }
export function createStripeClient(apiKey: string) { ... }
Modemの約2,900ファイルからなるTypeScriptリポジトリで、それぞれを検索してみます。
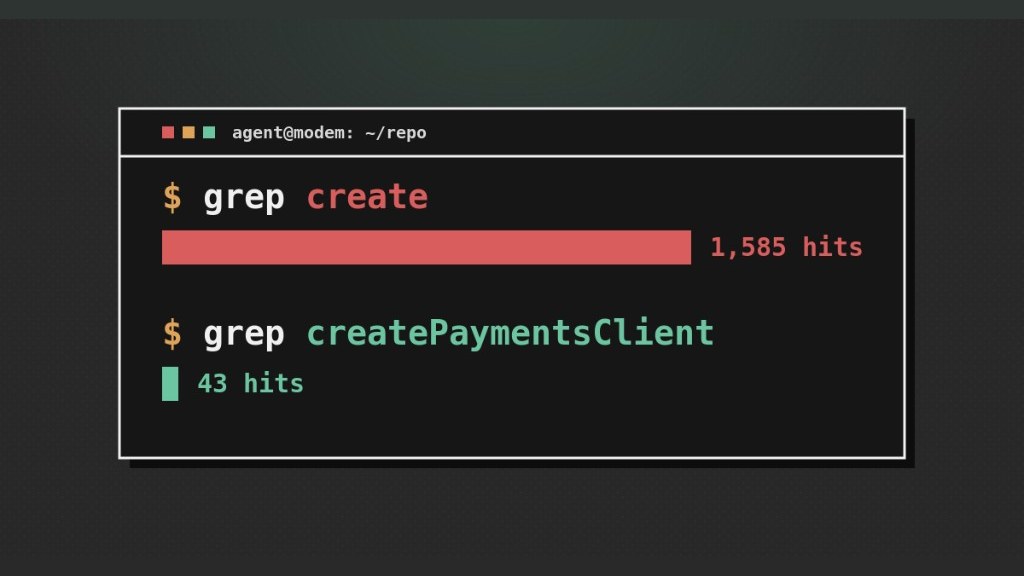
つまり問題は検索の速さではありません。grepが返すのはマッチした行であり、答えではありません。const client = create(config)という一行を見ても、それがAIに求められているクライアントなのか、それとも同じcreateという名前の数百あるうちの一つなのかは分かりません。
それを判断するには、ファイルを開いてヒット箇所の周辺を読み、さらに範囲を広げたり、別の箇所を開いたりする必要があります。ファイルは数十行から数千行まで様々で、1行あたり約10トークン(トークンはAIが読み書きするテキストの単位。一度の会話で扱える量や料金はこれで計算され、おおよそ英単語1つが1トークン強に相当)とすると、誤った候補を1つ排除するだけで数百〜数千トークンを消費します。それを十数個続ければ、数万トークンが消えていきます。お願いした作業はまだ一字も実行されていないのに。
あの1,585件のヒットは、数百の無関係なものに散らばっています。テスト用のダミーデータ、データベースへのレコード挿入、バックグラウンドタスクの登録などです。一方、createStripeClientの43件のヒットは、定義、呼び出し箇所、テストで、すべて同じクライアントについて語っています。
節約になるのは今回だけではありません。コンテキスト(一度に扱える情報量)は有限です。無関係なcreateを排除するために使ったトークンは、今回の変更ではもう使えません。さらに厄介なのは、コンテキストがこれらの似て非なるマッチで埋め尽くされると、モデルがその情報を信頼して使う度合いが低下することです。grep一回で特定できる名前は、AIの注意力と予算の両方を守ってくれます。
importがあるのに、なぜ十分ではないのか?
ここで疑問が湧きます。ファイルの先頭に「これがどこから来たか」が書いてある(importの行)のだから、それを辿っていけばいいのでは?と。
もし目的が呼び出し箇所から定義を見つけることだけなら、その通りです。importは前方を指す道標ですが、冒頭の「名前を変える」タスクは逆方向です。定義から出発して、それを呼び出している全ての箇所を見つける必要があります。プレーンテキスト検索には逆引きインデックスがありません。定義が置かれているファイルには、誰がそれを参照しているかを記した行は一切存在しないのです。
同じcreateへの3つの呼び出し箇所が、それぞれ相対パス、パッケージ名、リネームしたインポートで参照されています。パスで検索すると最初の1つしか見つかりません。パッケージ名にパスが含まれていないからです。関数名で検索すると2つ見つかりますが、リネームされたものは見逃し、無関係なcreateを大量に拾ってしまいます。
importが@modem/commonから来ていると示していても、それはパスではありません。AIはpackage.jsonを読むかパッケージ名で検索して、そのパッケージの場所を特定する必要があります。辿り着く先がbarrelファイルの場合、中身はexport *だらけです。このbarrelファイルはパッケージの入り口にある総目次のようなもので、「このパッケージのものは下のファイル群から出ていく」とだけ書かれていて、どれがどれかを示してはいません。AIは名前のない名簿を手にした状態で、パッケージ内を再びgrepしなければなりません。3回もジャンプして、結局最初からできた検索に戻ってくるのです。
client.getUsers() のような呼び出しは、どのimport文にもgetUsersという名前は現れません。importが扱うのはモジュールとそのトップレベルエクスポートであり、メソッドはそのどちらでもないからです。これはTypeScriptに限った話ではありません。Python、Go、Ruby、Javaでも、同じ空白が存在します。
モジュールは一方向しか指さず、barrelやパッケージ名に出くわすと曖昧になります。オブジェクトのメソッドに至っては一切言及しません。結局、働いているのは名前なのです。
パラメータの型を明確に書くと、AIのどんな作業が省けるのか?
ここまでは「AIがあなたのコードを見つけられるか」という話でした。見つけた後、どう使うかは別の要素に依存します。それが「型」です。
型はコメントやREADMEとは根本的に異なります。コメントは読まなくても済みますが、型はコンパイラが強制します。コンパイルを一度実行すれば、型エラーは具体的なフィードバックとなり、AIはしばしば1ラウンド以内で自分で修正します。
コンパイラが口を開く前に、すでに型はコストを節約しています。次のようなシグネチャを見れば、何が入って何が出るか一目瞭然で、関数本体を開く必要すらなくなります。
function enrichUser(user: User): EnrichedUser;
function enrichUser(data) や data: any に変えると、dataが何かを知るために実装を読む必要が出ます。さらに実装を読むと、それがまた別の何かに渡されていることが分かり、それも読み、場合によっては呼び出し元も確認しなければなりません。型注釈を一つ省くだけで、1行の読み物が複数ファイルの読書に変わります。TypeScriptのanyはさらに陰湿です。害は同じ大きさなのに、型らしい見た目をしているからです。
型の名前が適切かどうかも、同じくらい重要
次の関数は、3つのパラメータがすべて文字列のため、順序を間違えて渡してもコンパイラは何も言いません。
transferOwnership(
  userId: string,
  orgId: string,
  projectId: string
)
呼び出し時に順序を間違えてもビルドは通ってしまい、エラーは実行時まで持ち越されます。
transferOwnership(
  userId: UserId,
  orgId: OrgId,
  projectId: ProjectId
)
同じように順序を間違えると、ビルドは即座に失敗します。しかもエラーメッセージは OrgId を UserId として使えないと、具体的に指名します。
この自己修正ループを観察した研究もあります。モデルにコンパイラのエラーを持たせて何度か修正させると、成功率はおよそ3倍になりました。
ここに連鎖があり、先ほどの話に繋がります。エラーメッセージに指名されたOrgIdは、おそらく別のファイルで定義されています。AIがエラーに従って修正するには、その定義を読む必要があり、そこに辿り着く唯一の方法は、やはりその名前を検索することです。
型名と関数名は同じ規則に従います。OrgId、UserEnrichmentResultのような名前は、検索すれば即座に定義に辿り着けます。Result、Data、Configといった名前は、AIを再び針探しの海に放り込みます。コンパイラは「どこを見るべきか」を教えてくれますが、名前が「その参照にどれだけ時間がかかるか」を決めるのです。
anyの問題はまさにここにあります。コンパイラは何も言わず、AIは検索する言葉すら持てません。下手な名前であれば、少なくとも手がかりは残っているのです。
実験データ:この方法は本当に効果があるのか?
ここまではすべて理屈です。名前は具体的に、型は正確に。もっともらしい話ですが、実際にどれだけ節約になるのでしょうか。Modemはこれを実験にしました。
彼らはFable 5にこのブログ記事を1ページのスキルファイルに圧縮させ、コーディング時にコンテキストへ読み込ませました。そして、どちらの立場にも関係ない要件定義(リトライ、レート制限、署名付きの通知パイプライン用の小さなライブラリ)を、2つのライターモデルにそれぞれ2回書かせました。1回はスキルファイルなし、もう1回はスキルファイルあり。執筆者はHaiku 4.5(Claude Code)とGPT-5.6 Sol(Codex CLI)。これで、同じライブラリの4つのバージョンができました。
Haikuがスキルなしで書いたコードは、まさにこの記事が警告している典型例です。
Solがスキルなしで書いたコードは元々丁寧で、backoff.tsにはcalculateBackoffDelay、token-bucket.tsにはTokenBucketが置かれていました。スキルありではさらに深く、backoff.tsはnotification-retry-backoff.tsになりました。ただし、2つのバージョンの差は、Haikuの場合よりも明確に小さいものでした。
次に読む側の実験です。4つのバージョンをそれぞれ、実際のリポジトリから取った同じ500ファイルに埋め込み、クリーンなセッションで検索・読み取りツールだけを与え、次のような質問をしました。
次のリトライまでにどれだけ待つのか、その待ち時間はどこで計算されている?
計算されたHMAC署名(送信データに付与する偽造防止スタンプ)は、どの段階で送信データに添付される?
通知IDが与えられたとき、過去の配信試行履歴はどこで確認できる?
14種類のモデル・ツール組み合わせが、4つのバージョンそれぞれに10問、3回ずつ、合計1,680回の実行を行い、消費トークンと正誤を記録しました。
Solが書いたコードを読む場合、14の組み合わせ中12で改善し、中央値で12%減。残り2つは改善しませんでした。
傾向は一貫しています。元の書き方が粗いほど改善の余地が大きく、Solは元々うまく書けているため、節約できる分も少ないのです。
自分で書いたコードを読むときも、モデルに特権はない
特に注目すべきデータが1行あります。Solがスキルなしで書いた自分のコードを読む際、スキル版に置き換えた後でも13%〜38%(駆動するツールによって異なる)のトークンを節約できました。
コードを書いたモデルにも「どこに何を置いたか覚えている」という記憶はありません。彼らが実行する検索は、他者とまったく同じです。
曖昧な名前のバージョンにだけ現れる失敗
誤答はほぼHaikuの曖昧な名前のコードでのみ発生し、しかも自信満々の誤答でした。この通知ライブラリの配信履歴はどこかと尋ねると、リポジトリ内の別の何かのSlack配信台帳を指し示しました。HMAC署名がどの段階で付与されるか尋ねると、2回ともメディアプロキシサービスのURL署名器を指しました。
スキル版の誤答はゼロでした。似ているが違うコードは、hmac-payload-signer.tsという名前には太刀打ちできません。Solが書いた2つのバージョンでは、この種の失敗はほとんど見られず、840回の実行で834回正解。誤答はごく稀で、両バージョンに散発的に見られる程度でした。
実プロジェクトでも成立するのか?(4,943行のファイル)
合成されたコードベースは一部の問題しか説明しません。そこで彼らは実際の難しいケースを選びました。オープンソースのセルフホスト型AIワークベンチ「Odysseus」です。公開初週に数万のGitHubスターを獲得しました。

そのroutes/email_routes.pyは4,943行あり、うち約3,900行が1つの関数です。81個のルートハンドラ(それぞれがウェブリクエストに応答する)がすべてその中に詰め込まれています。1つの関数が、メールクライアント全体を形成しているのです。
Modemはこの1ファイルだけをリファクタリングしました。動作は変えず、ルートも変更せず、機械的に検証した上で、概念ごとに名前を付けたモジュールへ分割しました。
email_routes.py
  4,943 行
  81個のハンドラが1つの関数に
email/
  smtp_settings.py
  message_rendering.py
  folder_fallbacks.py
  delivery_history.py
そして、同じ6つの質問を4つのモデルに投げました。結果はまたもや同じ傾向です。モノリスで迷っていたモデルほど節約が大きく(Haiku 4.5は34.3%減、Grok 4.5は31.5%減)、迷っていなかったモデルはほとんど節約できませんでした(GPT-5.6 Solは5.9%減、Sonnet 5は3.9%減)。Haikuは以前、40万トークンを費やして、その壁を1ページずつめくっていましたが、リファクタリング後はそうする必要がなくなりました。
さらに重要なのは最悪ケースです。「40万トークン費やして、結局何も見つからなかった」という壊滅的な実行は、ほぼ全てリファクタリング前のバージョンで発生しました。「ほぼ」というのは、リファクタリング版でもHaikuが1回発生させたためです。そして、その発生場所が非常に示唆的です。彼らは1ファイルしかリファクタリングしておらず、Haikuは隣の手つかずの1,800行からなるemail_helpers.pyという雑多なファイルの中で迷子になりました。リファクタリングが床を引き上げましたが、新しい床は、手つかずのまま残った最も悪いファイルだったのです。
routes/email_routes.pyは現在6,032行。うち単一の関数setup_email_routes()が4,580行を占めます。つまり、この5日間でさらに1,000行以上増え、巨大関数は約700行伸びたことになります。これは本サイトがソースを取得して数えたもので、ブログには記載されていません。今取得すれば、また別の数字になっている可能性があります。節約したトークンで、何が得られるのか?
前の2つの実験は「どれだけコストがかかるか」を測ったものです。さらに重要なのは「安く済ませられるなら、正しく実行できるのか」という問いです。
彼らは2つのバージョンのメールコードに、4つの同一の隠れたバグを仕込みました(バイト単位で同一の変更なので、両バージョンは全く同じ欠陥を持ちます)。そして、4つのモデルに固定8ラウンドの検査予算を与え、これらのコードが要件通りに書かれているか確認させました。各モデルは各バグを2回確認し、各バージョンで32回のレビュー、2バージョン合計で64回のレビューを行いました。
Grok 4.5とGPT-5.6 Solは両バージョンで全て発見しました。8ラウンドあれば、検索に秩序立てて取り組めるモデルにとって、4,943行のファイル内でこれらの欠陥をgrepするのは十分可能なのです。
HaikuとSonnetはそれができず、モノリス版ではそれぞれ4/8と3/8しか発見できませんでした。失敗したレビューのほとんどは誤った回答をしていません。彼らは8ラウンドの予算を全てファイル探索に費やし、結論を出す前に時間切れとなっていました。リファクタリング後のコードでは、両者とも満点を獲得しました。
Sonnetの行は特に注目に値します。先ほどの検索実験では、彼はこのリファクタリングからほぼトークンを節約できませんでした。しかし、予算制限を加えると、正解率は3/8から8/8へと変わりました。巨大ファイルの中で「検索する余裕がある」ことと「その中で結論を導き出せる」ことは、別問題なのです。
AIフレンドリーなコードの書き方(実践的アドバイス)
メカニズムとデータの話はここまで。最後はすぐに行動に移せる部分です。
実験で使われたスキルファイルはMITライセンスで公開されています。本サイトが取得して読み終えたところ、ブログ本文には書かれていない、より実践しやすいルールがいくつかありました。
エクスポートするシンボルは2〜4語で命名し、そのうち少なくとも1つはビジネス用語にします。約70万行のモノレポでの実測では、1語のエクスポート名がグローバルに一意なのはわずか61%。3語で96%、4語以上で98%です。一意に検索できる最短の名前を使い、残りの説明はコメントに書きます。
人間もAIも質問は自然言語です。「rate limit」「retry delay」。ところがRateLimiterという識別子は、「rate limit」という検索にマッチしません。そこで、各エクスポートの上のコメントに、スペース区切りの普通の言葉でそのフレーズを書いておきます。SessionExpiryCheckerには「Checks whether the user session has expired」と添えておけば、「session expired」という検索がここに辿り着きます。
イベント名、フィーチャーフラグ、エラーコードをテンプレートで拼接してはいけません。github.${entity}.${action} のような書き方は、github.pr.merged をソースコード内で検索不可能な文字列にしてしまいます。冗長でも、完全な形で書くべきです。
ログに表示されるエラーが、その発生行へ直接検索で戻れるようにします。Webhook signature mismatch for ${id} と書き、${prefix}: mismatch のような書き方は避けます。
config.ts、types.ts、utils.ts、helpers.ts は、検索結果で何も語らず、リポジトリ内の他のあらゆるモジュールのconfig/types/utilsと衝突します。ビジネス用語を前置して billing-plan-config.ts のようにします。
生のデータベース接続ではなく、OrgScopedDb の受け渡しを要求します。スキルファイル内の原文はこうです。「コメントはお願い、必須の型は物理法則」。
これらのアドバイスのほとんどは新しいものではありません。説明的な命名、正確な型、「なぜ」を説明するコメント。私たちは数十年、互いにそう勧め合いながら、いつも実行できずに許してきました。なぜなら、人間は同僚に聞いたり、git blameを辿ったりできるからです。しかしAIにはそれができません。彼らが持っているのは、あなたの文章と型、そして一つの検索ボックスだけなのです。 — Modem エンジニアリングブログ
最後に、この結論の適用範囲について。著者が明記している限界は3つあります。このスキルは命名・ファイル分割・型・構造を同時に変更しており、節約できたトークンを命名だけに帰属させることはできません。Odysseusの表のトークン数は同じ行内でのみ比較可能で、ツールを跨いだ比較はできません。Odysseusの実験は1ファイルのリファクタリングのみです。さらに、著者が指摘していない限界が1つ、本サイトの見解です。スキルファイルはFable 5にこのブログ記事自体から抽出させたものであり、それを使ってこのブログ記事を検証するのは自己検証です。彼らはまた、grepの上に埋め込み検索を重ねることで効果があるというCursorの優れたデータにも言及しており、プレーンテキスト検索が唯一の解ではないかもしれません。ただし、grepもリポジトリマップも埋め込み検索も、入力として食べているのは同じものです。それは、あなたのソースコードに含まれる言葉です。
email_routes.pyの現在の行数は本サイトが2026-07-25にdevブランチを取得して実測したもので、ブログのデータは公開当時の状態です。AIがあなたのコードを読む手段は検索ボックスだけ。名前が曖昧だと、数百ファイルを読むまで手を出せない
Modemが1年間すべてのコードをAIで書き、この問題を対照実験に。図解で1ページにまとめました
↓ 1ページで読了 · 動く図あり
AIに関数の変更を頼むと、最初にやることはあなたのリポジトリの検索です。この「検索」はエディタでCtrl+Fを押すのと同義。リポジトリ全体の文字を走査し、その文字列が含まれる行を探します。
リポジトリ全体の文字を走査して一致を探す(CLIツールのgrep、AIは高速版のripgrepを使用)
ヒット箇所の前後を読む
足りなければ単語を変えて再検索
コンパイラが描く依存関係グラフ(コードを実行可能なプログラムに変換し、ついでに誤りをチェックする工程)
言語サーバー。エディタで「定義へジャンプ」ができるのは、これが働いているから
逆引き検索。関数の定義から、それを呼び出している全箇所を見つけること
SWE-agent もモデルに提供しているのはキーワード検索ツールです。ファイル冒頭のimport(発生源を示す行)も欠陥は補えません。前方しか指さず、今回のタスクは逆引きが必要だからです。つまり、あなたのコード内のすべての名前が、そのまま検索クエリになります。差はどれほどか。Modemが3つの関数で試しました。機能は完全に同じで、Stripeを呼び出すAPIクライアントを作成します。違うのは名前だけ。3回の検索はすべて40〜50ミリ秒。お金がかかるのはヒットの後です。AIはヒットしたファイルを順番に開いて読み、探しているものかどうかを判断します。読むたびにトークン(AIが読み書きするテキストの単位。一度の会話で扱える量や料金はこれで計算)を消費します。
節約になるのは今回だけではありません。コンテキスト(AIが一度に同時に記憶しておける範囲)は有限です。無関係なcreateを除外するのに使ったトークンは、今回の変更ではもう使えません。しかも、似て非なるマッチで埋め尽くされると、モデルがその情報を使う信頼性も低下します。
理屈はもっともらしい。では実際にどれだけ節約になるのか。ModemはFable 5にこの書き方を1ページの規約に圧縮させ、2つのライターモデルに同じ要件(リトライ・レート制限・署名付きの通知ライブラリ)を2回ずつ書かせました。1回は規約なし、もう1回は規約あり。4つのバージョンをそれぞれ同じ500ファイルに埋め込み、14のモデル・ツール組み合わせが各10問、3回ずつ実行しました。
誤答の内容は印象的です。この通知ライブラリの配信履歴はどこかと尋ねると、リポジトリ内の別の何かのSlack配信台帳を、確信を持って指し示しました。リネーム後は、似ているが違うコードは、明確に書かれた名前に対抗できません。
最後のグループはさらに本質を突いています。同じ4つのバグ、同じ8ラウンドの予算で、弱いモデルは4,943行・81個のウェブリクエストハンドラを1つの関数に詰め込んだ実ファイルから、3〜4つしか見つけられませんでした。彼らのほとんどは誤った回答をしたわけではなく、8ラウンドの予算を全てファイル探索に費やし、結論に至らなかったのです。この1ファイルを概念ごとに分割・命名したモジュールに変えると、両モデルとも満点を獲得しました。
上記の数字はすべてModem自身が設計・実施した実験であり、第三者はまだ再現していません。本サイトは2026-07-25に同じブランチを取得しましたが、あの4,943行のファイルはすでに6,032行に成長していました。
あの規約はModemがMITライセンスで公開しています(そのまま取得してプロジェクトに導入可能)。その中でも取り組みやすく、動作を一切変えないものを選びました。
validateConfig()
github.${entity}.${action}(userId: string, orgId: string)
ファイル名は役割だけを示し、リポジトリ内の全モジュールのconfigと衝突。動詞に目的語なし。イベント名はテンプレート拼接で、ソースコード内を検索できない。パラメータがすべて文字列で、順序を間違えてもコンパイラは沈黙。
validateSmtpConfig()
"github.pr.merged"
(userId: UserId, orgId: OrgId)
ファイル名にビジネス用語を付与。動詞と目的語をセットで。文字列は完全な形に。同種のIDに型タグを付与し、順序間違いは即コンパイルエラーに。しかも、そのエラーで指名されたタグが、次の検索語になる。
そして、直感に反するルールがもう一つ。人間もAIも質問にはスペース区切りの自然言語を使います(「rate limit」)。ところがRateLimiterのような連結された名前はフレーズ検索にマッチしません。そこで、各エクスポートの上のコメントに、普通の言葉でそのフレーズを書いておきます。Modemが約70万行のリポジトリで数えたところ、1語の名前がグローバルに一意なのは61%。3語で96%に達し、3語が分岐点です。
作る関数の名前を変えて
あるのは
検索ボックスのみ
文字を走査して、
その文字列が含まれる行を探す
- × コンパイラの依存関係グラフ
- × クリックで定義へジャンプ
- × 定義から呼び出し元を逆引き
足りなければ単語を変えて再検索。
ダミーデータ、DB挿入、
バックグラウンドタスク…
このクライアントと無関係
定義、呼び出し元、テスト、
すべて同じものを指す
高いのはどこ?
どの行が目的のものかは、
ファイルを開かないと分からない。
作業はまだ一字も
すべてトークン消費が減る:
6%〜66%、中央値で3割減。
自信満々の誤答はゼロに