AIで700人分を削減、それでもKlarnaは「質が落ちた」と言った
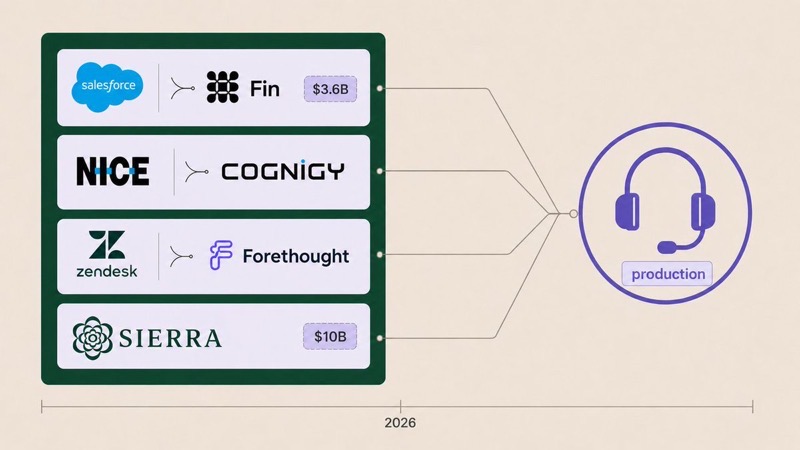
- 2026年6月前後、Salesforceが約36億ドルでFinを買収、NICEがCognigyを買収、ZendeskがForethoughtを買収、Sierraは評価額100億ドルに——AIカスタマーサポートが一斉に企業の中核予算に入り込んだ。
- Klarnaは2024年2月、AIカスタマーサポートが問い合わせの3分の2をカバーし、フルタイムオペレーター700人分に相当すると公表した。約1年後、CEOはコストばかり見ていたせいで「質が落ちた」と認めた。
- 阿里巴巴が256万件の会話を対象に行った4週間のランダム化実験では、AIによって問題把握のスピードが8.2%速くなり、その場の満足度も1.2%上がった。だが3日以内に同じ問題で再度連絡する確率は統計的に変化していなかった。
- 現行の主要4指標(自動解決率/処理時間/有人エスカレーション率/1件あたりのコスト)は、すべて企業側の視点でコスト削減を数値化したものだ。自信満々な誤答一つでも、全指標を良く見せることができる。
- 筆者Luciusは新しいフレームワークを提示する——サポート品質 = 解決率 × コンテキスト × 信頼 × 学習 × 体験。コスト削減に代えて、ユーザーの全体験ジャーニーを中核指標に据える。
たった1ヶ月で4件の大型買収、AIカスタマーサポートが一気にメインステージへ
2026年6月15日、SalesforceはAIカスタマーサポート企業Finを約36億ドルで買収すると発表した。同じ時期にNICEはCognigyを、ZendeskはForethoughtを買収し、Sierraは新たな資金調達を完了、評価額は100億ドルに達した。

Klarna:指標はすべて青信号、それでも1年後にCEOは「間違えていた」と語った
旧来の評価表は、第一世代のAIカスタマーサポートに華々しい成績を与えていた。
2024年2月、KlarnaはAIアシスタントが稼働開始から最初の1ヶ月で230万件の会話を処理し、サポート依頼の約3分の2をカバー、業務量にしてフルタイムオペレーター700人分に相当すると発表した。平均解決時間は11分から2分に短縮され、同社はその年の利益改善効果を約4000万ドルと見込んだ。サポート予算を管理する立場からすれば、これ以上ない数字だった。

- 2.3M 最初の1ヶ月の会話数
- ≈700 フルタイムオペレーター換算
- 11→2 分、解決までの時間
- $40M 見込み利益改善(自社推計)
同社は「コストばかりに気を取られ」た結果、「lower quality(品質の低下)」を招いたという。CEOのSebastian Siemiatkowski氏は、有人サポートの重要性を改めて強調した。
この二つの主張は矛盾なく両立する。AIは確かに多くの会話を処理し、確かにコストを押し下げた。問題は「成功」という言葉の定義にある。
今の評価表は、企業がいくら節約したかしか測っていない
自動解決率、平均処理時間、有人エスカレーション率、1会話あたりのコスト——この主要4指標はすべて企業側の視点で数値化されたものだ。待ち時間がどれだけ短縮されたか、有人対応がどれだけ回避できたかは教えてくれるが、ユーザーが正しい答えを得られたか、同じことを何度も言わされていないか、複雑な問題に誰かが対応したかには答えてくれない。
ここでキーワードになるのが「転送率(Deflection rate、偏向率とも呼ばれる)」だ。AIが自力で解決し、有人対応に回さなかった会話の割合を指し、有人に渡されなければそれだけで「成功」とみなされる。
並んでいる人をセルフサービス端末に誘導しただけで「対応完了」とし、その人が実際に用事を済ませられたかどうかは誰も記録しない、というようなものだ。
「転送率」が目標になると、プロダクトはいくつかの動きに引っ張られる——ユーザーをできるだけ自動化の中に留める、有人対応への切り替えを先延ばしにする、曖昧な質問を既存の回答に無理やり当てはめる、片付けやすいチケットを優先的にクローズする。どの動きも自動化指標を良く見せる一方で、ユーザー体験を悪化させかねない。自信満々な誤答でも、そのまま「成功」としてカウントされる。
ユーザーは自動化フローの中で何度も同じことを繰り返させられ、システムはそのたびに「効率的な対応」として記録する。たとえ最終的にユーザーが諦めたとしても、処理時間もチケット数も見た目は悪くない。第一世代のAIカスタマーサポートは自動化そのものはよくできていた。弱点は、企業が節約したコストを、ユーザーが得た結果と取り違えたことだ。
阿里巴巴の256万件対話実験が示した、精確な数字の亀裂
4週間にわたるランダム化実験で、阿里巴巴は5940人のオペレーター、約256万件の会話、39万件のユーザー評価を観測した。生成AIを導入した後、いくつもの指標が同時に改善した。

最初の4項目はいずれも改善していたが、最後の1項目——3日以内に同じ問題で再びサポートに連絡する確率だけは統計的に有意ではなかった(検出可能な変化がなかった)。しかもこれこそが、この中で唯一「問題が本当に解決したか」を測る指標だった。
スピードは速くなり、その場でのユーザーの印象も良くなった。だが、後で戻ってくる割合は下がらなかった。速さと満足感は体験のごく一部しか説明しない。問題が結果にたどり着いたかどうかは、また別の話だ。
新フレームワーク:「いくら節約したか」から「ユーザーの旅が完結したか」へ
企業のカスタマーサポートがユーザーの旅路全体を背負うのなら、評価表もその旅路全体をカバーしなければならない。Luciusはサポート品質を、同時に測定すべき5つの次元に分解した。
前世代のダッシュボードが数えていたのは、AIが何件返信したか、何人時分の人件費を節約できたかだった。このフレームワークが答えようとするのは5つの問いだ——ユーザーは結果を得られたか?コンテキストは追いついていたか?今回のやり取りで信頼を消耗しなかったか?今回の経験が次回をより良くしたか?ユーザーはこのコミュニティに留まりたいと思うか?それぞれの層を開いて、旧来の体系が何を測っていたか、この層が何を補うかを見てみよう。
1解決率問題は結果にたどり着いたか?+
転送率、処理時間——待ち行列が縮んだかしか見ない。
タスク成功率、初回対応解決率、再連絡率、チケット再オープン率、そして明確な担当者と次のステップがあるかどうか。
2コンテキスト情報は追いついているか?+
ナレッジベースの規模、詰め込んだ文書の量。
「企業の状態+ユーザーの状態」のリアルタイムなスナップショット。内容が最新で、範囲が明確で、実行可能かどうか——流暢に答えていても、それが旧バージョンの答えでは意味がない。
3信頼今回、関係を消耗しなかったか?+
ほぼ測らない。AIは企業の名の下に返信し、一言間違えればそれも企業の約束としてカウントされる。
情報が不足したときに立ち止まれるか、勝手な約束をしないか、デリケートな問題を非公開の流れに切り替えられるか、返金やコンプライアンスに関わる約束で証跡を完全に残せるか、問題が起きたときに責任を追跡できるか。
ITProがSinchの調査を引用したところによると、回答企業の74%が、ガバナンス上の失敗を理由にカスタマーサポートAIエージェントをロールバックまたは停止した経験があるという。主な理由は、顧客データの漏洩31%、ハルシネーションまたはブランドリスク22%、監査可能性の欠如16%。企業が気にしているのは、AIが人間らしく見えるかどうかではなく、安心してサービスを任せられるかどうかだ。

4学習今回の経験が次回をより良くしたか?+
測らない。すべての会話は一回限りで、処理が終わればそこで終了。
不確かな問題がシステムの新しい知識になったかどうか。ユーザーが今回ハマった落とし穴、詰まったポイント、最後にたどり着いた突破口が、次回再利用できる経験として蓄積されたかどうか。
5体験ユーザーはまだ留まりたいと思うか?+
満足度スコア一つが、プロセスの中で起きたすべてを覆い隠してしまう。
ユーザーが元の場面のまま理解されたのか、それとも別の窓口に飛ばされ、再ログインし、フォームに記入し、問題をもう一度説明させられたのか。公開される一つひとつの返信が、その組織が助けを求めた人をどう扱うかを物語っている。
一つの例:初心者が初めて自分のアイデアでプロジェクトを作った話
あるツールコミュニティで、初心者が初めて自分のアイデアでプロジェクトを作ろうとした。ワークフロープラットフォームとローコードツールをつなぎ合わせ、記事の内容とAPI認証情報を入力すればワンクリックで下書きに送信できるページを作りたかったのだ。プロジェクトはレスポンス構造、APIフィールド、変数バインディング、結果表示、60秒タイムアウトのあたりで詰まったが、最終的に一連の流れは動くようになった。終わった後、彼はコミュニティのAIキャラクターに、最初の一言から全体を再利用可能な手順としてまとめさせた——プロジェクトの目標、全体のアーキテクチャ、5つのフェーズ、それぞれのエラー、現在の状態、次のステップを含めて。彼は、自分のアイデアで何かを作り出せたと初めて感じられたと語った。AIはまるでプロセス全体を記憶していて、一緒に前へ進んでくれるようだったという。データベースから答えを探すだけの旧式のカスタマーサポートには、こうしたエンドツーエンドの伴走はできない。
本当の「解決」は、ユーザーが口を開けるかどうかから始まる
解決は「AIが答えたかどうか」から始まるのではない。ユーザーが口を開こうとするかどうかから始まる。
教育心理学には「開口不安(Question-asking anxiety)」という関連概念がある。相手が権威的で、フォーマルで、自分を評価してきそうだと感じると、人は自分の質問を検閲し始める——馬鹿げていないか、素人っぽく見えないか、相手の迷惑にならないか、と。カスタマーサポートでも同じだ。あまりに堅苦しく冷たい窓口は、ユーザーに質問する「資格」があるかどうかを先に量らせてしまう。定型回答しか返さない公式窓口は、多くの初期の疑問をユーザーの頭の中に押し戻してしまう。いざ本当に助けを求めてくる頃には、問題はたいてい既により複雑になっている。
速さには意味がある。ユーザーが口を開いたばかりのとき、問題はまだ新鮮で、感情もまだ発酵しておらず、足りないコンテキストも補いやすい。このタイミングでシステムがユーザーを別の窓口に放り出したり、フォームへの記入を求めたり、メールを待たせたりすれば、次はもう質問してくれないかもしれない。本当の解決とは、システムがユーザーに結果への道筋を見せることだ——誰が担当するのか、次に何が起きるのか、いつ更新があるのか、今どこで止まっているのか。ユーザーを別の担当者、別のチャネル、別のフォームに回すことは、問題が別の場所に移動しただけの証拠にすぎない。誰が処理するのか、いつなのか、どこまで進んだのかをユーザーがまだ知らなければ、問題は一歩も前進していない。
これはちょうど、阿里巴巴の実験で見えたあの亀裂と呼応する。AIはその場の印象を良くしたが、再連絡率は下がらなかった。これは「速く答える」ことが「正しく答え、次のステップを示す」こととイコールではないことを示している。
Luciusが「解決率」を測る8つのシグナル
タスク成功率・初回対応解決率・再連絡率・チケット再オープン率・解決所要時間・エスカレーション成功率・担当者アサイン率・次のステップが明確か(多少主観的な判断を含む)。
コンテキストとはナレッジベースではなく、同時進行する2本のリアルタイムのレールだ
コンテキストには、同時に変化し続ける2つの記録が入っている——企業の状態とユーザーの状態だ。どちらか一方でも欠けていれば、古い答えで新しい問題に答えることになる。

多くの企業はナレッジベースの規模を誇りにしている。だが本番環境はもっと難しい問いを突きつけてくる——その内容はまだ正しいのか?機能は変わり、価格は変わり、ポリシーは変わり、担当者は発言を変え、ユーザーは新しい約束を受け取る。文書が古くなっても、AIは相変わらず答えてくれる。ただ、流暢な言葉で古い答えを返してくるだけだ。コンテキストが役に立つのは、それが最新で、範囲が明確で、実行可能である場合に限る。
ここで区別しておきたい言葉が「ワーキングメモリ(Working memory)」だ。AIがこのチケットを処理する過程でリアルタイムに記録している帳簿——何を収集したか、どんな操作を実行したか、現在どのステップで止まっているか。
それはカルテ(ナレッジベース)ではなく、「この手術は今どこまで進んでいるか」を記録するリアルタイムの手術記録のようなものだ。
1億人超のユーザーにサービスを提供するNubankのカスタマーサポートシステムでは、指示、フロー、マクロ、ツールの説明、ワーキングメモリが、それぞれ独立してバージョン管理されるコンポーネントとして扱われている。ワーキングメモリには、収集済みの情報、ツールの実行結果、現在どこまで処理が進んでいるかが記録される。確信度の低い問題が有人対応に回されるときは、会話全体のコンテキストがそのまま引き継がれ、ユーザーが自分で「コンテキストの運び屋」になる必要はない。これはプロンプトに文書を無理やり詰め込むよりも、本番運用に耐えるコンテキスト管理に近い——システムは現在の事実を知っていると同時に、タスクの現在の状態も知っていなければならない。
月1回のナレッジベース更新では、その間の変化はすべて古い答えで処理されてしまう
同じコンテキストでも、メンテナンスのリズムが違えば、AIが古い答えで新しい問題に答えてしまう確率も変わってくる。
従来のナレッジベース運用はここで詰まる。多くのチームは以前、月に1回しか文書を更新していなかった。更新しても、AIが正しい箇所を検索できる保証はなく、そのため文書をどんどん細かい断片に切り分けていった。細かく切ることが必ずしも検索精度を上げるわけではなく、むしろ似たような断片を増やし、どれがまだ有効なのかをシステムが判断しづらくしていた。

チームは文書を手動でメンテナンスする必要がない。Luciusは不確かな問題を彼らにルーティングし、彼らはメッセージに返信するような感覚で答えるだけで、システムはそれを学習する。逆に言えば、もしこの400件の更新が月1回の手動整理に圧縮されてしまえば、その間に起きた大量の新しい発言、例外、ユーザーへの約束、製品の変化は、その空白期間の中で消えてしまう。こうしたコンテキストに手が届かないシステムは、古い答えで新しい問題に答えることしかできない。
需要はすでに目覚めた、だが応えられる企業はまだ追いついていない
市場は方向性を見出したが、移行はまだ完了していない。このギャップこそが、先に動いた者にとっての好機だ。
大半の企業はいまだに旧システムに縛られている——文書は各所に散らばり、過去の会話はチャンネルの奥に埋もれ、サポートフローとコミュニティの現場は分断され、有人への引き継ぎには証跡がなく、AIの返信には境界も記憶もない。多くの人はAIカスタマーサポートの問題を「人間らしさが足りない」と読み違え、口調やキャラクター設定、アイコン、挨拶文を何度も磨き上げる。だがユーザーが本当に気にしているのは別のことだ——システムがその問題を本当に理解しているかどうか。Luciusによれば、同社のシステムを使うサポートコミュニティでは、ユーザーが自ら有人対応への切り替えを求める割合を0.1%未満に抑えられるという(Lucius自社サンプル)。
「口を開いた瞬間にシステムが自分が誰かを分かってくれて、繰り返す必要がなく、前回どこで詰まったかも覚えていて、必要なときにはちゃんと人を呼んでくれる」——そんな体験を一度でも味わってしまえば、旧式のカスタマーサポートはダイヤルアップ回線のように時代遅れに見えてくる。前世代のチャットボットでユーザーを引き留め続けている企業は、いずれ追いつく必要に迫られる。そしてその頃に直面するのは、もはや技術調達の問題ではなく、信頼回復の問題だ。
第一世代のAIカスタマーサポートは企業を中心に作られていた。次の世代は、ユーザーの旅路全体を中心に作られる。Lucius / X・2026年6月29日
AIカスタマーサポートはコストを削減した、だが間違ったものを評価している
AIカスタマーサポート製品を手がけるLuciusが振り返る——Klarnaは1年で前言撤回、阿里巴巴の256万件の会話、いずれも同じ測定上の盲点にぶつかった。1ページ、図付きで読み切る。
↓ 1ページで読み切る・動く図が1枚あります
AIカスタマーサポートとは、AIボットが人に代わって顧客のアフターサービスの問い合わせに答える仕組みのことだ。2026年6月のわずか1ヶ月間に、Salesforce、Zendeskなどが立て続けに4件の大型買収を行い、一気に大企業の中核予算へと押し上げた。
だが、その良し悪しを判断するための評価表は、すべて企業側の帳簿でしかない。
✘ 算出できないもの:ユーザーが正しい答えを得られたか、同じことを何度も言わされていないか、複雑な問題に誰かが対応したか
主要4指標(自動解決率/処理時間/有人エスカレーション率/1件あたりのコスト)はすべて企業側でお金を数えているだけで、ユーザー側で問題が解決したかどうかはそもそも測っていない。
まず、矛盾を白日の下にさらした実例を見てみよう。
- 最初の1ヶ月で230万件の会話を処理、依頼の3分の2をカバー
- フルタイムオペレーター約700人分に相当
- 平均解決時間 11 → 2分
- その年の増益見込み 約4000万ドル(自社推計)
同社は有人カスタマーサポートを再び採用した。CEOは「コストばかりに気を取られ」た結果、「質の低下」を招いたと認めた。同じシステムから、二つの結論が生まれた。
コスト削減は事実であり、質の低下も事実だ。この二つが同時に成立するということは、評価表が測っているものが間違っているとしか言いようがない。なぜこの二つが両立できるのか?下の動く図を見てほしい。
小互(シャオフー)の返金問題が自動サポートに入った。業界にはこんな暗黙のルールがある——ボットが自力で受け止め、有人対応に回さなければ、それだけで「成功」とみなされる(この割合を転送率と呼ぶ)。すると、この後起きることは、企業のあらゆる指標を良く見せることになる。
小互の返金問題は自動サポートの中で空回りし、最後には諦めることになった。それでもシステムはそれを「効率的な対応」として記録する。Klarnaの月間230万件という会話数は、こうして華々しい指標を作り出していた。
阿里巴巴は4週間にわたるランダム化実験を行った。サンプルは問題を語るのに十分な規模だ。まず公式の数字を時間の感覚に換算してみると、確かに応答は速くなっている。
速いのは事実だ。だがそれは体験の半分にすぎない。
最後のこの数字だけは動かなかった——小互たちが同じ用件で戻ってくる割合は、まったく下がらなかったのだ。速く返ってくることは、問題が本当に解決したこととイコールではない。
AIカスタマーサポートは企業の中核予算に食い込んだばかり。
最大は36億ドル。
有人対応には回さなかった。
ボットはまだ同じところをぐるぐる回っている。
こうして華々しい数字を作り出した。
256万件の会話。
また聞き直しに来る割合。」
「本当に解決したか」を測る唯一の指標。
信頼 × 学習 × 体験
「問題が完結したか」を問い直す。
- × 数字はすべて各社の自社測定
- × 第三者による再現はない
- × あの新しい物差しも、ベンダーLucius自身が出したもの
問題が本当に解決したこととは違う。」
まずこう問い直そう: