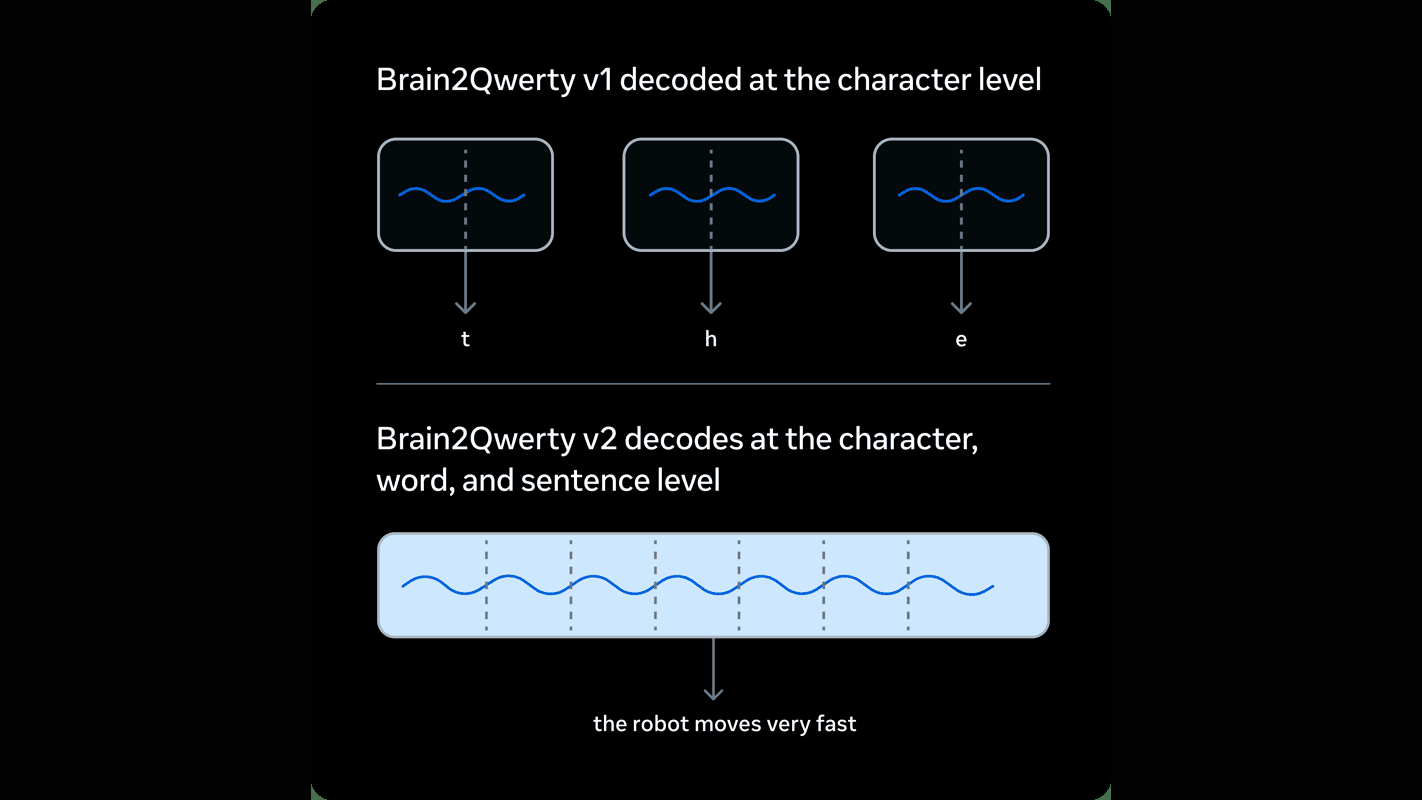
開頭手術なしで脳波が読める、Meta の非侵襲型が同種手法の約8倍の精度に
- Meta が Brain2Qwerty v2 を発表。MEG(脳磁図)デバイスを装着するだけで、脳が発する磁気信号をリアルタイムで一続きの文章に解読できる。手術は一切不要。
- 単語正解率は61%に到達、他の非侵襲型脳機インターフェース手法(8%)の約7.6倍。最も成績の良い参加者は78%に達し、半数以上の文で誤りが1語だけだった。
- 核心は二層構造の積み重ね:エンドツーエンドの深層学習で生の脳磁信号から直接解読し、さらに神経データでファインチューニングした大規模言語モデルで意味的な補正をかける。
- 9名の参加者がそれぞれ約10時間のタイピング課題を記録し、合計約2万2千文の訓練データを収集。正解率はデータ量に対して対数線形に向上する。
- v1/v2 の訓練コードは完全公開。共同研究機関 BCBL も同時に v1 データセットを公開。世界中で脳損傷によりコミュニケーション能力を失った数百万人の患者に向けたもの。
ヘルメットを被るだけで、脳波が文字に変わる
Meta AI は2026年6月、現時点で最高性能の非侵襲型脳機インターフェースシステム Brain2Qwerty v2 を発表した。MEG(脳磁図)信号をリアルタイムで一続きの文章に解読でき、v1・v2 の完全な訓練コードも同時に公開された。
開頭せず、皮膚にも触れないヘルメットを被るだけで、タイピング時に脳が生み出すごく微弱な磁気信号をリアルタイムで文字に復元できる。文全体の単語正解率は61%に達した。
手術を必要としない同種の非侵襲型手法は、これまで単語正解率が8%しかなく、ほぼ実用にならなかった。v2 の61%はその約7.6倍にあたる。無創脳機インターフェースが、脳に電極を埋め込む必要のある侵襲型技術に、文全体のリアルタイム解読という点で初めて肉薄した瞬間だ。

従来の手法は、効果がないか、開頭が必要かのどちらかだった
この数字がなぜ注目に値するかを理解するには、脳機インターフェースが長年どこで行き詰まっていたかを見る必要がある。脳信号を文字に変える方法は、これまで2つの道しかなく、それぞれに越えられない壁があった。一方は精度は高いが手術が必要、もう一方は安全だが精度が出ない。
| 比較軸 | 侵襲型(SEEG / ECoG) | 従来の非侵襲型手法 |
|---|---|---|
| 単語正解率 | 高く、コミュニケーションの回復に既に実用化 | わずか8%、ほぼ実用にならない |
| 手術の要否 | 開頭が必要、電極を脳皮質に埋め込むか貼り付ける | ヘルメットを被るだけ、完全非侵襲 |
| 信号品質 | クリアで信号対雑音比が高い | ノイズが多く、細部の損失が大きい |
| 普及可能性 | 手術リスクがあり、大規模普及は困難 | 安全で使いやすいが、正解率が実用に届かない |
侵襲型の立体定位脳波記録(SEEG)や皮質脳波記録(ECoG)は、神経信号を AI 解読器に渡すことで、失語症の人が再びコミュニケーションを取れるようになることを既に証明している。問題は手術が必要で、数千万人規模には広げられないことだ。安全性と使いやすさは、これまで両立できなかった。これこそが v2 が解こうとした矛盾である。
侵襲型は、歌手の喉に直接マイクを突っ込むようなもの。録音はクリアだが手術が要る。非侵襲型は、コンサート会場の外で録音するようなもの。安全ではあるが、頭蓋骨と頭皮を隔てているためノイズが大きく、細部が大きく失われる。難しいのは、会場外の雑音混じりの録音から、会場内で歌われている一語一語をどう聞き取るかだ。
二層構造の革新:自ら学習し、言語モデルが意味を補う
v2 が正解率を8%から61%まで引き上げたのは、積み重なった2つの改良によるものだ。一方はモデル自身に生の信号からパターンを学ばせること、もう一方は言語モデルで推測した断片を完全な文へと補完することだ。
従来の手法は、多段階の手作りパイプラインだった。まず人手で作ったルールで「この磁場の揺れはどのキーが押されたことに相当する」を検出し、次に特徴量エンジニアリングを行い、それを分類器に渡す。各ステップで信号の意味を推測しており、誤差が段階ごとに積み重なっていく。v2 はこの仕組みを丸ごと捨て、生の脳磁信号を直接深層学習モデルに入力し、2万2千文・9人分のデータから信号から文字への写像を自ら学習させる。途中に人手は介在しない。
ノイズの中から絞り出した解読結果は、しばしば断片的で不完全な文字列になる。v2 はさらに、神経データでファインチューニングした大規模言語モデルを重ね、文脈を取り込みながら、意味に基づいて断片を補完・修正し、雑音混じりの脳信号を滑らかな文へとつなげる。
地下鉄の中で、相手の言葉が半分しか聞き取れなかったとしても、文脈と経験を頼りに文全体を推測できることがある。この大規模言語モデルの層がやっているのはまさにそれだ。生の解読結果は曖昧な半分の文しか出さないが、それを意味によって完全な文へと復元する。
従来のパイプライン vs 新モデル、クリックして構造の違いを見る
約7つの手作業工程が連なり、つなぎ目のたびに信号の意味を推測し、誤差が段階的に積み重なる。
生の信号が1つのモデルに直結し、あとは言語モデルが意味を補う。手作業のパイプラインはもう存在しない。


従来の方法は、方程式の解き方を教える先生のようなもの。まず公式を説明し、手順を示し、問題パターンを当てはめ、一歩ずつ教え込む。エンドツーエンドは、10万問を答えごとまとめて渡し、途中の解き方は教えず、自分で規則を悟らせるやり方だ。
AI によるパラメータ調整に関する補足
Meta は解読フローの最適化方向を探るために AI エージェントも活用したが、最終的な訓練設定はエンジニアが人手で選んで確定したものであり、完全自動生成ではない。
信号はどこから来るのか:ヘルメットを被って10時間タイピング
モデルがどれほど賢くても、データがなければ学習できない。v2 のデータは素朴なパラダイムから得られている。実際に人にタイピングをしてもらい、その間 MEG でキー入力ごとの脳の磁場変化を記録する。
重要な点に注意したい。参加者は実際にタイピングしており、「話すことを想像する」のではない。タイピングという動作は神経信号がより安定していて信頼性が高く、キー入力のタイミングも文字と正確に対応させられるため、訓練サンプルの品質がより高くなる。
MEG はヘルメット型センサーの一種で、超高感度の磁力計を使い、神経細胞が発火する際に生じるごく微弱な磁場変化を捉える。普通の脳波帽(EEG)より精度が高い。脳に磁場マイクのアレイを装着したようなもので、録るのは音ではなく、神経細胞が発火する「電磁的なブーンという音」だ。
61%、78%、誤差1語——数字がどれだけリアルか
3つの数字を並べれば、今回の跳躍の大きさと、61% が実際の体験としてどの程度のものかがはっきり見えてくる。
61%とは、10語の文なら平均6語が合っているという意味だ。最高成績の参加者の78%になると、体験としてはかなり実用的だ。半数を超える文で、文全体の誤りが1語のみ、または完全に正しい——10語の文で誤りはわずか1語だ。
解読された文の中で、正しく予測できた単語が全単語に占める割合を指す。61%は平均10語のうち6語が合っている状態、78%は8語近く合っている状態だ。
Meta はさらに一つの法則を見出した。解読正解率はデータ量に対して対数線形で増加する。データ量が倍になるたびに、正解率は安定して一段上がる。つまり体系的にデータを拡充し続けるだけで、侵襲型手術方式との残りの差も縮まっていく見込みがある。
誰が使えるようになるのか、実用化までどれくらいか
この研究が最も直接的に指し示すのは、「話したいのに話せない」人たちであり、また現時点でまだ越えていない壁でもある。
- 直接の恩恵を受ける対象:脳卒中や ALS(筋萎縮性側索硬化症)などの脳損傷により言語能力を失ったが、運動野は無傷のままの患者。世界に数百万人存在する。非侵襲であることは、開頭手術のリスクを負わずに利用できる可能性を意味する。
- 現時点での制約:現在のシステムは一人ひとりに合わせた訓練が必要で、まず約10時間分の個人データを記録する必要があり、そのまま誰でも使える汎用化にはまだ届いていない。
- 今後の道筋:訓練コードと BCBL データセットの公開に加え、Meta が Digital Brain Project を通じて設立した500万ドルの基金により、より大規模な公開データでシステムの汎用化を目指す。
何が公開されたか、どこで見つけるか
より多くのチームがそのまま引き継いで開発を進められるよう、Meta は今回、訓練コードとデータセットを一緒に公開した。
- 訓練コード:Brain2Qwerty v1 と v2 の完全な訓練コードがいずれも公開されている。
- データセット:共同研究機関 BCBL(バスク認知・脳・言語研究センター)が v1 データセットを公開。HuggingFace(リポジトリ bcbl190626/SpanishBCBL)でホストされている。
背景:Meta のオープンな脳科学基盤モデル体系
この研究は、Meta が構築するオープンな脳基盤モデル群の一部だ。あわせて、知覚エンコーディングを担う Tribev2、脳データを大規模に処理する NeuralSet、モデルを体系的に評価する NeuralBench も存在する。Meta は、閉じた環境でそれぞれが研究するよりオープンな協業の方が、神経系疾患の特定・診断・治療を早く進められると述べている。
Brain2Qwerty v2 は、現時点で最高性能のエンドツーエンドシステムであり、非侵襲型の脳記録からリアルタイムで文全体を解読できる。これまで脳外科手術を要する技術でしか到達できなかった精度水準に近づきつつある。 Meta AI Blog · From Brain Waves to Words(2026年6月)
開頭せずに脳波を読む:非侵襲型脳機インターフェースが「ほとんど読み取れない」から「リアルタイムで文全体を読める」へ
Meta が Brain2Qwerty v2 を発表。ヘルメットを被るだけでタイピング時の脳磁信号をリアルタイムで一続きの文章に復元、単語正解率は8%→61%。図付きで一枚に凝縮。
↓ 一枚で読み切り · 動く図が1つあります
脳機インターフェース(手を動かさず、口も開かず、脳活動を直接文字や操作に変換する技術)は、長らく失語症の人が再びコミュニケーションを取るための希望だった。しかし脳信号を文字に変える方法には、これまで2つの道しかなく、それぞれに越えられない壁があった。開頭手術をするか、そもそも精度が出ないかのどちらかだ。
✘ しかし読み取れる文はわずか8%しか単語が合っておらず、ほぼ使い物にならなかった
頭蓋骨と頭皮越しに採取するため、脳信号は弱く雑音も多く、細部が大量に失われる。精度良く読み取ろうとすれば、これまでは開頭して電極を埋め込む(侵襲型)しかなく、手術リスクがあり数千万人規模には広げられなかった。
今回 Meta が発表した Brain2Qwerty v2 が実現したのは次のことだ。同じくヘルメットを被るだけで開頭なし、非侵襲型手法の単語正解率(読み取った文のうち何割の単語が合っているか)が8%から61%に向上、最も成績の良い参加者は78%に到達。手術をしない方式が初めて開頭が必要な水準に肉薄した。対象となるのは、脳卒中や ALS(筋肉の制御を徐々に失っていく病気)などの脳損傷で話せなくなった、世界中の数百万人だ。
疑問はここだ。被っているのは同じヘルメット、信号も同じくらい雑音だらけなのに、なぜ正解率が何倍にもなったのか。鍵は手法にある。
8%から61%への跳躍は、高価な機材によるものではなく、手法上の2つの改良によるものだ。1つ目は「エンドツーエンド」——人が一歩ずつ信号の意味を推測する代わりに、生の脳磁信号を直接 AI に渡し、信号から文字への規則を自ら学ばせること。2つ目は、言語モデル(ChatGPT のような文章を書けるモデル)に文脈から、読み取られた断片的な文字列を一続きの文へと補わせることだ。
正解率61%と言われてもピンとこないが、「10語の文なら、実際何語間違えるのか」に換算すると実感が湧く。バーは短いほど良い。
これまで2つの道、
開頭して電極を埋める
精度が出ない……
ほぼ使い物にならない。
従来手法の7.6倍。
脳が目覚めたのかな?
自ら規則を学ばせる。
「わた…水…飲」
文全体を推測できるのと同じ。
10時間タイピング。
誤りは文全体でたった1語。
でも頭ははっきりしている人、
世界に数百万人。
文全体として読み取られ、手術方式に肉薄した。
- × 数字は Meta の自己測定、たった9人
- × 一人ひとりまず約10時間分の個別調整
- × まだ誰でも使える段階には届いていない