Cerebras が公開した社内ナレッジベースの作り方:誰にも使い方を変えさせず、資料は元の場所に置いたままAIが自分で取りに行く
- Cerebras のエンジニア3名が、社内ナレッジベース「Cerebras Knowledge」の作り方を公開した。公開から3か月で1日15000件超の質問をさばいており、質問者には社員だけでなく自動化スクリプトや Agent も含まれる。
- 誰にも使い方を変えさせない設計になっている。資料は引き続き Slack、コードリポジトリ、ドキュメントシステムに残したまま、システム側が各プラットフォームからデータを取りに行き、すべて同じ Postgres の1テーブルに集約する。
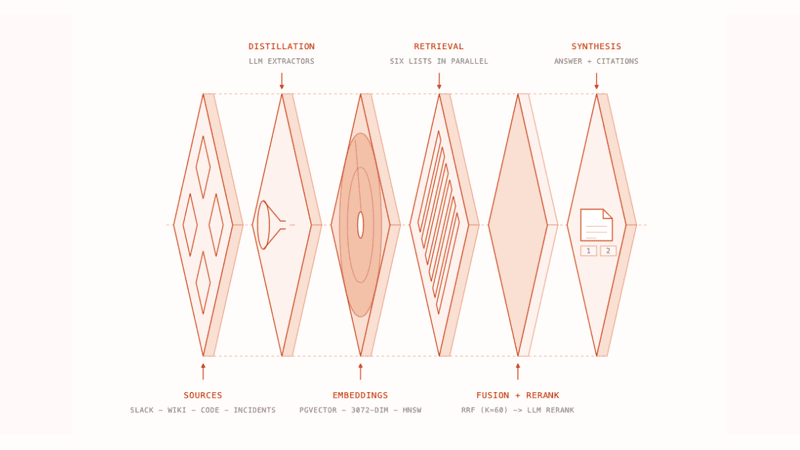
- もっとも手強いソースは Slack。同じ候補集合に対して、全文一致、ベクトル一致、レア単語の重み付け、時間減衰という4種のスコアリングを同時にかけ、それぞれの盲点を補い合う。
- チャット履歴はそのままベクトル化しない。まずモデルが「一言の質問文+要約+結論+関連システムとコードシンボル」という統一構造に蒸留してから埋め込む。
- 6つの検索器がそれぞれランキングを出し、それを Reciprocal Rank Fusion(RRF)で1本に合成する。定数は60を採用しており、「複数のランキングで上位に入る」文書が「1本のランキングで1位」の文書に勝つ効果が出ている。
1日15000件の質問、その中には Agent からのものも
Cerebras のエンジニア3名が最近、自社ブログで社内ナレッジベース「Cerebras Knowledge」の作り方をまるごと公開した。データ収集から回答のランキングまで、各層でどんなパラメータを使ったかがすべて書かれている。
このシステムは公開から3か月、1日15000件超の質問をさばいている。質問しているのは社員だけでなく、自動化スクリプトや Agent も含まれる。
これを引き起こしている状況は多くの企業に馴染み深いものだ。Cerebras のチームはデータセンター運用、チップ設計、ハードウェア、トレーニング、推論、クラウドプラットフォームなど各方面に分散しており、毎年数百人の新人が入ってくる。コミュニケーションチャンネルは同じ3種類の質問で埋め尽くされる——あれはどこにある、これは誰が一番詳しい、この用語はどういう意味か。

資料を1か所に全部集める、なぜこれまで一度も成功しなかったのか
社内で資料を探すのが難しいのは、検索そのものが難しいからではなく、資料が生まれつき散らばっているからだ。四半期ごとに誰かが同じ「絶妙な案」を出す——今後すべての情報を1つのプラットフォームに記録し、唯一の真実の情報源にしよう、と。この構想は実践でほとんど成功したためしがない。
理由は、情報はどこで作るのが便利かによって生まれる場所が決まるからだ。ドキュメントの中の修正提案、Slack のスレッド、GitHub のコード参照、Jira のステータス欄。これらのプラットフォームはそれぞれの用途に何年もかけて磨き上げられてきた。Google Docs で pull request を議論するのは、体験としてかなりひどいものになる。
そのため Cerebras の最初の決断は、既存の習慣をほぼ変えさせないシステムを設計することだった。収集側のやり方は、各プラットフォームから直接データを抜き出すというものだ。
- 今後すべて統一プラットフォームに書くよう要求する
- 一人ひとりに手間が1つ増え、数週間で元に戻る
- 過去の資料は元の場所に残ったまま、両方とも不完全になる
- 人は引き続き一番使いやすい場所に書く
- ソースごとにコネクタを1本書いてデータを取りに行く
- 取ってきたものを統一フォーマットにして、同じテーブルに落とす
システム全体の核は、1枚のテーブル
このナレッジベースが外部に提供するのは3つ:社内データを置く場所、そのデータを検索する場所、そして認証・権限制御・監査・統計を担う層だ。
核となるのは Postgres の1テーブルで、そこにベクトル、元の要約、メタデータが出どころを問わず同居している。システムは社内各所のデータを継続的に流し込み、常に検索可能な状態を保つ。データインターフェースは意図的にシンプルに作られている。Slack のスレッドから来ようが、チップ設計で使うネットリストファイルから来ようが、同じベクトルテーブルに落ちる。このテーブルに入りさえすれば、同じインターフェースで検索できる。
各データソースが定義する必要があるのは3つだけ:これは何のデータか、どう接続するか、どのくらいの頻度で取得するか。取ってきて生成される各行は、フィールド構造がまったく同じだ。
この設計は他チーム向けの抜け道も用意している。すでに自前のデータベースを持っていて、ナレッジベースに入れるためだけに Slack やドキュメントシステムにデータを移したくないチームもある。その場合は、このソースをプラグインスクリプトとして扱う。チームが pull request を1本提出し、自分のシステムからデータを読んでそのテーブル構造に合う行を吐き出す小さな Python モジュールを用意し、データソースのレコードを1件設定する。同じライブラリに書き込み、同じフィールドセットを使う限り、残りの全パイプラインは1行も変更する必要がない。
Slack で一番難しいのは、どの発言が有用か見分けること
Slack は彼らが最も重視し、かつ最も扱いにくいデータソースだ。社内の最新のエンジニアリング議論はそこで行われる。最初は最も手軽な方法を試した——元のテキストをそのままベクトル化して検索する。だがすぐに、ベクトルだけでは網羅できないことがわかった。
問題はチャット履歴自体が持つ3つの特徴から来ていた。第一に、情報密度の差が極端に大きい。「了解、ありがとう」と、カーネル実装を丸ごと説明する長文が、システムの目にはどちらも「1件のメッセージ」にしか見えない。第二に、メッセージの長さがまちまちで、短いメッセージがベクトル類似度でしばしば長く詳細なメッセージを上回ってしまう。第三に、あるメッセージの意味は前後の会話に依存することが多い。
グループチャットで「マニフェスト読み込み後に復元が止まる」と検索する。実際にこの問題を解決した返信は、元の単語を1つも使わず「checkpoint が NFS マウントポイントで詰まっていた」と言っているかもしれない。一方、文字面が一番似ているのは8か月前の、すでに廃止された古い対処法かもしれない。そして「了解、ありがとう」は、ほぼどんな質問文とも少し似てしまう。
彼らの解決策は、同じコンテンツを複数の検索方式で同時にカバーし、それぞれが他の弱点を補うというものだ。同じクエリ、同じ4件の候補で、スコアリング方式を切り替えると、誰が上がり誰が下がるかが毎回変わる(データは原文の例による)。
(マニフェスト読み込み後に復元が止まる)
CKPT_PREFETCH を4に設定して。ERR_MANIFEST_TIMEOUT:マニフェスト読み込み後に復元が止まる。LEGACY_FETCHER=1 に切り替えて対処。4つのタブを切り替えてみると、押し上げられるものと押し下げられるものが毎回違うことがわかる。2週間前の、言い回しを変えて、珍しいパラメータ名を含むあのスレッドこそ、実際に問題を解決した答えだが、全文一致の列では一語も一致していない。ベクトル一致、レア単語の重み、時間減衰の3列だけがそれを認めている。逆に、8か月前の文字面がほぼ同一の古い答えは、全文一致では最も高く評価されるが、時間減衰の列でようやく割り引かれる。どのスコアリングも単独で使えば、本当の答えを見逃すか、古い答えを上位に並べてしまうかのどちらかになる。だからこそ4種のスコアリングがそれぞれランキングを1本ずつ出し、クエリ時にそれを合算する。
チャット履歴はそのままベクトル化しない
元の Slack テキストは、そのまま置くだけでキーワード検索できる。Postgres 上で元テキストに全文インデックスを維持しているからだ。しかしベクトル検索を本当に使えるものにするには、もう一段の加工が必要だった。
この工程を蒸留と呼ぶ。モデルにスレッド全体を読ませ、4つのものを抽出させる——エンジニアが実際に検索しそうな一言の質問文、簡潔な要約、最終的な結論、そして過程で言及されたシステムとコードシンボルだ。ベクトル化されるのはこの4つであり、逐語のチャット記録そのものはベクトルデータベースに入らない。実測では、スレッドを統一フォーマットに正規化することで精度がはっきり向上し、追加されたメタデータが意味的マッチングにより多くの手がかりを与えている。
CKPT_PREFETCH=4 に設定したら完走した。デフォルト値は NFS マウントポイントには高すぎる。CKPT_PREFETCH=4 を設定する。データがどうリアルタイムで入ってくるか:Socket Mode とスレッド丸ごと再取得
収集側では、彼らはワークスペースに Slack ボットを設置し、Socket Mode で動かしている。Slack は1本の長時間接続を通じてメッセージイベントを逐一プッシュしてくるので、Web API を繰り返しポーリングする必要がなく、API のレート制限にも引っかからない。
イベントが届くとすぐに受信確認を返し、安定したイベント ID で重複排除したうえで、取り込みプログラムにマークを付ける。この取り込みステップには見落としがちな設計がある——新しいメッセージだけを単独で保存するのではなく、まずそのメッセージがどのスレッドに属するかを特定し、Slack API から会話全体(最初の投稿とそれ以降のすべての返信)を改めて取得し直し、スレッド全体を1行として書き戻す。したがって、新しい返信が1件届くたびに、親メッセージと同階層のすべての返信が再取得される。保存される本文、参加者リスト、最終アクティブ時刻は、常に会話全体の現在の状態を反映している。
また、システム内では各 Slack チャンネルがそれぞれ独立したデータソースとして扱われ、収集頻度を個別に調整できる。あるチームは自分たちの高頻度な障害対応チャンネルをより頻繁に更新させることができる。
長いスレッドの中で、要約に漏れてしまうメッセージ
ここまでで Slack の検索はすでに使えるものになっていたが、彼らは繰り返し同じ問題にぶつかった。長いスレッドの中の重要なメッセージが、スレッド全体の要約に必ずしも痕跡を残すとは限らないのだ。
この対策が bursting と呼ばれる手法だ。バーストとは、同じ人が連続して投稿した複数のメッセージのことを指す。彼らは各バーストを個別にベクトル化し、その前にスレッド全体の話題をコンテキストとして付加する。こうすることで、答えが脱線した枝分かれの中に埋もれていて、使われている単語がスレッド全体の要約に一度も出てこないようなケースでも、単独で検索できるようになる。
低価値なコンテンツがデータベースに大量に流れ込まないよう、各バーストは加重スコアリングを通過して初めてベクトル化される。判定基準は3つ:全社的なコーパスの中で十分珍しい単語を含んでいること(希少度のしきい値は IDF 4.0以上)、統合後に最低200文字あること、そのバースト内のメッセージに同僚からの絵文字リアクションが付いていること(これは同僚からの承認とみなされる)。
40GBのコードリポジトリを、どうやって最新に保つか
コードリポジトリをベクトル化すべきかどうか、彼らは最初ためらっていた。Claude Code のようなコマンドラインツールが登場した今、コード用のベクトルインデックスを作るのは少し直感に反するように見える——grep があれば十分ではないかと感じてしまう。同業者と話し、大規模コードベースの意味検索についての Cursor の知見を読んだうえで、彼らは試してみることにした。
本当の懸念は別のところにあった。社内のリポジトリは数が多く、1つで40GBを超えるものもある。それを許容できるコストで常に最新のインデックスに保つにはどうすればよいか、という点だ。
最終的に落ち着いたのは CocoIndex という、コードリポジトリのベクトル化専用に作られたオープンソースフレームワークだ。チャンク分割のルールは言語の構文境界に従い、粗いものから細かいものへと順に試す。まずクラスのような上位の境界を試し、切り出したチャンクがまだ大きすぎればメソッド境界まで下がり、それでもだめならさらに小さなコードブロックまで下がる。同じファイルからこうして複数の粒度のベクトルが生まれる。たとえばファイル単位で1本、関数単位でそれぞれ1本ずつといった具合だ。
- 切れ目は長さだけで決まる
- 1つの関数が途中で分断されることもある
- 切り出したチャンクは前後が欠けて、何をしているか読み取れないことが多い
- まずクラスで切り、大きすぎればメソッド、さらに条件分岐やループの単位まで下げる
- 各チャンクが完全な構文単位になっている
- 同じファイルから複数の粒度が生まれ、粗いものも細かいものも検索できる

更新面はこの方式が本当に手間を省いてくれるところだ。CocoIndex は同期用のメタデータも Postgres に保存しており、コミットのたびに変更のあったコードチャンクだけを作り直せばよく、リポジトリ全体を再計算する必要がない。同期状態とベクトルが同じデータベースに保存されている点は、彼らにとって特に都合が良かった。
接続するコードリポジトリが増えるにつれ、リポジトリ接続そのものが設定ファイルとして扱われるようになり、各チームが自分で提出できるようになった。ファイルパス単位でホワイトリストとブラックリストを設定することもできる。
質問が来たあと、システムは何をしているのか
質問を受け取るたびに、システムはまず短いプランニングを1回走らせる。モデルがこの質問にどのツール、どのデータソースが必要そうかを判断し、選ばれたツールを並行して発行する。
MCP 側では、ツールを直接 Agent に渡して自分で組み立てさせる
Web インターフェースでは、上記のパイプラインはエンドツーエンドで実行される。プランニングがツールを選び、実行層が並行して証拠を取得してスコア・時刻・出典のヒント付きの統一された証拠に正規化し、最後のモデルのパスがそれに基づいて引用と注意事項付きの回答を生成する。利用者から見れば、質問して回答を受け取るだけだ。
MCP 統合はこれと逆のアプローチを取っている。検索機能を「この質問に答えて」という1つの大きなインターフェースの裏に隠すのではなく、1つずつ直接呼び出せるツールとしてバラして公開する。これらのツールは意図的にシンプルに作られており、できるだけモデルを介在させない。そのためクライアント側は速く、安価に検索できる。各 MCP ツールは最も基本的な検索動作1つに対応しており、入出力は狭く、構造化されていて、安定している。どんなクライアントや Agent でも直接呼び出せる。ほとんどのツールは1本のクエリ経路だけを実行する——意味で検索する、文字面で検索する、あるいは直接 ripgrep を実行する——その上に軽量なスコアリングを1層かけて、元の証拠行を返す。
こうすることで、組み立てる作業は Claude Code のような MCP 対応の Agent に任せられる。どのツールをどの順序で呼ぶか、結果をどう最終的な回答や1回のコード修正にまとめるかは、Agent 自身が判断する。検索層はこれらのモデル判断に依存しなくても、通常どおりサービスを提供できる。
6本のランキングを、どう1本に合成するか
ある文書が最上位に来るのは、単に検索語と文字面がたまたま一致しただけで、実際には別のことに答えているだけかもしれない。さらに厄介なのは、6つの検索器が出すスコアが互いに直接比較できないことだ。ベクトルのコサイン類似度と全文検索の関連度は、まったく違う物差しだ。
彼らのやり方は、まずスコアを見ず、順位だけを見ることだ。このアルゴリズムは Reciprocal Rank Fusion(RRF、逆順位融合)と呼ばれる。ある文書が1本のランキングに載るたびにスコアを加算する。加算量は「1 割る(60 足す そのランキングでの順位)」で、重みはデフォルトで1.0、60というのは平滑化定数だ。
総合ランキング1位を計算してみると、この仕組みがはっきり見えてくる。CLASS: CheckpointLoader は6本のランキングのうち5本に入り、順位はそれぞれ1位、2位、3位、5位、5位だ。
順位の前に60を足すことで、1位と5位のスコア差はわずか6%(0.01639 対 0.01538)にしかならない。もしこの定数を足さず、順位の逆数をそのまま取ると、5位のスコアは1位の5分の1にまで落ちてしまう。つまり60の役割は「順位が高いこと」のメリットを平坦にならし、単一の強い1票よりもコンセンサスを優先させることにある——複数の検索器で上位に入る文書が、そのうちの1つだけで1位を取った文書に勝つ。上の INC-82 がその例で、一度も1位を取っていないのに、5本のランキングすべてに安定して入ることで総合2位に食い込んでいる。
合成後にもう3つの工程がある
融合して出てきたランキングは、そのまま回答の生成には送られない。次にまず同じ出典から分割されて重複しているチャンクを1つに統合し、続いて1ファイルが貢献できる結果数に上限を設けて、より分散した上位20件を得る。この20件は元の質問文とともに小型のリランクモデルに渡され、各件に0〜10点のスコアを付けて上位10件を残す。
順位が決まったあと、コンテキストを補い戻す。たとえばヒットしたのが Wiki のあるセクションだった場合、その前後2セクションも一緒に引っ張ってくる。チャンク分割で見出しや前提条件、注意事項が分断されて失われるのを防ぐためだ。こうすることで、読者の手元に届くのは前提を欠いた孤立した断片ではなく、完全な形の引用になる。
この一連の工程を経て、検索ステップが引き渡すのは1パックの証拠だ——異なる検索器から集まり、融合を経て、出典レベルで重複排除され、実際の質問に対してリランクされ、最後に周辺の文脈が付け加えられたものになっている。
全社検索すると、逆に役立つものが見つからなくなる
コーパスが大きくなっていくにつれ、「なんでも検索する」というやり方はすぐに使いづらくなった。コンパイラを作っているエンジニアは、結果の中にデータセンター運用マニュアルが出てきてほしくないし、その逆も同じだ。
彼らはこれを解決するために project という層を導入した。project とは、データソースを名前付きでまとめたグループのことだ——指定した複数の Slack チャンネル、複数のコードリポジトリ、複数の社内データベース、複数のドキュメントスペースを、あるチームやあるプロジェクトグループを中心に構成する。project は意図的に軽量に作られている。同じデータソース、たとえば全社共通の障害対応チャンネルや中央プラットフォームのリポジトリは、複製することなく複数の project から同時に参照できる。
新人が入社すると、自分の仕事に最も近いデフォルトの project を1つ選ぶか作るよう案内される。たとえばトレーニング基盤、コンパイラ、データセンター運用といった具合だ。このデフォルト値はユーザープロファイルに保存され、以降のすべてのクエリが自動的にこの範囲に限定される。効果として、新しく入ったエンジニアはどの Slack チャンネル、どのリポジトリ、どのドキュメントスペースが自分に関係あるのかを先に調べる時間をかける必要がなくなり、最初から関連性のある結果が手に入る。
- コンパイラの質問に、データセンター運用マニュアルが混ざる
- 関連度をアルゴリズムだけで無理やり支える
- 新人はどれを信じればいいかわからない
- そのチームが関心を持つソースだけを検索する
- 範囲そのものが関連性を一段支えてくれる
- 入社時に1度選べば、以降は自動で有効になる
このナレッジベースが機能しているのは、情報が本来あった場所でそのまま人を受け止めているからであり、すべてを1つの硬直したシステムに詰め込んでいるからではない。 Cerebras、『How we built our knowledge base』
原文に登場した具体的な数字
社内で資料を探す方法:「まず物を1か所に集める」→「物は元の場所に残し、システムが自分で取りに行く」へ
Cerebras のエンジニア3名が社内ナレッジベースの完全な作り方を公開。1枚の図で読み切る
↓ 1枚で読み切る · 動く図あり
会社では毎日3種類の質問が飛び交っている——あれはどこにある、これは誰が一番詳しい、この用語はどういう意味か。答えは実は存在していて、Slack のチャット、コードリポジトリ、社内ドキュメント、障害記録に散らばっている。いわゆる「社内ナレッジベース」とは、こうした場所をまとめて調べ上げ、直接答えを出してくれるものだ。
これまで会社の標準的なやり方は、検索窓と統一プラットフォームだった。四半期ごとに誰かが「今後すべての情報を1か所に記録しよう」と提案する。この試みはほとんど成功したことがない。
Cerebras の最初の決断は方向転換だった。誰にも物を書く習慣を変えさせず、代わりに各プラットフォーム向けにデータ取得プログラムを1本ずつ用意し、取ってきたものを統一フォーマットにして、すべて同じデータテーブルに落とす。公開から3か月、1日15000件超の質問をさばいており、質問者には社員だけでなく自動化スクリプトや Agent も含まれる。
結果:一人ひとりに手間が1つ増える
数週間で元に戻り、古い資料は元の場所に残ったまま
ソースごとにデータ取得プログラムを1本
すべて同じテーブルに落とす:
本文 + 3072次元ベクトル + 出典 + 時刻
同じテーブルに落とすことの利点は、新しいデータソースを1つ追加してもクエリ側は一切変更不要な点だ。だが新たな悩みがすぐにやってくる。Slack は最も手強いソースで、「了解、ありがとう」とカーネル実装を丸ごと説明する長文が、システムの目にはどちらも「1件のメッセージ」にしか見えない。どうやってどの発言が有用かを見分けるのか?
彼らの答えは、どの物差しにも頼らないことだった。同じ候補集合に対して4種のスコアリングを同時にかけ、それぞれの盲点を補い合う。下の図は、小互(筆者)の実際の質問1件をたどっている。彼はグループチャットで「マニフェスト読み込み後に復元が止まる」と質問し、データベースには4件の候補がある。4つの物差しがそれぞれ誰を押し上げ、誰を押し下げるかを見てみよう。
「検索精度が向上した」という言い方には実感が湧かない。同じ具体的な出来事に置き換えてみよう——新人がトレーニングクラスタを引き継ぎ、復元が止まる問題に遭遇して「CKPT_PREFETCH=4 に設定する」という答えにたどり着くまで、3つのやり方でそれぞれどれくらいかかるか。
ログはマニフェスト読み込みで停止。
何も出てこない!
データベースの本当の答えは
「checkpoint が NFS
マウントポイントで停止した」。
動かさなければいい?
もう1つの道を見つけた。
資料は Slack、コードリポジトリ、
ドキュメントに残し、システムが自分で取りに行く。
人だけじゃない
カーネル解説の長文が
なぜ同じ重みなんだ?
4つ同時に測れ。
単語の珍しさ、時間での割引。
それぞれが他の盲点を補う。
残り3つの物差しが押し上げる。
ほぼ同一だが、時間という
物差しで割り引かれる。
1本のランキングに載るごとにスコアを加算。
5位よりわずか6%多いだけになる。
引用付きの回答が。
CKPT_PREFETCH を4に設定。
- × 製品は非公開、公開の入口はない
- × 1日15000件は Cerebras 自身が公表した数字で、第三者の裏付けはない
- × 原文には「何分節約できるか」の対照データはない