OpenAIがGPT Images 2.5を発表:Photoshop級の精密な画像編集能力、その実力は驚異的
ピンポイント編集、連続微調整、参照写真による着せ替えや合成写真から、スケッチ、テンプレート、プロンプトまで:Images 2.5がどのように創作へ取り入れられるかを見てみましょう。
- 2.0ですでに画像編集に対応していましたが、2.5では指定位置の修正、参照元の被写体保持、複数ターンの一貫性がさらに向上しました。
- 写真の着せ替え、複数人の集合写真合成、中国語の長尺インフォグラフィック、チケットやケーキの蝋燭など、画像と動画の全編で確認できます。
- Sketch、テンプレート、画像内コメント、プロンプト共有により、構図や局所的な修正指示が伝えやすくなりました。
- Flareは速度優先、Sunburstは画質優先。両モデルのトークン単価はGPT Image 2と同一です。
OpenAIは最新の画像生成モデル「GPT Images 2.5」を発表しました。今回の最大のアップデートは、AIによる画像編集における3つの主要な能力の向上です。具体的には、指定した位置をより正確に修正すること、参照写真に写る人物や物体の特徴をより的確に保持すること、そして連続した修正において先行する調整結果を引き継ぐことです。GPT Images 2.0でもすでに画像の生成と編集に対応していましたが、2.5では編集の精度と一貫性がさらに改善されました。
GPT Images 2.5の中核となる機能的特徴は以下の通りです:
- より正確な修正:指定した位置をピンポイントで調整し、連続した修正でも既存の結果を的確に維持。
- より自然な写真表現:参照写真内の被写体の特徴をより的確に保持し、より自然なライティングと豊かな質感を再現。
- 複雑な指示の理解力向上:視覚的な要件を正確に把握し、複雑なレイアウトを構成。現実世界の情報を含む画像コンテンツを向上。
- スタイルの忠実な再現:指定されたアートスタイルにより忠実に従い、透過背景(アルファチャンネル)出力にも対応。
GPT Images 2.5の画像生成レイテンシは、2.0と比較して最大50%削減されました。さらに、スケッチ機能、プリセットテンプレート、画像内コメント、プロンプト共有などの新機能が追加されたほか、APIでは速度優先の「GPT Images 2.5 Flare」と品質優先の「GPT Images 2.5 Sunburst」の2つのバージョンが提供されます。
OpenAIによると、ChatGPTおよび画像APIを通じて作成される画像は毎週30億枚を超えているとのことです。
ピンポイント編集:指定箇所のみを変更し、周辺コンテンツを保持
AIによる画像編集において、ピンポイント編集(Precision Editing)の肝となるのは局所的なコントロールの実現です。指示された要素のみを正確に変更しつつ、周囲の人物、背景、ライティング、ブランドスタイルを可能な限りそのまま維持します。編集を行うたびに変更後の画像が1枚生成され、異なるターンの結果を連続再生することで、その変化のプロセスを確認できます。
- 複数都市の旅行チケット(Multi-city ticket):手持ちで斜めに構えられたアングルとチケットの基本レイアウトを維持したまま、券面の都市名と代表的なランドマークのみを順次置き換えます。例えば、ニューデリーのインド門から、サンパウロの斜張橋が架かる都市景観、東京の桜と五重塔、パリのエッフェル塔、サンフランシスコのゴールデンゲートブリッジへと切り替えられ、チケット内の特定エリアにおけるテキストと画像の精密な置換能力が示されています。
- 全身ポートレートの個別編集(Full-body edits):同一の直立した女性の全身正面写真をベースに、複数の独立した局所修正を個別に実行します。淡い紫色のサテンブラウスへの着せ替え、テラコッタ調の中庭背景への変更、ネイビーのベレー帽の着用、ガッシュ画(不透明水彩)風への変換、強い午後の直射日光とドラマチックな陰影への調整などです。いずれの独立した修正においても、人物のポーズ、プロポーション、主要な顔立ちの特徴はベース画像とほぼ一致した状態を維持しています。
複数ターンの連続編集:既存の修正を崩さず新たな変更を反映
複数ターン編集の一貫性(Multi-turn Editing Consistency)とは、1枚の画像を連続して修正する際、新たな要求が前のステップの結果を適切に引き継ぎ、過去の変更の消失や画質の低下を減らすことを指します。例えば、まずタイトルを変更し、次に行程を調整し、最後に不要なモジュールを削除することで、画像を目的の完成形へと段階的に近づけていくことができます。
- 中国語の長尺インフォグラフィック改変(Travel infographic / 宜昌旅行):複数のエリアにわたるレイアウトと中国語テキストを含むインフォグラフィックに対し、連続して5ステップの局所改変を実施します:
- メインタイトルを「宜昌」から「宜昌旅行」に更新;
- 赤いサブタイトルバナーの文字を「一泊两日攻略」に置き換え;
- 右上の所要時間表記を「2天1夜(约48小时)」に変更;
- 青色のモデルコースカードのタイトルを「推荐行程(2天1夜)」に更新;
- 右下の紫色の「费用参考(人均)」カードを削除し、その領域を自然な余白として処理。下部のまとめテキストと上部のレイアウト構造は、元の画像におおむね近い状態を維持。
- 幾何学立体の連続回転(Cube rotation):立方体を多角的に回転させるプロセスにおいて、角度の変化に伴い異なる面が現れ、その幾何学的構造と遠近感の関係を連続して観察できます。
- ケーキのキャンドル点灯(Birthday candles):丸太を模した細長いチョコレートケーキの上で、細いキャンドルが左から右へと1本ずつ点灯していきます。キャンドルの灯りが段階的に増えていくプロセス全体を通じて、ケーキの樹皮の質感、グラサージュの艶、テーブル上の小さなキノコや右側の緑色のカエルの立体デコレーションなど、全体の構図が元の画像に近い状態で保たれています。
参照写真:着せ替え、集合写真の合成、部屋の片付け
人物、ペット、部屋などの写真をアップロードすることで、それらの写真を基に衣装を変更したり、シーンを合成したり、画風をアレンジしたりできます。2.5では被写体らしさをより的確に保持し、照明や質感もより自然に表現できます。
- 写真内の着せ替え(Remixed baby portrait):手持ちのプリント写真を現実的にスナップ撮影した画像を入力とし、紙の写真の内側に写る子どもの赤い上着のみを黒のボウタイ付きオフホワイトのスーツに変更。写真を持つ指や傾き、周囲の環境は元の画像に近い状態で保たれています。


- ペットの着せ替え(Dog in costume):日当たりの良いテラスの黒いテーブルと椅子の傍らに立つ明るい毛色の巻き毛の子犬に、「STUNTMAN」のロゴが入った赤と青の星条旗デザインのヘルメット付きスタントスーツを着せ替えます。子犬本来の外見的特徴は、テラスの背景や床に伸びる長い影と調和しています。


- ベッドメイキング(Making the bed):傾斜天井の寝室で布団が乱れた実際の写真を入力すると、シーツや布団がきれいに整えられ、枕が規則正しく並んだ画像が出力されます。寝具本来の自然なシワの質感が維持され、傾斜天井、窓、テーブルランプ、ベッドサイドテーブルの空間配置も元の画像に近い状態に保たれます。


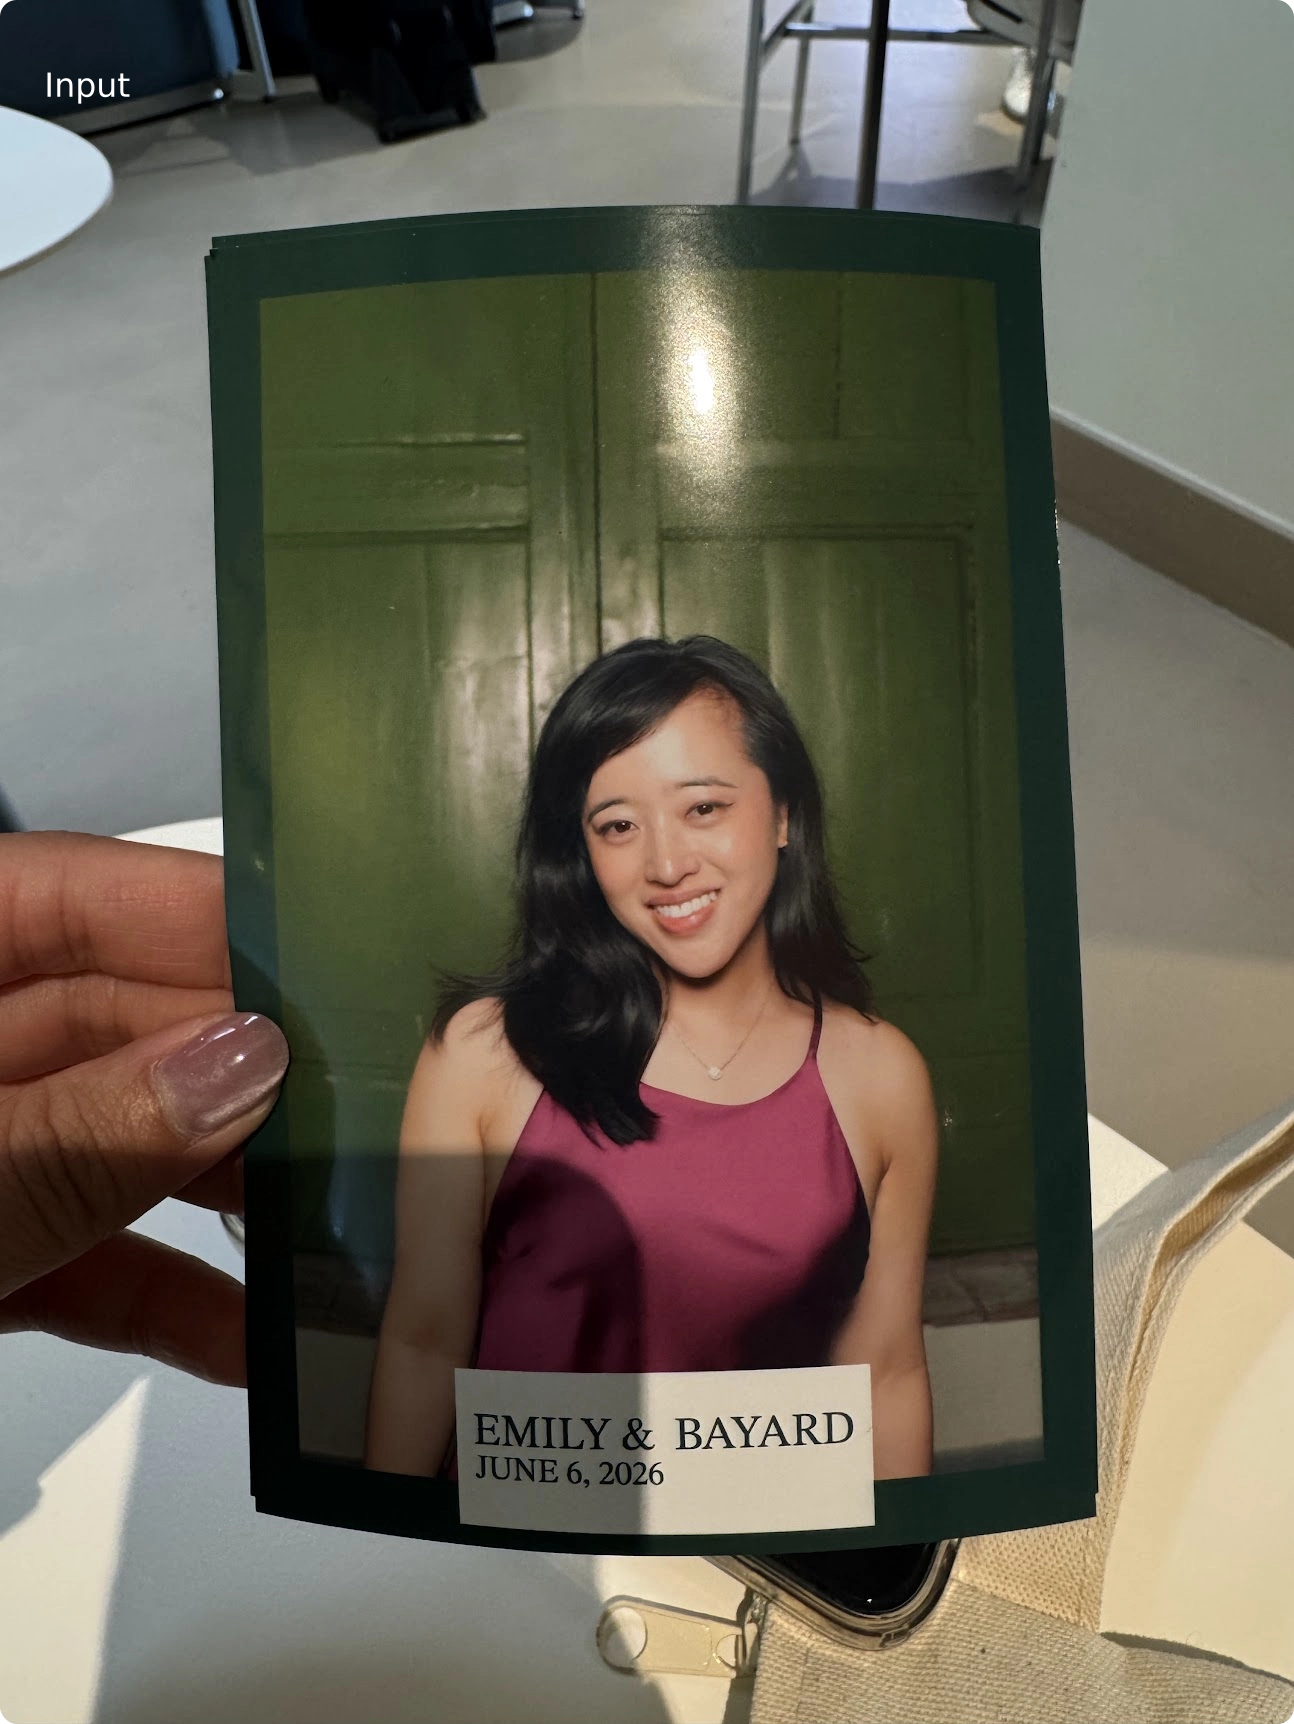
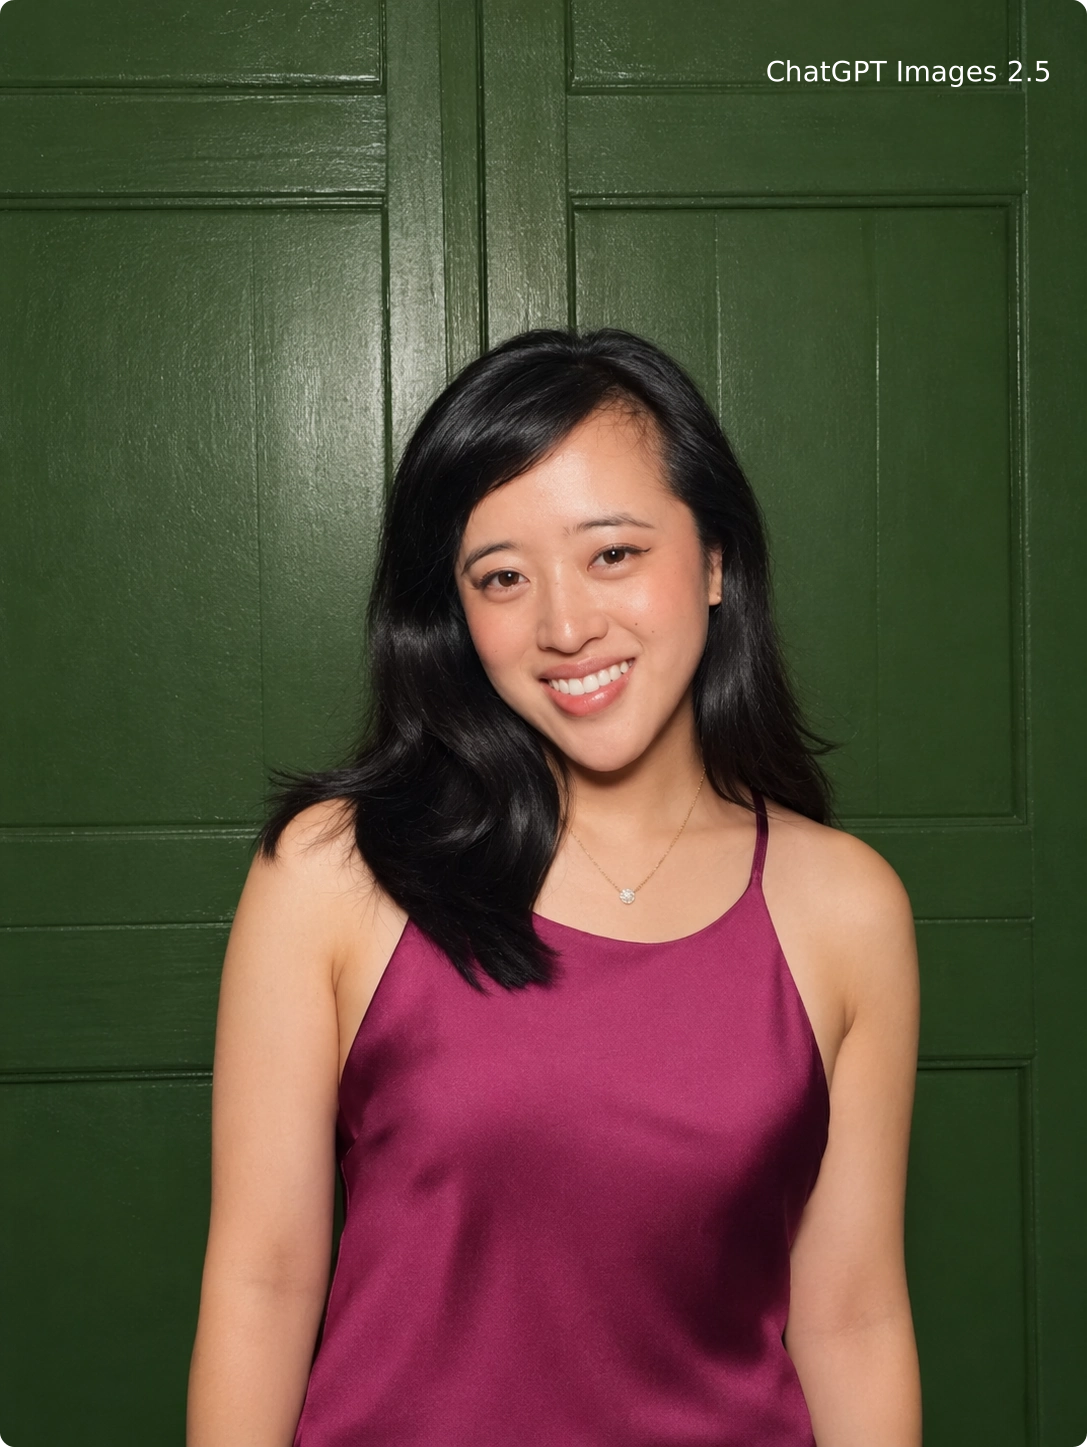
- スナップ写真からの人物切り出し(Headshot from photobooth):光の反射や印画紙のフチ、下部のラベルが写り込んだ手持ちのスナップ写真を入力し、持ち手の指や反射の遮りを排除してクリアな正面ポートレートを抽出。赤紫のトップスや背後のグリーンのドアの背景はそのまま保持されています。
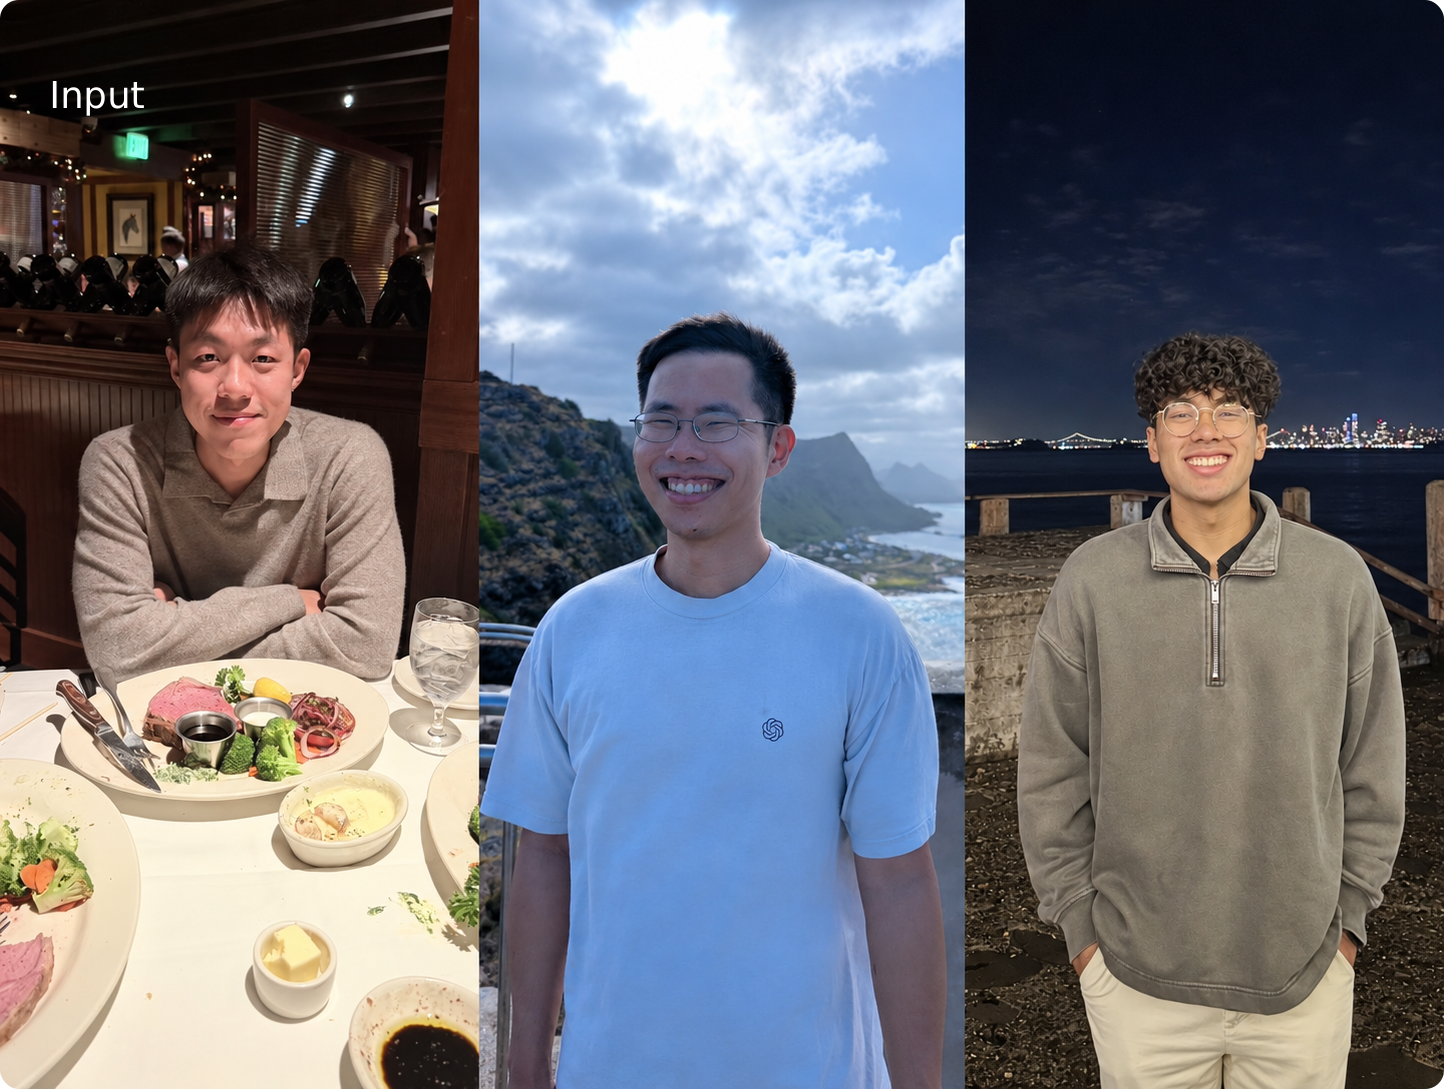
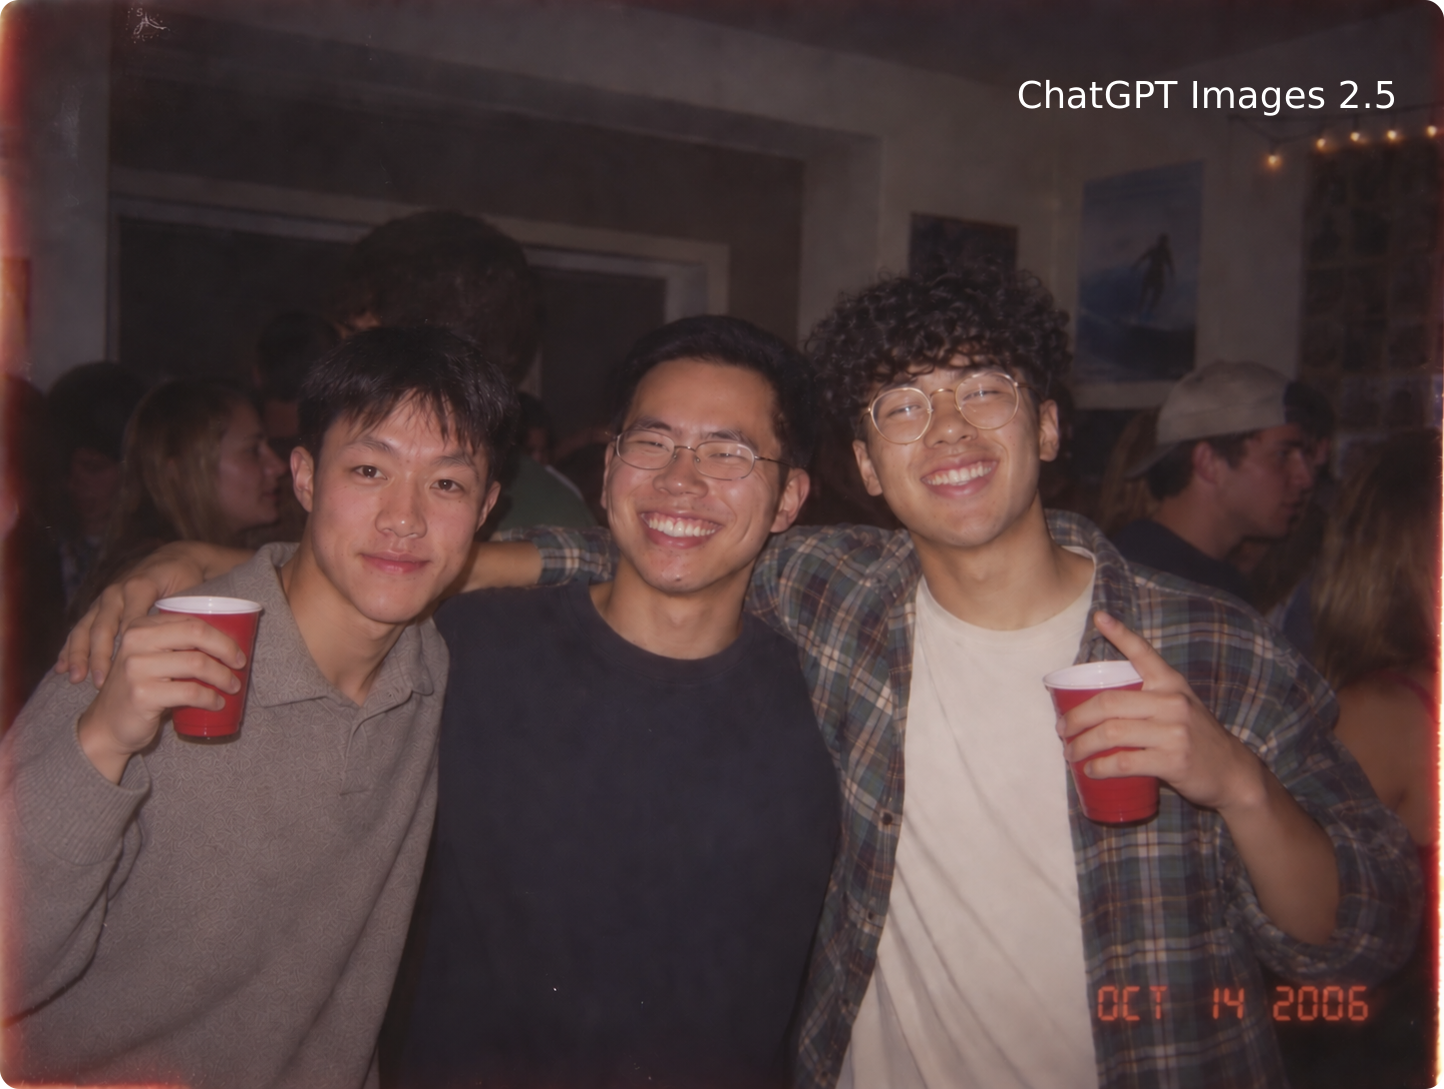
- 複数の個別写真の合成(Composite party photo):それぞれ異なる照明環境で撮影された3人の男性の個別写真を入力し、室内パーティーで3人が肩を並べて立ち、赤いカップを手にした1枚の集合写真へと統合します。
インテリジェンスとスタイルの理解:複雑なレイアウトからシリーズ素材まで
Images 2.5では、複雑な視覚的プロンプトの解釈能力が強化され、現実世界の情報を処理する際の正確性が向上しました。特定のアートスタイルやレイアウト要件にも高度に従うことができ、ネイティブの透過背景出力にも対応しています。
- マルチユニットのレイアウト協調(ミッドセンチュリーモダン風9分割ポスター mid-century-modern-posters):3×3のグリッド内で、9組の独立した幾何学的シンボル(波、花、横顔のシルエット、階段、目など)と、視認性の高い英文フレーズ(CREATE、GROW TOGETHER、CHOOSE KINDNESSなど)を調和させ、複数の要素で構成される画面を統合する構成力を示しています。
- シリーズ素材のスタイル統一(ヴィンテージ国立公園切手 vintage-national-park-stamps):イエローストーン(Yellowstone)、グランドキャニオン(Grand Canyon)、グレイシャー(Glacier)など8カ所の異なる自然景観を扱いながら、クラシックな版画の質感とギザギザの目打ち枠を統一しています。
- 階層構造と現実世界の視覚情報(太陽フレアのプレゼンテーションスライド presentation-image):スライドエディタのインターフェースをシミュレートし、「What Causes Solar Flares?」というメインタイトル、太陽の画像、下部の4ステップにわたる科学的プロセスの解説図を配置。専門的なレポートに求められる視覚的ヒエラルキーに適合しています。
- 多彩なアートスタイルの再現:
- レトロフューチャリズム(retrofuturism):巨大なシリンダー型宇宙居住区を窓越しに眺める3人家族。古典的なSFの宣伝ポスターのタッチを再現。
- 印象派の都市風景(impressionist-cityscape):厚塗りの色彩豊かな筆跡で湾、坂道のストリート、赤い海峡大橋を表現。
- SFシュルレアリスム(sci-fi-surrealism):上下反転した都市の高層ビル群、夜空を横向きに浮遊する人物、弧を描く地平線。
- ウェディング招待状(wedding-invitation):エレガントなクリームゴールドの飾り枠、シンメトリーなエンブレム、手書き文字のタイポグラフィ。
- モザイクタイルアート(mosaic):青と金のモザイクタイルの目地によって描き出される地球と銀河。
- ステッカー風ポスター(stickers):レトロな質感のポスターの中で、黒猫がステッカーシートを抱える構図。
- サイバーパンク都市(cyberpunk):冷たいブルーの雨夜の高層ビル街、巨大な発光サイネージ、空中を浮遊する飛行ビークル。
- ネイティブ透過背景のサポート(Transparent Background):生成および編集の際に、アルファチャンネルを含む透明背景画像(PNG/WebP)を直接出力可能。UIアイコン、商品の切り抜き、プレゼン資料の挿絵、Web用素材の作成において、後工程の背景透過処理の手間を減らします。


ChatGPT インタラクション機能の進化:4つの実用的なクリエイティブツール
モデル自体の画質や一貫性の向上に加え、クライアント側にも操作のハードルを下げ、コントロールの精度を高める4つのインタラクティブツールが追加されました:
@Sketch(手描きスケッチによるガイド):空間のレイアウトや衣服のラインなどは、言葉だけで完全に伝えるのが難しい場合があります。入力欄に@Sketchと入力するとキャンバスが立ち上がり、部屋の配置ライン、衣服の輪郭、大まかな構図などを直接手描きして視覚的ガイド(visual guide)として指定できます。スタイルを指示するテキストと組み合わせることで、完成画像を生成できます。
Templates(シーン別のプリセットテンプレート):ポスター(Poster)、チラシ(Flyer)、オリジナルグッズ(Merch)など、人気の制作フォーマットにあらかじめ適した出発点を提供します。白紙のキャンバスを前に悩む必要はなく、テキスト情報と希望のスタイルを入力するだけで、素早く形にすることができます。
-
画像内ピンポイントコメント(In-image Comments):チャット欄で修正したい位置を言葉で回りくどく説明する必要はありません。生成された画像の修正したい箇所に直接コメントを置き、その箇所に絞った修正を指示できます。
-
プロンプト付きのクリエイティブ共有(Prompt Sharing):画像を共有する際、その画像の生成に使用された完全なプロンプトを一緒に添付できます。受け取ったユーザーはその構図やスタイル設定をそのまま流用し、自分の写真やディテールに差し替えることができます(例えば人気の80年代レトロ写真スタイルなど)。

API の二系統モデル選定と実践的なプロンプティング(Prompting)
画質の要件と許容できる待機時間に応じて、APIでは2つのモデルが提供されています:
Flare:速度優先
GPT-Image-2.5 Flareは軽量モデルで、画質はGPT Image 2と同等ながら、レイテンシは2.0に比べて最大50%削減されています。ソーシャルメディア向けコンテンツ、製品のUIプロトタイプ、画像検索、高並列バッチ処理などに適しています。
Sunburst:画質優先
GPT-Image-2.5 Sunburstは基本モデルであり、GPT Image 2を上回る画像クオリティを誇ります。複数ターンにわたる編集のコントロールもより精密ですが、生成時間は相対的に長くなります。ブランドビジュアル、広告クリエイティブ、EC向けの高品質な商品画像のレタッチに適しています。
GPT Image 2の画質で十分な場合は、まずFlareを試して待機時間を短縮できるか検証することをお勧めします。複雑なディテールがまだ期待どおりでない場合はSunburstをテストし、実際の仕上がり、所要時間、予算のバランスを考慮して選択してください。
また、GPT-Image-2.5はAdobe Fireflyにも導入されており、プロ向けの各種デザインツールと連携して、構想から最終的な作品づくりまでを行うことができます。
API パラメータの設定方法
サイズ、品質、背景フォーマットはAPIパラメータで指定し、プロンプトは描画内容の記述に専念させます。
モデル model
gpt-image-2.5-flare または gpt-image-2.5-sunburst を選択します。
品質 quality
auto(デフォルト)、low、medium、high、xhigh、max をサポートしています。
図表の細かな文字や密集したタイポグラフィでは high を試してみてください。より緻密な描写が求められ、かつ長めの生成時間を許容できる場合は xhigh や max を検証してください。なお、上位の品質設定が常に優れた結果をもたらすとは限りません。
サイズ size
一般的なサイズ規格には 1024x1024、1536x1024、1024x1536 があります。カスタムサイズは以下の条件を満たす必要があります:
- 各辺が3,840ピクセル以下、かつ16の倍数であること。
- 長辺と短辺の比率が3:1を超えないこと。
- 総ピクセル数が655,360から8,294,400の範囲内であること。
総ピクセル数が3,686,400(2560×1440)を超える設定は実験的なサポートとなります。
背景 background
auto、opaque(不透明)、transparent(透明)をサポートしています。
透明な背景を出力する場合は background="transparent" と指定し、出力フォーマットにはPNGまたはWebPを選択します。PNGでは output_compression は使用せず、WebPでは圧縮率を指定できます。
プロンプトの書き方
ゴール、参照画像の役割、そして「何を変更し、何を保持するか」を明確に記述します。さらに詳しいユースケースについては GPT Image 2.5 プロンプトガイド を参照してください。
- 参照画像に明確な役割を割り当てる(Assign roles to references):複数の参照画像を入力する場合、プロンプト内で画像の識別番号と用途を個別に指定し(例:「画像1はメインの人物」「画像2は適用する衣服」など)、要素の組み合わせロジックを説明します。
- 変更点と保持条件を明確に分離する(Separate changes from constraints):「〜のみを変更する(change only X)」という表現を明確に用い、ロックすべき要素(人物の顔立ち、表情、ヘアスタイル、体型、背景構図、カメラアングル、照明の色温度など)を項目ごとに列挙します。
- 画像内のテキストはそのまま二重引用符で囲む(Verbatim text in quotes):描画させたいテキストはそのまま引用符で囲み、出現回数(例:「render exactly once」)やレイアウト位置を指定した上で、不要な余計なテキストを追加しないよう明示的に要求します。
- 1ターンずつ単一要素を反復修正する(Refine across turns):前回のターンで生成された画像を次のリクエストの入力ベースとして使用し、1回のリクエストでは1箇所の属性のみを微調整します。問題がないことを確認してから次のステップに進むことで、意図しない変更を発見し修正しやすくなります。
着せ替えプロンプト例:変更項目と保持項目を分離する
APIリクエストパラメータは個別に設定します(例:model="gpt-image-2.5-flare"、quality="medium"、size="1024x1536")。プロンプトは以下のように記述できます:
画像1は人物の参照画像、画像2は衣服の参照画像です。
服装のみを変更:画像1の人物に画像2の衣服を着せてください。
人物の顔、肌の色、ヘアスタイル、体型、ポーズ、表情はそのまま保持してください。
画像1の背景、カメラアングル、照明の方向、全体の構図を保持してください。
衣服が現在のポーズに自然にフィットし、生地のシワや接触部分の影が自然になるようにしてください。
テキスト、ロゴ、透かしは追加しないでください。
各ターンの完了後は、変更された領域と保持された領域を注意深く照合してください。連続編集では意図しない細部が変化してしまう可能性があります。特定の領域をピクセル単位で完全に一致させる必要がある場合は、生成された有用な変更箇所を元画像に手動で合成(コンポジット)することを推奨します。
API の料金体系とコスト構造
Standard(標準)モードはトークン消費量に基づいて課金され、課金単位は米ドル / 100万トークン($ / 1M tokens)です。
GPT-Image-2.5 Flare、GPT-Image-2.5 Sunburst、および前世代のGPT-Image-2の間で、基本トークン単価は完全に同一に維持されています:
| 課金項目(米ドル / 100万トークン) | GPT Image 2 | 2.5 Flare | 2.5 Sunburst |
|---|---|---|---|
| 画像入力 | $8.00 | $8.00 | $8.00 |
| キャッシュ画像入力 | $2.00 | $2.00 | $2.00 |
| 画像出力 | $30.00 | $30.00 | $30.00 |
| テキスト入力 | $5.00 | $5.00 | $5.00 |
| キャッシュテキスト入力 | $1.25 | $1.25 | $1.25 |
3モデルとも、対応する単価は2.0から一切変更されていません。価格確認日:2026年9月9日。最新の価格を確認。
画像1枚あたりの費用の計算方法
1回のリクエストにかかる費用は、テキスト入力、画像入力、画像出力の3つの費用の合算となります。それぞれの項目で実際に消費されたトークン数に上表の単価を掛け、100万で割ることで算出されます。
- プロンプト:テキストトークン数に応じて課金。
- 参照画像:枚数と解像度が画像入力トークン消費量に影響。キャッシュにヒットした部分はキャッシュ入力単価で計算。
- 生成画像:出力解像度と
quality設定が画像出力トークン消費量に影響。最終的なコストは実際の消費トークン数に基づきます。
リリース日、提供範囲、および安全対策
- リリース時期とプラットフォーム展開:2026年9月8日より、デスクトップアプリ、モバイルアプリ、Web版を含む、ChatGPT、ChatGPT Work、Codexの全ティアのユーザーに向けて順次展開を開始。
- API の提供範囲:開発者はAPI経由で
gpt-image-2.5-flareおよびgpt-image-2.5-sunburstをすでに利用可能です。 - 安全性とコンプライアンス管理:
- プロンプトと生成画像の両方に対してチェックを実施し、有害な出力の低減を支援。
- 出力画像には一貫して C2PA デジタル出所メタデータ と 不可視電子透かし(Invisible Watermarking) が埋め込まれ、画像の生成元を識別する助けとなります。