Claude Code公式が徹底解説するループ設計:4段階で無人運転まで進化
- AnthropicのClaude Codeチームがブログ記事を公開し、「ループ(loop)設計」を4つの標準パターンに整理した:ターン制、ゴール制(
/goal)、時間制(/loopと/schedule)、プロアクティブ制——自律度の低い順から高い順へと段階的に進む。 - ループの公式な定義:agentが停止条件を満たすまで、作業を何度も繰り返し実行すること。4つのタイプは「誰がトリガーするか、どう停止を判断するか、どの機能で実現するか、どんなタスクに向くか」という4つの軸で区別される。
/goalの核心的な仕組みは、独立した評価モデルを導入して基準を満たしたかどうかを判定すること——Claude自身が先に「もう十分だから終わり」と判断することはできず、最大試行回数の上限も設定できる。- プロアクティブ制ループは、
/schedule(定時トリガー)、/goal(停止条件)、skills(検証基準)、dynamic workflows(複数agentの並列オーケストレーション)、auto mode(人手による確認不要)という5つの機能を積み重ね、bugレポートのトリアージ、issue分類、依存関係のアップグレードといった継続的な作業を無人で処理できる。 - 実践的なアドバイスは2つ:決定的な作業はスクリプトで処理する方が、Claudeに毎回推論させ直すよりtokenを節約できる。大規模なdynamic workflows(数百のagentを起動する可能性がある)は、本番投入前に小規模で試験運用しておくこと。
AIが代わりに作業してくれる、でも「終わった」と誰が決めるのか?
Claude Codeチームの Delba de Oliveira と Michael Segner が2026年6月30日、Anthropic公式ブログに寄稿し、Claude Codeのために「ループ(loop)」をどう設計するかを体系的に整理した:agentに、停止条件を満たすまで作業を繰り返し実行させる、という考え方だ。
筆者は冒頭であるひとつの現象を指摘する:X(旧Twitter)上では「コーディングagentに一言ずつ指示を出すのはもうやめて、ループを設計しよう」という話があちこちで交わされているが、実際に「ループとは一体何なのか」を調べてみると、互いに食い違う答えばかりが出てくる。この記事がやろうとしているのは、そこをきちんと整理することだ。
以下では4段階のループをシンプルなものから複雑なものへと順に分解していく。それぞれの段階が、あなたの手元にある何らかの作業に当てはまるはずだ。
まず理解しよう:「ループ」とは一体何か
公式な定義はたったひと言だ:ループとは、agentがある停止条件を満たすまで、作業を何度も繰り返し実行することである。ここでの肝心な違いは、「いつ完了とみなすか」があらかじめ決められていてシステムの判断に委ねられている、ということだ——あなたが一回一回張り付いて急かすのではない。
筆者はループを4つの軸で分類しており、この4つの軸が以降の各ループタイプに共通する参照系となる:誰がそれをトリガーするか、いつ止めるべきかをどう判断するか、Claude Codeのどの機能で実現するか、どんなタスクに最も向いているか。まずこの座標系を立ててから、4種類のループをそこに当てはめていく。
一言のプロンプト → 手動でリアルタイムに → 時刻になったら(一定間隔)→ イベントまたはスケジュール、全過程で人は不在
Claudeが自分で判断 → 基準達成または再試行上限に到達 → あなたがキャンセルするか作業が終わる → 各タスクが基準達成で終了、パイプライン全体はあなたが手動で止める
デフォルトの会話 → /goal → /loop、/schedule → 上記すべて + dynamic workflows + auto mode
短いタスク → 検証可能な終了基準があるタスク → 周期的、または外部システムと連携するタスク → 繰り返し発生し定義が明確なワークフロー
筆者はこうも念を押している:すべてのタスクに複雑なループが必要なわけではない。最もシンプルな方法から始め、これらのパターンは必要に応じて使い分ければいい。
あなたが一言尋ねると、それが一回分の作業をこなす
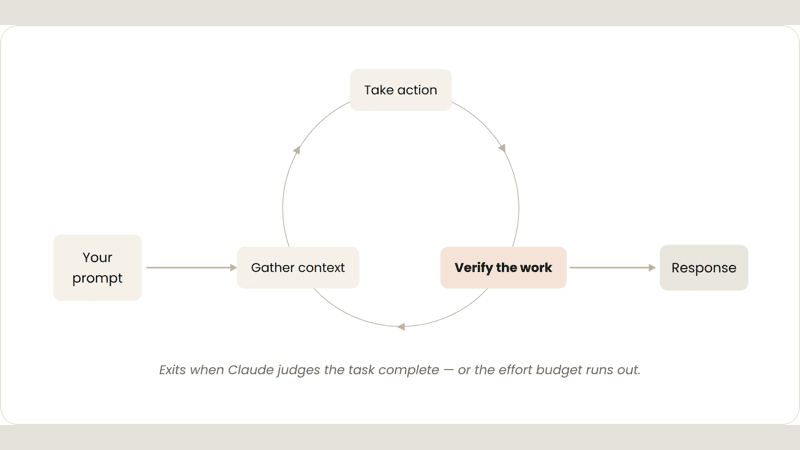
これはあなたが毎日使っているデフォルトのモードだ。あなたが送るプロンプトのひとつひとつが、あなた自身が各ラウンドを手ずから導くループを開始する:Claudeがコンテキストを集め、手を動かし、自分の作業を確認し、必要なら繰り返し、そして返答する。公式にはこれを「agentic loop」と呼んでいる。
原文にある例を挙げよう:あなたがClaudeに「いいね」ボタンを作らせるとする。Claudeはあなたのコードを読み、ファイルを編集し、テストを走らせ、それから「自分では使えるはず」と思うものを返してくる。その後はあなたが手動で検収し、次のプロンプトを書く。トリガーとなるのは一言のプロンプトで、止めるかどうかの判断権はClaude自身が握っている。決まった手順に属さず、スケジュールにも縛られない短いタスクに向いている。

もっと徹底的に自己確認させるには
「検証」というステップを強化することができる:普段あなたが手動で検収している手順をSKILL.mdとして書き出せば、Claudeがエンドツーエンドでより多くのことを自分でチェックできるようになる。ポイントは、Claudeに見える・測れる・触れるツールやコネクタを与えることだ——チェックが定量化されているほど、Claudeは自己検証しやすくなり、必要なラウンド数も少なくなる。
原文では verify-frontend-change というスキルの例が挙げられている:どんなフロントエンドの変更も、「編集が成功した」というだけで完了扱いにしてはならず、人間のレビュアーと同じように一連の流れを最後まで通す必要がある。
- dev serverを起動し、ブラウザで変更したページを開く
- 変更点と直接やり取りする:ボタンをクリックし、状態変化を確認し、前後のスクリーンショットを比較する
- ブラウザのコンソールを確認する:新たなエラーや警告が一切ないこと
- Chrome DevTools MCPでパフォーマンスtraceを実行し、Core Web Vitalsを監査する
いずれかのステップが失敗したら、修正してから第1ステップからやり直す。中途半端な成果物を渡すことは決してない。
元のSKILL.mdサンプルコードを見る
---
name: verify-frontend-change
description: Verify any UI change end-to-end before declaring it done.
---

# Verifying frontend changes
Never report a UI change as complete based on a successful edit alone.
Verify it the way a human reviewer would:

1. Start the dev server and open the edited page in the browser.
2. Interact with the change directly. For a new control (button,
   input, toggle): click it, confirm the expected state change,
   and screenshot before/after.
3. Check the browser console: zero new errors or warnings.
4. Use the Chrome Devtools MCP, run a performance trace and audit
   Core Web Vitals.

If any step fails, fix the issue and rerun from step 1 — do
not hand back partially verified work.
先に「合格ライン」を決めておいて、初めて止まることを許される
時には一回のラウンドでは足りないことがある、特に複雑なタスクでは。agentは何度も反復できる状態のほうがパフォーマンスが良い。/goalを使って「どうなったら完了とみなすか」を明確に定義すれば、Claudeが反復する時間を延ばすことができる。
成功基準を定義しておけば、Claudeは自分で「もう十分良いか」を判断して先に切り上げる必要がなくなる。Claudeが止まろうとするたびに、独立した評価モデル(evaluator)があなたの定めた条件と照らし合わせてチェックする——基準に達していなければ差し戻して作業を続けさせ、目標が達成されるか、あなたが設定した試行回数の上限に達するまでは、本当には止まらない。
言い換えれば、判定の権限はClaudeの手から取り上げられ、基準の照合だけを専門に行う評価モデルに委ねられる。だからこそ「決定的な基準」が特に使いやすい——通過したテストの数や、ある点数のしきい値をクリアするといった基準なら、評価モデルは曖昧さなくはっきりとチェックを入れられる。
提出前に品質チェックの関門を通すようなものだ:チェック担当は自分で自分を採点するのではなく、別の人(評価モデル)がチェックリストを手に一項目ずつ照合していく。基準に達していなければ差し戻してやり直し、それを何度か繰り返せる上限まで続ける。

具体的な例を挙げよう:
/goal get the homepage Lighthouse score to 90 or above, stop after 5 tries.
ゴール制は検証可能な終了基準があるタスクに向いている。あなたが引き渡すのは「停止条件」であり、使う機能は/goalだ。コストを管理する方法は、完了基準と再試行の上限を具体的に定めること——たとえば「5回試したら停止」のように。
時刻になったら自分で様子を見に行く
中には周期的な作業もある:タスクの内容は変わらず、入力だけが変わる——たとえば毎朝Slackのメッセージをまとめて要約するような作業だ。また外部システムに依存する作業もある。最もシンプルな連携方法は、一定間隔でチェックしに行き、変化に応じて反応することだ。たとえばあるPRは、レビューコメントが付くこともあれば、CIが失敗することもある。
このような作業は/loopでトリガーする。一定間隔で同じプロンプトを再実行してくれる。停止条件は、あなたがキャンセルするか、作業が終わる(PRがマージされた、キューが空になった)ことだ。例:
/loop 5m check my PR, address review comments, and fix failing CI
あなた自身のパソコン上で、一定間隔で同じプロンプトを再実行する。
パソコンの電源を切れば止まる。あなたがその場にいて、一時的に様子を見る作業に向いている。
/scheduleを使ってroutineを作り、この「定時での再実行」をクラウド上に常駐させる。
パソコンの電源を切っても動き続ける。長期間稼働させ続ける必要があり、あなたがその場にいるかどうかに左右されない作業に向いている。
/loop 5mは5分ごとにPRをチェックし、レビューコメントに対応し、失敗したCIを修正する5つの機能を組み合わせれば、人の手を借りずに自分で動く
これまでのいくつかのプリミティブに加えて、auto mode(オートモード。ステップごとに止まって続けるか確認する必要がない)とdynamic workflows(ダイナミックワークフロー、リサーチプレビュー版)を組み合わせることで、長期的な作業を処理するループを作ることができる。トリガーとなるのはイベントやスケジュールで、全過程を通じてリアルタイムで人が立ち会うことはない。
プロアクティブ制ループの停止ロジックは2層に分かれている:個々の具体的なタスクは自分の目標を達成すれば終了するが、routine全体はあなたが手動で止めるまでずっと動き続ける。これは、繰り返し発生し定義が明確なワークフロー——bugレポート、issueトリアージ、マイグレーション、依存関係アップグレードなど——に最も向いている。
フィードバック処理を例にとると、公式が示す組み合わせ方は4つの機能を層のように積み重ね、その上にauto modeをかぶせるというものだ:

すべてを組み合わせると、完全なプロンプトはこのようになる:
/schedule every hour: check #project-feedback for bug reports.
/goal: don't stop until every report found this run is triaged,
actioned, and responded to. When fixing a bug, use a workflow to
explore three solutions in parallel worktrees and have a judge
adversarially review them.
平たく言えば:1時間ごとに#project-feedbackチャンネルをチェックしてbugレポートを探す。今回見つかったレポートはひとつ残らず、トリアージ・対応・返信が終わるまで止めない。あるbugを修正するときは、workflowを使って3つの独立したブランチ(worktree)で3通りの解決策を並行して試し、さらに1体の審査役agentに互いのミスを対抗的に探させる。ここで言うdynamic workflowsは、一度に数百体規模のサブagentを起動して手分けして作業させ、互いに連携させることができる。
コストを管理する方法:routineはより小型で高速なモデルに任せて動かし、判断が必要な重要なポイントでのみ最も強力なモデルを使う。
ループを自分勝手に暴走させない
ループのアウトプットの質は、それを取り巻くシステム全体によって決まる。システムを設計する際、公式は4つのポイントを挙げている:
- コードベース自体をきれいに保つ
Claudeはあなたのコードベースにすでにあるパターンや慣習に沿って動く。土台がきれいであってこそ、それに沿って作られるものもきれいになる。
- Claudeに自己確認の手段を与える
「どうなったら良いとみなすか」をskillsとしてあなたとチームの基準に固定化し、Claudeがエンドツーエンドで自分をチェックできるようにする。
- ドキュメントをすぐ手に取れるようにする
フレームワークやライブラリの公式ドキュメントには最新のベストプラクティスが載っている。古い記憶を頼りに当てずっぽうさせてはいけない。
- 2体目のagentにコードレビューをさせる
コンテキストがまっさらなレビュアーはバイアスが少なく、メインagentの推論に影響されない。組み込みの
/code-reviewを使ってもいいし、GitHubのCode Reviewと連携させてもいい。
ある回の結果が基準に達しなかったとき、その1回分の問題を直すだけで終わらせてはいけない。それをルールとして固定化し、システム全体を改善することを試みれば、以降のすべてのイテレーションがその恩恵を受けられる。うまくいかなかったときに直すべきなのはシステムのルールであって、その1回の結果ではない。
ループにこっそりtokenを使い尽くされないように
tokenを管理するには、ループに明確な境界が必要だ。原文では実行可能な6つのチェック項目が挙げられている:
/usageはskills・subagents・MCPごとに最近の使用量を分解して表示する。引数なしの/goalは使用済みのラウンド数とtokenを表示する。/workflowsは各agentの使用量を確認でき、いつでも停止できる。4種類のループをどう選ぶか、1枚の表でわかる
具体的なタスクを前にしたら、3つのことをはっきりさせる必要がある:何を引き渡すか、いつ使うか、どの機能を使うか。原文にあるこの一覧表は4段階のループを行ごとに対照させたもので、各カードを開くと具体的な例を見ることができる。
| ループ | 引き渡すもの | いつ使うか | 何を使うか |
|---|---|---|---|
| ターン制 | 「チェック」 | 探索中、または意思決定をしているとき | カスタム検証skills |
| ゴール制 | 「停止条件」 | 何をもって完了とするか明確なとき | /goal |
| 時間制 | 「トリガー」 | 作業がプロジェクトの外でスケジュールに沿って発生するとき | /loop、/schedule |
| プロアクティブ制 | 「プロンプト」 | 作業が繰り返し発生し定義が明確なとき | 上記すべて + dynamic workflows |
ターン制・例を見る
Claudeに「いいね」ボタンを作らせる:コードを読み、ファイルを編集し、テストを走らせ、自分では使えるはずと思うバージョンを返してくる。あなたが手動で検収したのち、次のプロンプトを書く。
ゴール制・例を見る
/goal get the homepage Lighthouse score to 90 or above, stop after 5 tries.
時間制・例を見る
/loop 5m check my PR, address review comments, and fix failing CI
プロアクティブ制・例を見る
/schedule every hour: check #project-feedback for bug reports.
/goal: don't stop until every report found this run is triaged,
actioned, and responded to. When fixing a bug, use a workflow to
explore three solutions in parallel worktrees and have a judge
adversarially review them.
すでに取り組んでいる作業を眺めて、自分がボトルネックになっているタスクをひとつ選び、どの部分を引き渡せるか自問してみよう:
- この作業の検収チェックを書き出せるか?
- この作業の目標は十分に明確か?
- この作業はスケジュールに沿って発生するものか?
考えがまとまったらループを実際に動かしてみて、どこで詰まるか、どこで一線を越えるかを観察し、そこから思い切って改善を重ねていこう。
私たちはループを次のように定義する:agentが、ある停止条件を満たすまで、作業を何度も繰り返し実行することである。 Claude Codeチーム、Getting started with loops、2026-06-30
AIに繰り返し作業させる:「毎回張り付いて見る」から「条件を設定すれば自分で止まる」へ
Claude Codeチームは新製品を発表したわけではなく、バラバラだった5つの機能を、手動から無人運転までの4段階ループのフレームワークとして整理した。図付きで1枚にまとめて解説する。
↓ 1枚で読み終わる・動く図が1枚あります
2026年6月30日、Claude CodeチームがAnthropic公式ブログに寄稿し、AIコーディングアシスタントに「ループ」をどう設計するかを解説した。agent(自分で手を動かせるAIアシスタント)に、あらかじめ決めた「停止条件」を満たすまで繰り返し作業させる、という考え方だ。肝心なのはこの停止条件にある:いつ終わったとみなすかはあらかじめ決められていてシステムの判断に委ねられており、あなたが一回一回張り付いて急かすのではない。
これは新製品の発表ではない。チームがやったのは、もとからあった5つの機能(/goal、/loop、/schedule、dynamic workflows、auto mode)を、「自律度」に沿って並べた4段階のループとして統一的に整理し、そのままコピーして使える組み合わせテンプレートまで示したことだ。
機能はバラバラで、それぞれ個別に使われていた。どの種類の作業をいつ止めるかは、すべてあなたが一言ずつ急かし、手動で検収することに頼っていた。
ターン制 → ゴール制 → 時間制 → プロアクティブ制、というひとつの座標系に並べられた。上に行くほどあなたが引き渡す量は増え、張り付く時間は減っていき、最高段階では無人運転になる。
そこで疑問が出てくる:あなたが張り付かなくていいなら、一体何を根拠に「もう止めどき」と判断するのか?4つの段階の違いは、すべてこの一点にかかっている。
同じ作業で見てみよう——小互(シャオフー)が次々と届くbugレポートを処理するとして、4段階のループはこう動く。違いはたった2点だ:誰が「開始」を告げるか、誰が「止める」と判断するか。
ループが節約するのは処理時間ではなく、「小互が画面に張り付く回数」だ。同じ繰り返し発生する作業(1時間ごとに新しいbugレポートを処理する)で、旧来のやり方と新しいやり方の違いはここにある:
tokenを節約する2つの心得も覚えておく価値がある:決定的なステップはスクリプトに任せて動かすほうが、Claudeに毎回推論し直させるより安く済む。ある回の結果が基準に達しなかったときに直すべきなのはシステムのルールであり、そうすれば以降のすべてのラウンドが恩恵を受けられる——その1回だけを取り繕うのではなく。
以上の数字はすべてAnthropic公式ブログの定義と例に基づくものであり(/schedule、dynamic workflowsはいずれもリサーチプレビュー版機能)、第三者による再現はない。
テストを走らせられる。ひとかたまりの作業を全部こなせる。
でも本当に終わった?
毎回小互が張り付いて手動で検収するしかない。
「終わり」を決めるんだ?!
ひとつのフレームワークに整理した。
先に「いつ止めるか」を決めておくことだ。
→時間制→プロアクティブ制
最高段階では無人運転になる。
終わっていいか?
差し戻し、やり直し。
評価モデルが照合
自分で「もういい」と言って終わることはできない。
品質チェックを通すみたいだ
ボタンひとつで動き出す。
基準達成で自動的に終わる。