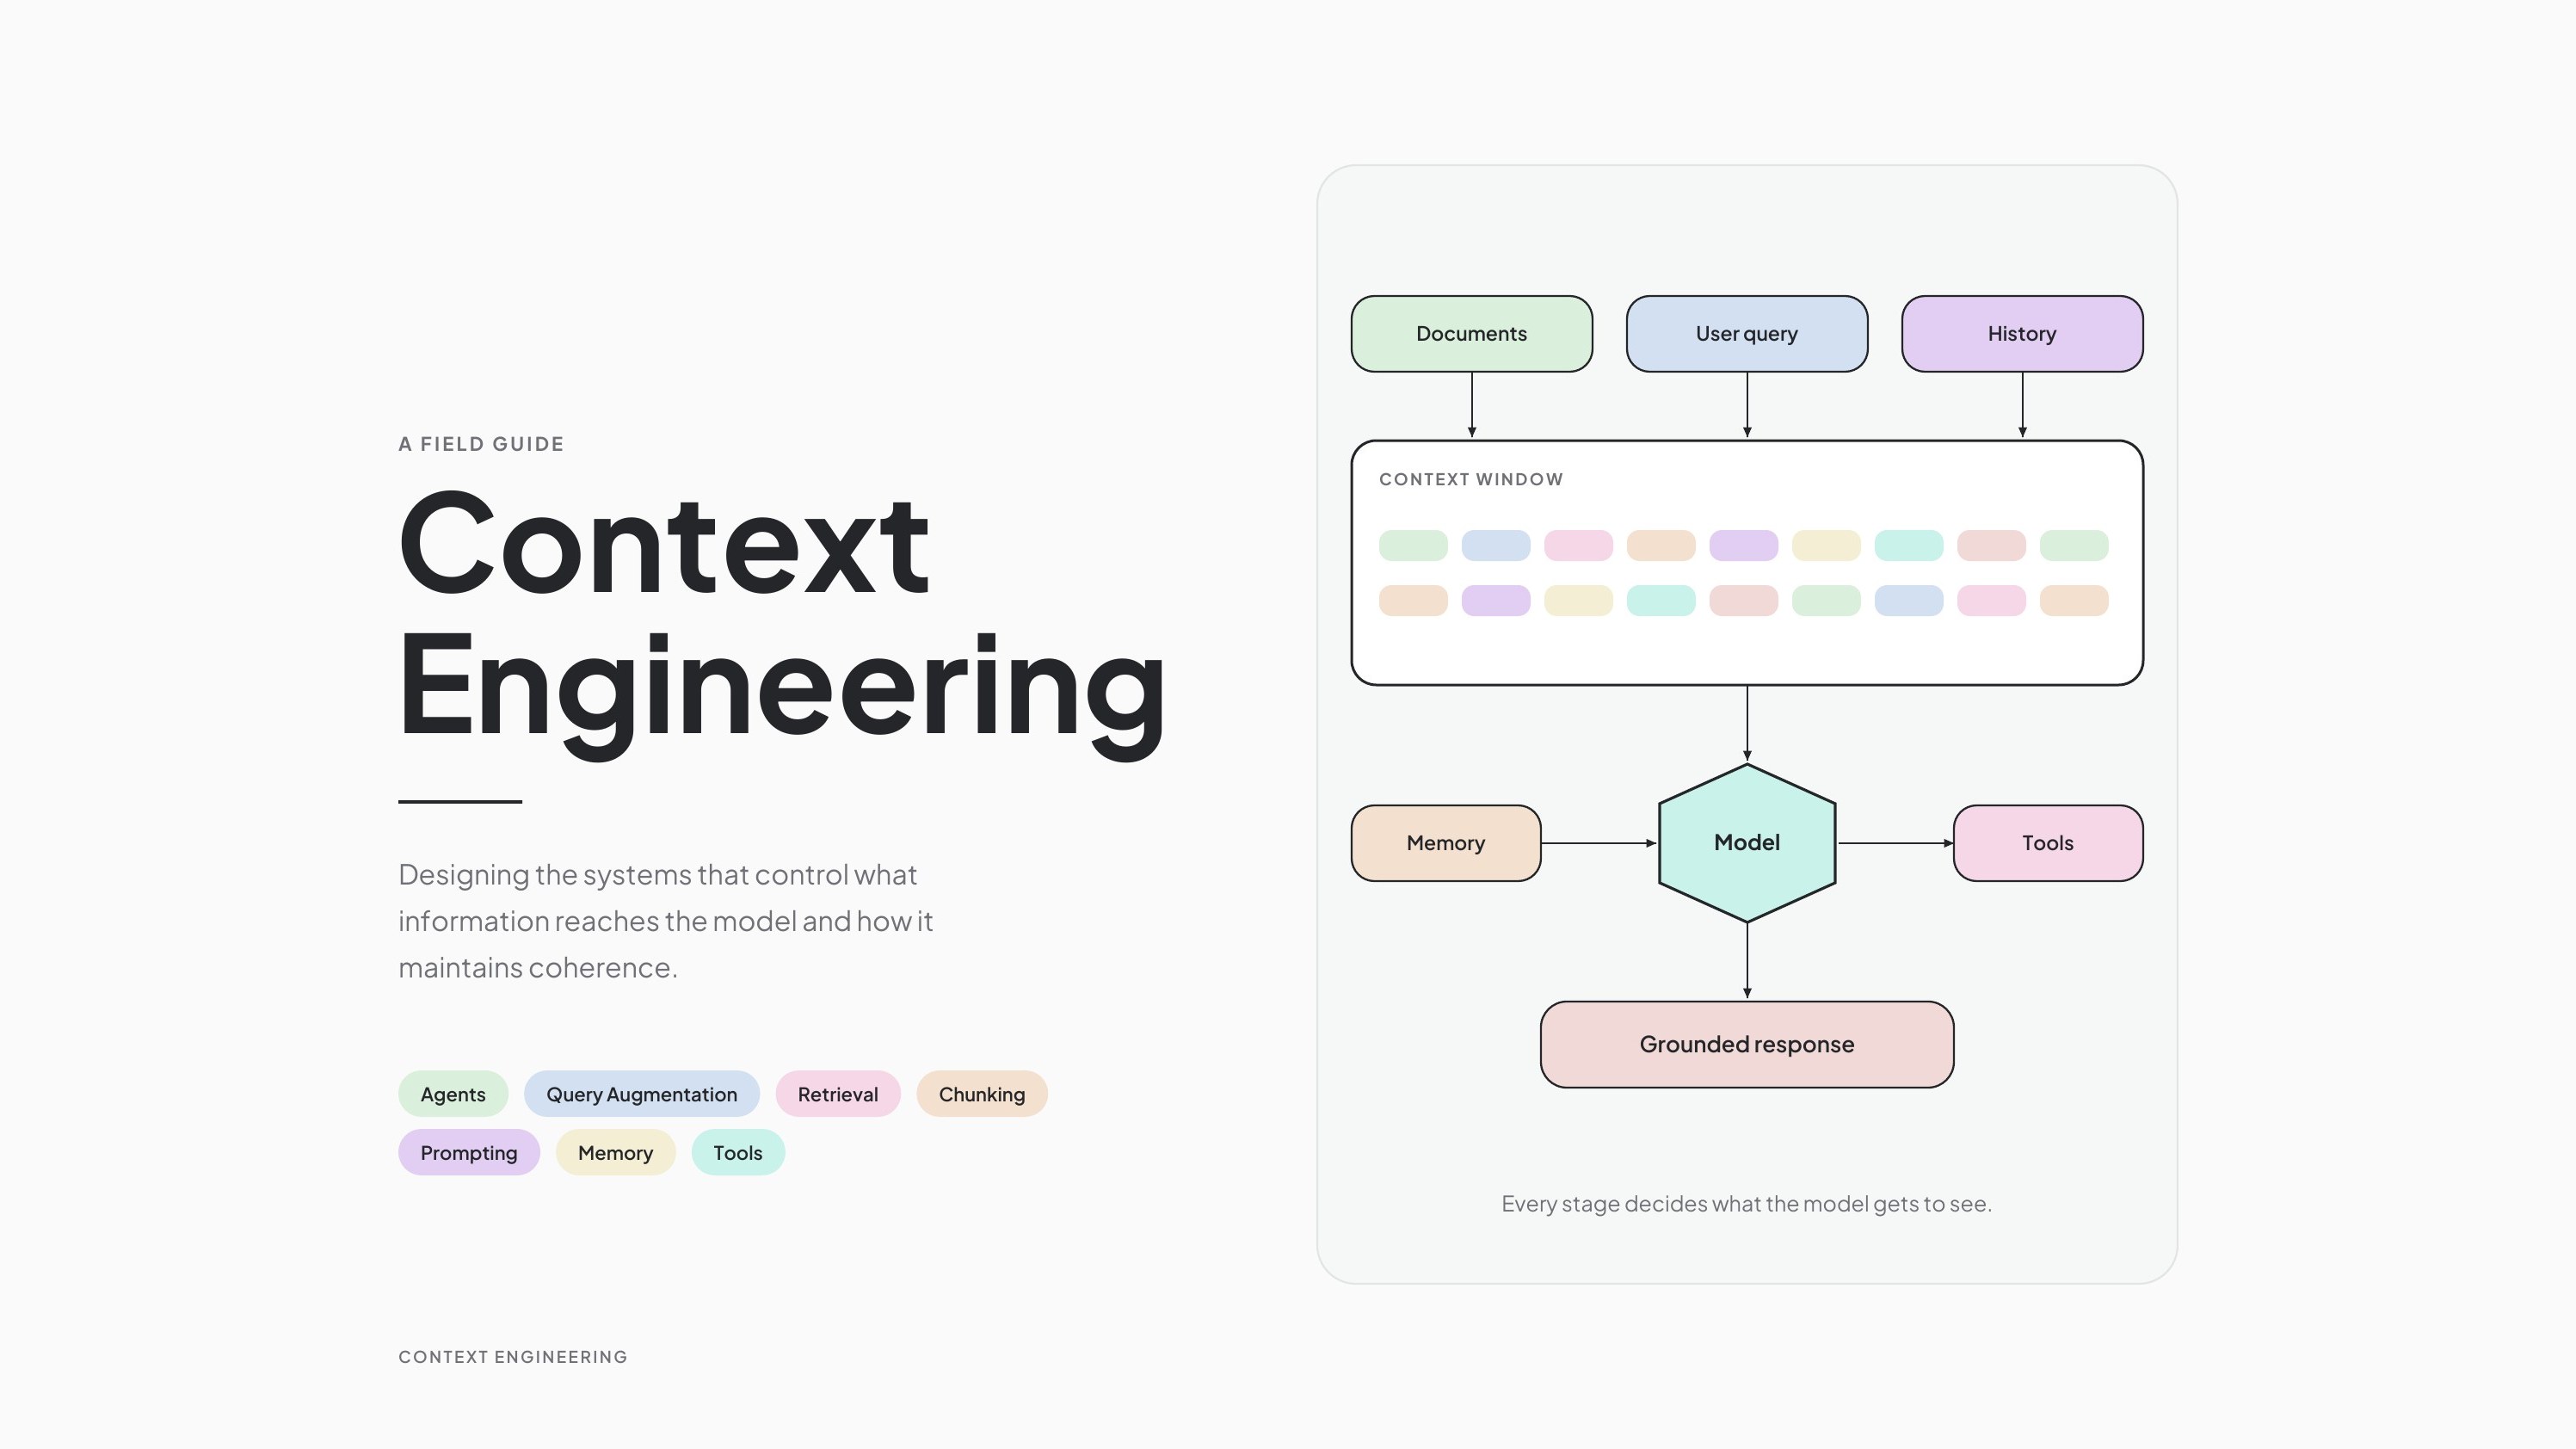
コンテキストエンジニアリング、その本質は何か
Weaviateは六つの能力でシステムマップを描き出します。真の主軸は、各ステップでどの情報をモデルに入れるか、どの状態を外部に残すか、次の実行を誰に任せるかを決めることです。
- このマニュアルは、コンテキストエンジニアリングをエージェント、クエリ拡張、検索とチャンク分割、プロンプト、メモリ、ツールの六つの相互接続された部分に分解しています。
- コンテキストエンジニアリングが制御するのは、一つのタスク内の完全な情報フローです。意図、証拠、プロンプト、状態、ツール、フィードバックが、モデルウィンドウにどのように入り、または出ていくかを管理します。
- このガイドはシステムマップを提供しますが、効果の実験は含まれていません。実装時には、六つの各ステップが検証可能な成果物を残し、実際のタスクセットで検証する必要があります。
『The Context Engineering Guide』は、Weaviate が公開した、AI アプリケーション開発者向けのコンテキストエンジニアリングの手引書です。この本では、AI システムがタスクを進める過程で、モデルに対して常に適切な情報を用意し続ける方法を扱っています。また、マルチターン対話、外部知識、長期的な状態、ツールの実行といった要素が、どのように一貫性を保つのかについても解説しています。
本書は、六つのパートで構成されています。エージェントは情報の流れ全体を制御し、クエリ拡張は曖昧なユーザーの質問を検索・実行可能な意図へと変換します。検索とチャンク分割は、大量の資料から現在必要な証拠を選び出し、プロンプトはタスクの目標と操作上の境界を定めます。さらに、メモリはターン間の状態を保存し、ツールはモデルの判断を行動に移して、その実行結果を次のターンに渡します。
この六つのパートは、リクエストの理解、証拠の選択、コンテキストの組み立て、状態の保存、ツールの呼び出し、結果に基づく継続または停止、という一連の実行チェーンを形成します。この手引書の核心となる問いは、モデルが各ステップで最も有用な情報だけを見られるようにしつつ、一時的に不要な状態を外部に確実に保持するにはどうするか、という点です。
モデルが高性能でも、システムが正しいコンテキストを得られないことがある
実際のAI製品で起こる障害は、「プロンプトの書き方が悪い」だけに起因することはほとんどありません。モデルが社内資料にアクセスできていなかったり、直近のビジネス上の変更を知らなかったり、前のステップで確定した決定を覚えていなかったり、似たようなツールが多数ある中で誤ったものを選んだりすることがあります。プロンプトを追加で改善しても、その場の呼び出しを修正できるだけで、データ、状態、アクションのインターフェースにおける根本的な問題は解決できません。

ここで言うコンテキストエンジニアリングとは、意図、証拠、ルール、状態、ツールの結果を実行時に選択し、組み立てることで、モデルが現在のステップで十分かつ関連性の高い情報を得られるようにすることを指します。
この手引書では、長いコンテキストにまつわるリスクを四つのカテゴリに分類しています。誤ったコンテンツが繰り返し再利用される「汚染」、無関係なコンテンツが多すぎる「注意散漫」、類似した素材が密集する「混乱」、そして矛盾するルールが同時に存在する「競合」です。これらは、コンテキストウィンドウが注意力の予算であり、その容量と品質を分けて管理する必要があるという事実を共通して示しています。
したがって、毎回の実行において四つの明確な決定を行う必要があります。どの情報を現在のウィンドウに残し、どの状態を外部に退避させて必要に応じて取り出すか、どの履歴を要約に圧縮できるか、そして計画と回答のためにどれだけのスペースを確保するかです。「あとどれだけトークンを詰め込めるか」だけに注目すると、より重要な予算の問題、つまりモデルが次のステップを判断するためにどれだけの注意力を残しているか、という点を見逃してしまいます。
完全なシステムは、六つの動作を繰り返します。まず意図を理解し、次に証拠を選択し、ルールと現在の状態をウィンドウに組み込み、行動するかどうかを決定し、必要な状態を外部に書き出し、最後にその結果を使って次のターンを修正します。エージェントはこの一連の流れの制御者であり、クエリ拡張、検索、プロンプト、メモリ、ツールはそれぞれにインターフェースを提供します。
この手引書は、エージェントの具体的なタスクも明確に示しています。履歴を定期的に圧縮すること、検索結果が一貫して利用可能かを検証すること、期限切れや無関係なコンテキストを削除すること、最初の検索が失敗した場合にクエリを書き換えたり知識ベースを変更したりチャンク分割の戦略を変えたりすること、一時的に不要な詳細を外部に退避させること、現在関連するツールだけをロードすること、そして複数の情報源が矛盾する場合にそれらを統合することです。エージェントはこれらの技術の代わりになるのではなく、実行時にどれを使用するかを決定する役割を担います。
- 意図書き換え、拡張、分解
- 証拠検索、チャンク分割、再ランキング
- 組み立てプロンプト、例、出力予算
- 状態作業、状況、意味、手順
- 行動ツール選択、パラメータ、承認
- フィードバック検証、継続、ロールバック、停止
この実行時の流れは、トラブルシューティングの順序も示しています。回答が的外れなら、まず意図が誤って解釈されていないかを確認します。事実が間違っているなら、検索された証拠を調べます。以前の決定を頻繁に覆すなら、状態が適切に永続化されているかをチェックします。ツールの使い方を誤っているなら、ツールの契約と選択ロジックを点検します。モデルを直接変更すると、多くの場合、最もコストがかからず特定しやすい障害ポイントを見逃してしまいます。
最初のステップ:ユーザーの質問を、システムが実行できる意図へと変換する
人間は、データベースのフィールドに合わせて話すわけではありません。ユーザーが「これ、どうしてまだダメなの?」とだけ書き、一つの文に三つの目標を詰め込んだり、「この顧客」がどの期間を指すかをシステムが当然知っていると思い込んだりすることもあります。入り口で明確にしなければ、その後の検索、再ランク付け、生成はすべて、誤った目標を真剣に最適化することになってしまいます。
クエリの書き換え、拡張、分解、そしてクエリエージェントは、それぞれ異なる四つの状況に対処します。
| 入口の症状 | システムの動作 | 主な利点 | 主なコスト |
|---|---|---|---|
| 曖昧、口語的 | 曖昧さの解消、キーワード補完、ノイズ除去 | 検索インターフェースに適合しやすくなる | ユーザーの意図を誤って変更する可能性がある |
| 質問の仕方が単一、広範囲な検索が必要 | 関連する複数のクエリを生成 | 再現率とカバレッジが向上 | トピックの逸脱、遅延、重複 |
| 1つの質問に複数の目的が含まれる | 独立して処理できるサブ問題に分割 | それぞれの検索がより正確になる | 統合時に矛盾が生じる可能性がある |
| 複数のデータベースにまたがる、経路が不明 | スキーマに基づいて動的にクエリし、結果を評価 | 結果に応じて戦略を変更できる | コスト、遅延、デバッグの複雑さ |
クエリの書き換え自体には、三つの基本的な動作があります。不自然または省略が激しい質問を再構成すること、検索の妨げになる無関係な背景を削除すること、そして対象となる資料でよく使われるキーワードを補完することです。必要に応じて、複雑な質問をサブ問題に分解します。ここでの目標は、各段階に適した異なる形式のクエリを用意することです。検索エンジン用のバージョンはマッチングを重視し、最終的な回答用のバージョンは完全な意図を保持します。これは単にユーザーの発言を磨くことではありません。
例えば、「最近の顧客離れの原因を調べて、最も訪問する価値のある三社を見つけて」という質問には、少なくとも三つの意図が含まれています。「最近」がどの期間を指すのか、「離れ」をどの基準で判断するのか、「訪問する価値がある」を金額、アクティビティ、回復の可能性のどれで決めるのかです。システムはまず質問を構造化された問題に書き換え、原因分析と顧客スクリーニングを別々に検索し、最後にそれらを統合します。データがCRM、チケット、通話記録に分散している場合、クエリエージェントは各データベースのスキーマに基づいて、検索、フィルタリング、集計の順序を動的に決定する必要があります。
完全なクエリエージェントは、少なくとも分析、実行、そして任意の統合という三つの段階を経ます。まず問題のタイプ、必要な情報源、フィルタ条件を判断し、次に検索を実行します。結果にフィールドが不足していたり、証拠が矛盾していたり、タスクを完了するのに不十分な場合は、ギャップを評価し、クエリを書き換えるか拡張して再試行します。証拠が揃った場合にのみ、統合された回答に進みます。このサイクルは「一回の検索後に直接生成する」方法よりもコストがかかりますが、検索の失敗を回復可能な中間状態として明らかにすることができます。
クエリの拡張は再現率を向上させることができますが、ユーザーの意図を必要以上に広げてしまう可能性もあります。分解は精度を高めますが、呼び出し回数と統合の複雑さが増加します。クエリエージェントは未知の経路に適応できますが、レイテンシ、コスト、デバッグの複雑さが加わります。選択基準はタスクに基づくべきです。質問が曖昧かどうか、複数の目標があるかどうか、複数のデータベースにまたがる必要があるかどうか、最初の検索が失敗した後に探索を続ける価値があるかどうかです。
入り口の段階では、少なくとも三つの確認可能な成果物を残す必要があります。ユーザーの発言をそのまま残した正規化された意図、越えることのできない範囲条件のセット、そして「どのような結果が回答の完了とみなされるか」を示す受入基準の文です。この三つがなければ、システムは後の動作が探索なのか、それともすでに話題から逸れているのかを判断することが困難になります。
第二のステップ:現在必要な知識だけをコンテキストウィンドウに入れる
意図が明確になった後、システムは二つ目の問題に直面します。資料がウィンドウよりはるかに大きい場合、そのうちのごく一部で、見つけやすく、かつ十分なコンテキストを持つものはどれでしょうか。これこそが、検索とチャンク分割が実際に解決する問題です。
チャンクを小さく切りすぎると、個々の断片はヒットしやすくなりますが、主語、条件、例外が失われる可能性があります。逆に大きく切りすぎると、コンテキストは完全になりますが、ベクトル表現が複数のトピックに平均化され、検索時に正確にヒットさせることが難しくなります。この手引書では、これを「検索精度」と「コンテキストの完全性」のスイートスポットとして図示しています。このスイートスポットに、業界全体で通用する数値はありません。それは、文書の構造、質問の粒度、下流のタスクによって変化します。
固定長チャンク分割は高速で、短く規則的な資料に適しています。再帰的チャンク分割は段落や文を段階的に処理するため、一般的なデフォルトと言えます。見出しや関数による分割は、構造が明確なドキュメントやコードに適しています。セマンティック、LLM、エージェンティックなチャンク分割は、より高いコストでトピックの境界を判断します。階層的チャンク分割は、要約、セクション、詳細を同時に保持します。late chunking は、まず表現に全文を読ませてから、その中からチャンク表現を生成します。方法に加えて、いつ分割するかも決定する必要があります。事前分割はコストをオフライン段階に置くため、クエリは高速ですが戦略は固定されます。事後分割は現在の質問に基づいて動的に処理するため、柔軟ですが最初のターンは遅くなります。
以下のセレクターは、この手引書の戦略マトリックスと事前/事後分割のトレードオフを組み合わせたものです。これはエンジニアリングの出発点であり、性能を保証するものではありません。
3つのタスク条件を選択すると、提案がどのように変わるかを確認できます。下部には完全な静的ベースラインも表示されます。
オフラインで見出しや構造の境界に基づいてチャンク分割し、ターゲットサイズで制約します。
これは当サイトがガイドに基づいて取捨選択した出発点です。最終的な選択は実際の問題セットで評価する必要があります。4つの代表的な組み合わせを見る
| ドキュメント構造 | コンテンツの更新頻度 | 初回応答までの遅延 | 提案 |
|---|---|---|---|
| 構造が明確 | 比較的安定 | 低遅延が必須 | Document-based / Recursive + 事前チャンク分割 |
| 構造が疎ら | 比較的安定 | 低遅延が必須 | Recursive / Semantic + 事前チャンク分割 |
| 構造が明確 | 頻繁に変更 | 追加処理を受け入れ可能 | Document-based + 事後チャンク分割 |
| 構造が疎ら | 頻繁に変更 | 追加処理を受け入れ可能 | Semantic / LLM-based + 事後チャンク分割 |
選択後には、タスクレベルの評価も行う必要があります。まず、実際の質問を小さなセット用意し、各質問に対して必ずヒットすべき元の段落をマークします。次に、検索結果が回答をカバーしているか、必要な限定が含まれているか、無関係な断片がどの程度あるか、最終的な回答が原文に遡れるかを確認します。ベクトル類似度やデモでの成功例だけを見ていると、チャンク分割戦略はドキュメントを変更した後すぐに機能しなくなる可能性があります。
これはまた、この資料のベンダー視点を露呈しています。Weaviate は当然、ベクトルデータベースを中心に据えています。本番システムでは、キーワード検索、リレーショナルデータベース、ファイルインデックス、イベントログ、直接的なツールクエリを組み合わせることもあります。検索層の目標は、利用可能な証拠を取得することであり、特定のストレージ方式が先進的であることを証明することではありません。
第三のステップ:プロンプトとメモリで、一回の呼び出しを長期的なタスクにつなげる
検索結果が自動的に優れたコンテキストになるわけではありません。システムは、タスクのルール、証拠、最近の対話、ツールの説明、出力スペースがそれぞれどの程度を占めるかを決定する必要があります。また、どの詳細が現在のステップでのみ有効で、どの状態をターン間で保存する価値があるかも判断します。
プロンプトはここで制御層の役割を果たします。目標、境界、ツールのトリガー条件、パラメータ形式、戻り値、完了基準を定義します。この手引書では、few-shot、Chain of Thought、Tree of Thoughts、ReAct を紹介しています。真に転用可能な部分は、例を使って出力契約を固定し、複雑なタスクを検査可能な段階に分割し、行動の結果を次のターンに反映させることです。モデルに私的な推論を表示させる必要はありません。計画、ツールのパラメータ、実行結果、引用、状態の変化があれば、監査には十分です。
メモリは時間軸を延長します。現在のウィンドウは、最近のメッセージとこのステップに必要な資料を保存します。ワーキングメモリは、複数ステップのタスクで未完了の状態を保持します。エピソディックメモリは、発生したイベントを記録します。セマンティックメモリは再利用可能な事実を保存し、手続き的メモリは検証済みの作業方法を保持します。これらは、保存場所、書き込み条件、クリーンアップ条件がそれぞれ異なります。
| 状態の種類 | 一般的な保存場所 | 書き込み条件 | 読み取り条件 | クリーンアップ条件 |
|---|---|---|---|---|
| 現在のコンテキスト | モデルウィンドウ | 今回のターンで実際に必要 | 毎回の呼び出し | ツール出力と重複情報を圧縮 |
| 作業状態 | タスク台帳 / ステートマシン | マルチステップタスクが未完了 | 復元または次のステップへ進む | タスク終了後にアーカイブ |
| エピソード記憶 | イベントログ | イベントが将来の判断に影響する | 類似オブジェクトや時間範囲 | 重複を統合、期限切れをマーク |
| 意味記憶 | ナレッジベース / データベース | 事実が検証済みで再利用可能 | 問題がその事実を必要とする | バージョン、出典、有効期限 |
| 手続き記憶 | プロセス / Skill / Playbook | 方法が検証済み | 同種のタスクがトリガー | 新しいプロセスが古いプロセスを置き換える |
「何でも保存する」と、別の種類の忘却を生み出します。重要な情報が、繰り返し、期限切れ、低品質の記録に埋もれてしまうのです。実用的なメモリシステムは、少なくとも五つの質問に答えなければなりません。誰が書き込めるのか、何に基づいて書き込むのか、矛盾をどう統合するのか、いつ取り出すのか、いつ期限切れまたは削除するのか、です。検索の質は書き込みの質と同じくらい重要です。誤ったメモリが繰り返し取り出されると、一度の失敗が長期的なバイアスに拡大する可能性があります。
メモリのアーキテクチャはタスクに従わなければなりません。カスタマーサービスエージェントは、ユーザーのやり取りの履歴を再現できるエピソディックメモリに依存します。財務分析エージェントは、安定したドメイン知識に依存します。単純なタスクであれば、まず最近の数ターンの対話をバッファとして使用し、最初から完全な長期メモリを構築する必要はありません。選択の基準は、タスクがクロスターン状態、パーソナライズされた履歴、安定した知識、再利用可能なプロセスを必要とするかどうかにあります。
メモリの取り出しも、一度の盲目的な検索で済ませるべきではありません。この手引書が示す改善策には、まずクエリを拡大または反復してから候補を取得すること、再ランク付けで本当に関連する記録を前面に押し出すこと、必要に応じてクエリエージェントに複数のコレクションをまたいで検索させること、またはパーソナライゼーションロジックにユーザーの好みと対話履歴を組み合わせて再ランク付けさせることが含まれます。保存できることは最初のハードルに過ぎず、正しい瞬間に正しい記録を取り出せることこそが、メモリシステムの核となる能力です。
この手引書は、コンテキストの外部化を、情報をウィンドウの外に置き、必要な時に取り出すことと説明しています。現実には、最も軽量な実装は、多くの場合、構造化されたタスク状態です。目標、完了したステップ、重要な決定、未解決の問題、証拠の場所です。これは、すべてのチャット履歴を保持するよりもコストがかからず、検証も容易です。
この原則が実際の製品でどのように適用されているかの例として、当サイトの記事では、Claude Code がシステムプロンプトとツールの説明を削減した具体的な方法を分析しています。
第四のステップ:エージェントにツールを選択させ、結果を使って次のターンを継続する
ツールによって、モデルは質問への回答から行動へと移行します。function calling は、「コマンドのようなテキストを出力する」ことを、構造化された関数名とパラメータへと発展させます。MCP は、リソース、プロンプト、ツールの接続方法を標準化します。接続が成功したことはインターフェースが利用可能であることを示すだけで、エージェントが正しいタイミングで、正しいパラメータを使って、適切な承認を得てそれを呼び出すことを保証するものではありません。
単一のツール呼び出しとツールチェーンは、難易度が異なります。フライトを一回調べるだけなら、ツールを選択し、パラメータを入力し、結果を解釈するだけです。週末の旅行を計画する場合、フライト、ホテル、現地のアクティビティを順番に調べ、前のステップの結果を次のステップの制約条件に変換する必要があるかもしれません。ツールチェーンは、計画の順序、中間状態、部分的な失敗、停止条件という複雑さを増します。
信頼性の高いツールループには、少なくとも七つのチェックポイントがあります。利用可能なツールの発見、無関係なツールの除外、選択または計画、パラメータの構築、承認の取得、実行とObservationの検証、そして最後に、継続、戦略変更、ユーザーへの問い合わせ、停止の判断です。
パラメータの構築は、最も過小評価されがちな関門です。エージェントは正しいツールを選んでも、必須フィールドを欠落させたり、単位を間違えたり、形式が不正なパラメータを生成したりする可能性があります。この手引書の例は、回復可能な経路を示しています。最初の呼び出しが不正なパラメータのためにエラーを返し、そのエラーがObservationとしてウィンドウに戻り、エージェントがそれに基づいてパラメータを修正して再実行します。いわゆる自己修正は、「エラーを読み解く→パラメータを変更する→再検証する」という観察可能なプロセスに落とし込む必要があり、「モデルが振り返る」といった記述だけでは不十分です。
- 発見関連ツールのみを公開
- 選択使用するか、どれを使用するかを決定
- パラメータ型、単位、形式
- 承認権限と副作用
- 実行べき等性、タイムアウト、再試行
- 観察結果とエラーを検証
- 停止継続、別の方法、確認、または終了
ツールの説明はコンテキストの一部です。優れた契約には、動詞、適用範囲、必須パラメータ、単位と形式、戻り値の構造、エラー状態、制限事項を明確に記述する必要があります。ツールの戻り値もサイズを制御する必要があります。数万行のログをそのままウィンドウに戻すと、次のステップの意思決定がノイズに埋もれてしまいます。要約、重要なフィールド、元の結果の場所、再確認可能なリファレンスを保持することが、通常はより堅牢です。
MCP の価値は、繰り返し発生する適応作業を減らすことにあります。従来の方法では、M個のAIアプリケーションがそれぞれN個の外部システムに接続する場合、最悪でM×N組のカスタム接続を維持する必要がありました。標準プロトコルにより、アプリケーション側とサーバー側がそれぞれ一度だけ適応すればよいため、接続の問題はM+Nに収束します。MCP が向上させるのはモジュールの組み合わせ可能性であり、呼び出しの信頼性ではありません。公式仕様の基本プリミティブには Resources、Prompts、Tools が含まれており、「モデルにツールを接続する」というだけではありません。それでも、権限、承認、データ境界、冪等性、リトライ、停止条件をアプリケーションが決定する代わりにはなりません。MCP を接続したことをエージェントの完成とみなすのは、コンセントを設置したことを家電製品が安全に動作していると誤解するようなものです。
マルチエージェントも同じ原則に従います。専門のサブエージェントは、クリーンなコンテキストで狭いタスクを並行して処理でき、メインエージェントは圧縮された結果のみを受け取ります。その代償として、タスクの分割、証拠の受け渡し、競合のマージ、共有状態の管理が難しくなります。タスクに明確な並列処理の利点がない場合、単一のエージェントと明確なツールおよび状態の方が、検証が容易なことがよくあります。
コンテキストエンジニアリングシステムは、最終的にこの六つの受け入れ基準を満たす必要がある
この手引書は、プロンプト、検索、メモリ、ツールを一つのシステム図にまとめています。効果の実験を提供するものではなく、フレームワークを選択してくれるものでもありません。そこには六つの工学的な関門が示されています。各ステップに、検査可能な成果物、失敗のシグナル、次のステップへの引き継ぎが必要です。
ユーザーの発言、正式な意図、完了条件
失敗: システムが誤った目標を最適化した位置特定可能な断片、出典、制約条件
失敗: 回答に数字があるが、資料に遡れないシグナルの高い入力と出力予算
失敗: ウィンドウが無関係な履歴やツール出力で埋まる書き込み、読み取り、更新、忘却のルール
失敗: 古い決定が失われる、または誤った記憶が再発するツール契約、権限、パラメータ、べき等性
失敗: ツールの選択を誤る、または重複した副作用が発生する結果の検証、ロールバック、停止条件
失敗: エージェントのループが止まらない、または誤った状態で継続するエージェントを評価する際には、失敗から逆算することができます。意図層では、ユーザーの発言と完了基準が保持されているか。証拠層では、元の断片を特定できるか。組み立て層では、シグナルの高いコンテンツと出力スペースの両方が予算に含まれているか。状態層では、書き込み、更新、忘却のルールがあるか。行動層では、承認、パラメータ、冪等性の契約があるか。フィードバック層では、Observationに基づいて継続、ロールバック、停止ができるか。
これらすべてを満たして初めて、システムはコンテキストエンジニアリングを備え始めたと言えます。それでも、実際のタスクセットを使って、正確性、コスト、レイテンシ、回復力を検証する必要があります。この手引書のメソッドリストは設計の地図であり、本番の信頼性は継続的な評価、ログ、障害の振り返りから生まれます。

記事の最後で、プロンプトエンジニアリングとコンテキストエンジニアリングを、それぞれ異なるスケールとして描いています。前者は現在のウィンドウ内の指示に焦点を当てるのに対し、後者はドキュメント、ツール、メモリファイル、履歴、ツールの結果がどのように動的に取り込まれるかを管理します。この対比は、さらに一言でまとめることもできます。モデルの能力は「何が可能か」を決め、コンテキストシステムは「何に基づいて行動するか」「今何ができるか」「そして行動した後に何が残るか」を決める、ということです。