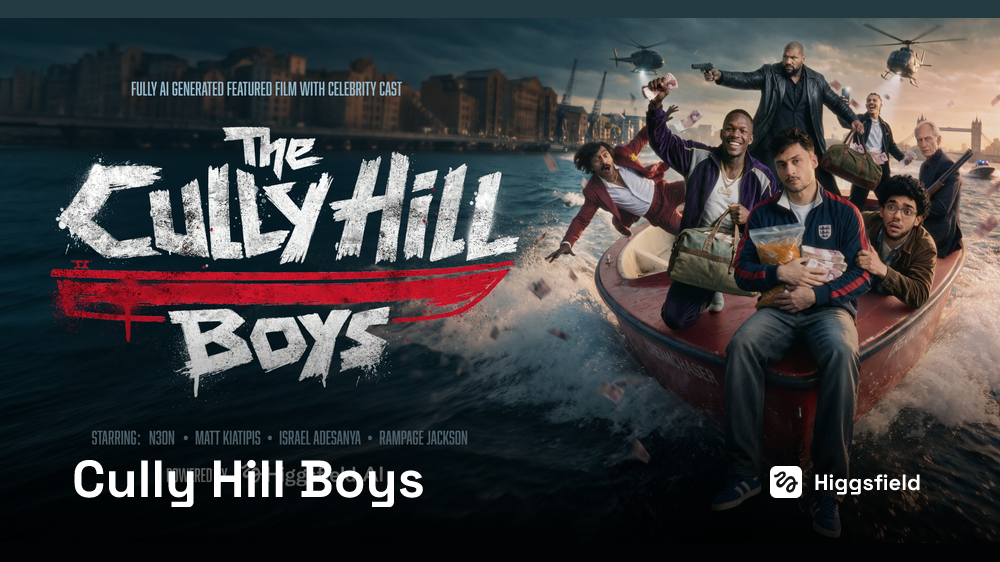
Higgsfield、実写俳優の肖像をAIで使用して110分の長編映画を制作し、制作マニュアルとプロンプト手法をすべて公開
- 1時間54分のAI長編映画が、制作手法一式と自社用のClaudeスキル3点をまとめて公開しました。
- このマニュアルが取り組むのはたった一つ。「動画モデルに記憶はない」→ だから「同じ人物を同じ人物に見せる」ことこそがすべての仕事です。
- 一番価値があるのは、直感に反する禁忌の数々。設定表に「studio」と書かない、全身ショットは頭を消す、プロンプトに「〜しない」と書かない——です。
AI長編映画、その制作マニュアル全公開
この2年、AI動画は数秒〜数十秒の世界が主流で、画質やカメラワーク、単発のショットの派手さが競われてきました。Higgsfield(AI動画生成プラットフォームを手がける企業)が今回持ち込んだのは、別次元のものです。110分の劇映画。4人の実在俳優が肖像と声の使用を許可し、制作期間は4週間、コストは200万ドルです。
彼らは同時に、作品を100%オープンソース化すると発表し、すべてのプロンプトとアセットを公開しました。当サイトが項目ごとに確認したところ、直接ダウンロードできるのはClaudeスキルファイル3点。残りの素材はプロジェクトページ本文とキャンバス上に分散しており、具体的に何が不足しているかは、末尾のセクションで詳述します。
作品は『The Cully Hill Boys』。ロンドンの売れないラッパー3人が、名声を求めて誤って麻薬の抗争に巻き込まれるアクションコメディです。8月5日にニューヨークで初映されました。
以下で解体するのは、作品と一緒に公開されたもの、完全な制作マニュアルです。アセットの作り方、プロンプトの書き方、演技の調整方法、ラップパートのリップシンク、ポストプロダクションでの管理方法まで、徹底解説。彼らが実際に使っているClaudeスキルファイル3点もダウンロードできます。

全フレームが生成されたものです。セットも撮影クルーも存在せず、俳優本人は一度も実写撮影に参加していません。彼らが提供したのは、デジタル化が許可された肖像と声のみ。全編で唯一の例外がありますが、これについては後述します。
何で作るか:5つのツールが各工程を担当
全編のカット、動画、ボイスは、Seedanceで生成。顔とキャラクター設定表はSoul Cinemaが担当。編集、リバースショット、視点の変更にはSeedreamとNano Bananaを使用します。
プロンプトはすべてClaudeが書き、しかも意図的にチャットを2つに分けています。片方は画像プロンプト専用、もう片方は動画プロンプト専用です。理由は、一方のルールが他方を汚染するから。画像側にはフラットな照明や、CGっぽさを避ける言い回しが必要です。動画側には、画角を度数で指定し、すべての光に光源が必要です。これを1つのチャットに混ぜると、両方のルールが混ざり合ってしまいます。
3つのスキルを、使用順に
彼らは頻用ルールをClaudeスキルとしてパッケージ化しました。ルールブックを1つ用意し、Claude自身がそれを読み込んで作業します。3つのスキルのSKILLファイルはすべて公開されており、ファイル名をクリックするとダウンロードできます(末尾にも再掲します)。
もう4つは、前作から受け継いだもの
このチームは以前、HELL GRIND という作品を制作しました。その時は作りながら試行錯誤していましたが、今回は初日からこれらを手にしていました。
- シーンコンテキスト:各カットの冒頭で、この場面でドラマとして何が起きているか、誰がいるか、長さを明確に書く。
- ファーストフレーム空間ロック:最初のフレームで配置を確定させ、全員が所定の位置につく。空虚な引きのショットは作らない。
- 各セリフの後に1秒の無音を残す:クリップ内にきれいな尻尾を残し、編集者が継ぎ目を作れるようにする。モデルが音を捏造する余地もなくなる。
- 表情と演技はビート単位で書く:顔と身体をビートごとに書き、形容詞でごまかさない。
しかし全ルールが狙うのは1つのこと:モデルに記憶がない
このマニュアルがこれほど分厚いのは、たった1つの出発点があるからです:一貫性こそがすべての仕事です。
動画モデルには記憶がありません。キャラクターの説明が不完全だと、次のカットで見た目も行動も声も変わってしまいます。さらに、空間はカメラが動くと崩れ、音声はクリップ間で漂い、シーンは位置関係を失います。これらを合わせると、AIで長編映画を撮る際にずっと対処すべき課題になります。
彼らの基本方針は一言で言えば、各カットは「参照 + テキスト」から生成されることです。アセットは映像を担当し、テキストはそれ以外のすべて、幾何学的関係も含めて担当します。誰がどこに立つか、カメラはどちら側か、光はどの方向から当たるか。
さらに、全編を通じてより厳しい制約があります:テキストのみで動画を生成し、ファーストフレームを与えず、画像から動画への変換もしない。これは難しい方法ですが、それゆえにカットがつながります。
全編で唯一このルールを破ったのが、キャデラック車内での銃の奪い合いのシーンです。2人が接触し続け、同じ銃を奪い合うため、生成結果は四肢が絡まり、銃がこの手から消えてあの手に現れる、というものでした。最終的に彼らはスタントマンを頼み、実際の車内でスマホで1日撮影し、この素材を動作参照としてモデルに与えました。モデルはキャラクター、内装、照明を重ね合わせました。1日のスマホ素材で、1週間分の試行錯誤を省きました。
2つで1組です:すべてのプロンプトに一字一句入るテキスト記述と、モデルを固定するための参照画像。キャラクター、ロケーション、小道具はそれぞれがアセットです。
撮影現場のメイク写真とキャラクター紹介文のようなものです。写真は見た目を、紹介文は性格と服装を担当し、両方を新しい撮影監督に渡します。
そして撮影前に、脚本をカードに分解する
彼らの絵コンテ分解は、脚本をすでに監督の意図が組み込まれた準備済みの絵コンテ表に変えることであり、単に作るべきものをリストアップすることではありません。各カットに1枚のカードがあり、カードには4つのグループがあります。
| カードのグループ | 書く内容 |
|---|---|
| 素材 | ロケーションと内外観、それをカバーするアセット。時間帯(どのアセットバリアントを使うか決めるため)。画面に登場する各人物(タグと状態付き)。小道具と車両(タグ付き)。アクションは1〜3文。セリフは一字一句。長さ(秒)。複雑さ(簡単、普通、複雑) |
| 監督 | このカットの目標(1文)。キャラクターのタスクを動詞で書く(問い詰める、暴く、辱める)。開始から終了までに何が変わるか。カメラに対する相対的な立ち位置。演技(顔と身体が何をするか、キャラクターが何を隠しているか) |
| 撮影 | 画角、動き、レンズ、アングル |
| 編集 | どのようにカットするか、テンポ、次のカットへのつなぎ方 |
各カードにはシーン番号とカットのアルファベットが付きます(例:50B、50C)。同じ番号がカードからバージョンログ、プロンプトファイルまで一貫して使われるので、隣接する2つのカットが混同されることは決してありません。
このバージョンログには最終的に 137件 が記録され、どのカットが繰り返し作り直されたかがわかります。最も難しかったものは v15、v10、v9 まで修正されています。この記録がないと、良いカットを再現できず、特定の修正方法をすでに試したかどうかもわかりません。
カードが埋まれば、プロンプトはほぼ機械的に書き写せます。さらに重要なのは、穴は生成を1回消費する前に見つかることです。目標のないカット、タスクのないキャラクター、アセットのないシーンは、カードを見れば一目瞭然です。
だから、アセットがロックされるまで、1カットも撮ってはいけない
600点の承認済みアセットの内訳は次の通りです。主人公と敵役のカードが74枚、脇役と動物が52、1〜2シーンしか登場しないモブキャラクターが90、小道具が159、ロケーション背景図が200枚以上。
状態そのものがアセットです。きれいなジャケットのCal、水に濡れたCal、第3幕で眉を割って血まみれのCal。これは3つの別々のアセットであり、1つのアセットにメモを追加するものではありません。
新しい状態を作る方法も決められています:元の設定表を使って、変更された部分だけを変える。服を着替えさせ、傷を追加し、布地を濡らす。それ以外はすべて変えません。これで肌の質感が保たれます。画像全体が再度モデルを通過することがないからです。さらに、新しいバージョンは古いバージョンを上書きせず、それぞれに独自の名前とバージョン番号があります。
ロケーションも同様です。昼、夜、雨は3つのアセット。小道具も同様で、銃には2つの状態があり、車のフロントシートと後部座席の内装は別々に数えます。

@char_CB_Kel_v9                — キャラクター、プロジェクトコード、名前、バージョン
@loc_CB_warehouse_s6_v2        — ロケーション + どのシーンのために作られたか
@loc_CB_kal_street_s5-46_v3    — 1枚の背景図が第5シーンと第46シーンに使われる
@prop_CB_gunTobin_s26_v2       — 小道具、シーン、バージョン
@prop_CB_sedan_interior_back   — 車内装は小道具として扱う。ロケーションではない
すべてのアセットは1枚のキャンバスに並べられます。ルールはただ1つ:キャンバスにないアセットは、カットに登場しません。
そして設定表の禁忌は、すべて失敗から生まれた
キャラクター設定表は、1枚の画像に3コマあります:正面全身、背面全身、大きなクローズアップ。クローズアップは4分の3アングルで、正面と側面の両方の情報を一度に与えます。
本当に価値があるのは次の4つです。それぞれの背後に具体的な失敗があります。

ロケーションは斜めから撮る。色彩設計は前もって確定させる
ロケーション背景図は、一律4分の3の斜めアングルで中景または遠景を生成し、正面からは撮りません。正面から撮った部屋は平らな壁紙のようで、モデルは空間の奥行きを読み取れず、画面の端の外は毎回勝手に作り出します。斜めから撮ればボリュームが出て、人物が正しく立ち、1枚の画像でほぼ一周分のアングルをカバーできます。
- 各ロケーションにアンカーポイントを1つ残す。柱、照明、ソファ、傾いた椅子など。そして、立ち位置をそれに結び付けます。「照明のそばに立って、ドアの方を向いている」は有効です。「部屋にいる」は宝くじです。
- 1つのライティングロジック:光源は1つ、影の方向は1つ。太陽が2つ現れてはいけません。背景図には人を置かず、武器も置きません。
- リアルな表面の言葉でレンダリング感に対抗する:錆、ひび割れ、ガムテープ、指紋、油汚れ、水跡。
もう1つの技:リバースショットは動画から切り出せます。人物のいない、カメラがゆっくりと空間を移動する動画を生成すると、モデルは背景図に基づいて部屋の他の面を描き出します。必要なアングルをキャプチャーし、Seedream や Nano Banana で質感と光を高めます。1枚の画像から、一式のロケーションが作れます。
会話シーンのロケーションには一式が必要です。斜め、正面、リバース、そして各キャラクターの背景図。通り過ぎるだけのロケーションには、1アングルで十分です。
色彩設計はポストプロダクションに取っておかず、アセット作成時に確定させる
撮影前にビジュアルバイブルを書き、すべての背景図をそれに従って作成します。全編をいくつかの「世界」に分け、それぞれの世界に1つの色域を割り当てます。公営住宅街は、濡れたアスファルトに染み込んだカーキグリーン。ラップシーンは、コンクリートとブラウン管テレビ。母親の家は、暖かい白とハニーオーク。あるボスのクラブは、牛血赤、マホガニー、輝きを失った金。別の世界は、漆塗りの紅と鏡面真鍮。テムズ川は黒い水。警察システムは、暖かみを一切排除したグレーのコンクリート。
1つの世界内の画面比率も確定させます:80〜85%がベースカラー、10〜15%が1つか2つのアクセントカラー、残り約5%が対比色。
それは画面内にある実際の光源を持つ物体でなければなりません:緑のドア、ナトリウムランプ、オレンジのテント、モニターの光。グレーディングで作ったアクセントカラーは、次のカットで一致しなくなります。
同じ色相で2つのシーンを区別するには?質感と年数で区別します。色番号ではありません。2人のボスはどちらも赤と金の中で生きています:古い方は、パティナ。乾いた牛血赤、輝きを失った金、古いランプ。新しい方は、磨き上げ。飽和した紅、鏡面真鍮、一列に並んだ対称的な同じランプ。こう書けば、同じように豪華な内装でも、同じ部屋には見えません。

見た目が良いだけではダメ。アセットを10回実行して認識できるか
設定表自体が見栄えよくても、何も証明されません。彼らの検収方法は、それを使って動画を生成すること:10回実行し、動作、画角、ロケーションを変えて、10回すべて同じ人物と認識できることではじめて合格です。そして、実際のプロンプトを使い、キャラクターを走らせ、ラップさせ、電話させ、泣かせ、笑わせます。
そうして初めて、顔が安定するのはキャラクターが平静な時だけだと気づきました。
Cully Hill Boys プロジェクトブリーフ
2つの付随ルールも同様に役立ちます:
- キャラクターとロケーションは一緒にテストする。2つのアセットは互いに影響を与えるため、キャラクターだけをテストするのは無意味です。だから、ロケーションが完成する前にキャラクターをテストしてはいけません。また、一緒に画面に映る他のキャラクターともテストします。単独で成立する人でも、2人のショットで崩れることがよくあります。
- 崩れたのはプロンプトのせいとは限らない。画像がぼやけたり、キャラクターが途中で溶けたりするのは、設定表やロケーション背景図自体が弱い可能性もあります。まず言葉を修正します。同じ場所がまた崩れたら、アセットを作り直します。
プロンプトは15のブロックに分かれ、しかも「〜しない」と書いてはいけない
本格的なカットはすべて、同じ順序で15のブロックを書きます。順序は変えられません。
SCENE CONTEXT · ACTIVE REFERENCES · LOCATION MAP ·
FIRST FRAME AND SPATIAL BLOCKING · FORMAT MODE ·
OPTICS · CAMERA · ACTION TIMING · PHYSICS · LIGHTING ·
AUDIO · CHARACTER ACTING · STYLE · QUALITY ·
POSITIVE CONSTRAINTS
末尾のブロックは「ポジティブ制約」と呼ばれます。なぜなら、骨格全体に否定ブロックがないからです。禁止事項はすべて期待する結果として書かなければなりません。「仰向けに倒れないで」はモデルには「仰向けに倒れることを考えて」と読まれます。だから素直に「うつ伏せに倒れる」と書きます。
もう2つ、参照に関するルールは、何よりも生成を台無しにしやすいです:
- 各タグは一度だけ出現させる。そして「有効なアセット」のブロックにのみ置くことができます。プロンプトの最後にタグを繰り返すことは、生成が即座に拒否される最も一般的な理由です。
- ロケーションアセットには、構図を継承しないことを明示的に書く。それは幾何学、マテリアル、光、雰囲気のみを担当し、フレーミングは決して担当しません。この一文がないと、モデルはほぼ複製のような背景図を返してきます。
実際のプロンプトを見る。すぐに真似できる4つの書き方
公式は作中の廊下のシーンのプロンプトを解説に使用しました:Oli が画面外でドアを蹴り、Cal と Horace が画面内でそれを見ています。この1つには、特に取り上げる価値のある4つの仕掛けがあります。
見落とされがちな上限がもう1つ:1回の生成で最大9枚の画像、3本の動画、3つの音声参照を添付できます。この数字は、1つのカットに同時に登場できる名前付きキャラクターの数を直接決定します。
光学はミリメートルではなく度数で指定し、1秒の引きで空間を固定する
画面が横にどれだけの範囲を捉えられるかを、角度で表したもの。角度が大きいほど多く入り、広角に近づきます。角度が小さいほど画面は狭くなり、遠くのものが圧縮されて見え、望遠の雰囲気になります。
ドアの隙間から部屋を見るか、ドアを全開にするかの違い。隙間が狭いほど、見える範囲は小さくなります。
彼らはレンズをミリメートルではなく度数で書き、10段階のアンカーを使います。
180° · 135° · 107° · 84° · 63° · 47° · 29° · 18° · 12° · 8°
理屈は非常に明確に説明されています:モデルはあなたが書いた数字に従うのではなく、画面内のものからレンズを逆算します。だから135°のディテールは崩れ、8°の群衆は崩れます。さらに、レンズは各カットで個別に固定しなければならず、そうしないと快適な中央値に滑り戻っていきます。
1秒で空間を固定する
各シーンはマスターショットで始まります。立ち位置を固定した引きのショットで、約1秒、セリフもアクションもありません。モデルはこのレイアウトを「撮影」し、シーン内の後続のすべてのカットでそれを維持します。この1秒を削除すると、キャラクターは位置を変え始めます。
2つの小さなコツ:この1秒の間に誰かに短い音(「うん」など)を出させる。モデルがこの引きのショットを本格的なショットとして認識しやすくなります。このシーンが前のシーンへの応答である場合、前のセリフの末尾をこの最初の1秒にフィードします。俳優の口調と内容がつながり、2つのクリップが継ぎ目でくっつきます。
引きのショットの下には、空間マップも置きます。数行の平面図で、各シーンで一度書き、このシーンのすべてのカットに一字一句貼り付けます。これは初期の最も高価な問題を治しました:人物の瞬間移動、お互いの位置の入れ替わり、カメラが突然部屋の反対側にジャンプする。
書き方には直感に反する点があります:位置は見えるものに結び付け、距離に結び付けてはいけません。メートルはモデルにとって無意味です。「主人公の左」も同様に無意味です。なぜなら、モデルは主人公がどこにいるのかまったく知らないからです。
正しい書き方は、各人を画面内で見えるランドマークに固定することです:照明、2列目の椅子、ステージの端、ドア。そして「画面左/画面右」で方向を指定し、カメラがどちら側にあり、どのラインを絶対に越えないかを書きます。
空間マップはだいたい次のようなものです:まず「カメラは常に窓側、この軸線は越えない」と決め、次にステージが画面奥の右側にあり、赤い安全ドアがステージに隣接し、椅子の列が中央を埋めてステージの方を向いている、と説明します。そして、各人を見えるものに固定します。誰々は2列目の椅子のそば、通路から腕1本分。誰々はステージの端、安全ドアから大股1歩分。誰々はミキサーのそば。最後に「場内はちょうど3人だけ、他はすべて空」と補足します。
もう1つの経験則:生成結果と実際のロケーションが矛盾したら、プロンプトではなくアセットを読み返してください。彼らにはフットサル場のシーンがあり、何度も攻める方向を間違えました。プロンプトを書いた人が記憶で書いたからです。
そしてルールは「法律」になるには、廃ショットを判定できなければならない
前述のように、プロンプトライブラリには約150件のネームドロックがあります。ルールが「法律」と呼ばれるには、3つを同時に備える必要があります:名前がある、画面内で目に見える証拠がある、何が廃ショットかを一言で説明できる。彼らのロックのうち、約80件は「= 廃ショット」で終わります。最もよく使われる4つ:
カットを救った具体的な方法
- 複雑なアクションは絶対にタイムラインの途中に置かない。あのドアがどうしても蹴り開けられず、生成結果は主人公がドアのそばでぐずぐずして硬直する、というものでした。アクションを冒頭に置くように変更:「彼はすでに蹴りの途中で、ドアはすでにひび割れている」とし、助走の部分は別のカットにします。
- 群衆は1つのアセットとして扱う。身長と服装の範囲を与え、さらにクローズアップ用に先頭の数人に個別のアセットを割り当てます。15人を超えると、群衆は3〜5人に崩れます。だから混雑した部屋は「体がステージの端に押し寄せ、腕が前景にある」と書き、具体的な人数は絶対に書きません。
- 車内装は独立したアセットです。車自体、ロケーションとも分離されており、プロジェクト全体で最も再利用可能なものの1つです。
- モデルが頼んでもいないものを繰り返し描くなら、名前を挙げて禁止します。彼らの鉄道の背景図は、いつも勝手に駅になってしまいました。そこでロックを1つ書き、ホーム、雨よけ、一列のフラッドライト、停車中の列車を項目ごとに「存在しない」と列挙し、正確な線路数を補足したところ、治りました。
演技は形容詞ではなく、筋肉が何をしているかを書く
「悲しみ」「怒り」「衝撃」と書くと、モデルは即興でやり、表面的なものが返ってきます。深いものを得るには、筋肉が何をしているかを書く必要があります:震え、顎を噛みしめては緩める、頬骨が張る、鼻から小さく息を吐く。筋肉の上に、さらに言葉にされない内心のモノローグとしての注釈を1文加えると、モデルはこの文から微表情を逆算し、顔がセリフの合間に生き生きとしてきます。
その内心のモノローグはどんなものでしょう?例えば同じカットで、あるキャラクターには「この部屋はかつて私のすべてだった」と注釈し、別のキャラクターには「これが自分にとって大切なことだと、彼らに悟られないように」と注釈します。「ノスタルジー」「嫉妬」「悲しみ」といった言葉はプロンプトに一切現れませんが、モデルはこの2つの文から逆算し、一人はステージを見たときに足を止め、手の小さな動きが途中で止まる。もう一人はまず場内を見渡す態度を見せるが、視線はステージで半秒長く止まる。
さらに上の段階は行動で感情を置き換えることです:生き生きとしたシーンは「キャラクターが何かを欲し、障害があり、それを取りに行く」ものです。そして、彼を1つのシーンで戦略を変えさせます。冗談を言い、失敗する。圧力をかけ、また失敗する。最後に懇願する。毎回の変化は目に見える出来事でなければなりません:間、姿勢の変化、テンポの変化。最初から最後まで1つのことだけをするシーンは、必ず平坦です。
声も同じやり方で、しかも声はアセットではありません。それはセリフを書く前に確定させる条件のセットです:音域、音色、話す速度、アクセント、口調。あるキャラクターのサウンドブロックはだいたい「25歳の英国人男性、リラックスしたミドルテナー、リハーサルしていないような気軽な口調、南ロンドンのストリートアクセント、h音を落とし、t音を喉頭音化し、-ing を -in' と発音し、少しノスタルジックな温かみがある」といった具合です。
この文はその後、同義語にさえ変えずに、すべてのプロンプトのオーディオセクションに一字一句貼り付けます。言い換えれば、モデルのサンプリング範囲を広げることになり、声が漂ってしまいます。彼らは全編で声のクローンを作成せず、再録音もしていません。
もう2つ、小さな動作ですが効果的な手法があります。1つはまばたきを段階的に書くこと:ゆったりとしたまばたき、続いて素早い2回まばたき、最後に力を込めたリセットまばたき。「彼はまばたきした」とだけ書くより、ずっと生き生きとします。もう1つは静的なカットでは、1〜2秒ごとに目に見えるマイクロイベントが1つは必要なことです。「誰も動かない」と書くと、画面自体が凍り付くからです。静止は「張り詰めた緊張」と書き、「動作がない」とは書きません。
すべてのキャラクターには、eye-life というデフォルト設定があります:微細な眼球運動、名前を指定された注視ターゲット、現実的なまばたきの頻度、生き生きとした目の輝き。抑制的なキャラクターはまばたきが少なく遅い。それは選択としての静止であり、凝視ではありません。

彼らはカットが生きているかどうかを判断する3つのサインを挙げており、どれもその場で確認できます:
- 反応が相手の話が終わる前に始まる。聞いている側は途中で理解し、顔がすでに答えています。重要な出来事の後は、話し出す前に0.数秒の消化時間を与えます。
- 感情は瞬間的にオフにならない。重要なシーンの後、呼吸が乱れ、手が震える。この尾を次のクリップに持ち越すことで、ちょうど2つの編集ポイントを縫い合わせられます。
- 手は常に忙しい。キャラクターは「おしゃべり」しているのではありません。物を修理し、お金を数え、水を注ぎ、椅子を直し、それをやりながら話します。そして、シーンの最も強いアクセントは、この手が今聞いた言葉のために止まる瞬間です。
ラップパートの解決策は、生成される音声をオフにすること
まず問題を明確にします:動画モデルはあなたの歌を演奏できません。ラップさせると、口が空中に向かって動くだけ。音楽を生成させると、拒否されるか、編集でまったく使えないものが返ってきます。
だから音楽は一歩もモデルを経由しません。全体の流れは5つのステップ:
成功を左右する詳細がいくつかあります。歌は録音・ミックスが完了した完成品でなければなりません。完全なパート、生の声、最終ミックス。口を特定の波形にロックするからです。仮のデモではダメです。分割はボーカルの息継ぎの位置に合わせ、単語の途中で切ってはいけません。そうすれば、ブロック間を編集で合わせられます。
最も重要なのは4番目のステップです。設定で生成されるオーディオをオフにします:ボーカルはリップシンクを駆動し続けます。なぜなら、口の形は元々波形から作られているからです。しかし、返ってくるクリップは無音です。
クリップが無音だと、著作権検出が捉えるものがなく、このクリップをブロックしません。音楽は編集で無音の映像の下に重ねます。もともとそうあるべき場所です。
誠実にワークフローを説明:「これはオーディオガイドです。同期のためだけに使います」。どの文も真実ですが、モデルはまったく受け入れません。
1つのことだけを伝えます:これがその曲で、彼はそれを歌っている。プロセスは説明せず、「参照」とも言いません。モデルはワークフローに興味がなく、メタ記述は混乱させるだけです。
プロンプトには「口の帰属」も追加で明記します:聞こえるすべての単語は歌っている人に属する。他の人の口は生きていて、大笑いし、歓声を上げ、声を出さずに叫ぶ。しかし、決して歌詞に合わせてリップシンクしません。

編集は生成と並行して進め、ポストには専任者を置く
編集は生成が終わるのを待たず、並行して進めました:カットが届き次第つなぎ、足りないものは直接注文します。「ここに手のクローズアップが欲しい」「これはもう少し広く」。リテイクは数分で済むので、編集は生産を形作っているのであって、待っているのではありません。
テンポに関する2つの経験則:生成されるものはほぼ常にテンポが遅めなので、感覚よりも大胆に切ります。また、各クリップの先頭と末尾の0.5秒は切り落とす計画を立てます。端はどうしても漂うからです。
編集が確定した後、別途磨き上げの工程があります。一部のカットはフレーム単位での修正が必要です。看板の文字、ナンバープレート、大画面でしか気づかない小さな欠陥。本当に壊れているカットは修正せず、再生成します:保存された最終プロンプトから1行だけ変更します。これは、プロンプトライブラリが完全で、バージョン履歴がある場合にのみ可能です。優先順位の第1位は顔と手のクローズアップで、すべてグレーディングの前に行います。
見直し・監視は独立した仕事であり、期待ではありません。専任者がつなぎ終わった映像を監視し、「技術的には存在するが、成立していない」カットを探します。ワンテンポ遅れた視線、ぎこちなく読める手、3秒目から漂い始める顔。そして、名前を指定した修正方法を持って差し戻します。
理由は:スクリーンに漏れたゴミカットの代償は名声です。組み立て段階で見つかれば、代償はプロンプト1行です。
グレーディングの最初のステップは統一です:毎回の生成には独自のルックが付属します。カラーグレーダーはまず隣接するカットを同じルックに揃える必要があります。そしてルック自体は前もってロケーションアセットに焼き込まれているので、グレーディングは微調整であり、発明ではありません。
セリフは1つも再録音されておらず、ボーカルは生成結果から直接クリーンアップし、ノイズを減らし、クリップ間の音色を平らにし、音を空間に配置しました。個々のクリップで使えるボーカルがどうしてもない場合にのみ、スタジオで追加録音しました。
最後に:サウンドデザインと音楽は連続した環境音の上に構築されます。共有されたアンビエンスの層が、個々に生成されたカットを1つの空間に接着します。たとえ映像自体が漂っていてもです。
それゆえに、すべてのプロンプトに1文必ず書き込む必要があります:効果音のみ、BGMなし。
そして俳優の権利処理は、最初の生成よりも前に行う
作中の4人のキャラクターは実在の人物の肖像を使用しています:Cal はバスケットボール選手の Matt Kiatipis、Oli はUFCファイターの Israel Adesanya、Horace はストリーマーの N3on、Tobin はMMAファイターの Quinton「Rampage」Jackson。
重要なのは順序です。キャラクター設定表は契約撮影で作成されたため、表の顔は俳優本人の顔であり、「似ているタイプの人を探す」ものではありません。以降、カットに入るのはこの表だけです。
肖像権と音声権は、最初の生成の前に契約で閉じられています。プラットフォームは権利確認を要求し、権利ファイルは俳優が1フレームでも登場する前にコンプライアンスを通過します。

では、公開されているものは具体的に何か、どこで手に入るのか
「オープンソース」という言葉は、ここではコードを指しているのではなく、この映画を作るための一式の素材を指しています。実際にクリックしてダウンロードできるのは、Claudeスキルファイル3点です。使用する際はこの順序で:
さらに、あのキャンバスも直接開けます。承認済みの600点のアセットが区分ごとにまとめて置かれています:キャラクター設定表とその様々な状態、時間帯ごとのロケーション背景図、小道具と車両。横にはチームの注釈や、採用されなかったバージョンも残っています。これは幕ごとにフォルダ分けされており、一幕、二幕、三幕、エピローグがあり、それぞれシーンごとに分かれています(一幕だけで36のシーンフォルダ)。さらに PRE PROD には前段階のアセット、衣装、キャラクターテストが入っており、再生成されたカット専用のフォルダもあります。
注意すべき落差が1つあります:プロジェクトページの「添付ファイルリスト」は、実際にダウンロードできるものより多く書かれています。視覚・配色バイブル、5つの世界のスタイルプレフィックス、10段階の視野角の光学リファレンス、アクセント付きのサウンドシステム、リップシンクロック付きの音楽シーンプロンプト。これらは独立したファイルにはなっておらず、内容はプロジェクトページ本文に書かれています。また、「各カットの完全なプロンプト原文とバージョン履歴」もパッケージ化されたダウンロードではなく、キャンバスの幕別フォルダに分散しており、シーンごとに1つずつ確認する必要があります。
始める際のアドバイスは、まず CINEDANCE スキルを取り、次にキャンバスを開くこと。そして、1つのシーンから始めます:ロックされたキャラクター、ロケーション背景図、プロンプトの骨格。
結果は5つの法則と、「一人でも回せる」という言葉に収束する
マニュアル全体は5つの法則に収束します:
ここにあるすべてのルールは、かつてあるカットがあり、それがなければ失敗したから存在します。
Cully Hill Boys プロジェクトブリーフ
最後に彼らは1つの判断を示しました:このパイプラインは大規模なチームを必要とせず、1人にまで縮小できます。
同じマニュアルの中に、編集者、カラーグレーダー、組み立て後の映像を監視する専任者、そしてあの格闘シーンを振り付けたスタントマンが登場します。両方がここに提示されており、どう解釈するかは読者の判断です。
コストと期間は明確です:200万ドル、4週間で完了。しかし、この資金がどう使われたか、何人参加したか、合計で何回生成を実行したかは、マニュアルには内訳がありません。全編の効果も制作元の自己申告のみで、第三者の検証はありません。
AIで110分の長編映画が完成。制作元が「どうすれば撮影現場感を出せるか」の全マニュアルを公開
『The Cully Hill Boys』の全手法を公開、Claudeスキル3点を配布
↓ 一枚で読了・動く図あり
全編AI生成の長編映画、制作マニュアルも同時公開
Higgsfield Studio が『The Cully Hill Boys』を制作。1時間54分のアクションコメディです。ロンドンの売れないラッパー3人が麻薬抗争に巻き込まれ、8月5日にNYで初映。4人の実在俳優が肖像と声の使用を許可し、映像はすべてAI生成。セットも撮影クルーもありません。
公開されたのは作品だけではありません。完全な制作マニュアルも公開されました。アセットの作り方、プロンプトの書き方、演技とリップシンクの調整方法に加え、自社用のClaudeスキルファイル3点もダウンロードできます。
このマニュアルがこれほど分厚いのは、たった1つの出発点があるからです:動画モデルには記憶がない。キャラクターの説明が不完全だと、次のカットで見た目も行動も声も変わります。空間はカメラが動くと崩れ、音声はクリップ間で漂います。全手法は、この1つの問題に対処するためのものです。
上記の数字はすべて Higgsfield Studio 自身のプロジェクト説明によるもので、第三者の検証はありません。
1カット = アセットが映像 + テキストがそれ以外のすべて
彼らの基本方針は一言です:各カットは参照とテキストから生成される。アセットはこの人の見た目を担当し、テキストはそれ以外のすべてを担当します。誰がどこに立つか、カメラはどちら側か、光の当て方。こうした幾何学的関係はすべてテキストで明確に書かなければならず、モデルは自分で推論できません。
だから最初の法則が最優先されます:アセットがロック、命名、バージョン管理され、ストレステストを通過するまで、1カットも撮ってはいけません。ストレステストとは、アセットで10回動画生成を実行し、動作、画角、ロケーションを変えて、10回すべて同じ人物と認識できるか確認することです。
- 全身ショットから頭を消す。ワイドショットの顔は小さく柔らかく、モデルはその顔を遠景にコピーします。消せば、顔はクローズアップという1つの情報源だけになり、安定します。
- クローズアップは2バージョン、笑っているものと笑っていないもの。そうしないと、初めて笑った時、モデルが歯と顎を捏造し、笑顔が他人の口になります。
- 「studio」と書かない。モデルが実際にスタジオと照明スタンドを描き込み、キーライトを以降のすべての生成に焼き付けます。「スタジオなし、機材なし、壁なし」と書き換えます。
- 逆光は禁止、手には何も持たせない。小道具が設定表に組み込まれると、永遠に取り外せず、捨てられません。
プロンプトは15ブロック、否定文禁止。レンズは度数で固定
15ブロックの骨格は順序を変えられません。このシーンで何が起きているかから始まり、画質、ポジティブ制約まで続きます。骨格には否定ブロックがありません:禁止事項はすべて期待する結果として書きます。「仰向けに倒れないで」はモデルには「仰向けに倒れることを考えて」と読まれます。だから素直に「うつ伏せに倒れる」と書きます。
空間も同様です:各シーンは1秒の固定された引きのショットで始まります。モデルがレイアウトを記憶し、後続のカットで位置が保たれます。引きのショットの下には数行の空間マップを置きます。位置は照明、椅子など、見えるランドマークに固定し、距離には固定しません。「メートル」も「主人公の左」もモデルにとって無意味だからです。
ラップパートの解法:生成される音声をオフにする
動画モデルは実際の曲を演奏できません。ラップさせると、口が空中に向かって動くだけ。音楽を生成させると、拒否されるか、編集でまったく使えないものが返ってきます。だから音楽は一歩もモデルを経由しません。
手に入るのは手法一式。チーム規模とコストは完全には開示されず
マニュアルは5つの法則に収束します:アセット最優先、毎回完全に記述、一度に1つだけ変更、モデルに与える自由を減らす。そして、同じカットを10回20回直しても成立しなければ、問題はカット自体にあることが多い。分割し、アクションを減らし、アングルを変える。
4人のキャラクターには実在の人物の肖像と声が使われています:Matt Kiatipis、Israel Adesanya、N3on、Quinton Jackson。権利処理は最初の生成の前に契約で閉じられました。
小互、ニュースを見つける
110分、オールAI生成
8月5日NY初映、セットも撮影クルーもなし
実在の俳優は
肖像と声のみ
公開されたのは
失敗のマニュアル一式
小互、マニュアルを開く
このカットで1行書き漏らすと
次のカットで別人になる
アセットが映像
テキストがそれ以外のすべて
小互、設定表を描く
顔が小さいとモデルが
遠景にコピーする。描き込むほど崩れる
ドン
設定表に「studio」も書かない。照明スタンドが全カットに焼き付く
ラップのシーンが最難関
生成時
音声をオフに
口の動きは問題なく同期。形は元から実声の波形で作られている
小互、マニュアルを閉じる
すべてのルールの背後に
失敗したカットがある
同じマニュアルには、編集者、カラーグレーダー、映像監視者も登場する
効果とコストはすべて Higgsfield Studio の自己申告。第三者の検証はありません
終
小互解説サイト・best.xiaohu.ai