Databricksが公開したAIコーディング費用削減術:モデル選定でコスト半減も
- AIによるコーディングは確かに効果があり、チームによっては生産性が10倍になった例も。しかしトークン請求額も指数関数的に膨らみ、大規模に導入したほぼ全ての企業がこの壁にぶつかっています。
- 4つの施策の中で最も効果が大きいのはモデル選定の見直し。Stripeは実測の結果、新しいOpusが性能向上なしに価格だけ高いと判断し、社内導入を拒否しました。
- 一番意外なのはこの点:ハードな利用枠を日常的なツールとして使っている企業は1社もなく、遮断は最終手段として残していること。その理由は、以下に挙げる2つの現実的な理由からです。
効率は伸びても、請求額はもっと伸びる
Databricksが最近公開したコスト管理の振り返りは非常に実践的です。AIによるコーディングについて、社内で追跡しているすべてのスピード指標で改善が見られ、チームによっては生産性が10倍になりました。しかし、請求額も指数関数的に増え続けています。
このまま放置すれば、いつかは会社の売上高を超えるでしょう。企業は板挟みになっています。できるだけAI活用を推進し、最高のツールを全従業員に届けたい。一方で、AIによる効率向上の利益を食いつぶし、場合によっては打ち消してしまう総コストにも直面しているのです。
幸い、いち早く大規模展開した企業たちは、両方を同時に達成する方法を編み出しました。従業員全員がほぼ抵抗なくAIツールを使えるようにしつつ、一人当たりのコストをほぼ一定の範囲に抑えるという方法です。この手法の材料は、Databricks自身の実践と、Stripe、Coinbase、Uber、Ramp各社との意見交換に基づいています。
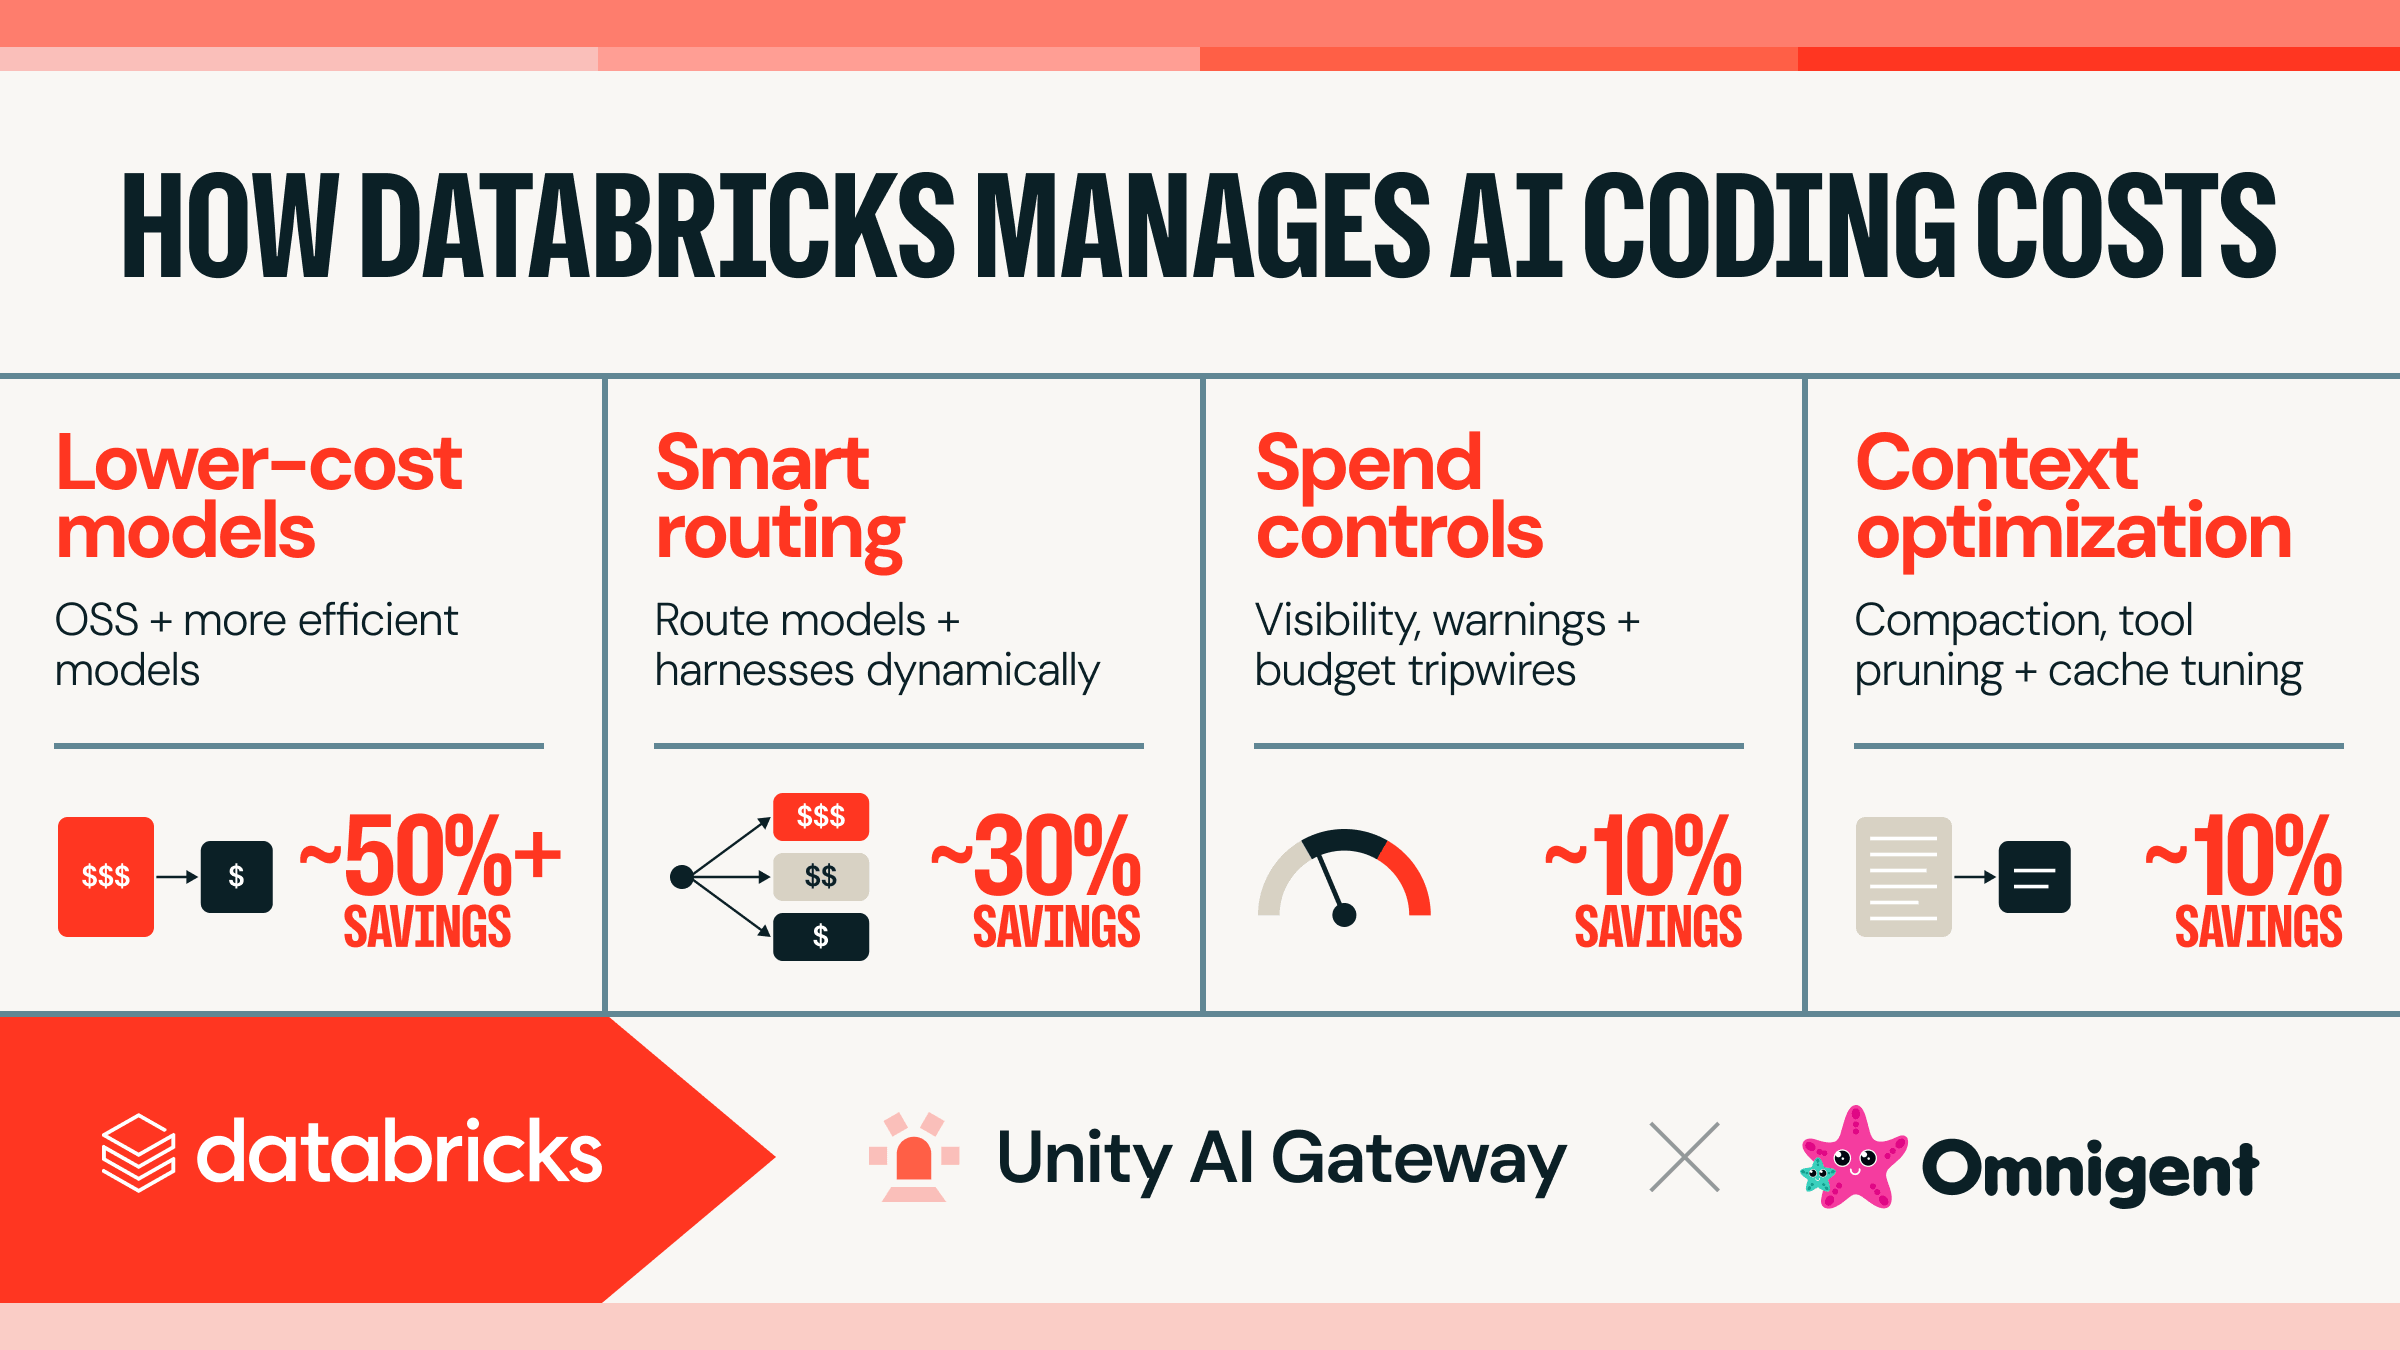
4つの施策と、それぞれの削減効果は次の通りです。

| 手法 | 具体的な内容 | 削減効果 |
|---|---|---|
| より低コストなモデルへの変更 | オープンソースモデル+より高効率な新モデル | 50%+ |
| Smart Routing | モデルとツールを動的に割り当て | ~30% |
| 支出管理 | 費用の見える化、超過警告、予算の段階的制御 | ~10% |
| コンテキスト最適化 | 圧縮、ツールの冗長性排除、キャッシュ調整 | ~10% |
既製のソフトウェアで導入できる施策もあれば、インフラの変更が必要な施策もあります。特に、開発者のローカルツールを変更したり、複数のモデル間でトラフィックを切り替えたりする必要がある施策です。Databricksは自社のシステムを構成する2つの重要コンポーネント、開発者向けの統合エントリポイント「Omnigent」と、トラフィック管理を行う「Unity AI Gateway」を公開しており、前者はオープンソース、後者は無料で利用できます。
日常のコーディングに最強モデルは不要
よく言われる「フロンティアモデル」とは、最も賢いモデルを指します。各研究所が競っているのも知能の上限であり、現在の最先端モデルは数学の難問を解いたり、新たなセキュリティ問題を発見したりできるまでになっています。
しかし、AIを全社の数千人の開発者に展開するとなると、もう一つのフロンティアが重要になります。それが効率フロンティアです。これは同じ知能水準であれば、最も価格が安いモデル群を指します。
数学の難問を解くにはアインシュタインを呼ぶ必要があるかもしれません。しかし、コンポーネント名をXからYに変更したり、繰り返しの定型コードを補完したりするのにアインシュタインを呼ぶのは、純粋なお金の無駄です。日常のコーディング作業の大部分は後者に該当し、モデルがエンジニアリング品質の合格ラインを超えていれば十分で、知能の上限が高くてもその恩恵は受けられません。
したがって、会社の請求額を本当に左右するのは、「ちょうど良い」モデルの価格です。そして、この効率フロンティアは、知能フロンティアよりもはるかに速いペースで進歩しています。ほぼ毎週新しいモデルが発表され、同じ1ドルで買える知能は前世代よりも増えています。
モデル変更が最も効果的、ただし公開ベンチマークは当てにできない
4つの施策の中で最も効果が大きいのはこれです:新しく、より高効率なモデルに迅速に移行することが、他のどの施策よりも大きな削減につながります。しかし、このメリットを享受するには、どの新モデルが本当に現在のモデルより優れているのかを企業が把握している必要があります。
これは想像以上に難しい問題です。公開ベンチマークのスコアと実際のコーディングタスクのパフォーマンスは一致せず、スコアが高くても自社のコードベースで良い結果が出るとは限りません。そこで、多くの企業が自社で自動評価システムを構築し、実際の内部開発により近い構成の問題でテストしています。Databricksも自社の数百万行のコードベースでこのベンチマークを構築・実施したところ、GLMシリーズが特にコストパフォーマンスに優れていることが判明し、社内の開発者にGLMを推奨しました。
評価でネガティブな結果が出ることもよくあります。例えば、次のようなケースです。
Stripeはテストの結果、Opus 4.7は4.6と比較して実質的な品質向上が見られず、コストは高いと判断し、社内での提供を見送りました。DatabricksもOpus 5.0と4.8を比較し、同様にコスト増を確認しています。
大手企業が「この新モデルは試したが、従業員には使わせないことにした」と公言することはまれです。ベンダーは自社がリジェクトした新バージョンについて公に語ることはほとんどありません。新しいバージョン=コストパフォーマンスが良い、とは限らないため、自社で検証する必要があります。
Databricksは、2026年8月6日時点での試算をグラフにまとめました。横軸はタスクあたりの平均コスト、縦軸は平均合格率です。赤い線で結ばれた点が効率フロンティアであり、同じ合格率であればこれより安いものはありません。

最終的な推奨リストは3つのみです:GLM 5.2、Opus 4.8、GPT-5.6 Sol。いずれも現時点で最も強力なモデルではありません。効率フロンティアが求めるのは、決して「最も賢い」モデルではないのです。
モデルを自由に変えるには、まずツールからの解放を
理屈が通じても、実際に変更しようとすると、モデルよりもツールが壁になることが多いです。
開発者が日々実際に操作しているもの、Claude Code、Codex、Cursorなどは、業界用語で「harness」と呼ばれます。モデルが思考を担当し、harnessがモデルにコードの読み取り、ファイルの変更、コマンド実行を可能にします。
モデルはエンジン、harnessは車全体です。ハンドル、トランスミッション、ダッシュボードはすべて車に付いています。現在の問題は、クローズドなフロンティアモデルが特定のharnessとセットで設計される傾向が強まっていることです。特定の車には特定のエンジンが合う、という状態です。エンジンだけ交換して車を変えない、というのが難しくなってきています。
あるツールに慣れてしまうと、それは知らぬ間に特定ベンダーのモデルに縛られることを意味します。切り替えコストが一定以上になると、そのツール自体が事実上のロックインとなり、企業はより安いモデルにコストを移したくても移せなくなります。打開策は2つです。
1つ目は、開発者自身がツールを切り替えられるようにすること。企業は複数のharnessを同時に提供し、移行コストが発生する場合は、別のツールの使用を促します。利点は、開発者が普段使い慣れたツールを使えること。欠点は、個人にとっての切り替えコストが現実的に存在し、慣れたユーザーは違和感を覚えることです。
2つ目は、その上に統合ダッシュボード層(業界用語でmeta-harness)を追加すること。開発者が見るインターフェースは常に同じで、背後でどのharness、どのモデルを呼び出すかをこの層が振り分けます。クローズド系・オープンソース系の両方を接続できます。これにより、モデルとツールの独立性を保ちつつ、ユーザーに新しいインターフェースへの再適応を強いることがありません。Databricks内部ではこの方法を採用しており、デフォルトのエントリポイントは自社オープンソースのOmnigentです。また、同社が接触した一部の企業は、自社の開発ツールチェーンに統合した内部バージョンを独自に構築しています。

難しいタスクは高価なモデルへ、単純なタスクは安価なモデルへ
上記の2つの施策は、人が主体的に切り替えることを前提としています。では、システムがタスクの難易度に応じて自動的に振り分けることはできないでしょうか。これが第2の施策、ルーティングです。
宅配便の仕分けのようなものです。荷物が届いたらまず仕分け台を通し、市内の小包は安いラインへ、国際的な大きな荷物は高いラインへ送ります。違いは、ここで仕分けられるのがAIに依頼するタスクだということです。
原文ではルーティングを3つのタイプに分類しています。粒度の細かい順に紹介します。
1. リクエスト単位での振り分け
ツールと基盤モデルの間にステートフルなプロキシを挟み、リクエストごとに判断します:このリクエストに最も安く答えられるモデルはどれか、それを特定して送信します。ここで注意すべき点があります。サーバーサイドのキャッシュを考慮する必要があるということです。コンテキストが大きい場合、キャッシュミスが発生するとコストが非常に高くなるため、単価が安いという理由だけで切り替えるのは危険です。既存製品も多数あります:Cursor Router、OpenRouterのAutoRouter、RampのRouter、DatabricksのUnity AI Gatewayに含まれるSmart Routingなどがあります。
2. タスク単位での振り分け
粒度を一段階上げます:ローカル環境で、タスク全体を一つの注文として送信します。「このコンポーネントをXからYに改名する」は簡単なタスク、「レイテンシを下げる設計案を探る」は複雑なタスクと判断し、判断が完了したら、そのタスク全体を最初から最後まで対応するレベルのモデルに委ねます。これを実行するのが前節で述べた統合ダッシュボードであり、Omnigentがこのモードをサポートしています。
3. 高価・安価モデルのペア運用
同じツール内に2つのモデルを設定します。1つは高価で高知能なモデル、もう1つは安価な作業用モデルです。両方向のアプローチがあります:
- 安価なモデルが主導し、難しい問題に直面したら高価なモデルに相談する。例えばClaudeのAdvisorツールは、安価なモデルが全体を進行し、より強力な処理が必要なタスクに遭遇した場合のみ、上位モデルに問い合わせます。
- 高価なモデルが主導し、単純作業を安価なモデルに外注する。例えばCognitionのDevin Fusionは、高コストモデルがメインループを実行し、一部の作業を安価なモデルに委ねます。
効果については、Databricksの社内結果によると、Smart Routerにより平均タスクコストを安定して30%以上削減し、品質はワークセット内で最も高価なモデルにほぼ匹敵するとのことです。同社が接触した他の企業でも同様の結果が得られています。

ハードな制限は設けず、段階的に摩擦を加える
モデル層での削減が一通り完了したら、次は人への対策です。ここでよく考えられる答えが、全員に月次利用枠を設定し、使い切ったら停止する、という方法です。
原文では、これが答えではない理由を明確に説明しています。すべての取材対象企業が、ハードな利用枠を最終手段としてのみ使い、日常的なツールとしては使っていません。その理由は2つとも非常に現実的です:
- 上限に達したら遮断、というのは、生産性を止めることと同じ。開発者が作業の途中で突然AIが使えなくなるのは、会社と従業員のどちらも望みません。
- 最も多く使っている人の中には、最も生産性の高い人が含まれている。彼らはAIを活用して驚異的な効率を生み出している層であり、彼らを止めることは自滅行為です。
代わりに採用されているのは、段階的なアプローチです:まず自分の支出を可視化し、支出が増えるにつれて段階的に摩擦を加えるという方法です。
第1段階:支出を可視化する。取材したすべての企業が、ほぼリアルタイムの支出フィードバックを提供しています。多くの場合、より安いモデルに切り替えた場合の節約額を提案するアドバイスも付け加えています。重要なのは、このデータがツールを横断して集計・表示され、開発者がどのツールに使うお金が最も価値が高いかを判断できるようにすることです。Databricks内部の開発者ダッシュボードは次のような外観です:

第2段階:消費ゲートを追加する。支出が一定の閾値に達すると、何らかのアクションを求めるポップアップが表示されます。最も軽いものは、クリックすれば続行できるもので、単に利用速度が上がっていることを知らせるだけです。Databricksは、この自己解除型のゲートが無意識の支出を防ぐのに特に効果的であることを発見しました。さらに上のゲートは承認プロセスが必要で、通常は管理チェーンを通じて予算を承認してもらいます。
第3段階:ダウングレードしても停止しない。ゲートに達したユーザーはトークンを遮断されるのではなく、より安価なモデルに切り替えられます。最も安いモデル群とトップモデルの価格差は大きいため、ユーザーは作業を続けられる一方で、請求額はそれ以上は上がりません。
第4段階:ようやく停止。ほとんどのシステムには完全に遮断する機能が残されていますが、これは通常は一時的な措置であり、むしろ「AIをより効率的に使う方法」について話し合う会話の始まりであることが多いです。
請求額の大部分はAI自身が追加したコンテキスト
ここまでの3つの施策は「どのモデルを使うか」「誰が承認するか」を管理するものでした。最後の施策は、トークン自体を削減します。
プログラミングエージェントに「このバグを調べて修正して」と入力したとします。その後に起こることは、エージェントが関連するコンテキストを大量に収集し、多数のツールを呼び出し、コードベースを検索し、さらに会社が設定したスキルやシステム情報も加わります。実際に高コストな推論が始まる頃には、あなたが入力した文は、投入されたデータのごく一部に過ぎません。請求額の大部分は、あなたが明示しなかったコンテンツによって占められています。
この長いバーを短くする方法はまだ新しく、原文では現在試行中のいくつかの方向性が挙げられています:
- ツールが現在のコンテキストをより頻繁に圧縮するようにする。
- 「言葉の少ない」harnessに切り替えるか、現在のものをよりトークン効率が良くなるように調整する。
- よく使うツールを一つずつ監査し、戻り値の冗長な部分を削減する。
- 開発者にタスクをより小さな単位に分割するよう促し、一度に読む必要のある範囲を自然に減らす。
コンテキストが大きくなると、プロンプトキャッシングの影響も重要になります。クローズド・オープンソースモデルの両方が、キャッシュの有効/無効と保持時間の設定を提供しています:コンテンツをキャッシュに書き込むにはコストがかかりますが、キャッシュからの読み取りは大幅に安価です。このコストパフォーマンスが良いかどうかは、各社のワークスタイルによって異なるため、デフォルトのキャッシュ設定を手動で調整し、ヒット率を上げることは、総コストに大きな影響を与えます。
Databricksによると、彼らはharnessとキャッシュ設定を比較的シンプルに調整しただけで、生成トークン数とそれに対応するコストがほぼ半分に削減され、開発者側で品質の低下は観察されなかったとのことです。同社は、この領域にはまだ大きな最適化の余地があると考えています。

コスト削減策はすべてAI Gatewayで実現される
これまで見てきた4つの施策を振り返ると、それぞれが技術的な前提を暗に含んでいます。新しいモデルにいつでも切り替えられるようにするには、会社が「モデルメニュー」を一元的に管理する場所が必要であり、開発者が使うツールが混在をサポートしている必要があります。ツール横断の支出を可視化するには、一元化された台帳が必要です。コンテキストの膨張を抑えるには、よく使うツールが出力する内容を観察し、圧縮を強制できる必要があります。
これらのニーズは、新しい種類のインフラストラクチャソフトウェアによって満たされつつあります。そのソフトウェアは、AI Gatewayという名称で広く知られつつあります。これは会社のAIディスパッチセンターのようなもので、次の4つのことがここで行われます:
| 管理機能 | 具体的な意味 |
|---|---|
| アクセスとキャパシティ | 基盤モデルへのアクセスを一元プロキシ。クローズド・オープンソース両対応 |
| 予算と実行 | 会計処理と、段階的摩擦・自動ダウングレードなどの複雑なポリシー実行 |
| エンドポイント設定 | 開発者ツールにモデルホワイトリストや圧縮設定などのローカル適用パラメータを配布 |
| セッション記録 | コーディングセッションの軌跡を記録し、後の効率分析や評価に使用 |
Databricksは、これら4つの機能をすべてUnity AI Gatewayに集約し、開発者向けのOmnigentと合わせて、両コンポーネントをオープンソースまたは無料で公開しています。
AIコーディングコストの指数関数的な増加は宿命ではありません。これは解決可能なエンジニアリングとガバナンスの問題です。 — 原文の結論より
この曲線をうまく制御した企業は、同じアプローチを取っています:効率フロンティアを注視し、モデルの自由度を保てるツールを選び、タスクを最も安く実行できるモデルにルーティングし、可視性と段階的摩擦でハードな利用枠に代え、本当にコストがかかるコンテキストオーバーヘッドを削減します。これらの施策のどれも生産性を犠牲にするものではありません。そして生産性こそが、そもそもAIを導入した理由なのです。
コスパ最良のモデルへの乗り換えが、AIコーディング費用削減の最大テコ
DatabricksがStripe、Coinbase、Uber、Rampと共同で洗い出した4つのコスト削減策を、図解付きで一気に解説
↓ スクロールで読了 · 動く図あり
AIコーディングは確かに効果があり、Databricks社内では生産性が10倍になったチームもあります。しかしトークン請求額は指数関数的に増加し、放置すれば効率向上の利益を食いつぶします。かといって一方的に利用を止めれば、作業中の人を止めてしまいます。4つの施策の削減効果は、Databricksによると開発チームへの非公式調査に基づく方向性の推定値です:
各研究所が競うのは「最も賢いモデルはどこまで強くなるか」、つまり知能フロンティアです。数学の難問を解けるモデルはこの層です。しかし日常のコーディングは、バグ修正、リネーム、定型コードの補完が中心で、そんな頭脳は不要です。請求額を左右するのは「同じ性能で最安のモデルはどれか」という効率フロンティアであり、こちらは知能フロンティアよりはるかに速く、ほぼ毎週更新されます。
公開ベンチマークは実務のパフォーマンスを反映しません。各社は自社コードベースで評価を構築しています。コーディングツール(Claude Code、Codexなど)はモデルとセットで設計される傾向が強く、慣れたツールを使い続けると背後にあるモデルに知らず知らず縛られます。Databricksは統合エントリポイントを追加し、ツールごと交換する必要をなくしました。実際の判断事例:
Databricks自社検証
Stripe自社検証、社内導入を見送り
Databricks自社検証
現在の推奨リストは3つのみ:GLM 5.2、Opus 4.8、GPT-5.6 Sol。いずれも現時点で最も賢いモデルではありません。
簡単なタスクと複雑なタスクに同じ価格のモデルを使うのは勿体ない。ルーティングはこれを解決します:リクエスト単位で最安で回答できるモデルを選択、タスク単位で複雑度に応じて振り分け、または高価・安価のペアで、安価が主導して難問は高価に相談、もしくは高価が主導して単純作業を安価に外注。DatabricksのSmart Routerは、Opus 5単体と比較して35%以上安く、解決率も高いという結果です:
モデルとルーティング以外にも仕上げの2つの施策があります。1つはコンテキスト削減。あなたが入力した文は実際の推論時にはごく一部で、請求額の大部分はAI自身がコードを探したりツールを呼び出したりして作られた部分です。Databricksは圧縮とキャッシュ設定を調整しただけで、セッションあたりの生成トークンが1200万から550万に削減されました。もう1つは支出管理ですが、取材した企業のどこもハードな利用枠を日常的には使いません。遮断は作業中の人を止めてしまい、支出が多い層には生産性の高い人が多く含まれるからです。
上限到達で即遮断。作業が中断される。
支出の可視化 → 自己解除可能な通知 → 承認フロー → 上限到達時も遮断せず安価なモデルへ自動切替 → 停止は最終手段で通常は一時的。「AIをもっと効率的に使う方法」を話し合う会話の始まり。
これらの施策は最終的に同じインフラ層で実現されます。モデルメニューの一元管理、ツール横断の会計処理、開発者への設定配布、セッションログ保存。Databricksはこのシステム(Unity AI Gateway + Omnigent)をオープンソースまたは無料で公開しています。
- × Opus 4.7
向上なし コスト高 - × Opus 5.0
4.8よりコスト悪化
Opus 4.8
GPT-5.6 Sol
最も生産性が高い人