Appleチームが「蒸留スケーリング則」を発表:AIモデルの小型化はもはや運任せではない
この論文は、教師の質、生徒モデルの規模、学習データ、教師コストを同じ計算予算の枠組みで比較した。教師は強いほどよいとは限らず、蒸留が生徒モデルを実データで直接訓練するより常に省計算になるわけでもないことを示している。
- エビデンスの範囲:この公式は、教師と生徒が同じデータ分布に従い、生徒が教師のトークン単位の全出力確率分布を学ぶ、C4 English上のTransformer実験に基づく。推論トレース、異分布蒸留、下流の推論能力は対象外である。
Appleとオックスフォード大学のチームが、論文「Distillation Scaling Laws」を発表しました。この論文の核となるのは、大規模モデルの蒸留におけるスケーリング則の研究です。扱っているのは、「大規模モデルの能力を小規模モデルに教え込む際、計算資源を教師モデルの強化に使うべきか、生徒モデルの拡大に使うべきか、それとも生徒により多くのデータを学習させるべきか」という、きわめて実践的な問いです。
この論文が示す答えは、次の四つです。
- 教師を選ぶ際に重要なのは、パラメータ数ではなく、次のトークンを予測する精度です。パラメータ数が小さくても十分に学習された教師は、より大規模でありながら学習が不十分な教師と同等の効果を持つ可能性があります。
- 教師が強すぎるのも問題です。生徒のサイズと学習データを固定した場合、教師が強くなり続けると、かえって生徒の性能が低下することがあります。
- 蒸留の優位性は、主に生徒の学習データがまだ十分でない場合に現れます。生徒が十分なデータを学習した後は、実際のデータで直接学習する方が、蒸留に追いつくか、それを上回ります。
- 蒸留が計算資源の節約になるかどうかは、教師のコストを分散できるかどうかにかかっています。既存の教師がいる場合や、同じ教師が複数の生徒を教える場合は、蒸留の方が有利になる可能性が高くなります。一方、特定の生徒のためにだけ教師を訓練し、その生徒一人にだけ使うのであれば、実際のデータで生徒を直接訓練する方が通常は計算資源の節約になります。
Appleとオックスフォード大学のチームは、これらの関係を経験則に基づくひとつの法則にまとめました。教師が予測する際の平均的な誤り度合い(論文では「損失」と呼びます)、生徒のパラメータ数、そして生徒の学習トークン数を入力すると、生徒の最終的な損失を推定できます。論文でカバーされている実験範囲では、相対予測誤差は約1%です。
この公式により、チームは訓練を始める前に、「教師を変更する」「生徒を大きくする、または多くのデータを見せる」「直接教師あり学習を行う」という三つの選択肢を比較し、計算資源をどこに投入するかを決定できるようになりました。
蒸留が計算可能な予算問題になった
まず、この研究の規模をご覧ください。このAppleとオックスフォード大学のチームによる研究はICML 2025で発表され、実験では約1.43億から126億のパラメータ、最大5120億の学習トークンをカバーし、73の教師あり学習サンプルと697の蒸留サンプルを使って式をフィットさせました。
教師あり学習では、生徒は実際の次のトークンに基づいてパラメータを更新します。一方、蒸留では、生徒は教師が語彙全体に対して出力する確率分布を模倣します。実際の答えは生徒に「どのトークンが正しいか」だけを教えますが、教師の分布は「他の候補がそれぞれどの程度類似しているか」も教えます。この追加情報は、通常、ソフトラベルと呼ばれます。
これまでの蒸留実験では、一人の教師を固定して、複数の生徒を比較することがほとんどでした。これにより「この教師は生徒の役に立つか」という問いには答えられますが、「教師をどの程度訓練すべきか」「生徒はどの程度の規模が良いか」「同じ計算資源を生徒に直接使うべきではないか」といった問いには答えられません。この論文では、教師の規模、教師の学習トークン数、生徒の規模、生徒の学習トークン数を同時に変化させることで、初めて四つの変数をひとつの地図上に載せました。
4つの訓練変数を、最終的に3つの予測入力へ
この研究では、その実験範囲内において、教師の規模と教師の学習トークンが生徒に与える影響が、ひとつの変数に圧縮できることを明らかにしました。それは、教師自身の交差エントロピー損失です。交差エントロピーは、「モデルが正しい次のトークンにどれだけの確率を割り当てたか」と理解できます。一般的に、この値が低いほど優れています。これにより、生徒の損失を予測するために必要な入力は、教師の損失、生徒のパラメータ数、生徒が学習したトークン数の三つだけになりました。
この点は非常に重要です。開発チームは、教師のアーキテクチャごとに個別の経験則を考案する必要がなくなりました。教師が論文で扱われているのと同じ分布のトランスフォーマー設定内にあれば、その規模や学習量は、まず品質として一律に換算できます。ただし、「教師の損失だけを見る」というのは、これらの実験から得られた経験的な簡略化であり、すべてのアーキテクチャ、データ、蒸留方法に対する普遍的な証明ではありません。
この研究の全体像は、最終的に三つの検証可能な結論へと収束します。生徒の損失は、教師の損失、生徒の容量、そして生徒のトークン数によって決まること。生徒を固定した場合、教師が強すぎるとかえって性能が低下するという容量ギャップが存在すること。蒸留の教師あり学習に対する優位性は、生徒のデータ量の閾値と教師の再利用可能性によって制約を受けることです。後者の二つの結論は、生徒を固定した場合のU字型の曲線と、四つのコスト計算によって検証されています。
生徒の最終損失は、教師の質、生徒の容量、学習データによって決まる
この公式は、まず「モデルが大きくなり、データが増えるほど損失が低くなる」という教師あり学習のベースラインを適合させ、そこに教師の質と容量の転換点に関する項を追加します。すべての係数を覚える必要はありません。重要なのは、次の三つの方向性を理解することです。
- 生徒が大きくなると、表現できるパターンが増えるため、損失は通常低下します。
- 生徒がより多くのトークンを学習すると、教師をより完全に近似できるため、損失は通常低下します。
- 教師が弱い状態から強くなるにつれて、生徒は最初は恩恵を受けますが、教師が釣り合いの点を超えてさらに強くなると、生徒の性能は低下する可能性があります。
これらの方向性は、三段階の実験設計で切り分けられています。第一段階は教師あり学習のベースラインです。著者らは「モデルを固定してデータ量を変える」方法と、IsoFLOP法を同時に使用しています。IsoFLOPとは、同じFLOPsの下でモデルサイズとトークン数を一緒に変更する方法です。各予算における最適なモデルだけを見ると、トークンとパラメータの比率がほぼ固定されてしまい、モデルサイズの項とデータの項を分離することができません。
第二段階は学習目標です。教師あり学習では、one-hotラベル、つまり正しいトークンの位置が1で、それ以外の位置が0となるラベルを使用します。蒸留では、ソフトマックス関数を使って教師の生のスコアを、合計が1となる語彙全体の確率分布に変換し、生徒にこの分布を学習させます。固定された教師の場合、この交差エントロピーは順方向KLダイバージェンスと等価です。これは教師分布から生徒分布へのKLダイバージェンスを測るもので、教師のエントロピーが定数であるためです。
第三段階は蒸留実験です。教師を固定し、生徒を複数のIsoFLOP曲線に沿って変化させることで、生徒の規模とデータの項を特定します。また、生徒を固定し、教師を複数のIsoFLOP曲線に沿って変化させることで、教師の規模と教師のトークン数が教師の損失によって要約できるかを検証します。その後、固定されたトークン/パラメータ比を持つ教師と生徒を広く組み合わせることで、容量ギャップ全体を明らかにします。この三つのプロトコルが一緒になって公式を支えており、単一の曲線がすべての証明を担っているわけではありません。

論文の図5。上半分は予測値と実測値の比較、下半分は相対誤差を示しています。著者らは、主要なフィットの相対予測誤差が約1%以内であると報告しています。
この法則は、第一原理から導き出されたものではありません。これは、与えられた実験ドメイン内で非常に正確に適合する経験的な関数です。その価値は、「教師、生徒、データ」の間の関係を、これまで試行錯誤で探るしかなかったものを、適合、比較、予算最適化が可能な対象に変えた点にあります。これは、すべてのモデルに適用できる永久的な係数セットを提供するものではありません。
教師が強くなりすぎると、生徒の性能が低下する可能性がある
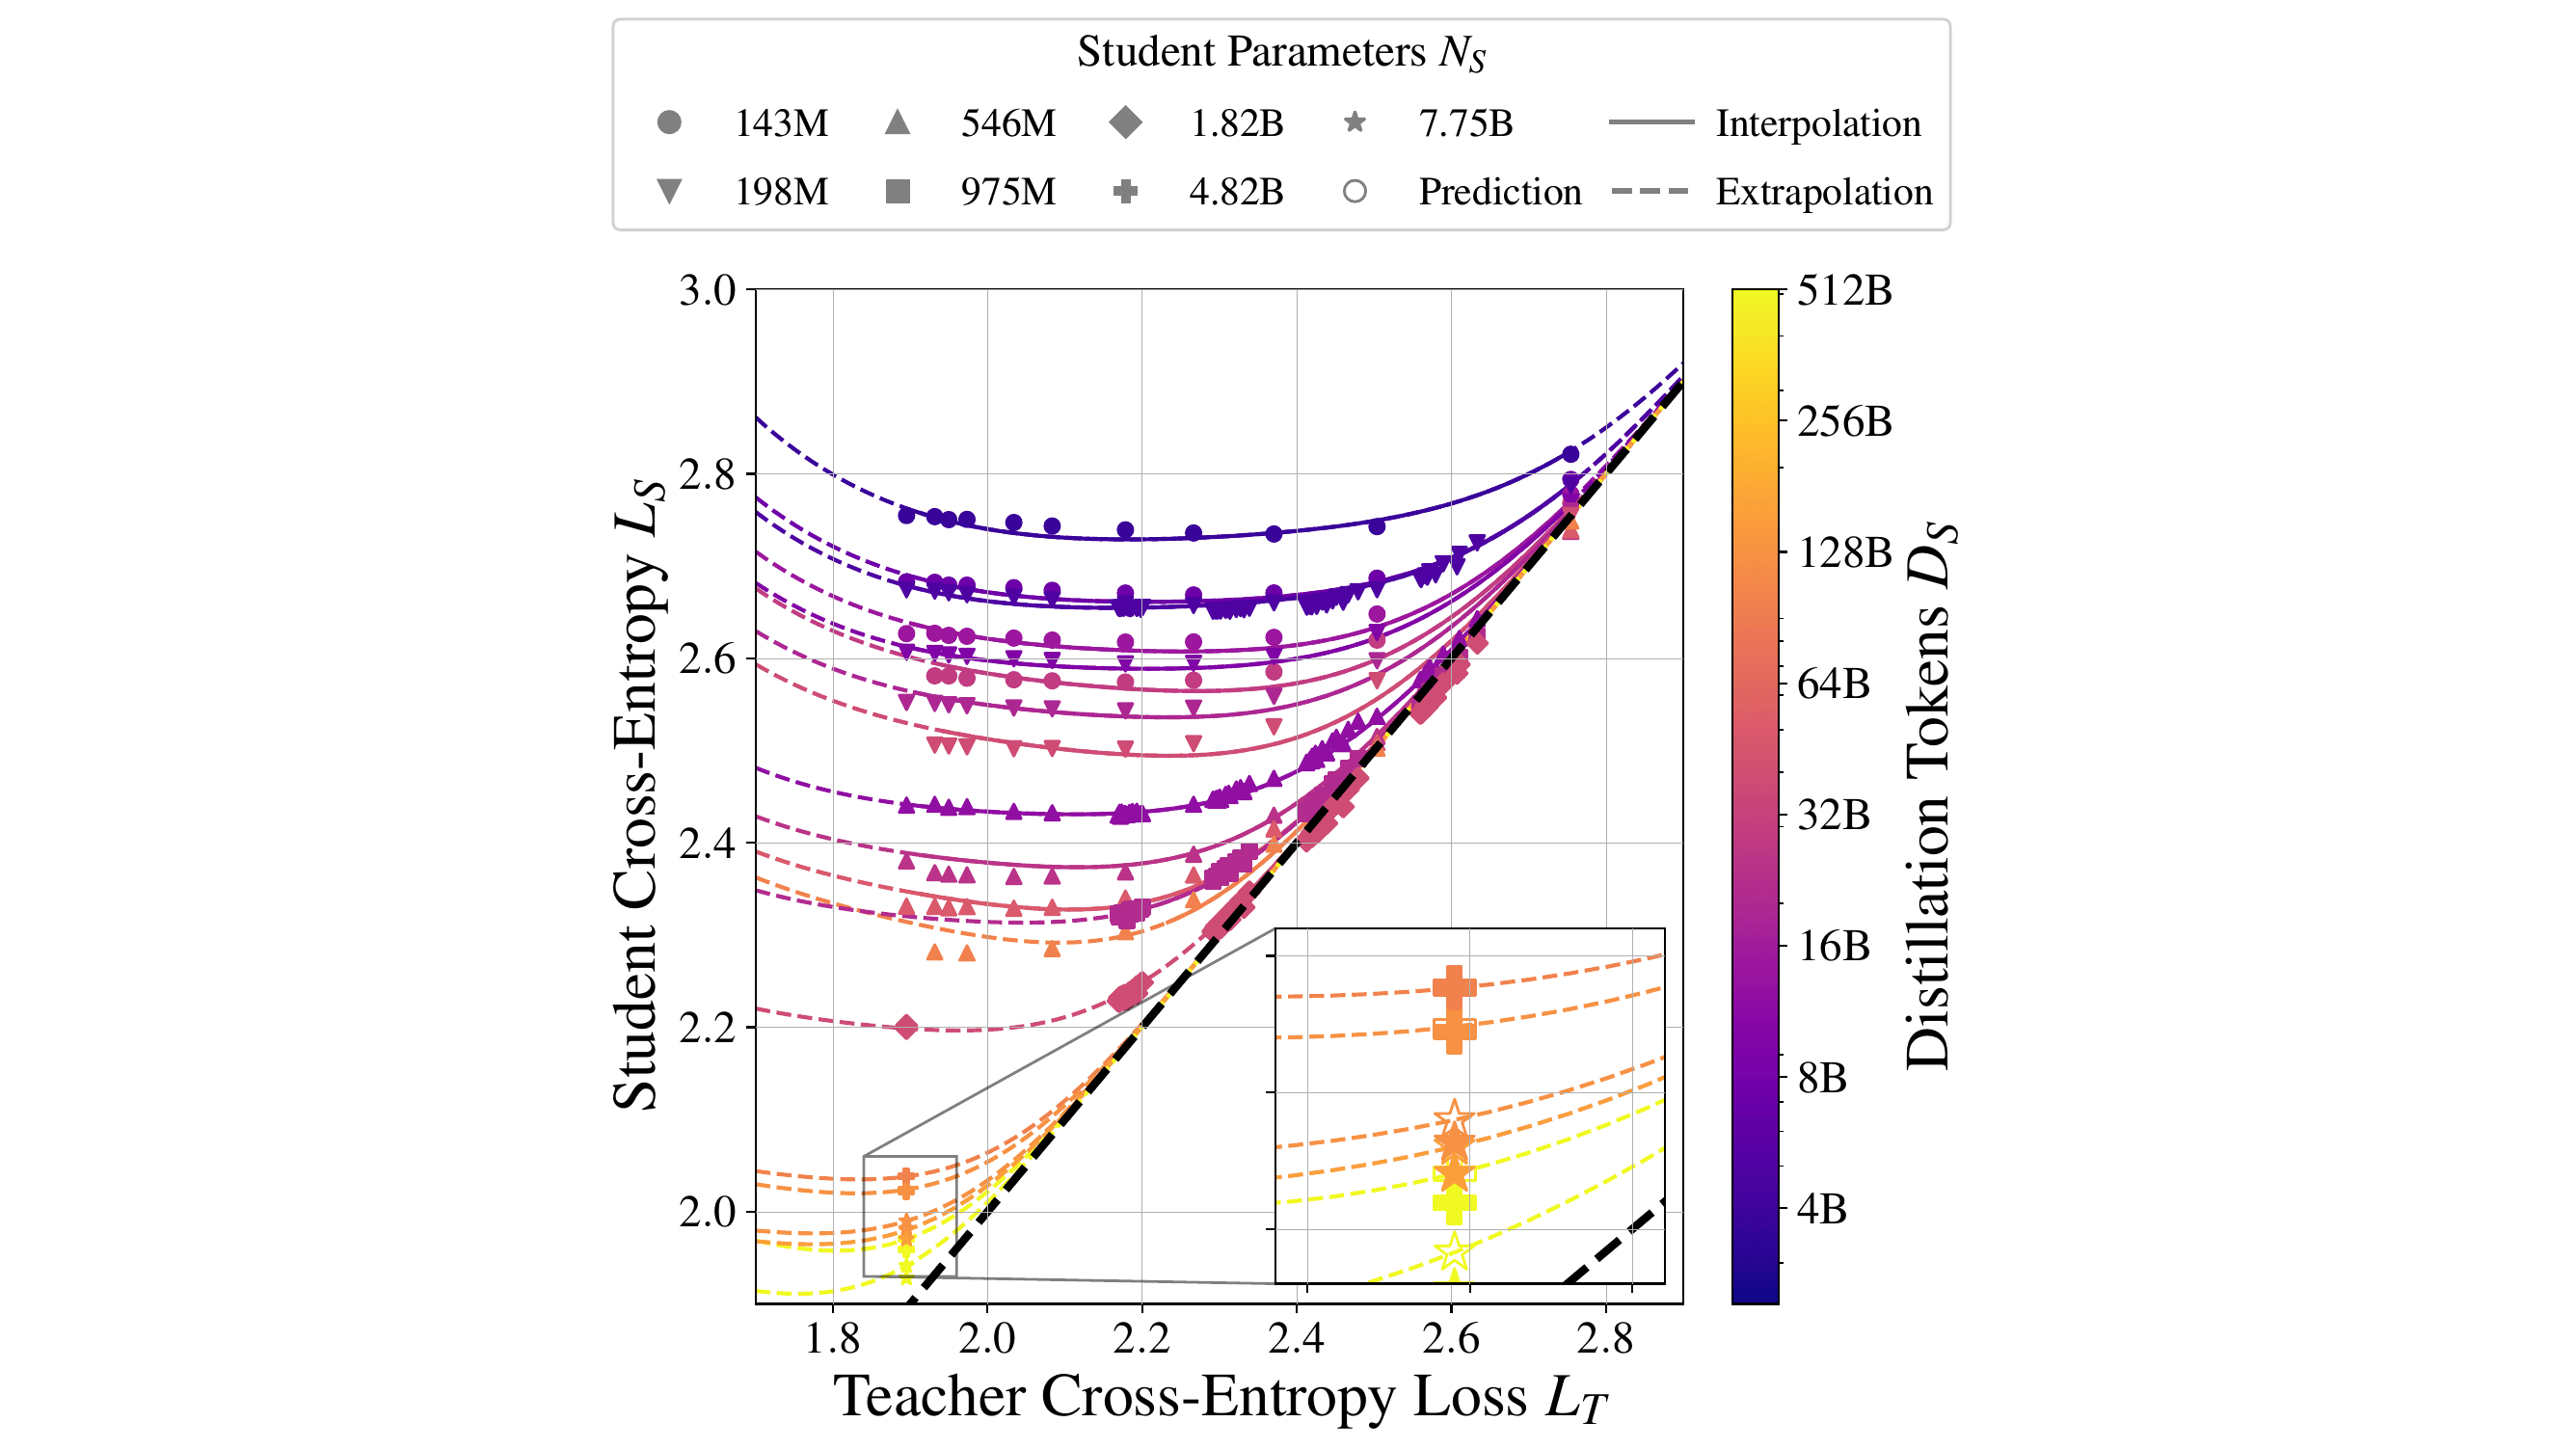
容量ギャップは、「教師は強ければ強いほど良い」という考えを覆します。生徒のサイズと学習データを固定した場合、教師の損失が高い状態から低い状態へと変化するにつれて、生徒の損失は最初は減少し、その後再び増加する、U字型の曲線を描きます。教師が弱すぎると、生徒は十分な情報を学習できません。また、教師が強すぎると、生徒はうまく学習できない可能性があります。
教師が強くなるほど、生徒の損失は最初は下がり、その後上がる
教師の損失をドラッグしてください。値が低いほど、教師が強いことを示します。
上記のインタラクションは、論文の表6の適合係数を直接使用し、約1.98億パラメータで、学習トークン数がパラメータ数の約20倍の生徒を固定した場合のものです。教師の損失を変化させると、生徒の予測損失は、教師の損失が約1.9 natsのときに最も低くなります。natsは、自然対数を使用して交差エントロピーを測定する単位です。教師がさらに強くなり、損失が1.6に低下すると、生徒の予測損失は約2.53から2.61へと上昇します。この数値は、論文の適合範囲における例にすぎず、他のモデルの一般的な閾値として扱うことはできません。
著者らは、理論的な説明として「表現可能なパターンのミスマッチ」を挙げています。教師の容量が大きくなると、生徒がまったく表現できない複雑なパターンを学習し続けます。これらのパターンに適合させるために、教師は確率質量を再分配し、生徒が本来学習できるパターンへの強調を減らす可能性があります。生徒は教師の完全な分布に直面し、限られた容量で近似を行うしかありません。したがって、教師が真の分布に近づくことは、その生徒が模倣しやすくなることとイコールではありません。
論文では、二つの単純化されたモデルを使用してこのメカニズムを検証しています。カーネル回帰は分析的に解ける例を提供します。教師が表現能力を生徒の仮説空間の外にある基底関数に多く割り当てると、生徒の誤差が証明可能な形で増大することが示されます。合成多層パーセプトロン実験でも、同じU字型の現象が再現されました。教師が生徒には到達不可能な基底関数を習得し始めると、生徒の性能に転換点が現れます。これらは共に「学習容量のミスマッチ」を支持するものですが、大規模なトランスフォーマーの内部メカニズムに関する因果関係の証明ではありません。
キャリブレーション実験は、単純すぎる説明をさらに退けています。教師の全分布を学習した生徒は、実データに対してもおおむね適切にキャリブレーションされていました。一方、教師のtop-1だけを学習した生徒は明らかな過信傾向を示しました。逆に、教師のtop-1を評価基準にすると、top-1だけを学習した生徒の方が適切にキャリブレーションされ、全分布を学習した生徒は自信不足に見えることがあります。これは、「教師の答えに合わせること」と「教師の不確実性に合わせること」が別の課題であることを示しています。また著者らは、教師が強くなるほど、生徒が教師の低信頼度領域で全分布を再現しにくくなることも観察しました。これは容量ギャップと同じ方向ですが、ビン分けしたキャリブレーション図は手がかりにとどまり、単独では因果関係を証明できません。
このことは、教師の選択ルールを変えます。目標は、最も損失が低い教師を見つけることではなく、与えられた生徒とデータ予算に適した教師を見つけることです。生徒が大きくなったり、より多くのデータを学習したりすると、釣り合いの点は移動します。元々強すぎた教師が、再び有用になる可能性があります。
教師のコストを分散できるかどうかが、蒸留の費用対効果を左右する
同じスケーリング則でも、異なるコストの計算方法を用いると、まったく異なる選択肢が導き出されます。論文の表2と表5は、四つの状況を明確に比較しています。総コストは三つの項目に分けられます。生徒の訓練は、生徒のトークンあたりのフォワードFLOPsの約三倍に生徒のトークン数を掛けたもの。教師のロジット生成は、教師のフォワードFLOPsに生徒のトークン数を掛けたもの。教師の事前学習は、教師のトークンあたりのフォワードFLOPsの三倍に教師のトークン数を掛けたものです。四つの計算方法は、後者の二つの項目をコストに含めるかどうかを決定するだけで、現実の教師が無料であると主張しているわけではありません。
教師のどのコストを考慮しないかで、結論が変わることがあります
蒸留に最も有利
データが限られる領域では通常優位。十分なデータでは教師あり学習が追いつきます。
優位性は大きく縮小
教師が大きいほどソフトラベルは高コストになり、最適な教師が際限なく強くなることはありません。
一度きりのコストを分散
学習の再開や、複数の生徒で同じソフトラベルを共有する場合に適しています。
教師あり学習が通常優位
三つのコストの合計が、ソフトラベルで節約できる生徒の計算量を上回りがちです。
一つ目は、教師が完全に償却される場合です。教師は既に存在し、ロジットも無料で利用でき、予算は生徒の更新のみを計算します。これは蒸留にとって最も有利な計算方法です。生徒の学習データが少ない場合、教師の分布は単一の実際のトークンよりも多くの情報を提供するため、蒸留は少ない生徒の計算資源でより低い損失を達成できます。しかし、データが増え続けるにつれて、教師あり学習は徐々に追いつき、十分なデータと計算資源があれば、教師あり学習は蒸留に匹敵するか、それを上回る可能性があります。
二つ目は、教師は既に訓練済みだが、生徒の各トークンについて教師モデルの前向き計算一回分のコストがかかる場合です。蒸留は依然として優位性を持つ可能性がありますが、教師が大きくなるほどソフトラベルの生成コストが高くなるため、最適な教師が無限に強くなるわけではありません。
三つ目は、教師の事前学習コストのみを計上し、教師の推論コストは計上しない場合です。教師は新たに訓練する必要がありますが、生成されたロジットは保存され、訓練の再開後や複数の生徒の間で繰り返し使用できます。これは、一度きりの教師コストを計上しつつ、トークンごとの推論コストを分散させるもので、ソフトラベルのキャッシュや複数の生徒の一括訓練に適しています。
四つ目は、「一人の生徒のためにだけ教師を訓練する」状況に最も近いものです。教師の事前学習、教師による生徒データへのフォワード推論、生徒の訓練という三つのコストがすべて計上されます。論文では、この最も不利な計算方法において、教師あり学習が通常は優れていることがわかりました。その理由は明白です。まず、多大な計算資源を費やして教師を入手し、次に教師に生徒のデータを読ませ、最後に生徒が自身の訓練を完了する必要があります。ソフトラベルによる生徒のデータ効率の節約は、最初の二つの追加コストをしばしば相殺できないのです。

論文の図1。曲面は、教師の損失、生徒の規模、生徒の損失の関係を示しています。右側の固定スライスは、容量ギャップを明らかにしています。
論文はさらに詳細な結論も示しています。弱い教師から強い生徒を生み出す蒸留の利点は、主に限られたデータの場合の現象です。生徒が少量のデータしか学習しない場合、教師の分布はより密度の高い学習信号を提供できます。蒸留データが十分になると、生徒は教師に近づきますが、無条件に教師を超えることはありません。「弱い教師が強い生徒を育てる」という言葉は、データ量や評価方法から切り離して成立するものではありません。
このことは、「忍耐強い教師」に関する研究との見かけ上の矛盾も解消します。ここでの「patient」は、生徒がより多くの蒸留トークン、つまりより長い生徒の訓練時間にわたって学習を続けることを指し、同じ教師を事前学習し続けることではありません。論文でも、生徒がより長く蒸留されると改善が見られましたが、C4の同分布で教師あり学習が実際のトークンを使用する比較では、蒸留を続けると最終的に計算資源の観点から非効率になる可能性があります。初期の研究で使用されたデータ分布と教師あり学習のベースラインは異なります。付録E.6で示されている厳密な境界は、各生徒の規模に最適な教師を選択した場合、無限の蒸留データの下での生徒の交差エントロピーの下限が、教師あり学習の下限と一致するというものです。
トークン数一定の曲線と計算量一定の等高線は、蒸留が優位になる領域が静的な境界ではないことも示しています。生徒が大きくなり、予算が増えるにつれて、吸収できる釣り合いの取れた教師は通常強くなります。固定された生徒でデータを増やし続けると、蒸留の教師あり学習に対する優位性は縮小します。著者らは、SLSQP(総計算資源の制約の下で最も低い損失の組み合わせを探索する数値最適化手法)を使用して、四つのコスト条件のそれぞれについて、最適な教師、教師の学習量、生徒のトークンを求めました。ひとつの教師をすべての予算に適用するわけではありません。
付録の下流評価は、この予算に関する結論に現実的なチェックを加えています。タスクのスコアが交差エントロピーの改善に伴って向上する場合、四つの計算方法は依然として参考になります。しかし、モデルがタスク上でランダムに近い場合、計算された交差エントロピーの最適点は、能力の検証に代わるものではありません。論文はまた、二面性のある影響も明確に挙げています。より信頼性の高いスケーリング則は試行錯誤を減らし、小規模モデルのライフサイクルにおける推論コストを削減できますが、教師の事前学習におけるバイアスが生徒に伝わる可能性があり、より強力で安価な小規模モデルは悪用のハードルを下げる可能性もあります。これらは導入に関するリスクであり、法則自体を変えるものではありませんが、「やる価値があるかどうか」という製品上の答えを変えるものです。
したがって、蒸留が費用対効果に優れているかどうかを判断するには、まず三つの質問をしてください。教師は既に存在しますか? それは何人の生徒、または何回の訓練ラウンドに役立ちますか? 現在の生徒はまだデータ不足の領域にいますか? 教師を複数の生徒、複数のサイズ、または複数の展開目標に再利用できる場合、事前学習コストは分散され、蒸留の経済性は大幅に改善されます。生徒がひとりだけの場合、「生徒の訓練が速い」という理由で教師のコストを隠してはいけません。
論文が示すトレーニングレシピ:温度1とTop-k 128
もしあなたのタスクが論文の設定、つまり同じテキスト分布でトークン単位の蒸留を行い、生徒が教師の語彙全体に対する確率分布を模倣する設定に実際に近いのであれば、付録には最初の実験の出発点として使用できるレシピが示されています。
5つの設定には、それぞれ適用範囲があります
260 PBC4の約2Tトークンについて、float32の全語彙logitsを保存する場合の論文推定
公式の係数は、いくつかの曲線を目視で推定したものではありません。著者らは、73の教師ありサンプルと697の蒸留サンプルに対して、対数空間でHuber損失を使用して適合させました。Huber目標は、少数の大きな残差点が結果を支配するのを減らします。その後、複数の初期値からパラメータを探索し、局所解のリスクを低減しています。この方法と、図5の約1%の相対誤差が、レシピの数値の統計的な基盤を構成しています。
ソフトラベルの重み付けについては、純粋な蒸留、つまり教師分布のみを学習する方式が、ほとんどの実験で安定した結果を示しました。そこに実際のトークン損失を混ぜた場合も、蒸留の重みが0.5を上回っていれば、結果は全体的に横ばいでした。温度は教師の確率分布の滑らかさを調整するもので、温度が高いほど低確率の候補により多くの重みが割り当てられます。著者らのテストでは、温度1が最良でした。最適化に関しては、µPは学習率などのハイパーパラメータをモデル規模間で転用しやすくするパラメータ化手法です。この論文では、簡略化したµPのもとで学習率0.01を、検証したモデル規模間で転用できました。
ストレージは、全分布蒸留における最も現実的な障壁です。教師モデルは各学習位置で、語彙内のすべてのトークンに一つずつ生のスコアを出力します。このスコア群をロジットと呼び、そこから確率が算出されます。論文の見積もりでは、C4の約2兆トークン分のfloat32の全語彙ロジットを保存する場合、その容量は約260ペタバイトになります。著者らは、教師の確率が高い上位トークンのみを保持し、それに一部の実際のラベル損失を組み合わせる方法をテストしました。Top-kを128、蒸留の重みを0.7とした場合、生徒モデルの損失は全分布蒸留との差が0.01 nats未満に収まりました。この結果はキャッシュを大幅に削減できることを示していますが、128という値は語彙やタスクを問わず有効な魔法の定数ではなく、各自のデータ分布で再検証する必要があります。
著者らはまた、二つの分布差異の計算方向についても比較しました。順方向KLは教師分布から生徒分布への差を測り、逆方向KLはその順序を逆にします。論文の実験では、順方向KLの損失が2.42、逆方向KLが2.70で、順方向KLの方が良い結果でした。これらの数値はすべて論文の固定されたトレーニングスタックに基づくものであり、出発点としては適していますが、デフォルトの標準として使うべきではありません。
計算量の見積もりについても、一般的なトークンあたりの前向き計算約2N、トレーニング約6NDという式を機械的に当てはめることはできません。この論文は小規模モデルとコンテキスト長4096に焦点を当てており、その場合、注意力と語彙投影は無視できません。固定の幅と深さの比率を持つモデルでは、前向きFLOPsは、パラメータに比例する主項N、指数が三分の二のNのべき乗項、指数が三分の一のNのべき乗項から構成されます。付録では、注意力、MLP、正規化、語彙投影、逆伝播を項目ごとに計算し、構成表で近似値を比較しています。例えば、1.43億の非埋め込みパラメータを持つモデルで2Nのみを使用すると約36%過小評価されますが、コンテキストと語彙の項を加えると誤差は約0.34%になります。したがって、小規模モデルと長いコンテキストの予算では、FLOPsの計算方法自体が最適な経路を変える可能性があります。
この法則は推論軌跡や異なる分布への蒸留には直接適用できない
この論文で研究されているのは、C4 English上のTransformerです。教師モデルと生徒モデルは同じデータ分布から来ており、シーケンス長は4096、蒸留の目標は各トークンに対する教師の完全な確率分布です。この研究は、教師が生成した回答全体をトレーニングデータとして使用する場合、ハードラベルのみを保持する場合、思考連鎖の学習、言語横断転移、異なるドメインのデータ、または教師と生徒が異なるトークナイザーを使用する状況を対象としていません。
実験アーキテクチャも高度に統一されています。マルチヘッド注意力、Pre-NormとRMSNorm、RoPE位置エンコーディング、固定の幅と深さの比率、フィードフォワード層の拡張比を固定し、すべてAXLearnでトレーニングされました。教師と生徒はC4 Englishの異なるデータスライスを使用しています。C4には約1800億トークンが含まれており、教師と生徒には、重複のない学習トークンがそれぞれ約900億ずつ割り当てられています。この規模を超えるトレーニングではデータが繰り返されます。著者が引用したデータ繰り返しの研究によると、C4での教師ありトレーニングにおいて、約四回の繰り返しは損失にほとんど影響を与えません。論文では同時に、この結論が蒸留にも当てはまるとは確認できず、データをまたいだ検証の代わりにはならないと明言しています。
これらの結論が研究全体の中でどのような位置づけにあるかを明確にするため、関連研究と著者の貢献は三つの層に整理できます。
- 問題の系譜:古典的な知識蒸留、自己蒸留、忍耐強い教師、容量ギャップ、キャリブレーション、弱から強への汎化研究は、生徒が何を学ぶか、どれだけ学ぶか、教師が強すぎないか、確率が信頼できるかという問いをそれぞれ提起しています。
- 方法の基盤:教師ありスケーリング法則、C4とデータの繰り返し、SLSQP、Huber、µP、注意力とテンソルプログラム、Transformerトレーニング、FLOPs見積もりは、比較のベースライン、堅牢なフィッティング、モデル規模をまたぐパラメータ転用、コスト計算を支えています。LLaMA、Gemma、転移学習、下流評価、推論計算は、実践的な背景や発展の方向性を提供するものであり、この論文で検証された対象ではありません。
- 証拠の分担:著者の貢献表では、トレーニングとIsoFLOP設計、式のフィッティング、カーネル回帰と合成MLP、キャリブレーション、Top-k、KL分析が異なるメンバーに割り当てられています。したがって、これらの式は実験、理論的な例、工学的な検証という三つのタイプの裏付けを持ち、単なる曲線フィッティングではありません。
意思決定の枠組みは応用できるが、表6の係数は流用できない
C4 English · Transformer
- 同じデータ分布
- トークン単位の全分布蒸留
- 交差エントロピー損失
三つの判断ルール
- 生徒に合う教師を選ぶ
- 生徒データの閾値を確認
- 教師コストをすべて計上して分散
新しい条件では再検証
- 推論軌跡とハードラベル
- 分布・言語・トークナイザーをまたぐ設定
- GSM8KやMMLUでの推論能力
下流タスクの能力の限界も直視しなければなりません。著者らは、一部の標準的な英語タスクが交差エントロピーの傾向と一致することを発見しましたが、彼らのモデルはGSM8KとMMLUではランダムレベルに近い結果でした。したがって、この論文は「交差エントロピーが0.01低下すれば、推論能力や知識問題への回答性能も同じ割合で向上する」ということを証明していません。さらに、今日よく話題になるDeepSeek-R1スタイルの推論軌跡の蒸留について、すぐに使えるスケーリング係数を提供しているわけでもありません。
この論文から実際に応用できるのは、三つの意思決定フレームワークです。最強の教師ではなく、生徒に合った教師を見つけること。生徒のトレーニングデータの閾値を比較に含めることで、一度きりの精度だけを見ないこと。教師のトレーニングと推論のコストを完全に計上し、それを何人の生徒で分担するかを明確にすることです。
具体的な係数は再フィッティングが必要です。データ分布、モデルアーキテクチャ、損失目標、語彙、シーケンス長、トレーニングレシピのいずれかが変われば、容量ギャップや計算上の最適点が移動する可能性があります。この論文を予算モデリングの方法論として使うことは非常に有用です。しかし、表6の数値を別のモデルプロジェクトにそのまま適用すると、一見正確に見えて、実際には証拠に裏付けられていない答えが得られるでしょう。
最終的な判断は一文に要約できます。蒸留の利点は教師分布が提供する追加情報に由来しますが、この情報が実際の計算上の利益に変わるのは、生徒がそれを吸収でき、データがまだ十分でなく、教師のコストを分担できる場合だけです。
蒸留予算:まず生徒に合う教師を探す
Appleとオックスフォード大学の論文『Distillation Scaling Laws』は、小さな言語モデルが教師のトークン単位の確率分布を学ぶ蒸留を予算問題として整理。判断順は、教師との適合、データ不足、教師コストです。
試行錯誤を、学習前の予算計算に
教師の規模と学習量をまず教師損失に集約。生徒の規模、学習トークン数と合わせて最終損失を予測します。実験範囲内の相対予測誤差は約1%です。
固定した生徒には、強すぎる教師も逆効果
約1.98億パラメータの生徒を、1パラメータ当たり20トークン(D_S=20N_S)で学習させると、交差エントロピー曲線はU字型になります。これらのnats値は説明用であり、万能の閾値ではありません。
データとコストの4ケースを比較
4マスをコスト台帳として読みます。ソフトラベルはデータ不足時に最も効き、データが増えると教師あり学習が追いつきます。教師を再利用できれば蒸留に有利。単一の生徒モデルが3つのコストを負担すると、通常は教師あり学習が有利です。
学習前に、3つの質問を確認
C4 Englishを用い、同一分布の教師・生徒によるトークン単位の全確率分布蒸留でのみ検証。推論軌跡、ハードラベル、異なる分布や言語、下流の推論能力は対象外です。別の場合は係数の再フィットが必要です。
- 1 · 教師は適切か?最小損失ではなく、生徒が学べる教師を選ぶ。
- 2 · データはまだ少ないか?データ閾値を超えると、教師あり学習が追いつく。
- 3 · コストは償却できるか?教師モデルが既にあるか、何個の生徒に使い回せるか、logitsを再利用できるかを確認。
最強の教師を追うな:蒸留予算の組み方
嵐同じ計算予算なら、教師モデルを鍛える? 生徒モデルを大きくする? それとも生徒モデルにもっとデータを見せる?
蒸留では、小さな生徒モデルに、大きな教師モデルの出力分布全体をまねさせる。
アシャオ複雑すぎるよ。ぼくの器には収まらない。
生徒モデルの規模と学習データを固定すると、教師モデルを強くするほど生徒モデルの損失は一度下がり、その後また上がりうる。
嵐最強ではなく、この生徒モデルに合う教師モデルを探そう。
生徒モデルを固定した論文中の例では、教師モデルの損失が約1.9の点で最良。モデルが変われば再計算する。
アシャオデータが少ない間は先生が効く。でも十分に見れば、実トークンだけでも学べるよ。
蒸留の優位は、生徒モデルの学習データがまだ足りない領域に集中する。
嵐生徒モデルの訓練費だけではない。教師モデルの事前学習費と推論費も帳簿に入れよう。
教師モデルとそのロジットを再利用できれば、コストは償却しやすい。1台の生徒モデルが3種類のコストをすべて負担するなら、通常の教師あり学習が一般に有利。
嵐教師モデルは生徒モデルに合う? 生徒モデルのデータはまだ少ない? 教師コストは償却できる?
3条件をすべて通過して初めて、蒸留を予算候補に入れる。
嵐持ち出せるのは枠組み。係数はそのまま使えない。
証拠の範囲は、C4英語データ、同分布のTransformer、出力分布全体を使うトークン単位の蒸留。推論軌跡、分布シフト、他言語では再実験が必要。