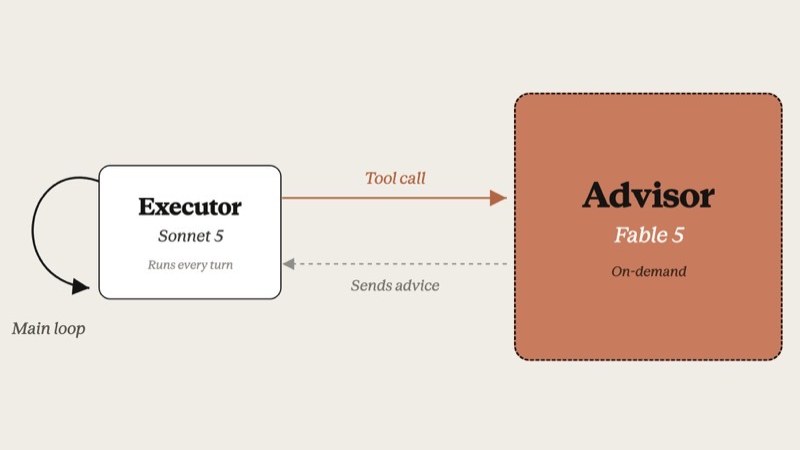
Anthropic公式のアドバイス:Claude Fable 5は「顧問」役、Claude Sonnet 5が実作業を担って費用の大部分を引き受ける
- Anthropic公式開発者アカウント @ClaudeDevs が2026年7月7日、チーム内部でよく使う2種類のClaudeマルチモデル協働パターンを共有した:顧問モード、オーケストレーションモード。
- 顧問モード:実行モデルClaude Sonnet 5が重要な判断に差し掛かったときだけ顧問モデルClaude Fable 5を呼び出す。SWE-bench Proでは、この組み合わせはFable 5単体の約63%のコストで、約92%のスコアを獲得した。Fable 5が呼ばれるのは平均1タスクにつき1回だけ。
- オーケストレーションモード:Claude Fable 5がオーケストレーターとしてタスクを分解し、ワーカーであるClaude Sonnet 5のサブエージェントに並行して割り振る。BrowseCompでは、この組み合わせはFable 5単体の約46%のコストで、約96%のスコアを獲得した。
- 両モードとも背後にあるのはAnthropic公式のClaude Managed Agents(マルチエージェントセッション)機能:顧問モードは具体的なbeta API ツール(advisor tool)に対応し、オーケストレーションモードはマルチエージェント調整機能に対応する。いずれも公式ドキュメントとサンプルコードがあり、チームが独自に組み上げた我流の手法ではない。
- サブエージェントと顧問はそれぞれ独立したセッションスレッドを占有し、スレッド自体は永続的なので、同じサブエージェントに繰り返し質問しても、履歴全体を毎回喂い直して全額課金される心配はない。
このアドバイスは誰が出したのか
Anthropicが開発者向けに運用する公式アカウント @ClaudeDevs が、2026年7月7日、チームがよく使う2種類のClaudeマルチモデル協働パターンを共有した。
顧問モデルと実行モデルはどう分業するか
顧問モードはチームが独自に編み出した我流のやり方ではなく、Anthropic APIに正式に実装されたbeta機能、advisor toolである。実行モデルClaude Sonnet 5はタスクを受け取ると自力で進め、判断に迷う局面に差し掛かったときだけ顧問モデルClaude Fable 5に一度相談し、判断を得てからタスクを完了させる。
顧問・実行の二モデル分業:より上位のClaude Fable 5には「アドバイスを出す」ことだけを任せ、「本文を書く」ことはさせない。大量のトークンを消費する生成タスクはすべてレートの低いClaude Sonnet 5に任せるため、費用の大部分は実行モデルの単価に落ち着く。
これは自前のコードで手動で2回リクエストを叩いてつなぎ合わせるものではない。toolsの中にadvisor_20260301タイプのツールを1つ宣言し、顧問に使うモデルを指定すれば、あとはすべてAnthropicのサーバー側で処理される。実行モデルは通常のツール呼び出しと同じ感覚でいつ相談するかを自分で決め、サーバー側で顧問モデルの推論がもう一度走る。顧問が目にするのは、実行モデルがそこまでに積み上げた対話の全文(システムプロンプト、ツール結果、書きかけの内容を含む)で、判断を返すとそのまま実行モデルの対話に差し戻され、実行モデルはそのアドバイスを踏まえて続きを書く。すべて同一のAPIリクエスト内で完結する:
response = client.beta.messages.create(
    model="claude-sonnet-4-6",
    max_tokens=4096,
    betas=["advisor-tool-2026-03-01"],
    tools=[
        {
            "type": "advisor_20260301",
            "name": "advisor",
            "model": "claude-opus-4-8",
        }
    ],
    messages=[{"role": "user", "content": "Build a concurrent worker pool in Go with graceful shutdown."}],
)
モデルの組み合わせには厳格なルールがある:顧問は少なくとも実行モデルと同等以上の能力を持たなければならず、逆はできない。ドキュメントが挙げる典型的な組み方は2つ。すでにSonnetで複雑なタスクをこなしているなら、Fable 5/Opusを顧問にして品質を底上げする。すでにHaikuを使っていてもう少し賢くしたいなら、Opusを顧問にすることで、実行モデル自体を大型モデルに直接置き換えるよりコストを抑えられる。

なぜ安く済むのか:顧問の出力は通常400〜700テキストトークン程度(思考過程を含めても1400〜1800トークン)しかなく、重要な一言のアドバイスを返すだけで、最終的な答えを最初から最後まで書く責任を負わない。会計上、顧問の呼び出しは顧問モデルの単価でusage.iterations[]に個別に計上され、実行モデルの合計には含まれない。元投稿の「Fable 5は各タスクにつきごくまれにしか呼ばれない(約1回)」という記述は、まさにこの節約ロジックが実際に効いていることを示している。
公式が示すベストプラクティスは、書き始める前に顧問を呼ぶべきで、書き終わってから振り返って質問するのではない、というものだ。Haiku実行モデルが「聞くべきときに聞かない」問題に対しては、Anthropicはシステムプロンプトのテンプレート(ファイルを書くとき、判断を下すとき、行き詰まったときに顧問へ相談するようモデルに促す)を用意しており、内部のコーディングベンチマークでHaikuの通過率を約7.5ポイント引き上げた。これは実測に裏付けられた具体的な数値であり、漠然とした助言ではない。
もう一つの分業:相談せず、直接タスクを割り振る
顧問モードではFable 5は一切作業に触れず、聞かれたときだけ一言答える。オーケストレーションモードは違う。Fable 5が最初から「オーケストレーター」として、タスクをいくつかに分割し、複数のSonnet 5「ワーカー」サブエージェントに割り振って並行して作業させる。自分自身は計画と結果の取りまとめだけを担当し、手を動かさない。

このオーケストレーション機能にも正式な公式サポートがある。Claude Managed Agentsのマルチエージェントセッション機能だ。「オーケストレーター」エージェントを定義する際、multiagentフィールドで調整可能なメンバー名簿(最大20エージェント、下方向に1階層のみ、入れ子は不可)を宣言する:
coordinator = client.beta.agents.create(
    name="coordinator",
    model="claude-opus-4-8",
    tools=[{"type": "agent_toolset_20260401"}],
    multiagent={
        "type": "coordinator",
        "agents": [{"type": "agent", "id": research_agent.id}],
    },
)
session = client.beta.sessions.create(agent=coordinator.id, environment_id=environment.id)
各ワーカーサブエージェントはそれぞれ独立した「セッションスレッド」上で動き、独自のモデル・システムプロンプト・ツール構成を持ち、互いに干渉しない(最大25の並行スレッドをサポート)。公式ドキュメントは、タスクを割り振るのに適した3つのシナリオをまとめている:並行分解(複数の情報源を同時に調べる、複数のファイルを分析するなど、オーケストレーターが最後に取りまとめる)、専門分野別の割り振り(セキュリティレビューやドキュメント作成といった作業を、1つのエージェントに何でもやらせるのではなく対応する専門エージェントに任せる)、能力の格上げ(特に難しい一部のサブタスクだけを一時的により強力なエージェントに格上げして処理させる)。
Anthropic公式のcookbookには具体的に動かせる例が1つある。「コーディネーターパターン」と呼ばれるもので(CMA_plan_big_execute_small.ipynb)、タスクは国立公園10箇所・合計20件の事実が公式情報源と一致するかを照合するというものだ。トップクラスのモデルが単独ですべてのウェブページを読んで照合する場合と、トップクラスのモデルには問題を分解する仕事だけをさせ、ウェブページを読む地道な作業を複数の安価なワーカーサブエージェントに並行して割り振る場合とで、効果を比較している:
公式が実測した結果:分業チームは単独作業に比べ約2.5倍安く、約3倍速かった。ただしnotebookは、いずれも実測から得られた4つの落とし穴の経験を正直に記しており、建前だけの話ではない:
notebookはこのやり方を使うべきでないケースについても示している:問題自体の情報量が小さく、調べることがあまりなければ、無理にオーケストレーター+ワーカーに分割しても、オーケストレーターの往復コストを1回余分に払うだけになる。オーケストレーターが結局タスクを委任せず自分の記憶だけで答えを出したなら、トップクラスモデルの料金を1回無駄にしたことになる。タスクがトップクラスモデル自身に原文の微妙なニュアンスを読み取らせる必要がある場合(単純な事実照合ではない場合)、安価なワーカーサブエージェントは要約の際に重要な情報を取りこぼしかねない。

なぜ繰り返しの呼び出しで毎回全額払わずに済むのか
元投稿にある「各サブエージェントはそれぞれ自分のキャッシュを保持する」という一文の背後には、2層の具体的な仕組みがある。顧問モードとオーケストレーションモードでそれぞれ別のセットになっている。
オーケストレーションモード側:各ワーカーサブエージェントは独立したセッションスレッド上で動いており、スレッド自体は永続的だ。オーケストレーターがしばらくしてから同じワーカーに再び質問しに戻っても、そのワーカーは以前に何をしたか、何を話したかを覚えているので、会話を続けるために履歴全体を喂い直す必要はない。
顧問モード側にはより具体的なスイッチがある:advisorツールは独立したprompt cachingをサポートしている。顧問が同じ会話の中で何度も相談を受ける場合、見えている会話ログの先頭部分は安定している(N回目の相談=N-1回目の内容の後ろに一段追加されたもの)ためだ。キャッシュを有効にすると、重複する部分だけがキャッシュヒット価格で課金される。公式が示す経験則は、1つの会話の中で顧問が呼ばれるのが2回未満ならキャッシュを有効にしてもむしろ損(キャッシュの書き込みコストが節約分を上回る)、だいたい3回目の呼び出しから元が取れ始めるというもの。長い会話、複数回の相談が発生する場面でこそ有効にする価値がある。
顧問モードとオーケストレーションモード、どの条件で選ぶか
両モードとも「より強力なモデルの作業量を減らし、体力仕事を安価なモデルに任せる」という点では同じだが、違いは強力なモデルが「そもそも作業そのものに触れるかどうか」にある。
| 顧問モード | オーケストレーションモード | |
|---|---|---|
| 強力なモデルの役割 | 本文は書かず、聞かれたときだけ一言判断を返す | 本文は書かないが、自らタスクを分解し、割り振り、最後に取りまとめる |
| 向いている作業 | 一本の主軸タスクで、途中に重要な判断ポイントが少数ある | 比較的独立した複数のサブタスクに分解でき、並行して進められる |
| トリガーの仕組み | 実行モデル自身が「相談するかどうか」を判断する | オーケストレーターが最初に「誰が何をやるか」を計画しておく |
| 対応する公式機能 | advisor tool(beta機能) | Managed Agents マルチエージェントセッション |
タスク自体が一本の主軸(例えば一連のコード変更や、継続的な1つの対話)で、生成量は多いが、より強力な判断力が本当に必要な分岐点は少数しかない場合。
タスクが元々互いに独立したいくつかのサブ作業に分解でき、同時進行できる場合(例えば複数の情報を同時に照合する、複数のファイルを分けて分析するなど)。分解し終えたら誰かが取りまとめる必要がある。
顧問モードは、チームがベテランのコンサルタントを1人雇うようなもの――日常の資料作成やメール対応には関わらず、重要な意思決定の局面でだけ会議室に呼ばれて「この方向で合っているか」と聞かれる。オーケストレーションモードは、プロジェクトマネージャーが実習生のチームを率いるようなもの――マネージャー自身は現場作業をせず、タスクをいくつかに分解して異なるメンバーに同時にやらせ、最後に自分で取りまとめてチェックする。どちらの組み方でも、チーム全体のコストは給与の低い側に主に落ち着く。
試してみたいなら、どこから始めるか
両モードとも最小実装はわずか3ステップで済む。自分のシーンに合う方を先に試すとよい。
toolsにadvisor_20260301ツールを1つ追加し、顧問モデルを指定する(実行モデル以上の能力が必須)。デフォルトでは実行モデルにタスクを最初から最後まで任せる。multiagentの名簿を追加し、どのワーカーエージェントを調整できるかを宣言する。各ワーカーはモデルとツールの範囲を独立して設定する。Fable 5を「顧問」として使う。実行モデル(Sonnet 5)がそれに相談する。トークンの大部分は実行モデルのより低いレートで課金される。 @ClaudeDevs、2026年7月7日(X)
- Claude Platform Docs・Advisor tool:顧問モードの公式APIドキュメント。コード例、課金の詳細、ベストプラクティスを含む
- Claude Platform Docs・Multi-agent sessions:オーケストレーションモードの公式APIドキュメント。coordinatorの構成方法を含む
- GitHub・claude-cookbooks / CMA_plan_big_execute_small.ipynb:公式が公開している実行可能なコーディネーターパターンの実例(国立公園の事実照合における実際のコスト比較+4つの落とし穴の経験)
マルチモデル節約術:「全部最上位モデルを使う」→「高いモデルはアドバイスだけ、安いモデルが大部分を片付ける」
Anthropic公式開発者アカウントが提案した2つの組み方:誰がアドバイスを出し、誰が手を動かすかを分ける——1枚の図で節約の仕組みがわかる。
↓ 1枚で読み終える・動く図が1つあります
今、AIで「自力で一歩ずつ作業をやり遂げるシステム」(業界ではAI agentと呼ぶ)を組む人が増えている。組む際にはどのモデルを使うか選ぶ必要があるが、モデルとは価格帯の異なるAIのことで、強いほど高い。最強のClaude Fable 5はどんな難題にも対応できるが、一連の作業を最初から最後まですべてそれに任せると、あっという間に請求額が跳ね上がる。
✘ しかし最初から最後まで一文字ずつ書かせると:一文字ごとに最も高い単価で課金される。
一連の作業のうち大半は、トップレベルの判断力を必要としない「体力仕事」であり、それをすべて高いモデルに任せるのは、高いお金を払ってタイピングを買っているようなものだ。
@ClaudeDevsはClaudeの開発元Anthropicが開発者向けに運用する公式アカウントで、2026年7月7日に方法を1つ示した:高いモデルはアドバイスを出すべき局面でだけ動き、安いClaude Sonnet 5が大量のコンテンツを書き出す作業を担う。
公式は具体的な組み方を2つ示している。違いは高いモデルがそもそも作業そのものに触れるかどうかにある。1枚の図でわかる。
どちらの組み方も高いモデルの作業量を減らす。顧問モード:安いモデルが自力で進め、重要な判断に差し掛かったときだけ高いモデルに一言相談する。オーケストレーションモード:高いモデルが最初に作業をいくつかに分割し、複数の安いモデルに同時に割り振り、自分は問題の分解と取りまとめだけを担当する。
公式は2つの公開テストで実際に金額を測定した。「一貫して最強モデルだけを使う」場合の費用を100元とし、分業後にそれぞれいくらかかり、成績がどれだけ下がるかを見てみる:
以上の数値はすべてAnthropic公式の自己測定によるもので、独立した第三者による再現はない。
すべて最高額で打つ
アドバイスもタイピングも
→ すべて高額
Sonnet 5がタイピングで大部分を担当
→ 大部分は安い
文字は安いモデルが打つ!
(SWE-bench Pro)
第三者による再現なし
アドバイス役に徹させる。
体力仕事は安いモデルに任せれば、
請求額は自然と下がる