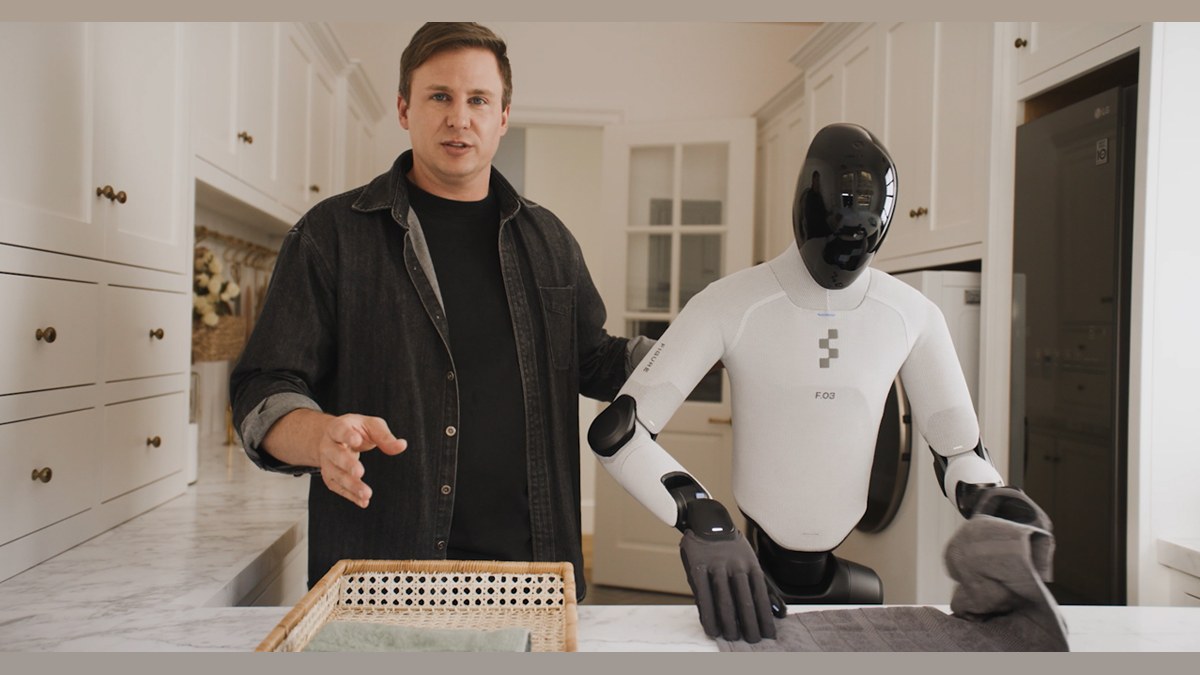
FigureがHelix 2.5を発表:ヒューマノイドロボットが一度も訪れたことのない30軒の家庭に入り、リビングの片付け、ベッドメイキング、タオル折りたたみを直接実行
鍵を握るのはIndexによる人間の経験データ:同一のロボットタスクデータを用いても、事前にIndexで学習したモデルは見知らぬ30軒の家庭で56%の試行を完遂したのに対し、事前学習なしのモデルはわずか8%にとどまった。Figureはさらに「人間のデータが倍増するごとに、ロボットの動作予測精度が安定して向上する」というスケーリング則も計測している。
Figure AIは、同社のヒューマノイドロボットFigure 03向け制御モデル「Helix 2.5」を発表した。このモデルの真の能力を検証するため、Figureはサンフランシスコ・ベイエリアでチームが一度も足を踏み入れたことのない住宅30棟(30軒の家庭)を借り受けた。事前に室内で一切のデータ収集を行わず、ロボットを直接入室させてリビングの片付け、タオルの折りたたみ、ベッドメイキングを行わせた。
Helix 2.5の主な能力と特徴
- 訪れたことのない家で直接作業:データを事前収集しておらず、チームも入ったことがない30の家庭において、各住宅に元からあるソファ、ベッド、作業台をそのまま使い、現場に合わせた調整を一切行わずに、リビングの片付け、タオルの折りたたみ、ベッドメイキングを完了した。
- 1つの基盤モデルから3種類の全身家事を教示:3つのタスクはいずれも、Index上で事前学習された同一の基盤モデルを出発点として個別に教示された。歩行、硬い玩具や柔らかいタオル・布団の把持、両手の協調動作、そして歩きながら視覚で対象を探す動作が要求される。
- 全身の協調動作:ソファとコーヒーテーブルの間、ベッドとクローゼットの間の狭い空間で、歩きながら腰をかがめ、立ち位置を変え、ベッドの周囲を回り込んで作業を行う。歩行と手の操作を2つの動作に分割しない。
- 自己修正能力:ミスが発生した際や手が届かない場合、一歩下がって立ち位置を直したり、姿勢を変えたり、ベッドの反対側に回り込んで布団の端を整え直したりする(これはFigureによる定性的な観察であり、具体的な数値は公開されていない)。
- 人間の経験データに由来する能力:モデルはスクラッチから、Figureが独自に収集した人間の経験データ「Index」のみを用いて事前学習されている。同一のタスクデータを用いた場合、Indexによる事前学習があるモデルは試行の56%を完全にやり遂げたのに対し、事前学習がないモデルはわずか8%にとどまった。
- 新タスクの教示に必要なデータを節約:Helix 02の代表的なタスクと比較して、半分のタスクデータで同等の成功率を達成し、しかもそれを見知らぬ30の家庭で実現した。
- データが多いほど性能が向上し、事前に予測可能:Indexのデータ量が倍増するごとに、ロボットの次の動作を予測する誤差が一定幅で安定して低下し、最初の3段階の結果から4段階目の数値を正確に予測できた。
ロボットが見知らぬ家庭に入ることの真の難しさとは
一般的な人間であれば、見知らぬ家に入ってもすぐに作業を始めることができる。私たちは物理世界に対する理解をある環境から別の環境へと持ち越すことができるため、ベッドの高さが違うからといってベッドメイキングを一から学び直す必要はなく、家具が異なるからといって部屋の片付けを一から学び直す必要もない。しかし、現在のロボットにはそれができず、場所ごとに個別に学習している。Figureが以前公開したHelix 02は、全身を協調させて長時間のタスク(食洗機の食器の出し入れや、物流タスクでの200時間の自律稼働など)を完了させることができたが、それらのデータはすべてロボットが実際に稼働する現場で収集されたものだった。
この困難をもたらしている根本的な要因はデータにある。大規模言語モデルがブレイクスルーを達成できたのは、スケーラブルな事前学習と膨大なデータおよび計算資源が組み合わさったためである。しかしロボット工学の分野には、直接学習に利用できるインターネット規模のデータが存在しない。
Helix 2.5は、大規模モデルの手法をヒューマノイドロボットへと移植しようと試みている。まず大量のデータを用いて汎用的な事前学習を行い、次に少量のデータで具体的なタスクを教示する。その事前学習データこそが、Figureが独自に収集した人間の経験データ「Index」である。3つの家事はロボットデータを用いて教示され、その後は何の調整も行わずに、一度も訪れたことのない家庭へと直接投入される。
30の見知らぬ家庭でのブラインド評価現場:ゼロショットで何を測定したのか
ここでの「ゼロショット(zero-shot)」には明確な定義がある。ロボットが一度も学んでいない新しい作業をいきなり実行できるという意味ではない。タオルの折りたたみ、ベッドメイキング、おもちゃの拾い上げの手順は、事前に別の場所で収集されたロボットタスクデータを用いてモデルに教示されている。ゼロショットが意味するのはただ1点、テストに使用された住宅や物品をモデルが事前に一切目にしておらず、現場に到着した後も調整を一切行っていないということである。 具体的には以下の通りである:
- Figureはサンフランシスコ・ベイエリアで30棟の住宅を借りてブラインド評価(blind evaluation)を実施した。チームはこれまでこれらの住宅に立ち入ったことがなく、内部でのデータ収集も一切行っていない。
- 評価に使用する13〜15個のおもちゃ、タオル、寝具類は、全実験の開始前にあらかじめ取り分けられ、まずAIモデルによって、次いで人間による再確認を経て、それらがタスクデータ内に出現していないことが確認された。
- ロボットは各家庭に備え付けのソファ、ベッド、折りたたみ台、照明環境をそのまま使用した。3つのタスクでは30の家庭を通じて同一の固定されたモデルバージョン(チェックポイント)が使用され、評価対象の家庭や物品に応じた重みの調整は行われず、評価中の試行データやパフォーマンスに基づいてモデルバージョンを選別することも行われなかった。
これら3つのタスクを合わせると、知覚、歩行、把持操作、両手の協調、全身制御が必要となり、そのどれもが固定された環境であっても容易ではない。下表は原文に示されたタスクの定義である:
| タスク名 | 対象物品 | シーンの条件 | 初期状態の乱れ | 合格判定基準 |
|---|---|---|---|---|
| リビングの片付け (Living Room Tidy) | 形状・材質・硬さが異なる13〜15個の小型手持ち玩具 | 対象住宅備え付けのリビング(未見の家具、床材、照明を含む) | スタッフが物品を床、ソファ、コーヒーテーブルの上に無作為にばらまく | 室内全体を自律的に巡回・探索し、すべての物品を拾い上げて収納バスケットに完全に回収する |
| タオルの折りたたみ (Towel Folding) | サイズ・色・厚さ・手触りが異なるタオル | 住宅内の任意の作業台(高さや表面摩擦が異なる) | タオルが無造作に丸められて作業台の上に投げ出される | 各タオルをきちんと折りたたんでバスケットに入れる(図表では1回の試行につき4枚) |
| ベッドメイキング (Bed Making) | 材質・重さ・質感が異なるベッドカバー、布団、枕 | 住宅本来のベッド(異なるベッドフレームの高さ、ベッド周囲の空間、照明条件) | スタッフが無造作に2つの枕と布団を乱す | ベッドの周りを歩き回り、2つの枕をベッドヘッド側3分の1の領域に戻し、布団を平らに引き伸ばす |
採点はタスク全体が完了したかどうかのみを評価する:部分点は一切与えられず、1回の試行でタスク全体を完全にやり遂げて初めて成功と判定される。評価細則では物品ごとに制限時間も設けられている。おもちゃは1個につき制限時間1分(時間超過で試行全体が中断・失敗)、タオルは1枚につき制限時間3分(時間超過でそのタオルは失敗判定、試行全体の成功にはすべてのタオルの成功が必要)、枕および布団の各側面は制限時間1分(時間超過で試行全体が中断・失敗判定)となる。安全上の理由で人間の介入が必要となった場合も、その試行は即座に中断され失敗と判定される。
8%から56%へ:事前学習がもたらした格差
この一連の成績のうち、どれだけがIndexの事前学習によるもので、どれだけがタスクを教示するためのロボットデータによるものなのか?Figureは一連の対照実験を行った。構造が完全に同一の2つのポリシー(policy:ロボットが見て感じた状況に基づき、次の動作を決定するモデル)を構築し、全く同一のタスクデータと学習設定(ハイパーパラメータ)を適用した。
2つのモデルの唯一の違いは出発点にある。一方はランダムな重みから直接学習を開始したタスク専用モデルであり、もう一方は大量の人間の行動データ(Index)上で事前学習を完了させた後、同一のプロセスでファインチューニングされたHelix 2.5である。Helix 2.5自身もランダムな初期化から開始し、完全にIndex上で事前学習されている(前世代のHelix 02は既存の事前学習済み視覚言語モデルから出発していた)。したがって、この対照実験が比較しているのは「Indexによる事前学習の有無」であり、「何らかの事前学習の有無」ではない。
対照実験の概要
2つのモデルの違いは出発点のみ:事前にIndexで事前学習したかどうか
Helix 2.5
ランダムな重みから開始し、まずIndexの人間の経験データで事前学習
評価対象のどのタスクもIndex内での割合は1.90%以下対照群
ランダムな重み、Indexによる事前学習なし
- タスクの教示:同一のロボットタスクデータ(別所で収集され、評価用の家庭や物品は含まない)
- 学習設定:モデル構造、最適化手法、ハイパーパラメータが一致
- テスト:タスクごとに1つのモデルバージョン(チェックポイント)に固定し、見知らぬ30家庭でブラインド評価。各タスク140回、部分点なし
完全達成237 / 42056%
完全達成35 / 4208%
両グループのモデルは、同一の30軒の家庭でそれぞれ420回の試行(タスクごとに140回)を実施した。タスク別の内訳は以下の通りである:
| 評価タスク | Index事前学習なし(ランダム初期化) | Index事前学習あり (Helix 2.5) | 倍率 |
|---|---|---|---|
| 全4枚のタオルの折りたたみ | 12 / 140回成功 (9%) | 87 / 140回成功 (62%) | 約7.3倍 |
| 全13–15個のおもちゃの片付け | 7 / 140回成功 (5%) | 56 / 140回成功 (40%) | 8倍 |
| 完全なベッドメイキング(≥B評価) | 16 / 140回成功 (11%) | 94 / 140回成功 (67%) | 約5.9倍 |
| 3タスク合計 (Pooled) | 35 / 420回成功 (8.3%) | 237 / 420回成功 (56.4%) | 約6.8倍 |
注:ベッドメイキングタスクの図表ラベルには「≥B」と表記されているが、原文付録のベッドメイキング評価基準はGood / Bad / Failの3段階となっており、「≥B」が具体的にどの段階に対応するのかは明記されていない。
数値の基準について:公式ブログの本文および要点要約では、「ゼロショット成功率が9%から56%へと6倍以上向上した」と記載されている。しかし原文Figure 1における3タスクの合計は35/420(約8%)対237/420(約56%)であり、約6.8倍となる。図中の9%はタオル折りたたみ単体の数値(12/140)である。原文ではこの食い違いについて説明されておらず、本稿では図中の試行回数に基づいて計算している。
各項目のデータを見ると、リビングの片付けの成功率(40%)は、ベッドメイキング(67%)やタオルの折りたたみ(62%)に比べて明らかに低い。採点規則から推測すると、これは評価方法に関係している可能性がある。リビングの片付けでは、散乱した13〜15個の物品をすべて見つけ出してバスケットに収める必要があり、1個あたりの制限時間は1分であるため、途中で1個でも見落とすか把持が時間切れになれば、試行全体が失敗と判定される。しかし全体として見れば、全く同じタスクデータを用いながら、Indexによる事前学習を経ているかどうかで、3タスクの総合成功率に7倍近い開きが生じた。
公式動画の中で、Figure CEOのBrett Adcockは「30軒の家庭のすべてにおいて成功を確認した(we saw success in every one of them)」と述べている。ただし公式ブログでは単一試行に基づく全体的な成功率のみが提示されており、住宅ごとのテストデータは公開されていないため、この発言を公開された数値で具体的に検証することはできない。これはせいぜい、各家庭でロボットが一度はタスクの完了に成功したことがあるという事実を示すにとどまり、すべての試行で成功したことを意味するわけではない。
成功率の向上に加え、事前学習は新しい動作の定義に必要なデータ量をも変化させた。FigureはHelix 2.5を代表的なHelix 02の動作と比較した。従来のHelix 02ポリシーは最終評価と同じ環境で収集されたデータを使用していたが、Helix 2.5はその半分のタスクデータだけで同等の成功率を達成し、しかもそれを見知らぬ30軒の家庭においてゼロショットで実現した(Figureは両者の具体的なデータ量や成功率の数値を公開していない)。
事前学習に用いられたIndexとはどのようなデータか
大規模言語モデルはインターネット全体のテキストを利用して事前学習を行うことができるが、ロボットにはそのような既存のデータが存在しない。Figureのアプローチは「ヒューマノイドロボットの身体が世界を移動する方法は人間と同じであるため、人間の経験から直接学習できるのではないか」という着想に基づいている。
Figureはそのために「Index」と呼ばれるデータ収集ネットワークを構築した。具体的にはスマートフォン向けアプリをリリースし、個人のクリエイター(Creators)に対価を支払って、家庭や職場での作業風景を動画で撮影・記録してもらう仕組みである。なお、公開されているIndexのデータは時期が異なり、いずれもFigureによる自主的な開示情報である点に留意されたい:
- 規模:公式動画においてチームは、毎週90,000人以上がデータを提供していると言及している。またHelix 2.5発表時の公式ブログでは、Indexにより1秒あたり約35分の新たな人間の経験が生み出されていると述べている。2026年8月25日にIndexを正式発表した際、Figureは同社アプリが108カ国で累計264,000回以上ダウンロードされ、その時点までにクリエイターへ1,500万ドル($15 million)を支払ったと公表した。
- タスクとシーンのカバー範囲:データには、家庭での料理、掃除、洗濯、猫のトイレ掃除といった日常の家事から、エンジンオイル交換、レストランのテーブル片付け、さらには物流センター、レストラン、工場、オフィスなどの職場環境で記録された作業が含まれる。クリエイターがそれぞれの環境で撮影するため、間取り、照明、家具の配置、作業の癖などの多様性がもたらされる。
Figureは、その後のあらゆる動作への微調整を可能にするため、事前学習は意図的に非常に幅広い範囲を網羅するように設計されていると説明している。付録に記載された手法によると、チームはIndexの各動画に対して動画埋め込み(embedding)を作成し、視覚言語モデルが生成した活動や物体の説明に対してテキスト埋め込みを作成した上で、それぞれを多層的な意味カテゴリにクラスタリングし、各カテゴリが総時間に占める割合を算出した。その統計によれば、評価対象となった3つのタスクに含まれる具体的な行動カテゴリは、Index事前学習データセット全体の中でいずれも1.90%を超えていなかった。
原文はここから、全く同一のタスクデータを用いて教示する場合、あらかじめ大量の人間の経験に基づいて学習されたモデルを出発点とした方が、はるかに高い転移効果が得られると結論づけている。ただしFigureは、Indexによる事前学習が人間の動画を具体的にどのようにロボットが利用可能な学習シグナルへと変換しているのか(例えば学習目標は何か、人間の手の動きをどのようにロボットに対応させているのかなど)や、モデルの具体的なアーキテクチャおよび規模については公開していない。
人間のデータが倍増するごとに、ロボットの動作予測が安定して向上
成功率の向上だけでなく、Figureは1つのスケーリング則(scaling law)も提示した。Figureの知る限り、人間からロボットへの転移においてスケーリング則が測定されたのはヒューマノイドロボットとして初のことであるという。
大規模言語モデルの領域において、スケーリング則はデータ量と計算量の増加に伴ってモデルの予測損失(loss)が滑らかに低下することを示し、研究者が小規模な学習ランを通じて、より大規模なモデルの性能を事前に予測することを可能にしている。
Figureはこれに対応する問いを立てた:人間の経験をヒューマノイドロボットの動作予測へと転移させる際にも、同様の予測可能な規則性が存在するのだろうか?
これを検証するため、Figureはモデルの規模と後段のタスク教示の学習方式を固定し、Indexの事前学習データ量のみを変更して、1倍、2倍、4倍、8倍のIndexデータを用いて4つのモデルを学習させた(小規模なデータはすべて大規模なデータに含まれている)。これら4つのモデルはいずれも同一のタスクデータでファインチューニングされ、学習に含まれずあらかじめ取り分けておいた同一のデータ上で検証loss(validation loss)が計算された。
ここでのlossは何を測定しているのか?
学習に使用されていない一連のロボットタスクデータ上で、モデルに「ロボットが次にどう動くべきか」を予測させる。モデルが予測した動作とデータ内の実際の動作との差分がここでのlossであり、差が小さいほど動作予測が正確であることを意味する。
結果は極めて整然としたものとなった:人間のデータが倍増するごとに、lossはほぼ一定の幅で一段ずつ低下した。
原図からの読み取りによる推計(原文には具体的な数値が記載されていない)によれば、事前学習データが1倍から8倍に増加するにつれて、検証セットのlossは約0.02897から約0.02789へと段階的に低下した。比較的小さな3つのデータ量(1×、2×、4×)の結果のみを用いてトレンドラインを引いたところ、チームは最大となる8×モデルを学習させる前に、テストlossを小数点以下第4位の精度で予測することができ、その予測誤差は8倍のデータ変化幅全体のわずか0.54%にとどまった。
見方を変えれば、このloss自体が0.028前後であり、データが8倍になっても全体で約0.0011(約3.7%)しか低下しておらず、予測誤差はその変化幅の0.54%を占めるにすぎない。つまり、規則性の曲線は極めて整然としており高い予測可能性を持つものの、測定しているのは動作予測の誤差であり、各段階での低下幅自体は決して大きなものではない。
原文Figure 2の再描画
Indexデータが倍増するごとに、動作予測lossが一定幅低下
- 4モデルの実測loss
- 1×、2×、4×の3点のみから引いた延長線
原文の説明によれば、これは「人間の経験がさらに倍増した場合にどれほどのゲインが得られるか」を学習前に事前予測できる可能性を示唆している。ただし原文は同時に、この実験ではデータ規模のスケーリングのみをテストしており、モデル規模やタスク教示の学習方法は固定されていると断っている。計算資源の投入に関して、FigureはHelixの学習のために35億ドル($3.5 billion)規模のコンピュートを投じることを約束している(原文はNscaleとの提携発表にリンクしている)。
また、この曲線には限界もある:原文はこの4つのモデルの実際のタスク成功率を公開していない。動作予測lossの低下が、家庭における実際の成功率向上に結びつくのか、結びつくとしてどれほど迅速に反映されるのかは、現時点では不明である。
なぜ全身を一緒に動かさなければならないのか
ロボットの汎化性に関する研究の多くは、機械のために特別に設営された環境で行われてきた。卓上マニピュレータは固定された作業スペース内で作業し、車輪型ロボットは台車が進入・旋回できるように床面に十分な開放空間を必要とする。一般家庭はそうした都合の良い環境を提供してはくれない。ヒューマノイドロボットは、物品を視認し、手を伸ばし、操作するために、狭く散らかった空間の中で体を動かし、立ち位置を調整しなければならない。そのためタスクは全身の課題となる。ロボットはまず歩いて物を探し、次にかがんで手を伸ばす必要があり、見る、歩く、取るという一連の動作を切り離して解決することはできない。
従来のロボットシステムでは通常、歩行と手先の操作を2つの独立したコントローラに分割し、あらかじめ設定された切り替え規則(ステートマシン)でそれらを連携させていた:歩く、止まる、踏ん張る、手を伸ばす、つかむ、再び歩く。ロボット制御の分野では現在、統一されたニューラルネットワークが全身を直接制御するアプローチが模索されている(例えば Google DeepMind の Gemini Robotics 2)。Figure自身も以前発表したHelix 02においてすでに単一のニューラルネットワークで全身を制御していた。したがってHelix 2.5の核となる新たなブレイクスルーは「全身制御」それ自体ではなく、一度も訪れたことのない見知らぬ30軒の家庭において、ゼロショットでそれを実現した点にある:
改造されていないこれらの家庭環境において、3つのタスクはいずれも能動的知覚(Active Perception)を要求する:死角を確認し物品に手を届かせるために、ロボットは室内を歩き回り、身体の位置や向きを調整しなければならない。
長時間のマルチステップタスクにおいて、Helix 2.5が見せた定性的な能力の1つが全身による自己修正である:ミスや動作の制限に遭遇した際、ロボットは一歩下がって姿勢を立て直したり、角度を変えたり、ベッドの周りをぐるりと回って布団の端を直したりすることができる。Figureは、ミスが発生した後に自律的に復旧してタスクを継続するこの能力こそ、Indexによる事前学習がもたらした重要な効果であると考えている(原文に具体的な統計データは示されていない)。
この一連の実験が示していること、まだ証明していないこと
この結果が示していること:
- Index事前学習により同一タスクデータの効果が向上:3つのタスク自体は依然としてロボットタスクデータを用いて指定する必要があるが、Indexによる事前学習を経ることで、同じタスクデータが見知らぬ環境で格段に高い効果を発揮するようになった。Figureの知る限り、この規模でヒューマノイドロボットの全身ゼロショット汎化が達成されたのはこれが初めてである。
- 未知環境でのゼロショット汎化:一切のデータ収集を行っていない30の実家庭において、未見の家具や物品に直面しながら、事前の現場適応を一切行わずに、3つの全身長時間タスクで総合単一試行成功率56%を達成した。
- 新規タスク教示に必要なデータ量が半減:Figureが提示した比較において、Helix 2.5は前世代のHelix 02の半分のタスクデータだけで同等の成功率を達成し、同時に見知らぬ30軒の家庭でのゼロショット汎化を実現した。
この結果がまだ証明していないこと:
- 家庭での完全な自律稼働との間には依然として距離がある:総合成功率が56%であるということは、試行の半数近く(44%)が最後まで完了しなかったことを意味している。原文では失敗要因の具体的な内訳(タイムアウトや安全のための人間の介入がそれぞれ何割を占めたかなど)は公表されていない。
- 動作予測lossの低下がタスク成功率の向上に対応するかは未証明:Figureはデータ倍増によって動作予測誤差(loss)が滑らかに低下することを証明したが、異なる事前学習データ規模を持つ4つのモデルについて、30軒の家庭における実際のタスク成功率は公表していない。動作予測lossの低下がどの程度、またどれほど迅速に実際の成功率向上へと転移するのかは、現時点ではデータによる裏付けがない。
- タスクの範囲と評価の独立性に限界がある:テストはFigure自身が選定し、自身で評価した3つの家事に限定されている。「ゼロショット」はあくまで評価環境と物品に対してのみ適用されたものであり、新しいスキル自体は依然としてロボットタスクデータを用いて教示する必要があり、訓練されていない新たなタスクへと何もない状態から汎化できるわけではない。
これは汎用ヒューマノイドロボットの課題が解決されたことを意味するものではない。Figure自身の言葉を借りれば、これは全身能力が人間の経験から学習可能であり、毎回ゼロから構築することなく新たなシーンへと転移できることを示す最初の証拠である。Figureが提示した処方箋は「事前学習で広く学び、具体的な行動の教示は1回にとどめ、配備時には汎化に頼る」というものである。