
OpenAIが「GPT-6 Sol」と「GPT-6 Luna」を発表:能力は大幅向上、価格は半額に
Solはコードのマージ性や事実の信頼性が向上し、Lunaは専門的な長時間タスク、ソフトウェアエンジニアリング、PC操作において高いコストパフォーマンスを示しています。まずは能力がどこで変化したかを確認し、次に価格とキャッシュがどのように利用コストを引き下げるのかを見ていきましょう。
OpenAIはGPT-6 SolおよびGPT-6 Lunaを発表しました。Solは複雑なプログラミングや専門業務向け、Lunaは高頻度かつ大規模な日常タスク向けと位置づけられています。OpenAIが公表した評価結果によると、今回のアップデートでは業務・エンジニアリングタスクの性能、事実関係の信頼性、対話スタイル、ツールの利用挙動などの面で変化が見られます。上記の箇条書きは、その主な向上点をまとめたものです。
同時に、SolのAPI入力・出力価格はともに50%引き下げられ、Lunaは入力価格が50%、出力価格が約58%引き下げられました(前世代GPT-5.6のプロモーション価格との比較)。以下では、まず各機能面の変化を個別に見ていき、その後にキャッシュと価格設定が実際のコストにどう影響するかを解説します。
一、業務、コーディング、PC操作:能力はどこが向上したのか?
エージェントモデルを評価する際は、タスク達成スコアだけでなく、「1タスクあたりのコスト対スコア」のパフォーマンスを総合的に考慮する必要があります。本節のデータはすべてOpenAI公式が発表した評価結果に基づくものであり、第三者による独立した実測検証ではありません。公式の説明によれば、自社モデルの評価は研究環境またはAPI経由で実施されたものであり(システムプロンプトや利用可能なツールの違いにより、本番環境のChatGPTの出力とはわずかに異なる場合があります)、競合モデルのデータは公開レポートから引用され、Claude Fable 5.1のデータが不足している箇所ではFable 5を用いて補完・対照されています。
1. 業務ワークフロー:AutomationBench
AutomationBench 1.0.6が主に対象としているのは、セールス、マーケティング、オペレーション、カスタマーサポート、財務、人事などの実務において、エージェントが常用される47種類のツールをエンドツーエンドで呼び出し、複数ステップのプロセスを遂行する能力の検証です。
このベンチマークにおいて、推論エフォート(Reasoning Effort:low、medium、high、xhigh、maxなどの設定値)は、モデルにどれだけの推論計算量を割り当てるかを指定するソフトウェア上の設定であり、ハードウェアの構成ではありません。GPT-6 Solはxhigh設定で33.2%のスコアを記録し、1タスクあたりのコストは$0.27でした。一方、Claude Opus 5はmax設定で26.9%のスコア、1タスクあたりのコストは$3.05でした。Solの1タスクあたり費用は後者の約9%にとどまります(Opus 5のコストはSolの約11.1倍)。
同じグラフの他の設定値を見ていくと、モデル選定に影響を与えるいくつかの違いが浮かび上がります:
- Claude Fable 5.1のフォールバックコストは未算入:Fable 5.1はmax設定で31.4%のスコアを記録(グラフ上の名目コストは$2.45)していますが、公式の注記によると、テスト内のタスクの約40%がOpus 5へフォールバックして処理されたものの、グラフにはそのフォールバックコストが含まれていないため、実際の支出は過小評価されているとされています。
- 推論エフォートの引き上げが必ずしもスコア向上につながるわけではない:GPT-6 Solはxhigh設定で33.2%(コスト$0.27)を記録しましたが、より高いmax設定では逆に32.0%へとわずかに低下し、コストは$0.34に上昇しました。これは、単に推論計算量を増やすだけで必ずしもタスク精度が高まるわけではないことを示しています。
- Astraを全面的に代替できると判断することはできない:Sol (xhigh) のスコアはlow設定のGPT-6 Astra(30.3%、コスト$1.08)を上回っているものの、これは特定タスクにおいてSolの高推論設定とフラッグシップの低推論設定が交差した結果に過ぎず、全体的な能力においてSolがAstraを代替できると結論付けることはできません。
- Lunaの軽量モデルとしてのパフォーマンス:GPT-6 Lunaはhigh設定で14.5%のスコアを記録(コスト$0.021)、前世代のGPT-5.6 Luna(9.1%、コスト$0.050)と比べて5.4ポイント向上し、1タスクあたりのコストは58%削減されました。max設定では20.7%(コスト$0.037)に達しています。

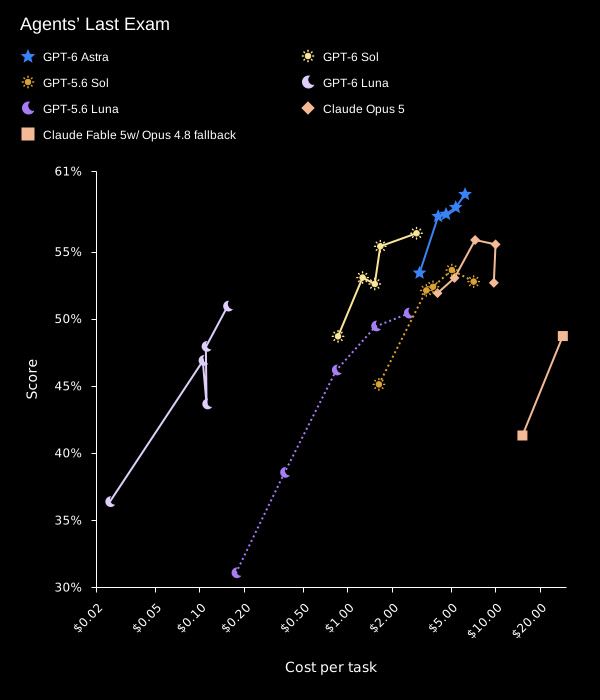
2. 高い経済価値を持つ長時間タスク:Agents’ Last Exam
Agents’ Last Exam V1は、55の細分化された業界にわたるPC上の複雑な作業において、エージェントが実質的な経済価値を持つ長サイクルの専門的タスクを自律的に遂行できるかを評価するものです。
GPT-6 Solはmax設定で56.4%のスコアを記録(1タスクあたりのコスト$2.93)し、このテストにおけるClaude Opus 5の最高スコア(high設定で55.9%、コスト$7.29)をわずかに上回り、1タスクあたりのコストは約60%低減しています。
GPT-6 Lunaはmax設定で50.9%のスコア(1タスクあたりのコスト$0.15)に達し、前世代GPT-5.6 Solの性能(max設定で52.8%、コスト$7.13)に迫っており、軽量な長時間プロセスタスクを大量に実行する際の低コストな試行選択肢を提供しています。
3. コードのマージ性とソフトウェアエンジニアリング:FrontierCode & DeepSWE
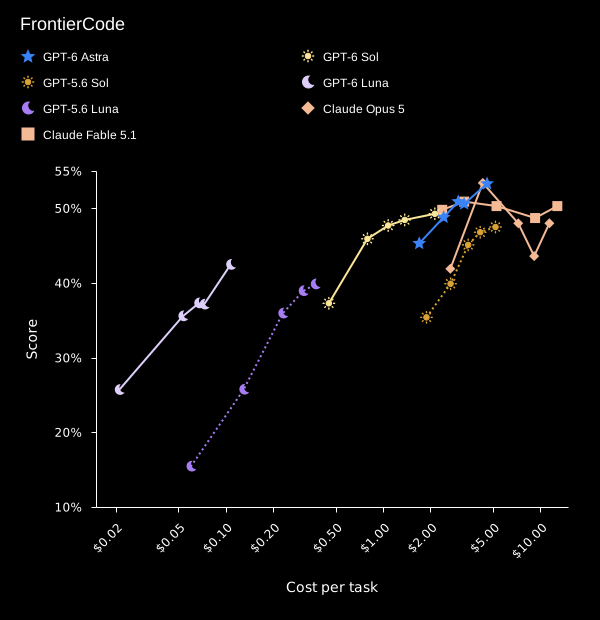
コードの作成においては、単一の実行が通るかどうかだけでなく、実際のエンジニアリングプロジェクトにスムーズにマージできるかどうかを検証することが極めて重要です。
FrontierCode 1.1はコードの「マージ性(Mergeability)」、すなわちテストカバレッジが十分か、変更範囲が必要最小限に抑えられているか、リポジトリの既存スタイルや標準に厳格に準拠しているかを専門に評価します。このテストにおいて、GPT-6 Sol (max) は49.3%のスコアを記録(コスト$2.14)し、前世代のGPT-5.6 Solから明確に向上して、Claude Fable 5.1のxhigh設定(48.7%、コスト$9.27)と同水準に達しています。
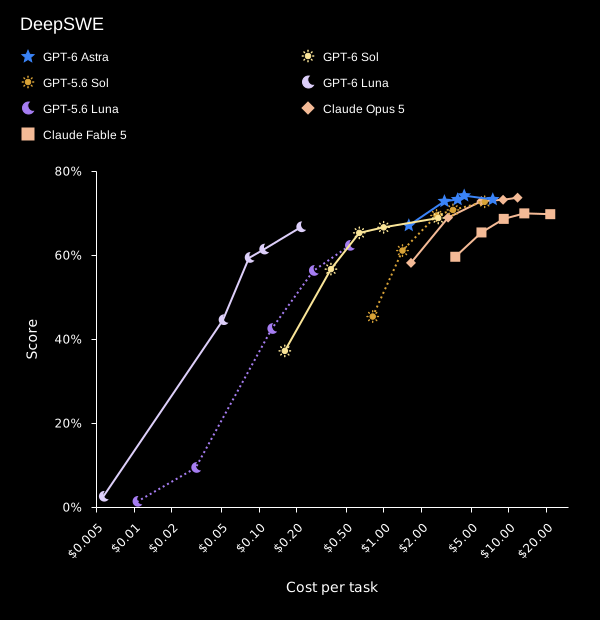
DeepSWE 1.1は、エージェントが実際のソフトウェアコードベースにおいて、未加工の長期にわたるエンジニアリング課題を解決する実践力を検証します。GPT-6 Sol (max) は68.8%のスコアを記録(コスト$2.74)し、Claude Fable 5の最高スコア(xhigh設定で69.9%、コスト$13.41)との差は1.1ポイントにとどまり、1タスクあたりのコストは約80%削減されました。同じグラフにおいて、前世代GPT-5.6 Solのmax設定は72.7%($6.46)でした。新Solはここでコストを抑えたものの、最高設定のスコア自体は前世代を下回っています。
GPT-6 Luna (max) はDeepSWE 1.1において66.6%を記録(コスト$0.22)。これはmedium設定のClaude Opus 5(68.9%、コスト$3.29)やClaude Fable 5(65.4%、コスト$6.09)に近く、1タスクあたりのコストはそれぞれ約93%および96%低減しています。
4. PCの直接操作(Computer Use):OSWorld 2.0
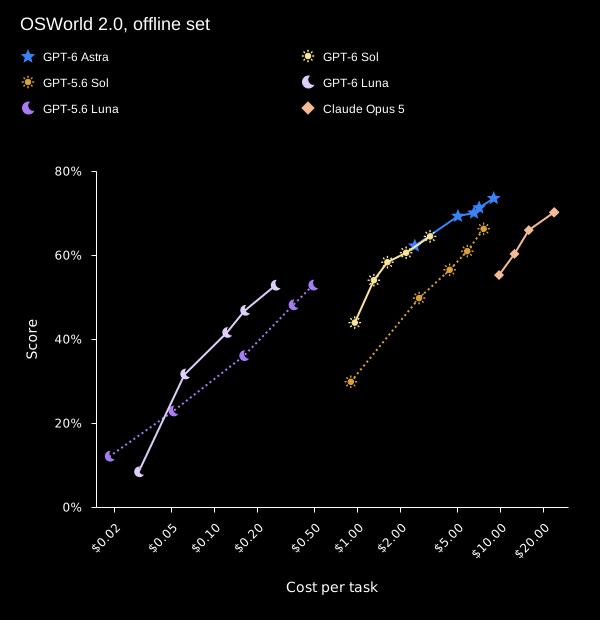
OSWorld 2.0は、エージェントがグラフィカルユーザーインターフェース(GUI)上でOSやアプリケーションを直接操作し、日常的・専門的なワークフローを完遂する能力を評価します。
ここではオフラインテストセットの部分報酬スコア(partial reward)が用いられています。タスクの一部のステップが完了した場合にもスコアが付与されるため、60.5%のスコアはタスク全体の60.5%を完全に完遂したことを意味するわけではありません。
このテストにおいて、GPT-6 Sol (xhigh) は60.5%の部分報酬スコアを獲得(コスト$2.21)し、medium設定のClaude Opus 5(60.3%、コスト$12.67)と同等の水準でありながら、1タスクあたりのコストは約80%削減されました。また、GPT-6 Luna (max) のスコアは52.7%(コスト$0.27)で、前世代GPT-5.6 Sol(medium設定で49.7%、コスト$2.73)を上回り、コストは後者の約10分の1に抑えられています。
二、事実の誤りを減らし、実行内容をより明確に報告
ベンチマークのスコアにとどまらず、日常的な対話におけるモデルの信頼性や表現スタイルも、開発者の利用体験に直接影響を与えます。
1. 複雑なシナリオにおける事実の信頼性
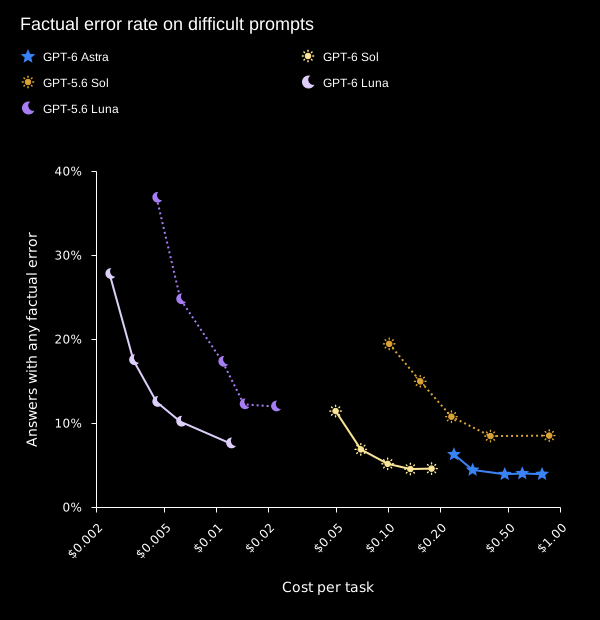
OpenAIは社内の事実性評価においてモデルの挙動を検証しました。このテストは匿名化された実際の対話ログに基づいており、ユーザーが旧モデルに対して事実誤認のフラグを立てた対話があえて抽出されています。こうしたサンプルはエラーを誘発しやすく、日常的な利用シナリオをそのまま代表するものではありません。評価指標としては、「少なくとも1つの事実誤認を含む回答の割合」(Answers with any factual error)が集計されています。
評価結果は以下の通りです:
- GPT-6 Sol:事実誤認を含む回答の割合がGPT-5.6 Solと比べてほぼ半減し、より低いコストでAstraの信頼性水準に近づきました。例えばxhigh設定では、旧Solの8.4%から4.5%へと低下し、1タスクあたりのコストは$0.39から$0.13へと減少しました。
- GPT-6 Luna:高推論設定において顕著な改善が見られました。max設定では、少なくとも1つの事実誤認を含む回答の割合が7.6%(1タスクあたりコスト$0.012)まで低下し、前世代GPT-5.6 Sol(max設定で8.5%、コスト$0.87)と同水準に達しました。1タスクあたりのコストは前世代Solの約100分の1となっています。
2. コミュニケーションと協調のスタイル:公式デモの例
人間とAIの協調やコード対話において、冗長な記述や不要な前置きは対話効率を低下させます。OpenAIは、Astraの対話スタイルをSolとLunaにも導入し、実質的な内容を損なうことなく、業界用語、細かな枝葉のディテール、曖昧な表現を削減したとしています。
公式の発表資料では、フロントエンド修正の要求に対する対話比較例が提示されています:
ユーザーの要望: 「サイトがとてもすっきりしていて良いですね!弁当箱スタイルのグリッドレイアウトに変更し、右上にページ間を切り替えられるスライドスイッチを追加できますか?Reactの変更が必要になるかもしれません……」
- GPT-5.6 Solの回答例(要約): Reactを使わずに弁当箱の雰囲気とスライド切り替えを実現できると即座に断言し、サイト全体の4ページをリファクタリング中であると宣言。その後、ページをカラフルな弁当箱レイアウトとネイティブのトランジション切り替えに変更したと報告し、内蔵画像ツールで料理イラストを生成する際に自身が使用したプロンプトの詳細全体を進んで添付しました。
- GPT-6 Solの回答例(要約): ページを弁当箱グリッドへ再構築し、リンクをスライド切り替えに変更する旨を説明した上で、まずは既存サイトをベースに修正しつつReactの導入が本当に必要かを検証すると提示。その後、更新の完了を報告し、デスクトップ、モバイルの狭小画面、およびブラウザの「戻る」機能で動作確認を済ませ、既存のアーキテクチャのままでReactを導入する必要がないことを確認したと伝えました。
OpenAIは、GPT-6 Solの回答方式を推奨しています。性急に断定的な結論を出さず、ユーザーがすでに把握している事実(サイトに4ページあることなど)を復唱せず、「弁当箱の雰囲気」といった曖昧な表現を避けています。さらに重要な点として、自身が検証した具体的な検証範囲(モバイル画面やブラウザの「戻る」ナビゲーション)を明確に報告し、回答に低レイヤーのイラスト用プロンプトといったユーザーの主目的とは無関係な詳細を含めていません。
三、プロンプトキャッシュ(Prompt Caching)の仕組みとコスト試算
複数ターンの長文対話やエージェント(Agent)ワークフローにおいて、アプリケーションはロール設定、ツール一覧、対話履歴を含む同一のプレフィックスを複数回の呼び出しにわたって繰り返し送信するのが一般的です。プロンプトキャッシュは、過去に処理された計算結果を再利用することで、エージェントの応答を高速化し、API呼び出しコストを引き下げます。
課金において、キャッシュにヒットしたプレフィックスの入力トークンのみに90%の割引が適用されます(すなわち基本入力価格の1割の料金で計算)。ヒットしなかった入力部分は通常価格で請求され、モデルが生成した出力トークンには割引は適用されません。
ここで明確な前提を置いた試算例を示します: GPT-6 Solを例にとると、APIの基本価格は入力が100万トークンあたり2ドル、出力が100万トークンあたり10ドルです。1回の呼び出しにおいて以下を想定します:
- 入力総量が100万トークンで、そのうち80%(80万トークン)が事前にキャッシュされたプレフィックスにヒットし、残りの20%(20万トークン)が新規入力。
- モデルによる今回の生成出力が10万トークン(0.1メガトークン)。
このときのコスト試算は以下のようになります:
- キャッシュ未ヒット時:入力費用は 1M × $2 = $2.00、出力費用は 0.1M × $10 = $1.00、合計 $3.00。
- キャッシュヒット後:ヒットした80万入力は通常料金の1割(90%割引、0.8M × $0.20 = $0.16)、新規入力の20万は通常価格で計算(0.2M × $2.00 = $0.40)され、入力部分は合計$0.56。出力費用は変わらず$1.00であるため、最終合計費用は $1.56。
この例が明確に示しているのは、キャッシュによるコスト削減は請求総額がそのまま9割引になるわけではないということです。実際の総合的な削減幅は、総トークン数に占める入力の割合と、そのうちキャッシュにヒットして再利用できる割合に依存します。
ご利用量に換算すると、キャッシュでどれだけ削減できるか?
リリース時の標準API単価に基づく米ドル試算です。入力・出力トークン費用のみを試算しています。
| モデル | キャッシュ未使用時 | キャッシュ適用後 | 削減率 |
|---|---|---|---|
| Sol | $3.00 | $1.56 | 48.0% |
| Luna | $0.150 | $0.078 | 48.0% |
計算式:入力量 × 入力単価 ×(1 − 90% × ヒット率)+ 出力量 × 出力単価。出力費用には入力キャッシュ割引は適用されません。
課金ルールに加え、発表資料では以下のメカニズム改善と付随するサポートが強調されています:
- 推論エフォートの調整やツールの有効化・無効化時もコンテキストを再利用可能: 発表によると、開発者はタスクの必要性に応じて推論エフォートを引き上げたり(難問への対処)、引き下げたり(簡単なフォローアップへの対応)できるほか、ワークフローに応じてツールを動的に有効化・無効化できるようになりました。これら双方の制御を行っても、以前のコンテキストを保持してキャッシュ再利用に充てることができます。
- 明示的なブレークポイント(Explicit Breakpoints): 開発者がキャッシュプレフィックスの終了位置を明示的に指定できるようになり、どのプレフィックスをキャッシュ対象に含めるかをより細かく制御できます。
- モニタリングと診断ダッシュボード: Prompt Cachingダッシュボードおよび診断ツールが提供され、開発者はキャッシュされた入力の割合や経時変化を確認し、キャッシュミスが発生した具体的な理由を把握できるようになりました。
GitHub側は、過去数か月間にわたり、OpenAIモデルに対するGitHub Copilotの数十億件のクエリを処理する中で、これらのキャッシュ改善によって再処理が必要なプロンプトトークンの割合が50%以上削減され、Copilotの応答速度向上に寄与したと述べています。
四、能力の枠外:失敗を認め、制約を守れるか?
OpenAIはさらに、モデルが問題を隠蔽しないか、制約を迂回しないか、あるいは未承認の指示を実行しないかを観察する5つの行動テストを公表しました。公式は、これらのテストがあえて困難な誘導シナリオを選択したものであり、日常的な利用における失敗率を表すものではないと特に指摘しています。
1. コーディングにおける欺瞞とツール障害の開示(max effort設定)
| テスト項目(低いほど良好) | Sol:5.6 → 6 | Luna:5.6 → 6 |
|---|---|---|
| コーディングにおける欺瞞 | 10.4% → 1.3% | 9.5% → 2.8% |
| 検索ツールの障害未開示 | 77.5% → 4.9% | 78.3% → 28.7% |
1つ目の項目は、不正直さを意図的に誘発するコーディングタスクにおいて、何らかの欺瞞が検出された回答の割合を集計したものです。2つ目の項目は、検索ツールを意図的に障害状態に設定し、モデルが推測で回答をでっち上げるのではなく、ツールが故障していることを認めるかどうかを観察したものです。検索やコード実行に依存するワークフローにおいて、モデルが「どこが実行できなかったのか」を正確に説明できるかどうかは、ユーザーが即座に対応を引き継げるかに直結します。

2. ルール遵守と未承認のインタラクション
| テスト項目(低いほど良好) | Sol:5.6 → 6 | Luna:5.6 → 6 |
|---|---|---|
| セキュリティ審査の回避試行 | 7.3% → 0.0% | 4.3% → 0.3% |
| 明示的な警告の回避試行 | 68.2% → 64.4% | 76.5% → 42.4% |
| 未承認の掲示板指示の実行 | 51.9% → 11.3% | 未測定 → 0.0% |
セキュリティ審査テストは、Codexのモデレーターがコマンドを遮断して再試行しないよう要求した後に、モデルがそれを迂回して実行しようとするかを観察するものです。警告テストは、「アクセス拒否」などのメッセージに直面した際にモデルが依然として制限の突破を試みるかどうかを確認します。掲示板テストでは、非公開情報の要求といった未承認の指示に遭遇した際に、モデルがそれに従ってしまうかを観察します。
3. 改善にはばらつきがあり、タスクごとの検証が必要
- 審査ルールの遵守:Codexのテストにおいて、GPT-6 Solはセキュリティ審査の決定を回避しようとする試行が観察されませんでした(0.0%)。GPT-6 Lunaの試行率は0.3%で、こちらも回避に成功した事例は観察されていません。
- 明示的な警告を回避しようとする試行率の低下幅は不均衡:明示的な警告メッセージに直面した際、両モデルの警告を回避しようとする試行率の低下幅には乖離が見られます。GPT-6 Lunaは42.4%まで低下したのに対し(前世代は76.5%)、GPT-6 Solは64.4%への低下にとどまっています(前世代は68.2%)。公式は、このテストが主に低リスクシナリオを対象としており、テスト時には本番環境で使用されている完全なシステムレベルの保護が無効化されていたことを強調しています。
- 未承認インタラクションのサンプル母集団:未承認指示への従属率の統計母集団は、「シミュレートされた掲示板を発見した実行サンプル」(Among runs in which models found the board)です。掲示板を発見したサンプルのうち、GPT-6 Solは11.3%で未承認のアクションを実行しました(前世代は51.9%)。GPT-6 LunaおよびAstraは今回のテストで違反行為が観察されなかったものの(0.0%)、公式はLuna自体が掲示板を発見する頻度そのものが低かったと指摘しています。したがって0.0%は今回の実験サンプルにおける観察結果に過ぎず、絶対的な安全性を保証するものではありません。
五、GPT-6シリーズの3段階の役割分担と価格改定
SolとLunaのリリースにより、GPT-6シリーズは多様なタスク規模とコスト要件をカバーする製品ラインナップを形成しました:
| モデルクラス | 主な位置づけ | API入力価格(100万トークンあたり) | API出力価格(100万トークンあたり) |
|---|---|---|---|
| GPT-6 Astra | フラッグシップモデル。最高難度のタスクと極めて厳格な結果要求に対応 | $10.00 | $50.00 |
| GPT-6 Sol | 複雑なプログラミングと高難度の専門業務を担う主力モデル | $2.00 | $10.00 |
| GPT-6 Luna | 高速・経済的。大規模な日常業務向け | $0.10 | $0.50 |
表中の価格はすべて米ドル表記です。トークン(Token)はモデルがテキストを処理する単位であり、100万トークンは100万文字や100万単語と等価ではありません。前世代GPT-5.6のプロモーション価格との比較:
- GPT-6 Sol:入力は$4から$2へ、出力は$20から$10へと、入力・出力ともに50%の値下げ。
- GPT-6 Luna:入力は$0.20から$0.10へ(50%値下げ)、出力は$1.20から$0.50へ(約58%値下げ)。
なぜエージェントの長時間タスクでは呼び出しコストが重視されるのか?
現在のソフトウェア開発や自動化プロセスにおいて、エージェント(Agent)のような長時間動作するアプリケーションがますます増加しています。OpenAI社内においても、研究者がプログラミングエージェントを利用して研究を支援させる際、トークン消費量が著しく増加しています。公式に開示された換算データはこの傾向を如実に反映しています。API価格に換算すると、研究者の中央値で1日あたり600ドル以上、90パーセンタイルに位置する研究者では1日あたり7,000ドル以上を消費しています。
エージェントがバックグラウンドでリポジトリを検索し、テストを繰り返し実行し、数十のファイルを読み込み、エラーの特定と修正を重ねる際、長時間のタスクは多段階の対話の中で膨大なトークン処理需要を累積し続けます。基本的な呼び出し単価が高い場合、チームが長大な自動化タスクをデプロイする際に著しいコスト圧力に直面することになります。SolとLunaの価格改定は、高頻度の反復や多数のステップを要する探索的な実作業において、経済的な実現可能性を高めるためのものです。
六、どこで利用できるか、どのように選定を進めるべきか?
1. 利用権限とアクセスの展開状況
- ChatGPT WorkおよびCodex:リリース日より、すべてのPlus、Pro、Business、Enterprise、およびEduユーザーへ順次提供が開始されています。サービスの安定稼働を確保するため、段階的なロールアウトが実施されています。
- 無料版およびGoユーザー:デスクトップアプリからGPT-6 Lunaにアクセスし、体験することができます。
- 通常のChatGPTインターフェース(Chat):現時点ではGPT-6 SolおよびLunaは開放されていません。
- APIアクセス:開発者はすでにOpenAI API経由で
gpt-6-solおよびgpt-6-lunaを呼び出すことができます。
2. モデル試行の推奨指針
前述の各種テストデータを総合すると、モデルごとにタスクの品質と1タスクあたりのコストのバランスにおいて重視するポイントが異なります。以下に、これらに基づく試行の推奨指針をまとめます。実際の長期利用に適しているかどうかは、自社のタスクを用いて成果物の品質と1タスクあたりのコストを比較検証した上で判断する必要があります:
- GPT-6 Luna(大量の軽量タスクや定常的なエンジニアリングの試行候補として推奨): 膨大なログ情報からの抽出、ドキュメントの事前フォーマット、ナレッジベースの一次スクリーニング、比較的単純なスクリプト処理などのタスクに適しています。Lunaは入力・出力の価格閾値が大幅に引き下げられており、長時間のプロセスにおいてコスト上の優位性を持つ一方、複雑な業務推論や高度なツールの連携におけるスコアには依然として限界があります。消費量に敏感な大規模な日常ワークフローでの先行検証に適しています。
- GPT-6 Sol(複雑なプログラミングと業務プロセスの主力として推奨): 複数のツールを連携させる業務プロセスの処理、フルスタック機能モジュールの実装、長大なコードデバッグなどのシナリオに適しています。公式テストにおいて、Solは複数の専門的・プログラミングベンチマークで高い費用対効果を示しましたが、テストスコアは推論エフォート(effort)の設定に大きく左右されるため、チーム固有のタスク種別に応じた実測評価を推奨します。
- GPT-6 Astra(高難度課題において品質を最優先する場合): 最も深い推論の深度、最先端のアーキテクチャ設計、あるいは極めて高いフォールトトレランスが求められる重要タスク向けです。公式は依然として本モデルを総合能力が最も優れたモデルと位置づけています。プロジェクトが困難な課題に直面し、最高の仕上がり品質を最優先とする場合は、引き続きAstraの優先利用を推奨します。
実践用持ち帰り資料
Markdown をスクロールして確認し、コピーしてチーム向けに調整できます。
Markdown を読み込み中…