Harvey が 1 億トークン超の合成法律事務所をオープンソース化 — 顧客 46 社、社内成果物ファイル約 1 万点
- Harvey は架空の法律事務所をゼロから作り、266 件分の全ファイルを GitHub に公開。AI にその中から答えを探させた。
- 最強の 2 モデルは個別チェックポイントで 7〜8 割正解するが、「1 つも漏らさない」となると、正解率は 24.4% と 36.0% にまで落ち込む。
- 正解が 16 項目を超える設問では全問正解率はゼロに。一方で、難しい設問でモデルが「バカになった」わけではない。
仮想事務所、それでも規模は本物
法律 AI 企業の Harvey が、法律事務所 1 軒分の全アーカイブをオープンソース化しました。案件 266 件、Word 文書 9,288 点、総量 1.08 億トークンを GitHub に公開し、AI がその中から答えを探すための設問を 250 問用意しています。アーカイブ、設問、採点基準、スコア結果まですべて公開され、検証可能です。
なぜこのデータセットを作ったのか。実際の法律事務所では、弁護士の資料調査は非常に骨が折れます。ファイルは膨大で、重要な情報の多くに決まったキーワードがなく、検索できないからです。これまでの法律ベンチマークは「契約書と設問が与えられ、回答する」という形式で、材料がすべて手元にあり、この課題を測れませんでした。このデータセットは、Harvey の法律 AI エージェント用評価セット LAB の新しい拡張パックです。
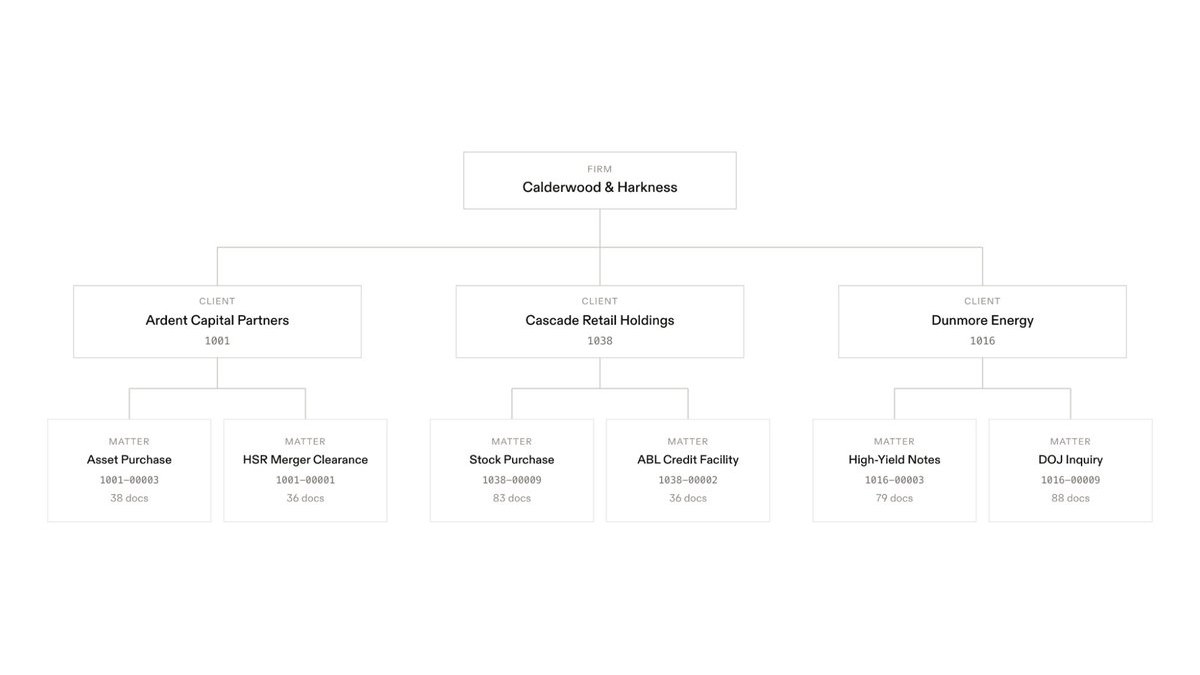
まず、法律事務所の仕事がどう組織されているかを理解する必要があります。データ全体がこの構造に基づいて作られているからです。事務所の仕事は、顧客(誰への仕事か)と matter(その顧客への具体的な仕事 1 件)という 2 つの関係で成り立っています。46 の顧客は 15 の業務分野にまたがり、1 つの顧客が複数の matter を持ち、1 つの matter に複数の分野の弁護士が関わることもあります。
この 46 の顧客には企業も個人も含まれており、わざと多様性を持たせています。PE ファンドの求める法律サービスと、産業メーカーのそれとは全く異なります。顧客が多様であればあるほど、カバーできる業務の種類も増えます。266 件の案件には、すでに完了したものと、進行中のものがあります。
法律事務所が特定の顧客に対して行う具体的な仕事のこと。契約締結から完了までの全ファイルがこの単位でまとめられます。プロジェクト管理ツールの「プロジェクト」フォルダのようなものですが、事務所ではこれが請求単位であり、ファイルキャビネットの 1 区画でもあります。フォルダ番号は「顧客番号-連番」で、1003-00001 は 1003 番の顧客の最初の案件です。

1 つの案件のファイルにはライフサイクル全体が含まれます。受注経緯(委任)、段階ごとの進め方、途中の重要な決定、最終的な結果です。案件内部はフォルダで分類されていますが、わざと標準化していません。案件の種類、パートナーの習慣、実際の進行状況によって、フォルダ構成は案件ごとに異なります。実際の事務所もこんなもので、ファイル整理の決まりなど誰も定めていません。
各ファイルは約 1,000 トークンのスクリプトから生成
これだけの量のアーカイブを 1 つずつ手書きするのは不可能です。Harvey の方法はこうです。各案件について、まず約 1,000 トークンの「スクリプト」を作成します。そこには、どの顧客への仕事か、プロジェクトの概要、という 2 点が記されます。そして、そのスクリプトに具体的な事実を埋め込みます。細かい事実(「この契約のエスクローは 10%」「競業避止義務は 2 年間」など)もあれば、構造的な事実(「この訴訟は却下された」「和解した」など)もあります。
巧みな点は最後のステップにあります。正解を決めるのに、1,000 トークンのスクリプトを見るだけでよく、生成された膨大なファイルを読む必要がないということ。そうでなければ、この 1.08 億トークンを誰が審査するのでしょうか。
埋め込まれた事実ポイントには、もう 1 つの役割があります。それが採点用の正解そのものになるのです。一方、AI が回答するときには、そのどれも見えません。手元にあるのは Word 文書の山だけで、検索と推論を駆使して、散らばった手がかりを 1 つずつ見つけ出し、答えを組み立てる必要があります。

合成データはどのくらいリアルなのでしょうか。実際に 1 つダウンロードして確認しました。second-request-strategy-memo.docx、66KB、344 パラグラフ。完全な弁護士メモです。冒頭は「秘密保持・弁護士業務成果物」とされ、本文では 15 U.S.C. § 18a を引用。2024 年の申告基準額 1 億 1,950 万ドル、手数料 16 万ドルと明記されています。6 月 4 日に買収契約締結、6 月 18 日に申告、7 月 8 日に当局から資料要求、7 月 16 日に正式な質問状送付というスケジュールは日にち単位で正確で、人名・会社名もすべて整合しています。
The initial 30-day statutory waiting period under the HSR Act was set to expire on July 18, 2024. However, on July 8, 2024, the FTC's Bureau of Competition, Mergers IV Division issued a voluntary access letter … We produced 23 supplemental documents on July 10, 2024, in response to that voluntary access letter.
設問 250 問は、弁護士が日常的に本当に尋ねる内容
アーカイブができたところで、設問はどのようなものか。この 250 問は、事務所が自社の文書管理システムに普段投げかけるような要求を模しています。ですから、すべて素朴な一言で、パートナーが朝、デスクの前を通りがかりに何気なく言い付けるような体裁です。

リポジトリから実際の設問ファイルを読んでみました。第 1 問の原文はこれです。「独占禁止法グループで規制審査の対象となった取引を整理しています。HSR の二次審査請求を受けたすべての案件を、関連する質問状のやり取りとともにリストアップしてください。」
米国の M&A は一定規模以上になると規制当局への申告が必要です。当局が競争に影響を与える可能性があると判断した場合、さらに詳細な資料を求める正式な文書を発出し、取引は審査が終わるまで停止したままとなります。ビザ申請で追加書類を求められる「追加書類請求(RFE)」のようなもので、拒否ではありませんが、この時点から旅程に確定期限がなくなります。
この設問の正解は 11 項目です。
最後の項目に注目してください。出題者自身が、どの案件が該当し、どれが該当しないかを、わざわざ説明文を追加して定義しているのです。
しかしアーカイブに目次はなく、AI は文書を 1 つずつ読むしかない
もう 1 つ、はっきりさせておくべきことがあります。各設問に対して、AI はファイルシステム全体を相手にします。266 件の案件がすべてそこにあり、どの案件を調べるべきか、事前に教えてくれる人はいません。
Agent が使えるツールは 6 つ。コマンド実行、ファイル読み取り、ファイル書き込み、ファイル編集、ファイル名での検索、内容での検索です。grep は使えます。問題は、検索する語がないことです。
このファイルシステムを確認しました。dms/matters/ の下には、266 個の数字だけのディレクトリがあります。インデックスも、顧客名簿も、業務分野の対応表も、メタデータファイルも一切ありません。1003 番の顧客が何という名前で、どの業務分野に属し、その案件が最終的にどうなったかを知るには、Word 文書を 1 つずつ開いて本文を読むしかありません。
「独占禁止法グループの案件で二次審査請求を受けたものは?」という設問。「second request」で検索すれば大量にヒットしますが、「この案件が独占禁止法グループ管轄かどうか」を示すフィールドは、アーカイブのどこにも存在しません。ファイルを読了して初めて判断できるのです。前節の「別の 3 件は含めても減点しない」という注記は、この境界線が人間でさえ説明に苦労するからこそ、付け加えられているのです。
しかもルールは「1 つ漏れたら 0 点」
各設問の正解は、合否のみのチェックポイントに分割され、AI 審判(claude-sonnet-4-6、温度 0、キーワード一致ではなく意味の一致のみを見る)が 1 つずつ判定します。すべて通過して初めて 1 点。1 つでも漏れたら 0 点で、部分点はありません。このルールを公式は all-pass(全問正解制)と呼んでいます。
なぜここまで厳しいのか。その理由が示されています。
法務の実際の納品シーンにおいて、平均点は誤解を招きます。デューデリジェンス・メモが問題の 95% を捉え、実質的な 1 つを見落とした場合、それは「95% 役に立つ」のではなく、間違いです。 Harvey LAB 評価方法ドキュメント
その見落とされた問題が、取引価格を変えたり、クロージング前にすべてをやり直さざるを得なくなったり、クロージング後に発覚したりする可能性があります。
飛行機の離陸前チェックリストのようなものです。99 項目チェックして、1 項目忘れたら、その飛行機は「99% 飛べる」のではありません。「飛べない」のです。
結果、最強の 2 モデルとも不合格
ルールの説明は終わり。スコアを見てみましょう。Harvey は LAB の標準実行フレームワークで 2 つのモデルを実行しました。
| 指標 | opus-4.8-high | gpt-5.6-sol-high |
|---|---|---|
| 個別チェックポイント通過率 | 71.7% | 79.1% |
| 全問正解率 | 24.4% | 36.0% |
| 1問あたり中央所要時間 | 475 秒 | 406 秒 |
| 1問あたり中央コスト | $1.26 | $1.66 |

個別チェックポイントでは 7〜8 割正解し、一見良さそうです。しかし「この設問で 1 つも漏らさなかった」という基準に変えると、2〜3 割しか残りません。475 秒は約 8 分、設問 1 問あたりです。中央コストで試算すると、250 問を 1 周走らせるのに約 300 ドル強かかります。2 つのモデルが解ける簡単な問題はほぼ重なっており、それぞれが相手には解けない難しい問題もいくつか解けています。
モデルは解ける問題は解くが、「1 つも漏らさない」となると崩れる
総得点だけでは不十分です。この 250 問を「正解が何項目あるか」で 4 つの層に分けて再集計すると、2 つの曲線は正反対の動きをします。
もう 1 つのモデル gpt-5.6-sol はもう少し持ちこたえ、全問正解率は約 51% → 27% → 約 20% と下がりますが、「26 項目以上」の層では、やはり 0% です。
直感的に計算すればわかります。項目通過率 71.7% で、26 項目すべて正解する確率は、0.717 の 26 乗、およそ 1 万分の 2 です。難しい設問でモデルが「バカになった」わけではありません。実際に効いているのは「全問正解」という要求そのもの。チェックリストが長くなるほど、完全正解の確率は急速に下がるのです。(この計算は読者の直感のための概算です。チェックポイントは完全に独立しているわけではなく、1 つの案件を見つければ複数の項目を同時に満たせることもあるため、実際の確率はこのように単純計算できません。)

病根は、AI が「探し終えたか」を自分で判断できないこと
では、一体どこに問題があるのでしょうか。Harvey は Agent の全プロセスを振り返り、直感に反する結論を導き出しました。
モデルは、見つけたものに対する推論はほぼ正しい。間違いは、関連する情報をすべて見つけられなかったことにある。そしてこれは検索戦略の問題ではありません。核となる情報は安定して見つけられ、基準の一部は満たせるのです。欠けているのは「まだ探し続けるべきかどうか」の判断力です。
この欠陥は「リストアップして」というタイプの設問で特に致命的です。上記のグラフで最も急激に落ち込んでいる部分が、まさにこのタイプの設問です。
Harvey がここから導き出した根本原因は、Agent が「この文書庫に一体何があるのか」というモデルを頭の中に構築していないため、自分の検索が十分に徹底されたかどうかを判断する根拠がない、というものです。
それは、入社初日のアシスタントのようなものです。手渡されたファイルはどれも読めて、分析も正しい。しかし、文書庫に全部で何があるのかを知らないので、自分がすべて確認し終えたかどうかが永遠にわかりません。「全部そろえたか?」と聞かれても、「私が見つけたものは、ここに全部あります」としか言えないのです。
Harvey の解決策:まずアーカイブをインデックスとして読む
法律業務の本質は、目の前の問題が過去の仕事とどう関係するかを判断することです。どの先例がこの顧客に適用されるか、市場の標準的な慣行はどうか。そして今日の Agent は、タスクを 1 つ受けるたびに、この知識をゼロから導き出しています。このやり方は、エンタープライズ規模の知識量では、コストが高く、性能も弱いのです。
彼らが注目しているのはこの方向性です。Agent に、まずアーカイブを自分自身のインデックスとして読み込ませてから、回答させる。この環境は持続的で、同じアーカイブが 250 回使われるため、一度だけの「読解コスト」は十分に回収できます。この分野ではさらに多くの成果が公開される予定ですが、協業先である Engram は AI 記憶層を手がける企業で、今年 6 月に 9,800 万ドルの資金調達を完了したばかりです。
Harvey 自身も、このデータセットの限界を明確に述べています。現在は法律事務所の業務の一部のみをカバーしており、250 問も弁護士が尋ねる質問の一部にすぎず、今後も追加される予定です。また、実行記録を見ると、コストと所要時間はアーカイブの規模に応じて増加し続けます。そして、実際のエンタープライズ規模の文書庫は、この仮想事務所より数桁も大きくなる可能性があります。
最強 AI 2 つでも、仮想法律事務所の全アーカイブから完璧な答えは組み立てられない
Harvey が作った 9,288 文書の仮想事務所で AI を試験。2 つの最強モデルがどこで負けたかを、このページの図で説明します
↓ 一枚で読了 · 動く図あり
Harvey は存在しない法律事務所をゼロから作り、その全アーカイブを GitHub に公開。設問 250 問を用意して、AI にその中から答えを探させました。
1 つの顧客が複数の案件を持つことも、1 つの案件に複数の業務グループが関わることもある。この構造は、実際の事務所の混沌を模しており、フォルダは意図的に不統一です。
出題者は AI に検索ツールを与えましたが、検索する語がないのが問題です。ディレクトリの下には数字だけのフォルダが 266 個あり、インデックスも顧客名簿も説明もありません。案件が誰のものか、どの業務グループの管轄かを知るには、文書を開いて本文を読むしかありません。
出題者自身も、正解に「どの案件が該当し、どれが該当しないか」をわざわざ注記として追加しているほどです。
正解は細かいチェックポイントに分割され、AI 審判が 1 つずつ判定します。すべて通過して初めて正解となり、1 つでも漏れたら 0 点。中間点はありません。
Harvey は最強の 2 モデル、opus-4.8-high と gpt-5.6-sol-high を実行しました。個別チェックポイントでは 7〜8 割正解しますが、「1 つも漏らさない」となると、2〜3 割しか残りません。
上記スコアは Harvey 自己評価による LAB 評価フレームワークの数値で、第三者による再現はまだありません。1 問あたり中央で 400 秒強、1〜2 ドルのコストがかかります。
Harvey が AI の操作記録を分析したところ、見つけたものに対する推論はほぼ正しい。間違いは関連情報を全て見つけられなかったこと。根底には「この文書庫に全部で何があるか」の把握がなく、検索が十分か判断できない、という問題があります。
解決策は、AI にまずアーカイブをインデックス・要約・記憶として読み込ませてから回答させること。同じアーカイブに 250 回尋ねるのだから、この初期コストは分散できます。
- × 顧客名簿
- × 業務分野表
- × 何の説明もなし