IBM、世界初の0.7ナノメートルチップを発表 爪ほどのサイズに約1000億個のトランジスタ
世界初の sub-1 ナノメートル・ロジックチップ
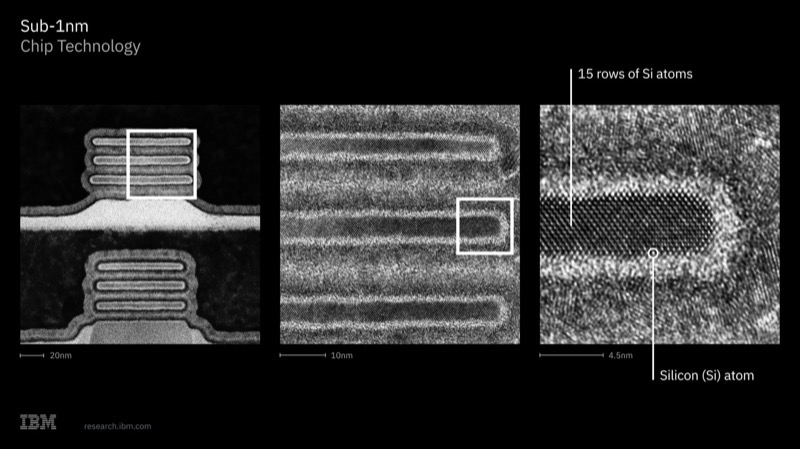
40年以上にわたり、チップはトランジスタをどんどん小さくすることで進化してきた。今やそのサイズは原子単位に迫っている。1ナノメートルの壁を初めて突破したわけだが、IBM が使った手はさらに小さくすることではなく、トランジスタを縦に積み上げることだった。
- IBM が世界初の sub-1nm チップ技術を発表。ノード名は0.7ナノメートル(7オングストローム)、爪ほどのサイズに約1000億個のトランジスタを集積し、密度は2021年の2nmチップの約2倍。
- 核心となる革新は新トランジスタアーキテクチャ nanostack:平面サイズを縮小するのではなく、トランジスタを3次元に垂直積層・千鳥配置する、業界初の3次元 nanosheet アーキテクチャ。
- 3つの鍵となる手法:積層+千鳥配置、3D シーケンシャル集積、層ごとに異なる材料で個別最適化。
- 機能する CMOS インバータなどの実験で製造可能性を実証済み。性能+50%またはエネルギー効率+70%は2nm比の予測値で、どちらか一方しか選べない。
- 生成AI、クラウド基盤、次世代デバイスをターゲットに、IBM は最短5年での量産を見込み、ロードマップは少なくとも10年先まで微細化を見据える。
この革新を理解するには、まずこの壁がどれほど厚いかを知る必要がある
1ナノメートルを突破することがマイルストーンとされるのは、これまでのやり方が本当に行き詰まっていたからだ。数十年間、チップの性能を上げる方法はずっとシンプルだった。通電のオンオフを担う最小のスイッチであるトランジスタを、どんどん小さくする。同じチップにより多く詰め込めれば、演算力も省エネ性能も上がる。問題は、トランジスタのサイズが今や単一原子のスケールに迫っていることだ。平面上でこれ以上縮小する余地は、物理的な限界にどんどん近づいている。「さらに小さく」という従来の道は、もう行き止まりに近い。
IBM は今回、旧来の路線を力ずくで突き進むのではなく、次元を変えた。平面で詰め込めないなら、垂直方向に積み上げればいい。下の図で4ステップをクリックして、同じ面積のままトランジスタ数をどう倍増させたのかを見てみよう。
従来の方法:トランジスタは同一平面上に並べられ、数を増やすには各々を小さくするしかなかった。だが今や「原子の壁」にぶつかり、縮小の余地はほとんど残っていない。
nanostack の第一の手:積み上げて、しかもずらして配置。元の層の上にもう1層トランジスタを重ね、上下層を千鳥状にずらす(IBM は staggered=千鳥チャネルと呼ぶ)。占有面積はそのままに、数は倍になる。
第二の手:層ごとに異なる材料を使う。上層のトランジスタは下層と違う材料で作れる。それぞれ最適な材料を選び、性能と消費電力を独立に最適化できる。これは平面アーキテクチャでは不可能だった。
結果:同じ爪ほどのサイズに約1000億個のトランジスタを集積、密度は2021年の2nmチップの約2倍に。
同じ敷地の平屋を、階をずらして重ねる多層住宅に建て替えるようなもの。敷地面積(チップ面積)は変わらないまま、上に積むことでより多くの住人(トランジスタ)を収容し、しかも各階を必要に応じて違う間取り(異なる材料)に仕上げられる。
IBM はどう実現したのか:nanostack の3つの手
トランジスタを縦に積み、しかも互い違いに並べる
従来のアーキテクチャでは、トランジスタはすべて一つの平面に詰め込まれ、数を増やすには小型化するしかなかった。nanostack はトランジスタを垂直方向に3次元積層し、しかも上下層をstaggered(千鳥状)に配置する。同じ占有面積のまま、上に積むだけでより多く収容できる。これは業界で知られる限り最初の、3次元かつ nanosheet(ナノシート)ベースのトランジスタアーキテクチャだ。
千鳥配置は無作為に重ねているわけではない。ずらすことで上下層の接続、放熱、信号経路がより合理的に配置できる。VLSI 2026 で IBM が発表した論文は、まさにこの「千鳥チャネル」による SRAM セル設計について詳述したものだ。
2枚を貼り合わせるのではなく、層ごとに「集積」していく
チップを積み上げるうえで難しいのは「積む」こと自体ではなく、「いかに正確に、機能する形で積むか」だ。nanostack が使うのは 3D sequential integration(3D シーケンシャル集積)。すでに完成した下層の上に、上層のトランジスタを段階的に直接集積していく方式で、別々に作った2枚を位置合わせして貼り合わせるのではない。そのため上下層は自然に整合する。
この方式は超薄膜誘電体ボンディング(ultra-thin dielectric bonding)を使い、実験で完全な CMOS 集積を実証済みだ。できあがったのは設計図ではなく、正常にオン・オフする機能回路である。この一歩が「本当に製造できるのか」という核心を左右する。
積層した各層ごとに、それぞれ最適な材料を使う
平面アーキテクチャでは、すべてのトランジスタが同じ材料とプロセスを共用せざるを得ず、互いに妥協が必要だった。多層化すれば、各層ごとに異なる材料の組み合わせを選べる。上層と下層のトランジスタがそれぞれ最適な材料を選び、性能と消費電力を独立に最適化でき、互いの足を引っ張らない。
これは「積み上げる」ことで新たに得られる自由度であり、IBM がこれを「構造+材料の二重革新」と位置づける理由でもある。密度は空間を積んだ結果だけでなく、材料の階層化がもたらす性能・エネルギー効率の余地でもあるのだ。

すでに実験室で作られ、動作を確認済み
3つの実験はそれぞれ異なる点を証明している。
| 検証項目 | 何を明らかにしたか |
|---|---|
| 超薄膜誘電体ボンディングによる CMOS 集積 | 層と層を極薄の誘電体でつないで完全な CMOS を構成できる、つまり積層構造は本当に作れる |
| デュアルチャネル・エンジニアリング能力 | 積層構造の中で上下2層のチャネルを同時に制御できる、複数層の同時動作が可能 |
| 機能する CMOS インバータ | 最も基本的なロジックセルが正常にオン・オフでき、そのスイッチング性能も想定通りで、単に通電するだけではない |
さらに VLSI 2026 で IBM は、nanostack によって SRAM(チップ上の高速キャッシュ)を40%微細化できることを示した。SRAM の密度が高まれば、同じ面積により多くのキャッシュを積める。これは先進的な AI ワークロードが求める「膨大なデータ、高帯域幅」というニーズにぴったり合致し、AI チップへの直結ポイントとなる。
誰に役立つのか:0.7nm が生む価値
このチップがターゲットとするのは生成AI、クラウド基盤、そして次世代電子デバイスの演算需要だ。2nm と比較して、性能とエネルギー効率は「二者択一」の関係にあり、使い方次第でどちらか一方しか最大値を取れない。下の切り替えでその trade-off を体感してみよう。
同じ消費電力で、より速く計算できる。AI に置き換えれば、同じマシンでトレーニングと推論のスループットが上がり、大規模モデルがより速く動くということだ。
同じ性能で、より省電力になる。今日の AI データセンターが直面する最大のボトルネックの一つが電力と放熱であり、エネルギー効率の向上はこの痛点に直撃する。
密度とエネルギー効率の向上は、2つの場面で次のような意味を持つ。
密度が約2倍ということは、同じ面積でほぼ2倍の演算力を詰め込める、あるいは逆に、同じ演算力なら消費電力を大幅に下げられるということだ。AI のトレーニングと推論のコストと放熱は今、主に消費電力に律速されており、エネルギー効率の向上こそが最も価値がある。
同じバッテリーと筐体サイズのまま、スマートフォンや PC、エッジデバイスがより強力なローカル AI モデルを動かせるようになる、あるいはバッテリー持続時間をさらに伸ばせる。
重要な数字
以下はメーカーの予測またはロードマップであり、実測ではない:
| 数値 | 意味 |
|---|---|
| +50% | 性能向上(2nm比、予測値、エネルギー効率とは二者択一) |
| +70% | エネルギー効率向上(2nm比、予測値、性能とは二者択一) |
| 最短5年 | IBM が示した量産時期(ロードマップ) |
| 少なくとも10年 | プロセスロードマップが微細化を継続できる期間 |

IBM のプロセス微細化の歴史
研究はニューヨーク・オールバニの半導体研究拠点で行われており、ASML の High NA EUV 露光装置を近く導入予定。協力企業には Lam Research、東京エレクトロン、SCREEN が含まれる。

私たちはトランジスタを小さくしているだけではない。チップの作り方そのものを再発明しているのだ。 Jay Gambetta、IBM リサーチディレクター(IBM プレスリリース、2026年6月25日)
チップの進化は「小型化」だった → 今回 IBM は「積層」に転換
IBM が世界初の0.7ナノメートルチップを発表。トランジスタを垂直に積み上げることで、爪ほどのサイズに約1000億個を詰め込んだ。この1ページで、それが何なのか、どう実現したのか、何の役に立つのか、どの数字を鵜呑みにしてはいけないかを図付きで解説する。
↓ 1ページで読み切る · 動く図が1つあります
まずチップがどう強くなってきたかから。ここ数十年、やり方はずっと一つだった。通電のオンオフを担う最小スイッチであるトランジスタをどんどん小さくする。同じチップにより多く詰め込めれば、演算力も省エネもともに向上する。だが今、この道は行き止まりに近づいている。
IBM は今回、従来路線で力ずくに突き進むのではなく、方向を変えた。平面で詰め込めないなら、上に積めばいい。この新しい作り方は nanostack(トランジスタを縦に積み重ねる新アーキテクチャ)と呼ばれ、業界初の真に3次元的なトランジスタ構造だ。
↑ 原子の壁にぶつかり、縮める余地なし
↓ 占有面積そのまま、数は倍に
だがチップを積み上げるのはずっと最難関だった。どうやって正確に積んで、しかも正常に通電できるのか。次の図でその方法を見てみよう。
nanostack の鍵は、トランジスタをより小さくすることではなく、チップの「作り方」そのものを再設計することにある。手法は実質3つ、1枚の図でつなげて見てみよう。
IBM の公式見解は「性能最大+50%」「エネルギー効率最大+70%」だが、パーセンテージだけでは実感が湧かない。同じAI計算タスクを新旧チップでそれぞれどれだけの電力で処理できるかに置き換えれば、その差がはっきり見えてくる。
詰め込める
ともに向上
単一原子に迫っている
新手法は nanostack
トランジスタを縦に積む
3次元構造
ちゃんと通電するの?
2nm の約2倍