OpenAIの開発舞台裏:GPT-Liveリアルタイム音声システムを6カ月で構築した方法
AIの会話を途切れさせないには、モデルが速いだけでは足りません。ボタンを押してから音声が耳に届くまで、すべての工程を滞りなく動かす必要があります。
- 従来の音声AIは、小型モデルが「ユーザーは話し終えたか」を推測していました。判断が早ければ話を遮り、遅ければ反応が鈍くなります。今回はこのモデルを丸ごと削除しました。
- 難しい問題はバックグラウンドのGPT-5.5へ委任し、GPT-Liveは会話を続けます。記事内の実録音声では、バックグラウンド処理中の十数秒も会話が止まりません。
- さらにWebRTCの接続ハンドシェイクも刷新しました。6往復を1往復に短縮し、変更案をIETFへ提出。主要な2実装がすでに対応しています。
従来の音声AIがぎこちなく聞こえる理由
OpenAIは珍しく詳細な開発回顧を公開しました。GPT-Liveのリアルタイム音声システムを6カ月でどう構築したのか、「話し終えたか」を推測する小型モデルの撤去から、WebRTC接続ハンドシェイクの再設計まで、各工程を明らかにしています。プロダクト開発者にとっては発表資料以上に価値のある内容です。「高速な応答」を単なるモデル性能ではなく、ボタンから耳までを結ぶエンドツーエンドの仕組みとして捉え直しているからです。
まずはアーキテクチャより、次の3つの音声を聴いてみてください。違いは耳ではっきり分かります。
最初の2つが不自然に感じられる原因は、大きく2つあります。
原因1:「話し終えたか」を推測する小型モデル
従来の音声AIは、トランシーバーのようなターン方式でした。ユーザーが話し、終わってからAIが答えます。その間にはturn detector(ターン検出器)という小型モデルがあり、ユーザーの発話が本当に終わったかを判定していました。
この判定はどちらに転んでも厄介です。早すぎれば話の途中で遮られ、遅すぎれば話し終えてもAIが黙ったままで、反応が鈍く感じられます。しかも主に「無音」で判断するため、考えるための間、周囲の話し声、道路を通る車まで「発話終了」と誤認する可能性があります。
さらに問題なのは処理順です。小型モデルが判定を終えなければ、後段のはるかに大きなモデルは処理を始められません。2つの遅延は並列ではなく、直列に積み上がります。
原因2:3つのモデルが順番待ち
さらに前の世代は、もっと遅い仕組みでした。初期のChatGPT音声は、音声認識、大規模モデルによる回答生成、音声合成という3モデルを直列につないでいました。各工程が順番に処理されるため、遅延が重なります。加えて、声の調子、話す速さ、間の取り方はテキスト化の時点ですべて失われ、後段のモデルには味気ない文字列しか届きません。
GPT-Liveの2つの改革:検出器を外し、会話と思考を分離
OpenAIは、この2つの問題を別々の手段で解決しました。
第1の改革:聞きながら話せるモデル
GPT-Liveの音声モデルはfull-duplex(全二重)です。電話のように、聞くことと話すことを同時に行えます。相手がボタンを離すまで発言できないトランシーバーとは違います。
モデル自身が毎秒何度も「今話すべきか、聞き続けるべきか」を判断できるため、ターンを推測する専用の小型モデルは不要になりました。音声経路から完全に取り除かれています。考えるために間を置いても話を奪われず、途中で口を挟んでも対応できます。
第2の改革:「会話」と「深い思考」を別モデルへ
ただし、応答の速いモデルが必ずしも賢いとは限りません。ウェブ検索が必要な質問に、反応速度重視の音声モデルだけでは十分な回答を返せない場合があります。
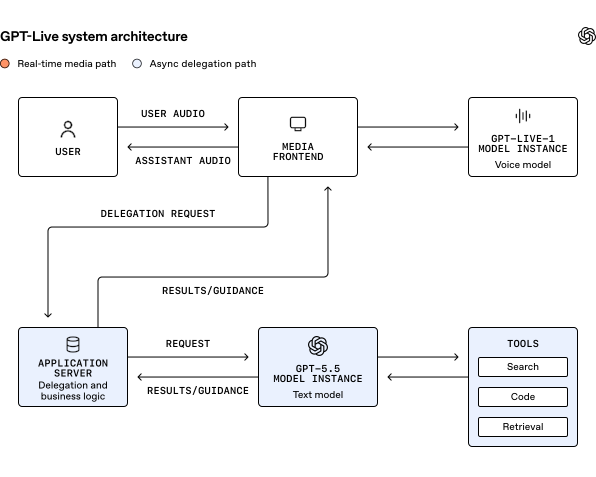
そこで、リアルタイム会話を担うGPT-Live-1をフロントに、検索、コーディング、情報取得を担うGPT-5.5をバックグラウンドに配置しました。調査が必要な質問を受けると、フロントが処理をバックグラウンドへ委任し、自身は会話を続けます。結果が届いた時点で自然に会話へ織り込みます。これが委任です。
抽象的に聞こえるかもしれませんが、効果は実際に耳で確認できます。次は公式の実会話音声です。ユーザーの発話、GPT-Live-1の応答、GPT-5.5によるバックグラウンド検索という3トラックで構成されています。
発表ページは、この2つの変更がGPT-Liveの問題解決の柱だと明言しています。全二重が人間の会話のテンポを守り、委任が難問への回答力を担います。どちらが欠けても、もう一方だけでは成立しません。
高速レーンと低速レーンを分離:音声を止めない設計
処理を別モデルへ委任するだけなら簡単です。難しいのは、その処理中に一切の間を感じさせないことです。
記事全体を貫く設計原則は、ひと言に集約されます。音声は流し続ける。それ以外は待ってよい。
具体的には、専用の高速レーンを設けます。音声はクライアントと音声モデルの間を直接流れ、途中にビジネスロジックを挟みません。委任、ツール呼び出し、会話履歴の保存はすべて非同期境界の後ろへ移します。遅いツール呼び出しが影響するのは自身の結果だけで、音声を止めることはありません。
もう1つ利点があります。アプリケーション層を変更しても応答速度に影響しません。ツール、戦略、バックエンドロジックを変更しても、高速レーンには手を入れずに済みます。
新システムのp95が旧システムのp50に並ぶ
設計だけでなく、実際の効果も重要です。チームはこの経路のコードをPythonのasyncioからGoへ書き直しました。その結果、フレーム配信が大幅に安定し、新システムのp95が旧システムのp50と同水準になりました。
p50は遅延の50パーセンタイル、つまり全体の50%がその値以下に収まる中央値です。p95は95パーセンタイルで、全体の95%がその値以下に収まり、これを超えるのは遅い側の5%だけです。つまり新システムでは、遅い側に当たるp95の水準が、旧システムの中央値であるp50まで改善しました。
これは音声で特に重要です。1回の停滞が、そのまま耳に聞こえるノイズや沈黙になるからです。平均値より、最も遅い数回の体験が問題になります。
パケット遅延への対処:音声をわずかに引き伸ばす
トランスポート層にはWebRTCを使います。ブラウザやスマートフォンAppに組み込まれ、ビデオ通話の多くを支えるリアルタイム音声・映像の標準です。WebRTCには便利な機能があります。パケットの到着が遅れると、手元の音声をわずかに引き伸ばして隙間を埋め、パケットが追いついた後に少し再生を速めて元へ戻します。利用者はほぼ気づきません。これがなければ、その箇所に音声の穴が生じます。
委任経路そのものも高速化
フロントは短時間なら会話をつなげますが、無限には待てません。そのため、委任から結果取得までのルーティング、プロンプト処理、推論、ツール呼び出しをすべて「応答予算」に含めます。基本方針は事前にできる処理は、すべて先に済ませることです。
| 手法 | 短縮できる処理 |
|---|---|
| 音声セッションの開始時にGPT-5.5の推論セッションを作成し、初期コンテキストを事前入力 | 調査が必要な質問を受けた時点でプロンプト処理は完了済み。最初から待つ必要がない |
| 推論セッションを通話中維持し、後続要求を同じworkerへ固定(セッションアフィニティ)。プロンプトキャッシュも利用 | 同じコンテキストの再計算を回避。「固定」であって「拘束」ではないため、worker障害時も復旧可能 |
| 推論強度、出力長上限、ツール記述形式、モデルとツール間の往復回数を個別に調整 | 結果を会話へ返すまでの時間を短縮 |
途切れない引き継ぎ:コンテキスト上限でも気づかれずに切り替える
短い会話ならこれで十分です。しかし、通話が30分続いたらどうでしょうか。
2つの問題が同時に発生します。第1に、マシンの切り替えです。推論インスタンスは需要に応じて増減するため、1つの会話を永久に同じマシンへ固定できません。第2に、コンテキストの上限です。会話が長引くほどコンテキストが蓄積し、いずれモデルの上限を超えます。
まず、コンテキストの上限がなぜ音声の停滞につながるのかを確認しましょう。ここが分からないと、解決策の巧みさも見えません。
コンテキストが上限に達すると、過去の内容を短く圧縮する必要があります。しかし、圧縮には副作用があります。過去のコンテキストが変更されるのです。それまでに計算したアテンションの中間結果を保存し、再計算を省いていたKVキャッシュがすべて無効になります。再びプリフィルしなければならず、処理中はモデルが即座に発話できません。音声では、これがそのまま会話の停止になります。
OpenAIは2つの問題に同じ方法で対応しました。稼働中の環境で処理せず、別の環境を準備してから切り替えるのです。
手順は次のとおりです。旧マシンAが会話を続ける間に、新マシンBを並行してウォームアップします。圧縮済みコンテキストのスナップショットをBへ投入し、現在の進行状況まで追いつかせます。2台が並行稼働する重複期間を設け、Bの準備が完全に整ってから切り替え、最後にAを停止します。
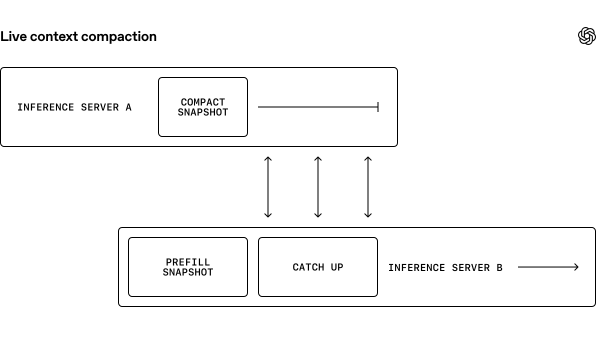
負荷の高い処理はすべて高速レーンの外で完了するため、利用者には変化が聞き取れません。長時間通話を支えられるのもこの仕組みのおかげです。コンテキストが上限に達するたびに圧縮しても、何度繰り返しても音声を止めません。
連続する会話を保存可能なメッセージへ分割
会話が連続的になっても、ChatGPTの画面ではメッセージの吹き出しを1件ずつ表示する必要があります。どう両立させるのでしょうか。
これは意外に厄介な問題です。音声モデル側はターンのない連続音声ですが、周辺システムは依然として個別メッセージを単位に動きます。ChatGPTの会話画面には吹き出しが必要で、分析や安全性のシステムも1件ずつ記録します。そのため、アプリケーションサーバーは連続し、頻繁に重なり合う会話を個々のメッセージへ分割しなければなりません。
難しさは3段階あります。
音声を聞きながら分割するため、最新メッセージは暫定的です。テキスト、時刻、話者の帰属は、その後の音声によって変わる可能性があります。一方の話者が十分な時間、安定して発言権を保って初めて確定できます。発話が重なればさらに複雑です。ユーザーの発話中にAIが「うん」と相づちを打っても、独立したメッセージにはすべきではありません。しかし、内容のある発言を差し込んだ場合は、通常は別メッセージとして扱うべきです。分割が早すぎると履歴が細切れになり、順序も乱れます。遅すぎると字幕の表示が遅れ、字幕に依存する機能も遅くなります。
解決策は、2種類の台帳を同時に維持することでした。
現在の状態を記録し、いつでも変更できます。
画面表示にはこちらを使います。会話画面は再描画できるため、テキストや話者が変われば更新すれば済みます。
最終的な発言内容を記録し、確定後にのみ書き込みます。
分析パイプラインにはこちらを使います。ログや統計には、後から変わらない事実が必要です。
これにより、ChatGPTの他の機能には安定した会話履歴を渡しながら、リアルタイム音声の経路をターン方式へ戻さずに済みます。
最初のパケットで即接続:ハンドシェイク遅延を極限まで削減
ここまでは会話開始後の話でした。しかし、その前にも時間を奪う処理があります。
音声ボタンを押すと、システムはまずメディアチャネルを確立し、音声をモデルへ渡さなければなりません。それまで会話は始まりません。この時間はすべてクリティカルパス上にあります。
標準WebRTCが6往復を要する理由
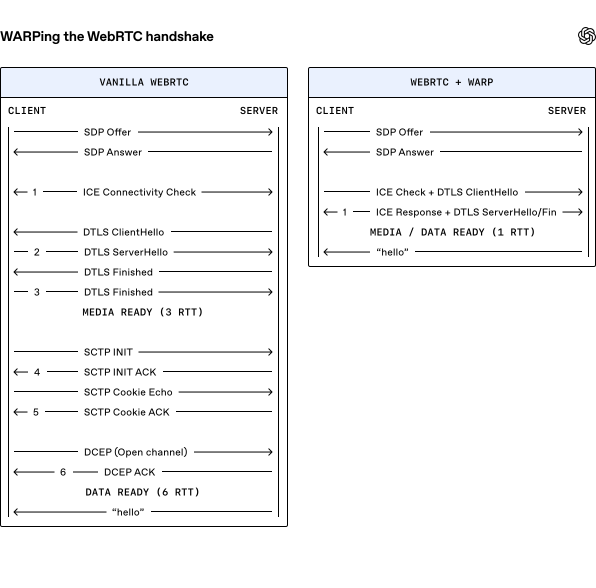
WebRTCは複数のプロトコルを重ねたサンドイッチのような構造です。ICEがネットワーク接続を確立し、DTLSが暗号化を担い、SCTPが信頼性のある転送を行い、DCEPがデータチャネルを開きます。各層はもともと独立して設計され、それぞれDoS攻撃を防ぐハンドシェイクを備えています。積み重ねると、処理が重複します。
公式の比較図によると、メディア送信の開始には3往復、データチャネルには6往復が必要です。1往復(RTT)とは、データがクライアントからサーバーへ届き、応答がクライアントへ戻るまでの時間です。6往復なら、ネットワーク上の往復を6回待つことになります。
なぜ今になって改善する価値が生まれたのか
この問題自体は新しくありません。ただし、耐え難い問題になったのは最近です。IETFのドラフトは、その経緯を説明しています。
WebRTCが設計された2011年当時、この数往復はTCP/TLSでWebSocketを確立するコストと大差なく、特に遅いとは見なされませんでした。その後QUICが登場し、同様の処理を1往復で実現したため、相対的に極端な遅さが目立つようになりました。
さらに重要なのは、用途の変化です。当時のWebRTCは主に人同士のビデオ通話向けでした。接続確立の時間は「相手が電話に出るまでの待ち時間」に隠れ、誰も気づきません。現在は人がサーバーへ直接話しかけるため、遅延がそのまま体験に表れます。
WARP:4つの変更で5往復を削減
解決策はWARP(WebRTC Abridged Roundtrip Protocol、WebRTC簡略往復プロトコル)と呼ばれます。互いに独立し、後方互換性を持つ4つの変更で構成されています。
残る最後の処理:Instant Connect
ハンドシェイクを高速化しても、WebRTC接続の前にはSDPパラメータを1往復で交換する必要があります。双方が対応コーデックや使用する鍵を通知し合う処理です。これもクリティカルパス上に残ります。
そこで開発したのがInstant Connectです。サーバー資源を確保せず、パラメータだけを事前に合意します。最初のメディアパケットが届くと、サーバーは直ちにセッションを生成します。事前合意したパラメータが期限切れまたは無効でも問題ありません。標準のシグナリング処理が並行して進んでいるため、フォールバックしても追加の待ち時間は発生しません。
WARPとInstant Connectは、同じ技術の別名ではありません。対象とする往復が異なります。WARPはトランスポート層を構成する各プロトコルのハンドシェイクを処理し、Instant Connectはその前にあるSDPシグナリング交換を処理します。
数字を照合すると違いが分かります。IETFドラフトの概要は「6往復から2往復へ」、ブログは「1往復へ」と記載しています。ドラフトの2往復は、シグナリング1往復とメディア1往復です。ブログはメディアの1往復だけを数えています。シグナリングの1往復はInstant Connectによってクリティカルパスから外れたためです。どちらも正しく、集計範囲が異なります。
両方を組み合わせると、クライアントは1つのUDPパケットでセッションを開始でき、サーバーは直ちに応答します。
実際にどれほど短縮できたのか
ブログ自体には接続高速化の実測値がありません。ただしIETFドラフトには、実際の本番環境でWARPにより接続遅延がp50で約4往復、p95で約12往復短縮されたとするデータがあります。
p50は50パーセンタイルで、接続の50%がその遅延以下に収まる中央値です。p95は95パーセンタイルで、接続の95%がその値以下に収まり、それより遅いのは5%です。p95の削減幅がp50より大きい理由について、ドラフトはハンドシェイクパケット数の減少を挙げています。パケット損失に遭う確率も下がるため、ネットワーク状態が悪い利用者ほど大きな効果を得られます。
標準化が速く進んだ理由
WARPは公開標準として開発され、IETFのTSVWGで標準化作業が進んでいます。主要実装であるlibwebrtcとPionは、すでに対応済みです。ドラフトの共同著者にはMetaのPhilipp Hanckeも名を連ね、競合企業のエンジニアが共同で策定しています。
進展が速い理由もあります。WebRTC初期のアーキテクトの1人であるJustin Ubertiと、Pionの作者Sean DuBoisが現在OpenAIに在籍しています。Ubertiはこのブログの著者でもあり、十数年前に自ら設計した仕組みを改めて作り直した形です。
シャドウテスト:実トラフィックで徹底検証
設計上は高速でも、実際のトラフィックを受けるとシステムが停止する可能性があります。
一般提供の前に、チームはシャドウテストを実施しました。実際のChatGPT音声セッションの一部を、従来のAdvanced Voice Modeと新システムへ同時に送り、割合を段階的に増やします。旧システムは通常どおり利用者へサービスを提供し、新システムは読み取り専用で推論を実行します。出力音声は誰にも聞かせません。これにより利用者へ影響を与えず、実際のクライアント、ネットワーク、通話時間、地域分布で負荷を検証できます。
このテストから4つの教訓が得られました。
音声セッションは接続を維持し、フレームを送り続けます。そのためCPU側のストリーム処理、キュー、ネットワーク経路も、推論処理と同時に拡張しなければなりません。実負荷では、付随コンポーネントの1つが負荷試験の予測より早く飽和しました(ブログは具体名を明かしていません)。推論要求が滞留し、遅延が連鎖的に増大しました。
そこで容量の捉え方を根本から変えました。「1基のGPUが処理できる要求数」ではなく、「全フレームを定刻どおり届けながら、システムが同時に維持できるセッション数」を問うようになりました。
セッションが遠隔のデータセンターへルーティングされると、起動と転送の複数工程に遅延が加わります。チームはモデルの配備、地域別容量、トラフィック制御設定をまとめて検証し、利用者の地域別に遅延を確認するようになりました。
推論を利用者へ近づけることは有効です。しかし、さらに重要な教訓は、エンドツーエンドの応答速度がモデルサーバーだけでなく、経路上の全サービスで決まるということです。
長時間通話によってメモリと永続化への圧力が判明しました。再接続はコンテキスト圧縮と状態復旧を引き起こし、利用者による通常の切断は終了処理の競合状態を露呈させました。
短時間の負荷試験では、こうした問題をほぼ再現できません。時間、蓄積された状態、サービスをまたぐ動作に依存するからです。どれだけ強い負荷をかけても、実行時間が短く、状態が十分複雑でなければ表面化しません。
発生源の異なる遅延を同じ指標に混在させていた例が見つかりました。全体値が正常に見えるダッシュボードでは、不健全な個別インスタンスが平均値に埋もれていました。テスト環境と本番環境の設定差異もありました。
その後、より詳細なテレメトリー、既知の正常構成による検証、段階的なトラフィック拡大、経路単位の迅速な隔離・停止を導入しました。シャドウテストは最終的にリリースの総合演習となりました。処理可能なトラフィック量だけでなく、障害をどれだけ速く発見、制御、復旧できるかも検証したのです。
- 全二重アーキテクチャ:モデルが聞くことと話すことを同時に行います。「話し終えたか」を推測する小型モデルは音声経路から削除されました。考えるために間を置いても話を奪われず、途中で話しかけても応じられます。
- 会話と思考の分離:フロントのGPT-Live-1が会話を続け、検索や推論が必要な難問はバックグラウンドのGPT-5.5へ委任します。速度と知性を両立し、バックグラウンド処理中も会話を止めません。
- 高速・低速経路の分離:音声はビジネスロジックを挟まない専用高速レーンを流れ、委任とツール呼び出しは非同期境界の後ろへ移されます。経路のコードもPythonからGoへ移行し、新システムの遅い側を示すp95が旧システムの中央値p50と同水準になりました。
- 途切れない引き継ぎ:マシン切り替えやコンテキスト圧縮を稼働中の環境で行いません。別マシンをウォームアップし、進行状況へ追いつかせてから切り替えます。長時間通話でも、コンテキスト整理による音切れを防ぎます。
- WARP + Instant Connect:WebRTCハンドシェイクを6往復から1往復へ短縮し、SDPシグナリングもクリティカルパスから外します。クライアントは1つのUDPパケットでセッションを開始できます。公開標準としてlibwebrtcとPionも対応しており、WebRTCを使うリアルタイムアプリケーション全般が恩恵を受けられます。
OpenAIが振り返るGPT-Live:AIの会話を止めない、ボタンから耳までの総力戦
OpenAIのエンジニアリングチームが6カ月の改修を公開しました。「話し終えたか」を推測する小型モデルの撤去から、十数年間ほぼ手つかずだったネットワークハンドシェイクの再設計まで、図解で1ページにまとめます。
↓ 1ページで読了 · 動く図解付き
従来の音声AIの多くは、トランシーバーのようなターン方式です。ユーザーが話し終えてからAIが答えます。その間にはターン検出器(turn detector、「ユーザーは話し終えたか」を判定する小型モデル)が立ち、判定が出るまで後段の大規模モデルは処理を始められません。
主に無音を手掛かりにするため、考えるための間や近くを通る車まで発話終了と誤認する可能性があります。しかも判定後に大規模モデルが動き始めるため、2つの遅延が直列に重なります。
GPT-Liveの音声モデルは全二重です(full-duplex、電話のように聞くことと話すことを同時に実行)。毎秒何度も「今話すか、聞き続けるか」を判断できるため、ターンを推測する小型モデルは不要になりました。
ただし、応答の速いモデルは難問を不得意としがちです。第2の改革では会話と思考を分離しました。フロントのGPT-Live-1がリアルタイム会話を担い、バックグラウンドのGPT-5.5が検索、コーディング、情報取得を担います。フロントは処理を委任して会話を続け、結果が戻れば自然に会話へ入れます。これが委任です。
音声はユーザーと音声モデルの間に設けた専用高速レーンを流れ、ビジネスロジックを挟みません。委任、ツール呼び出し、会話履歴の保存はすべて非同期境界の後ろへ移します。遅いツールが遅らせるのは自身の結果だけで、音声は止まりません。
長時間通話には別の壁があります。コンテキストが上限に達すると圧縮が必要です。しかし圧縮で過去のコンテキストが変われば、それまでの中間計算を保持するKVキャッシュはすべて無効になり、再計算が必要です。その間は発話できず、音声では会話がその場で止まります。
KVキャッシュがすべて無効化
再度のプリフィルが必要
処理中はモデルが発話不能
利用者には明確な停止として聞こえる
新マシンBを並行して準備:圧縮済みスナップショットを投入し、現在位置へ追随
2台が並行稼働する重複期間を確保
Bの準備完了後に切り替え、Aを停止
重い処理は高速レーン外で完了し、変化を感じさせない
実装結果を示す明確な数字があります。この経路をPythonからGoへ書き直した後、新システムのp95は旧システムのp50と同水準になりました。p95は遅延の95パーセンタイルで、全体の95%がその値以下に収まり、それより遅いのは5%です。p50は50パーセンタイル、つまり中央値です。音声で重要なのは遅い側の数回です。1度の停止が、そのまま耳に聞こえるノイズになるからです。
ボタンを押した瞬間、システムはまずメディアチャネルを確立します。この時間もすべてクリティカルパス上にあります。WebRTCはブラウザやスマートフォンに組み込まれたリアルタイム音声・映像の標準で、4つのプロトコルを重ねたサンドイッチのような構造です。ICEがネットワーク接続を確立し、DTLSが暗号化し、SCTPが信頼性のある転送を担い、DCEPがデータチャネルを開きます。各層は独立して設計され、それぞれハンドシェイクを持つため、積み重ねると処理が重複します。
往復数はOpenAI公式比較図の基準で、ブログにミリ秒単位の数値はありません。IETFの公開ドラフトには本番環境の実測値があり、WARPによって接続遅延がp50で約4往復、p95で約12往復短縮されました。p50は遅延の中央値、p95は全体の95%がその値以下に収まる遅延水準です。ハンドシェイクパケットが減るとパケット損失に遭う確率も下がるため、回線状態が悪い利用者ほど削減効果が大きくなります。WARPは公開標準としてIETFで進行中です。ドラフトの共同著者はMetaに所属し、主要実装のlibwebrtcとPionも対応済みです。
最後にもう1つ処理が残ります。接続前に双方がSDPパラメータを交換し、対応コーデックや使用する鍵を通知し合う必要があります。Instant Connectは、サーバー資源を占有せずにパラメータを事前合意します。最初のメディアパケットが届くと、サーバーは即座にセッションを生成します。WARPとInstant Connectを組み合わせれば、クライアントは1つのUDPパケットでセッションを開始できます。
正式提供の前にシャドウテストを行いました。実際のChatGPT音声セッションの一部を旧システムと新システムへ同時に送り、その割合を段階的に増やします。旧システムは通常どおりサービスを提供し、新システムは読み取り専用で推論のみを実行します。出力は誰にも聞かせません。
✔ 再接続がコンテキスト圧縮と状態復旧を誘発
✔ 通常の切断で終了処理の競合状態が判明
✘ 短時間の負荷試験では発見困難:時間、蓄積状態、サービス間動作に依存
✘ GPU追加だけでは解決不能:音声セッションは常時フレームを送り、CPU側のストリーム処理、キュー、ネットワーク経路が先に飽和
ほかにも重要な発見が2つあります。遠隔データセンターへルーティングすると、起動と転送の複数工程に遅延が加わります。エンドツーエンドの応答速度はモデルサーバーだけでなく、経路上の全サービスで決まります。また、異なる発生源の遅延を同じ指標に混ぜ、全体値が不健全な個別インスタンスを隠していたため、可観測性も作り直しました。
小型モデルがいる
話せる
両方が話せる
待ってよい
Goへ書き直し
旧システムの
中央値p50と同等
接続確立の往復数
ネットワークを1周待つ
- × DTLSをICEへ同乗、1往復減
- × DTLS 1.2から1.3、1往復減
- × SCTPを事前合意、2往復減
- × データチャネルも事前合意
最初のパケットで
即セッション生成
再接続で圧縮・復旧を実行
通常切断で終了競合が判明
CPU側のストリーム処理、
キュー、ネットワーク経路