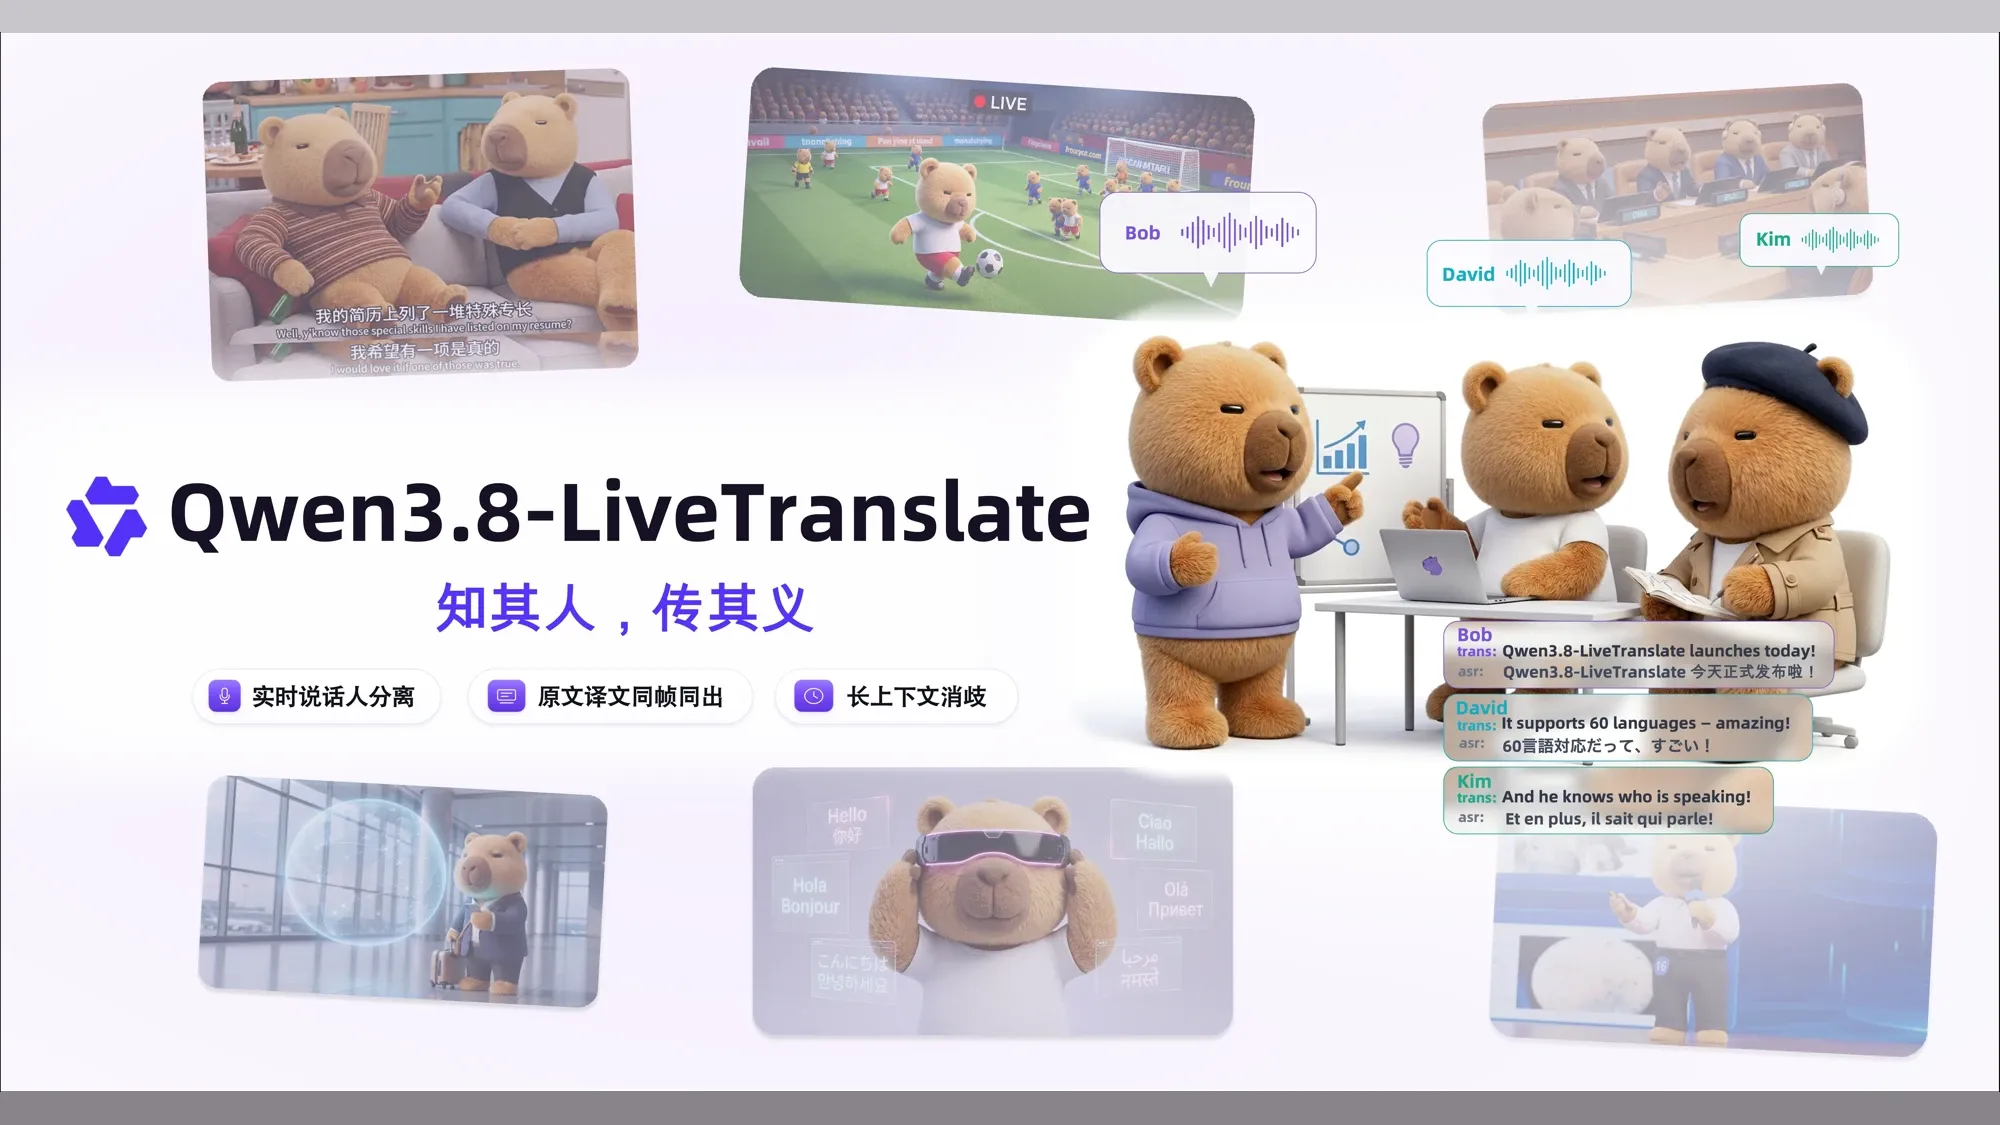
アリババがリアルタイム音声翻訳モデル「Qwen3.8-LiveTranslate」を発表:複数話者の識別に対応したリアルタイム同時通訳
原文と訳文の同時表示に対応し、長大なコンテキストと映像を組み合わせて曖昧さを解消。本記事ではアーキテクチャ、対応言語、ベンチマーク評価、API連携から実際の料金までを分かりやすく解説します。
複数人が参加する多言語ミーティングにおいて、翻訳が速いことは出発点にすぎません。聞き手は「誰がその発言をしたのか」を把握する必要があり、人名や専門用語が出てきた際には原文と照らし合わせられることが求められます。また、その後の会話でも、それまでに共有された背景を忘れてはなりません。リアルタイム同時通訳は、これらすべての情報を統合して伝達できて初めて、実用的なコミュニケーションツールに近づきます。
Qwenチームは、リアルタイム音声同時通訳向けの大規模モデル「Qwen3.8-LiveTranslate」をリリースし、Alibaba Cloud Model Studio(百錬)プラットフォーム上でストリーミングAPIインターフェース qwen3.8-livetranslate-flash-realtime の提供を開始しました。
Qwen3.8-LiveTranslateは、2つのコンポーネントの連携によって動作します。「Thinker」が音声を聞き取りながら、映像や前後の文脈を統合して内容を理解し、「Talker」がその訳文を発話します。公式のFLEURS多言語ベンチマークテストにおいて、訳文の進行が元の発言から遅れる時間は平均で2.3秒でした。この指標の英語略称はLAALで、リアルタイム翻訳システムが話者の発話に追随する速度を比較するために用いられます。
今回のアップグレードは、主に以下の4つの機能に集約されます。
- 誰が話しているかの識別:ストリーミング形式で複数の話者を識別し、訳文音声でもそれぞれの声色を可能な限り維持;
- 原文と訳文の同時出力:同一のデータストリームから原言語の認識結果と目的言語の訳文を同時に返し、字幕の確認や内容の整理を円滑化;
- 前文と映像による曖昧さの解消:長いコンテキストと静止画フレームを組み合わせ、指示語、固有名詞、同音異義語を的確に処理;
- ストリーミング待機時間の削減:音声とテキストを交互に同一の処理ストリームへ流し込み、聞き取り済みの音声や生成済みの訳文を再利用。FLEURSテストにおいて、訳文が元の発言から遅れる平均時間は前世代の2.8秒から2.3秒へと短縮。

どのように「聞き」「訳し」「話す」を同時にこなすのか
一般的な音声同時通訳システムは、3つのステップで処理を行います。まず音声を文字起こし(音声認識)し、次にそのテキストを翻訳し、最後に訳文を音声へと合成します。これら3つのステップは直列に連なっているため、前段階での聞き取りミスが後続の処理へと伝播しやすいという課題があります。また、話者の声色をこのテキスト主体のパイプライン越しに受け継ぐことも困難でした。
Qwen3.8-LiveTranslateでは、Thinker–Talkerのデュアルモジュール構成を採用しました。基盤となるHybrid MoE(混合エキスパート)は「タスクに応じて一部のエキスパートモジュールを選択して計算に参加させる」アーキテクチャです。また、Interleave(インターリーブ)は、音声、原文、訳文をバッチごとに順番待ちさせるのではなく、時系列に沿って交互に同一の処理ストリームへ投入することを意味しています。

システムのコアとなる動作は、2つのモジュールの連携によって行われます。
Thinkerは「聞き取って理解する」役割を担います。映像、音声、認識された原文、そして生成途中の訳文を時系列順にまとめて処理します。すでに聞き取った音声や翻訳済みの内容をそのまま再利用できるため、毎回最初から計算し直す必要がなく、スムーズに後続の翻訳を継続できます。
Talkerは「訳文を発話する」役割を担います。訳文と元の音声を同時に参照することで、合成される目的言語の音声において、元の話者の声色を可能な限り再現します。
4つの能力は実際の会話でどのように機能するのか
複数人でのコミュニケーションや複雑な文脈に対応するため、Qwen3.8-LiveTranslateは最適化されたストリーミング処理機能を導入しています。

話者を識別し、それぞれの声色を維持
複数人が順番に発言したり交互に会話したりする際、モデルは spk1、spk2、spk3 といったラベルを用いて各発言が誰によるものかを識別し、対応する訳文音声でもそれぞれの声色を保ちます。
原文と訳文の同時出力
モデルは訳文を返すと同時に、認識された原文も提示します。アプリケーション側で2つの言語テキストを同期して表示できるため、利用者は翻訳をそのまま読むだけでなく、いつでも元の発言と照合できます。これにより、バイリンガル字幕の生成、内容の整理、情報の検索などにおいても、そのまま活用できるデータが得られます。
前後の文脈から人名や指示表現を理解
過去の会話や文脈を統合することで、ストリーミング翻訳における代名詞の指示対象、人名、固有名詞の曖昧さを緩和します。公式のデモ動画では、火焔山、一年中続く酷暑、農作物が育たないといった対話の文脈を踏まえ、終盤でモデルがコンテキストに基づいて「铁山郡/Tieshan Country」を「铁扇仙/Iron Fan Fairy」(動画内の表示テキスト準拠)へと修正する様子が示されています。
映像を手がかりにした同音異義語の判定
音声に同音異義語が含まれ、前後の文脈だけでは判別が難しい場合、モデルはカメラ映像を参照することも可能です。公式デモでは、発音が同じで意味が異なる pear/pair、leek/leak、sail/sale という3組の単語を使用し、映像内に映っている実物に基づいて適切な意味を選択する様子が紹介されています。
翻訳速度、品質、話者識別のパフォーマンス
Qwenチームは、FLEURS多言語テストセットを用いて19言語間・計70の翻訳方向(例:「中国語から英語」と「英語から中国語」は別方向としてカウント)を比較評価しました。翻訳品質を測る自動評価スコア xCOMET-XXL(数値が高いほど高品質)において、Qwen3.8-LiveTranslateは85.7点を記録しました。前世代のQwen3.5は83.0点、Seed LiveInterpret 2.0は79.4点、Gemini 3.5 Live Translateは73.5点、GPT-Realtime-Translateは65.2点でした。

速度面において、訳文が元の発言から平均してどれほど遅れるかを測定するLAAL(数値が低いほど追従が速い)では、Qwen3.8が2.3秒、Geminiが2.5秒、SeedおよびQwen3.5が2.8秒、GPTが3.1秒という結果でした。文字起こしの正確度を表すWER(単語誤り率、低いほど高精度)では、Qwen3.8が6.6%、Seedが7.0%、Geminiが11.4%でした。合成音声の自然さを評価するUTMOSスコア(5点満点、高いほど自然)では、Qwen3.8が4.0点を獲得しました。なお、Seedの音声の自然度テストは音声出力に対応している26の翻訳方向のみを対象としており、その他のシステムは70方向すべてを網羅しています。
複数人による長尺音声ベンチマーク「Omnilingua-MSpeaker」において、QwenチームはQwen3.8と他モデルの訳文を1対1で比較し、内容の忠実さ、表現の流暢さ、文の簡潔さをそれぞれ検証しました。
- 忠実度:Seed、GPT、Geminiに対するQwen3.8の勝率はそれぞれ81.0%、79.3%、79.9%(対戦相手の勝率は15.4%、17.3%、15.0%、残りは引き分け);
- 流暢さ:勝率はそれぞれ87.2%、74.6%、95.6%(対戦相手の勝率は9.9%、20.9%、3.4%);
- 簡潔さ:Seedに対しては、Qwen3.8の方が優れていたサンプルが20.3%、同等(引き分け)が70.0%、劣っていたのが9.7%;GPTおよびGeminiに対する勝率はそれぞれ39.2%と83.2%。

話者の識別精度は、DER(話者分離エラー率、数値が低いほど高精度)で確認できます。音声をリアルタイムに受信しながら処理した場合、Qwen3.8のエラー率は9.7%でした。同じくリアルタイム処理を採用しているSeed-asr-2.0は30.6%でした。また、録音データ全体を取得した後に処理を行う2つの比較対象では、GPT-4o-transcribe-diarizeが18.0%、Gemini-3.5-transcribe-previewが26.7%でした。
対応言語とサポート範囲
システムは各言語に対して以下の3段階の機能を提供しています。
- 音声入力・60言語:ソース音声としてモデルに入力可能な言語;
- テキスト出力・60言語:目的言語の翻訳テキストとして返却可能な言語;
- 音声出力・29言語:目的言語の音声合成まで行えるサブセット。
たとえば広東語は、入力音声として使用でき、広東語テキストの出力にも対応していますが、現時点では広東語音声の合成には対応していません。以下に機能別の全対応言語一覧を掲載しています(特定の言語を直接検索することも可能です)。
翻訳対応60言語・音声出力対応29言語
言語ごとの対応機能を確認
中国語音声入力テキスト出力音声出力
音声出力に対応
29言語音声入力、テキスト出力、音声出力のすべてに対応します。
- 中国語
- 英語
- ドイツ語
- イタリア語
- ポルトガル語
- スペイン語
- 日本語
- 韓国語
- フランス語
- ロシア語
- タイ語
- インドネシア語
- アラビア語
- ベトナム語
- トルコ語
- フィンランド語
- ポーランド語
- ヒンディー語
- オランダ語
- チェコ語
- ウルドゥー語
- フィリピン語
- スウェーデン語
- デンマーク語
- ヘブライ語
- アイスランド語
- マレー語
- ノルウェー語
- ペルシャ語
音声入力とテキスト出力のみ
31言語翻訳テキストは出力できますが、現在の音声合成対応一覧には含まれません。
- アフリカーンス語
- アストゥリアス語
- アゼルバイジャン語
- ベラルーシ語
- ベンガル語
- ボスニア語
- ブルガリア語
- 広東語
- カタルーニャ語
- セブアノ語
- クロアチア語
- エストニア語
- ガリシア語
- グジャラート語
- ギリシャ語
- ハンガリー語
- ジャワ語
- カンナダ語
- カザフ語
- キルギス語
- ラトビア語
- マケドニア語
- マラヤーラム語
- マラーティー語
- パンジャブ語
- ルーマニア語
- スロバキア語
- スロベニア語
- スワヒリ語
- タジク語
- ウクライナ語
上の言語を選ぶと、音声入力、テキスト出力、音声出力への対応状況を確認できます。
開発者向け連携:WebSocketによる継続的な送受信
百錬プラットフォームでは、クライアントがWebSocketを介して切断されないネットワーク接続を維持し、録音全体のアップロード完了を待つことなく、音声を送信しながら訳文を受信できます。接続先エンドポイントの形式は以下のとおりです。
wss://{workspace_id}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime?model=qwen3.8-livetranslate-flash-realtime
上記のアドレスは中国華北2(北京)リージョンの接続エンドポイントであり、
{workspace_id}は百錬のワークスペースIDです。リージョンによって接続先アドレスは異なります(シンガポールの国際サービスなど)。認証はWebSocket接続確立時のHTTPリクエストヘッダーAuthorization: Bearer <DASHSCOPE_API_KEY>を通じて渡します。
同時通訳セッションの4つのステップ
接続確立後、クライアントが行う処理は主に4つあります。どの言語に翻訳するかをサーバーに伝えること、音声や映像を継続的に送信すること、翻訳結果を受信すること、そして未処理のデータが完了するのを待ってから接続を閉じることです。
1. 目的言語と出力形式の設定(session.update)
クライアントの接続が確立された後、サーバーへ最初に送信すべきイベントは session.update です。公式の最新ドキュメントに基づく、qwen3.8-livetranslate-flash-realtime の最小構成例は以下のとおりです。
{
  "type": "session.update",
  "session": {
    "output_modalities": [
      "text",
      "audio"
    ],
    "translation": {
      "language": "en"
    }
  }
}
各フィールドの役割は以下のとおりです。
- テキストか音声かの選択:
session.output_modalitiesを["text", "audio"]に設定すると訳文テキストと音声の両方が返され、["text"]に設定するとテキストのみが返されます。 - 原文の同時返却:Qwen3.8は常に音声認識(聞き取った音声を原文テキストへ変換)を行い、この結果は無償で返却されます。Qwen3.5のように
input_audio_transcriptionで手動で有効化する必要はありません。 - 翻訳先言語の指定:
translation.languageに目的言語を指定します。また、translation.corpus.phrasesを使って{"人工智能": "Artificial Intelligence"}のような用語集(対訳辞書)を提供することで、業界用語や固有名詞を安定して翻訳させることができます。
2. 音声の継続送信(必要に応じて映像を追加)
- 音声の送信(
input_audio_buffer.append):マイクで収録した音声を小さなチャンクに分割し、16000Hz・モノラルのPCM形式にしてから、ネットワーク転送に適したBase64文字列に変換して継続的に送信します。サーバー側が一文の開始と終了を自動的に判定し、翻訳処理をトリガーします。 - 映像の送信(
input_image_buffer.append):モデルに映像を参照させたい場合、静止画像をBase64文字列に変換して送信できます。画像は以下の要件を満たす必要があります。- 画像フォーマットはJPGまたはJPEGであること。推奨解像度は480pまたは720p(最大1080pまで);
- Base64エンコード前の1画像あたりのファイルサイズが500KBを超えないこと;
- 画像のストリーミング頻度は毎秒最大2フレームまで;
input_image_buffer.appendを送信する前に、セッション内で少なくとも1回input_audio_buffer.append音声イベントが送信されていること。
3. 原文、訳文、訳文音声の受信
サーバー側は対話全体が終わるのを待ってまとめて結果を返すのではなく、異なるイベントを通じて細かくストリーミング返却します。
- 訳文音声(
response.audio.delta):24000Hz・モノラルのPCM音声チャンクが順次返されるため、クライアント側で再生キューへ順序どおりに追加します。 - 訳文テキスト:音声と共に出力する場合は
response.audio_transcript.delta経由でチャンクごとに返却され、テキストのみ出力する場合はresponse.text.delta経由で返却されます。クライアントは受信順にテキストを結合します。 - 認識された原文:
conversation.item.input_audio_transcription.textが確定した原文テキストを継続的に返します。その区間の発話認識が完了すると、conversation.item.input_audio_transcription.completedから完全な原文と認識言語が出力されます。 - ターンの完了(
response.done):そのターンの翻訳生成が完了したことを示し、あわせて消費されたToken数が返されます。TokenはAPIの利用量および料金を計算する単位です。
4. 残存データの処理完了を待ってから切断
音声収録が終了したら、クライアントはまず session.finish を送信し、サーバーに「音声の送信完了」を通知します。サーバー側は残りの音声処理を完了すると session.finished を返します。このイベントを受信し、ローカルの再生キューの再生も完了した段階で接続を切断すれば、最後の発言が途切れてしまうのを防ぐことができます。
クライアント参考実装のアーカイブに関する注記
公式ブログでは以前、マイク入力によるストリーミング送信とバックグラウンドでのマルチスレッド再生ロジックを含む、Pythonベースの全二重クライアントサンプルコードが公開されていました。このコードは参考用としてそのままアーカイブされています:official-client.py。
このコードにはブログ公開当時のコメントがそのまま残されており、一部の内容は現在のAPIドキュメントと異なっています。実際に組み込む際は現在の最新ドキュメントに従って調整してください。
APIの料金と無料枠
このAPIは、音声、画像、テキスト、合成音声をTokenに換算して個別に課金します。Alibaba Cloud Model Studio(百錬)で公表されている価格によると、中国華北2(北京)リージョンにおける qwen3.8-livetranslate-flash-realtime の100万Tokenあたりの通常価格は以下のとおりです。
- 音声入力:40元;
- 画像入力:3.3元;
- テキスト出力:100元;
- 音声出力:160元。
中国華北2(北京)リージョンでは100万Tokenの無料枠が提供されており、有効期限は百錬の利用開始、モデルのリリース、または申請承認のいずれか遅い日から90日以内です。その他のリージョンにはこの無料枠はありません。シンガポールリージョンにおける4項目の単価は、100万Tokenあたりそれぞれ54.688元、4.01元、145.835元、218.752元となっています。音声、画像、テキスト、音声合成ではTokenの換算基準がそれぞれ異なるため、録音の分数のみから上記の単価を単純計算することはできません。正式な導入前には、百錬のモデル料金ページおよびコンソールの請求情報を必ずご確認ください。
導入後に重点テストすべき3つのポイント
リアルタイム同時通訳を導入した後は、話者、専門用語、待機時間という3つの観点からテストを行うことをおすすめします。
各自の発言を正しく識別できているか
- テストの論点:複数人が交互に発言したりテンポよく発話を重ねたりした際、システムは発話者を安定して識別し、訳文でも各自の声色を維持できるか。
- 観察ポイント:spk 話者ラベルが発言者の交代に合わせて正確に切り替わっているか。訳文音声で各自の声色が保たれているか。複数人がすばやく発話を交わした際に、話者の取り違えや声質の変化が生じないか。
- 不合格時の影響:聞き手が字幕や音声から誰の発言かを判別できず、複数人でのディスカッションやビジネス交渉において発言主体の取り違えや混乱を招く。
人名や専門用語の一貫性を保てているか
- テストの論点:長時間の会話や複数ターンにわたるやり取りの中で、専門用語、組織の略称、同音異義語の翻訳が一貫性を維持できているか。
- 観察ポイント:用語集(対訳辞書)の追加前後でキーワードの翻訳が改善されているか。会話が進んでも同一の名称が一貫した訳語で維持されているか。代名詞が正しい人物や事物を指しているか。
- 不合格時の影響:専門用語が日常的な言葉に誤訳され、専門的な会議における正確性が損なわれるとともに、人手による事後修正や突き合わせの負担が増大する。
音声チャンクの適切な分割長
- テストの論点:訳文の表示・再生をできる限り速くしつつ、スムーズな連続再生を保つには、音声をどれくらいの長さに分割して送信するのが最適か。
- 観察ポイント:音声チャンクの長さ(例:約100ミリ秒)を調整した際、最初の訳文音声が返るまでの時間。ネットワークが不安定な環境で、再生の途切れやバッファの遅延蓄積が発生しないか。
- 不合格時の影響:チャンクが長すぎるとモデルの処理開始までの待ち時間が長くなり、短すぎると送信リクエストの回数が増大します。実際のネットワーク環境で両者の最適なバランスを見つける必要があります。
Qwenチームは今後、待機時間のさらなる短縮やセッションをまたぐ長期記憶の探求を進め、より多くのマイナー言語や地域方言への対応拡大を計画しています。
本モデルの試用やシステム連携を検討している開発者は、公式のデモ体験ページから試用できるほか、百錬公式のAPIドキュメントで最新の接続仕様を確認できます。
実践用持ち帰り資料
Markdown をスクロールして確認し、コピーしてチーム向けに調整できます。
Markdown を読み込み中…