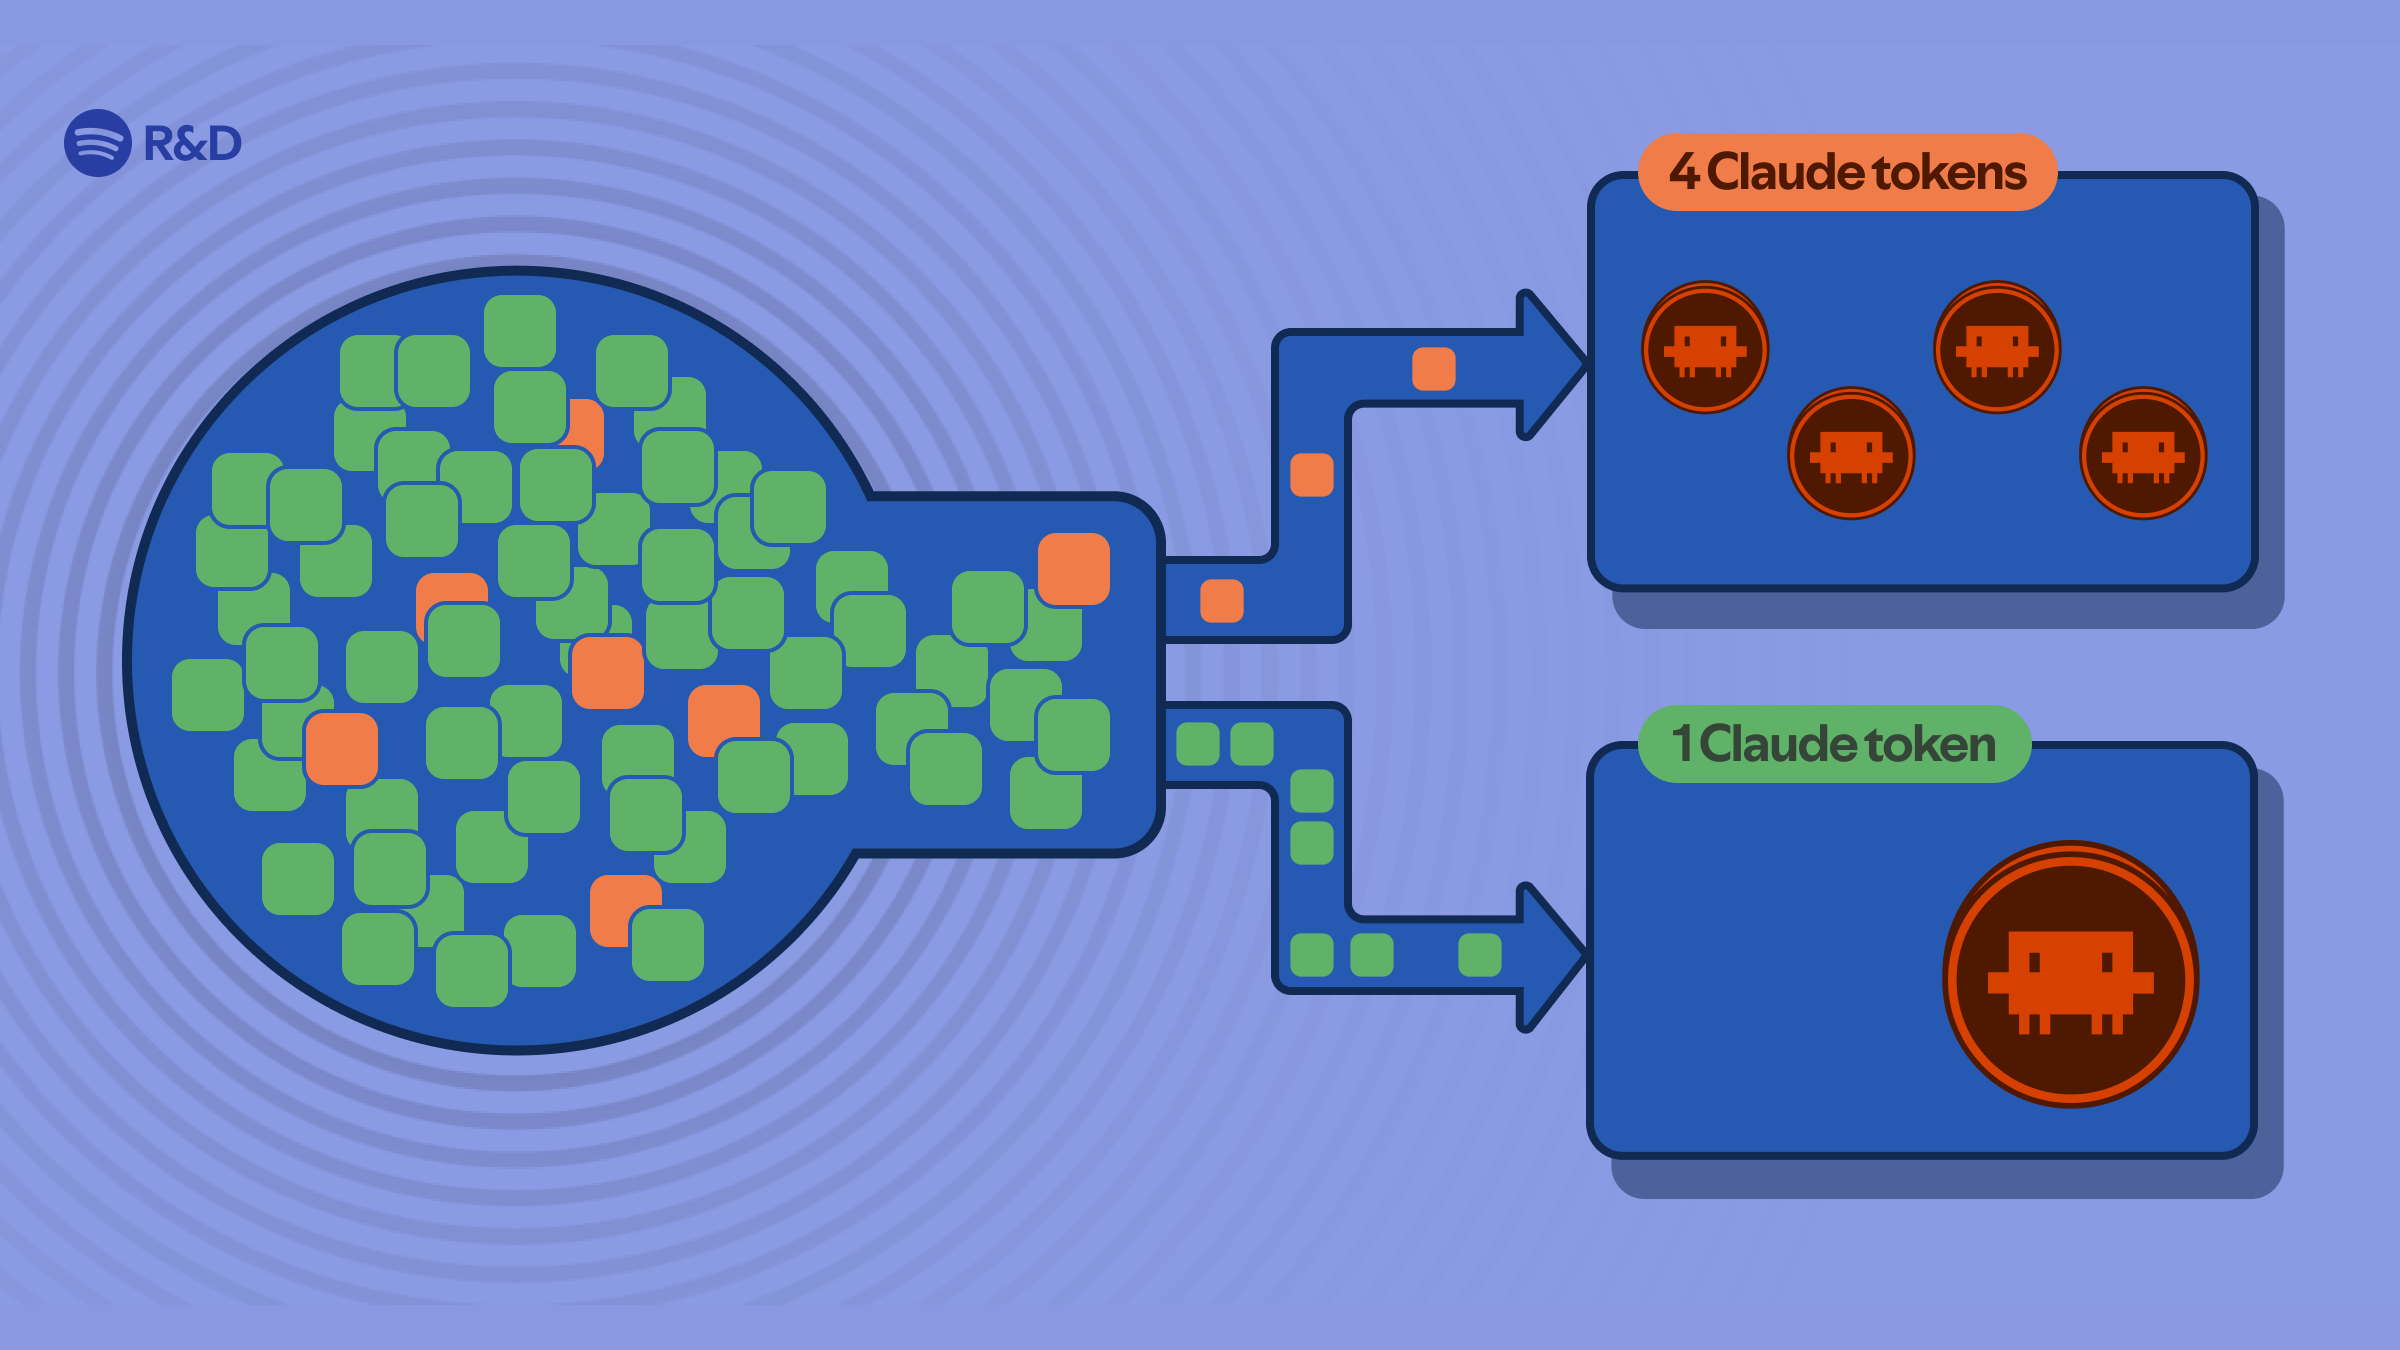
Spotify が Claude Code の処理振り分けの仕組みを公開:大ファイル読み込み時のコンテキストを約90%削減
多くの人はトークンが「思考」に費やされていると思いがちですが、実際には長大なファイルの読み込みや運搬作業に大量に消費されています。Spotify のプリンシパルプロダクトマネージャー Dimitri Mazmanov 氏が公開した分散プラグイン shunt は、大ファイルの通読や定型コード作成を補助モデルに肩代わりさせることで、テストにおいて Claude メインモデルに入る大ファイル読み込みコンテキストを約90%削減し、コンテキストを中核的な推論のために温存します。
- 消費の根本原因:Claude はごくわずかなコードを特定するために数千行の大ファイルを読み込んでしまうことがあり、長文がコンテキストに入ると枠を圧迫するだけでなく、その後の会話の入力コストまで押し上げる可能性があります。
- モードによる役割分担:クラウド上のステートレスなモードに体力仕事を分担させます。大ファイル読み込みではメインモデルに抽出した要点のみを返し、定型コード生成では仕様と参考ファイルをもとにローカルディスクへ直接コードを書き込めます。
- 連携メカニズム:デフォルトでは350行を超え範囲指定のない単一ファイルの全読み込みを Hook で遮断し、Skill の案内に従ってローカル Script を呼び出すよう誘導します。定型コード生成には強制遮断はなく、自発的な判断に委ねられます。
- メリットと限界:テストにおいてメインモデルに入る読み込みコンテキストは平均で約90%削減されましたが、補助モデルの呼び出しや後続のレビューによるコストは依然として存在します。精密な修正や並行処理の不具合調査には、依然としてメインモデル自身によるソースコード確認が必要です。
お金はどこに消えたのか:Claude は数行のコードを探すために、まず数千行を読み込んでいた
Spotify は先日、Claude Code の処理を分散(オフロード)させる手法を公開しました。16.2万行の Java コードを持つプロジェクトでのテストにおいて、大きなファイルを読み込む際に Claude のメインモデルのコンテキストに入る情報量を平均で約90%削減することに成功しました。多くの人は、課金対象となるトークンは AI が「思考」することに消費されていると思いがちです。トークンとは、モデルがテキストを処理する際の計算単位であり、API 利用料の計算にもよく用いられます。しかし実際には、多くのトークンが「長いファイルをただ読む」「呼び出し箇所を探す」「既存コードを真似て定型コード(ボイラープレート)を書く」といった、いわば単純な運搬作業に費やされているのです。
具体的な場面を想像してみてください。「決済成功後、SMS 通知はどこでトリガーされているか」だけを調べたいとします。ほんの2〜3行をサッと見つけて答えを出してくれると思いきや、AI は全体の文脈を把握しようとして、数千行にも及ぶ巨大なファイルを端から端まで読み通してしまうことがあります。ここで言う Claude Code とは、プロジェクト内のファイルを検索したりコードを編集したりできる AI プログラミングアシスタントのことです。しかし、数千行ものコードが会話コンテキスト(モデルが今回の回答で参照できる会話履歴や資料のこと)に読み込まれると、コンテキストの容量を圧迫するだけでなく、その長大なテキストがその後のやり取りでも入力コストとして加算され続ける可能性があります。
メインモデルにこうした機械的な読み込み作業をさせると、余計なコストがかさみがちです。元記事が引用している業界データによると、エンジニアリングリーダーの4人に1人が、開発者1人あたり月額200〜500ドルのトークン支出に直面しており、中には2,000ドルを超えるケースもあるといいます。ただし明確にしておくべき点として、今回の取り組みで達成された「約90%の削減」は、あくまで「3つの大ファイル読み込みテストにおいてメインモデルのコンテキストに入る内容が約90%減った」という意味に厳密に限定されており、開発プロセス全体や月々の請求総額がそのまま90%減るわけではありません。
長いコードを端から端まで読んで名前を1つ探したり、既存のコードを見本にして定型文のようなコードを起こしたりする作業は、本質的にはコンテキストを浪費するだけの基礎的な読み込み作業です。この無駄遣いに対し、Spotify のプリンシパルプロダクトマネージャーである Dimitri Mazmanov 氏が提示した解決策は「役割分担をつくること」でした。「資料の調査や見本に沿ったファイル作成は他の補助モデルに任せ、メインアシスタント自身は判断に必要な要点だけを受け取る」という仕組みです。
先ず2つの「体力仕事」を切り出す:ファイルの読み込みと定型コードの作成
Spotify の開発者ポータル製品「Portal」には、「AiKA モード(Modes)」と呼ばれる機能が備わっています。ユーザーは特定のタスクに合わせて専用の補助モードを設定し、明確な指示を与えた上で、対応する補助モデル(Gemini 2.5 Flash などの軽量モデル)を紐付けることができます。これらのモードは1回ごとの呼び出しで完結し、タスクが終われば終了するため、複数ターンにわたる会話の記憶は保持されません。
直接読み込み(分散なし)
コード全文を受信(コンテキストを圧迫)
補助モデルへ委譲(分散)
要約および呼び出し情報/ステータスを受信
分散したからといって全文が消え去るわけではありません。コード全文はクラウドの補助モデルに送信されて処理され、要約は補助モデルによって生成され、ローカルスクリプトはその要約を中継するだけです。補助モデルにはそのモデルの料金が発生し、分散によって削減されるのは Claude メインモデルのコンテキストに流れ込むテキスト量のみです。
ファイルを補助モデルに任せるといっても、長いテキストが跡形もなく消えるわけではありません。決定的な違いは「作業がどう流れるか」にあります。コードファイル自体はローカルPCに保存されており、手元で動くスクリプトがファイルを読み込んだ後、ネットワーク経由でクラウド上の補助モデルへと送信します。補助モデルはファイル全体を読んだ上で、抽出した重要事項だけをローカルスクリプトへ返却し、スクリプトがそれを Claude メインアシスタントへと受け渡します。メインモデルのコンテキストが受け取るのは、呼び出しに関する情報と簡潔にまとまった要点だけです。長文を読む作業そのものが外部へ移され、料金もそれぞれのモデルの単価に基づいて個別に計算されます。
最もコンテキストを消費しやすい2種類の作業に対して、それぞれ専用の補助モードが用意されています:
大ファイル読み込みモード(bulk-reader)
このモードは、長いコードを読み通して事実関係を抽出することに特化しています。プロンプトでは挨拶や長々とした総括を禁じ、各箇条書きは必ずクラス名、メソッド名、または行番号から直接書き始めるよう厳格に指定されています。ここで言うメソッドとは、日常的な言葉で言えば「特定の処理を実行するコードのひとまとまり」のことです。プロンプトで簡潔さを求めているとはいえ、返ってくる内容が常に絶対に無駄がなく、1行の漏れもなく読み切れており、完全に正しいとは保証できません。メインアシスタントはこの要約を受け取ることで、ひとまず最初の場所特定に関する質問には回答できますが、厳密な条件判定を行ったり実際にコードを修正したりする際には、依然として該当する元のコードを確認し直す必要があります。
決済通知の SMS を特定する例で考えてみましょう(以下は説明用の架空の例であり、実際の実行結果やプロジェクトのソースコードではありません):
- 入力:ローカルスクリプトが
PaymentService.java(約3,200行)とNotificationService.java(約1,800行)の全文をクラウドのモードに送信し、「決済成功後、SMS 通知はどのメソッドでトリガーされているか?関連するクラス名とメソッド名を挙げてください」という質問を添えます。 - 補助モードから返される要点:
PaymentService.java:processPayment()メソッドが取引処理中にNotificationService.sendPaymentReceiptSms()を呼び出しているNotificationService.java:sendPaymentReceiptSms()メソッドが決済控えの SMS を組み立てて送信している
- メインアシスタントの処理:メインアシスタントはこの簡潔な事実関係を受け取ることで、5,000行ものコードを丸ごとコンテキストに読み込むことなく呼び出し関係を把握し、ユーザーへ手がかりを提示できます。もしその後、詳細なトリガー条件を確認する必要が生じた場合は、該当するコードに絞ってピンポイントで参照します。
定型コード生成モード(code-writer)
このモードは、ユニットテスト(単体テスト)のように構造が繰り返し現れる定型コードの生成に使用されます。呼び出しの際には、「仕様書(Spec)」と「参考ファイル(Reference)」を同時に提供する必要があります。仕様書は目標とする動作を定義するもので、例えば「決済失敗」を入力したときに、システムが決済控えの SMS を送信していないことを検証する自動チェックプログラムを書く、といった指示です。一方の参考ファイルは、プロジェクト内にすでにある完成されたテスト用例を提供し、そのプロジェクトで普段どんなテストフレームワークを使い、どのように命名し、どんな構造でコードを整理しているかをお手本として示します。
ローカルスクリプトはプロジェクト内から他のソースコードを勝手に検索してきたりはしないため、「何をすべきか」を伝えるだけでは不十分で、実際の機能名や呼び出し方をきちんと指定してあげる必要があります。参考ファイルと仕様書が合わさって初めて、対象となるインターフェース、動作、スタイルが揃い、モデルはそれらと見比べながら適合するコードを生成できるのです。ただし、それでも生成されたコードが必ず合格点に達しているとは限らず、最終的には人間によるレビューやテストの実行が欠かせません。
出力先を指定(--target)
出力先未指定
生成コスト自体は依然として存在し、定型コードはレビューとテストによる検証が必要です。target を指定してファイルに書き込めば本文は画面に上がらず、必要に応じて後から読み直すことができます。
結果の受け渡しに関して、クラウドの補助モデルが生成したコードは、まずローカルスクリプトへ戻されます。そこからスクリプトは2つの出力ルートを提供します。出力先ファイルパス(--target)が指定されている場合、ローカルスクリプトは生成されたコードをローカルのディスクファイルに直接保存し、コードの本文を Claude には渡しません。ただし、呼び出し時の引数や書き込み完了の通知はメインアシスタントのコンテキストに入ります(後からレビューする際にピンポイントで読み直すことが可能です)。一方、出力先パスが指定されていない場合は、コードがターミナル上に出力され、Claude のコンテキストへと送られます。補助モデルによるコード生成でも相応の入出力コストは発生しますし、メインアシスタントが呼び出しを行ったりステータスを受け取ったりする際にも少量のコンテキストが消費されます。
安いモデルを用意しただけでは不十分:Claude が自力で無理やり読むのをどう防ぐか
これら2つの補助モードを用意したからといって、Claude が大きなファイルに遭遇した際に自動でそれらを呼び出してくれるとは限りません。
当初、Dimitri 氏はプロジェクトの説明ファイルである CLAUDE.md にルールを記載し、Claude に対して「大きなファイルを扱うときは補助モードを使ってください」と促す方法を試しました。しかし、こうした説明文はあくまで「緩やかな推奨」に過ぎず、Claude はタスクを実行する際にこれを無視することもあり、実際に従うかどうかはモデルの自発的な選択に委ねられてしまいます。その上、プロジェクトごとに個別の説明ファイルを用意してメンテナンスしなければなりませんでした。
トラフィックの分散メカニズムを確実に機能させるには、モデルの自発性に期待するのではなく、モデルがファイル全体の読み込みを試みた瞬間に手前で割り込んで阻止する(インターセプトする)仕組みが必要です。これこそが、分散プラグイン shunt の設計の核となっている部分です。
shunt はどのように処理を分散させるのか:遮断、案内、引き渡しの3ステップ
Claude が大きなファイルを読み込もうとしたとき、分散メカニズムは「遮断」「案内」「引き渡し」という3つの連携ステップで処理を完了します:
- 01
遮断(Hook 事前チェック)
ツールの実行前に、行数しきい値を超える単一ファイルの全読み込みを遮断し、大ファイルがメインモデルのコンテキストに流入するのを阻止します。
遮断(チェックルール Hook):無秩序なファイル全体の読み込みを阻止する Claude がファイル読み込みツールを呼び出そうとすると、下層のツールがファイルをコンテキストに読み込む前に、事前チェックスクリプト(Hook)が評価を行います。デフォルトの遮断条件は、「対象が単一ファイルであり、行数が厳密に350行を超えており、かつ読み込み範囲が指定されていない(開始位置 offset や行数上限 limit が設定されていない)」ことです。開始位置か行数上限のどちらか一方でもパラメータが指定されていれば、ピンポイントの範囲指定読み込みとみなされて通過が許可されます。Hook の価値は、条件を満たした段階でツール実行前に全読み込みを阻止し、ルールの遵守をモデル自身の自発性に委ねない点にあります。 - 02
案内(Skill ルート説明)
遮断時の通知が Skill を案内し、Claude は Skill に記載された引数仕様に従ってスクリプトを呼び出します。
案内(利用手順 Skill):明確な代替ルートを提示する 遮断が発生すると、ツールは Claude に対してエラー情報と誘導メッセージを返し、ファイルが大きすぎるため遮断されたこと、代わりに大ファイル読み込み機能を使うべきであることを伝えます。これを受けて Claude は、プラグインに付属している利用手順書(Skill)を参照します。そこにはスクリプトを呼び出す際の引数の形式や使用例が詳しく記載されています。Skill の役割は明確な道案内を提供し、モデルが遮断された後にあてもなく試行錯誤を繰り返したり、タスクがストップしてしまったりするのを防ぐことです。 - 03
引き渡し(Script ローカル通信)
ローカルスクリプトがコードを補助モデルに送信して処理させ、生成された要約とステータスを Claude に返して作業を続行させます。
引き渡し(ローカルスクリプト Script):パッケージングと呼び出し通信 Claude は手順書の案内に従い、ローカルでスクリプト(bulk-read)を呼び出します。スクリプトはローカルファイルを読み込み、明確な XML タグ(<file path="...">)でファイルの境界を区切ってパッケージ化し、クラウドの補助モードへ送信します。補助モデルはプロンプトの指示に従って構造化された事実関係を抽出し、スクリプトがその結果を Claude に返却して、Claude はそれをもとに分析を続行します。スクリプトがファイルのパッケージング、境界のマーキング、ネットワークリクエストを一括して引き受けてくれるため、メインアシスタントは引数を渡して呼び出すだけで済みます。(なお、bulk-readスクリプト自体はモデルの回答に対してテキストのクレンジングや要約のフィルタリングを行わず、出力の簡潔さは補助モード側のプロンプト規定に依存します。一方、コード生成スクリプトcode-writeには、Markdown のコードブロック記号を除去する処理が含まれています。)
仕組みの違いに関する注意点:この仕組みにおいて、Hook による強制遮断が設定されているのは大ファイルの読み込みのみであり、定型コードの生成には現状、事前遮断ルールがありません。Claude が生成スクリプトを使ってディスクに直接書き込むかどうかは、タスクを理解した上でそのスキルを進んで選択してくれるかに委ねられています。
大ファイル読み込み遮断ルールのデモ(check-file-size)
ファイルの総行数やしきい値行数を調整したり、読み込み範囲パラメータを切り替えたりすることで、Hook の遮断および通過の判定結果をリアルタイムで確認できます。
ローカルにすでに存在し正常に読み込めるファイルの Read ルールのみを再現しています。実際の読み込みは実行せず、Bash のエミュレーションは行いません。しきい値を 0 に設定することも有効です。
単一ファイルの読み込みルール:offset または limit のいずれかの範囲が指定されていればそのまま通過;範囲が未指定で行数がしきい値(デフォルト350行)以下であればそのまま通過;範囲が未指定で行数がしきい値を超えている場合は遮断し bulk-reader の利用を案内;パラメータは非負の整数である必要があります。
① 複数の小さなファイルをまとめて読み込んでも行数は合算されません;② 通過したからといってタスクが分散に適しているとは限りません;③ 遮断 Hook が設定されているのは読み込みのみで、コード生成には事前遮断がありません;④ 遮断通知が出ても Claude が確実に分散を採用するとは限りません。
90% はどこから削減されたのか:読み込みコンテキストは約90%減、ただし請求額の計算は別物
大ファイルを補助モデルに読み通してもらい、メインモデルには抽出した要点だけを返した場合、メインモデルに入るコンテキストは実際にどれくらい減るのでしょうか?
Dimitri 氏は、16.2万行のコードを含む Java プロジェクトで、4つの代表的な開発シナリオをテストしました:
代表的な3つのコード読み込みシナリオにおいて、分散前後に Claude メインアシスタントのコンテキストに入ったトークン数の推移を示します(全グループで 0〜75,990 の統一スケールを共有)。
単一の大ファイル分析
ソースコードとテストファイルのペア
複数サービスにまたがる複数ファイル分析
図中のデータはメインモデルのコンテキストに入ったトークン数を表し、元レポートによる削減率はそれぞれ 82%、94%、94% です。全文を補助モデルに送信して処理させる際にも利用料が発生するため、請求総額が90%減るわけではありません。また、定型コード生成でディスクに書き込まれた833行のコードは読み込みトークンではないため、本図には含まれていません。
| テストシナリオ | 対象コード量 | 分散前のメインアシスタント受信トークン | 分散後のメインアシスタント受信トークン | メインアシスタントのコード受信削減率(元レポート値) |
|---|---|---|---|---|
| 単一の大ファイル分析 | 4,014行 | 33,684 tokens | 5,737 tokens | 82% |
| ソースコードとテストファイルのペア | 7,408行 | 75,990 tokens | 4,148 tokens | 94% |
| 複数サービスにまたがる複数ファイル分析 | 1,281行 | 16,221 tokens | 821 tokens | 94% |
| 定型コード生成 | 参考コード 3,667行 | 40,614 tokens + 生成コード分のコスト | 833行のコードをディスクに直接書き込み | — (直接的なパーセンテージ表記なし) |
1行目の「単一の大ファイル分析」を例にとってみましょう:
- 分散前:Claude が標準の読み込みツールを呼び出し、4,014行のコード全文が会話に読み込まれ、33,684トークンを消費しました。
- 分散後:補助モデルがクラウド側で全文を読み込み、要約された要点のみをメインアシスタントに返却しました。このときメインアシスタントが受け取ったのは 5,737トークンで、元レポートに記録されたメインモデルへのコンテキスト流入量の削減率は 82% でした(2つのトークン数から直接計算すると約 82.97% になります)。テストファイルのペアやサービスをまたぐ分析のシナリオでは、報告された削減率は 94% に達しました。
テストレポートによると、3つの読み込みシナリオにおける削減率は平均して約90%でした。しかし、ここできちんと整理しておかなければならないのは、「約90%の削減」とは、あくまで大ファイル読み込み時にメインアシスタントのコンテキストに入る情報量の削減率を厳密に指しており、実際の開発における月々の請求総額が90%減るわけではないということです。
プロセス全体にかかる実際の利用料金は、総合的に計算する必要があります:
- メインモデルの入力コスト削減:大ファイルの全読が外部へ分散されることで、メインモデルのコンテキストに入るテキスト量が大幅に減少します。長いファイルの内容は一度会話に入ると、その後の入力でもコンテキスト領域を圧迫し続ける可能性があります。ただし実際の費用は、モデルのキャッシュ機能、コンテキスト圧縮の仕組み、プラットフォームごとの課金ルールにも左右されます。
- 長文生成コストの転換:定型コードを生成する際、ファイルをディスクへ直接書き込むことで、メインモデルが長大なコードを出力するコストを抑えられます。
- 補助モデルの呼び出しコストが発生:クラウドの補助モデルが数千行のテキストを読んだりコードを生成したりする際にも、それぞれの単価に応じた利用料が発生します。
- ネットワーク転送と処理の所要時間:元記事の著者の観察によると、1回の委譲処理には通常10〜30秒かかります(ネットワーク転送と補助モデルの処理時間を含みます)。
- その後の確認や詳細な分析には依然としてメインモデルが必要:複雑なロジックの調査、重要なコードの追加読み込み、そしてその後の修正作業では、依然としてメインモデルの費用が消費されます。
なお、デフォルトで設定されている350行というしきい値は、運用の都合上設定された経験的な目安であり、コードの複雑さを測る絶対的な基準ではありません。開発者は環境変数(SHUNT_MIN_LINES)を使って自由に調整できます。
なぜすべてを外部委託できないのか:修正やデバッグはやはり Claude 自身が見る必要がある
補助モデルが長いテキストを処理することでコンテキストを効果的に節約できるのなら、なぜすべてのタスクを外部に丸投げしないのでしょうか?先ほどの決済 SMS の例に戻ると、補助モードの限界がよく見えてきます:
補助モデルが返す要点は、関連するメソッドを素早く特定するのには役立ちます。しかし、次のタスクが「コードの修正」や「厳密なロジックの調査」である場合——例えば、引き落としが完全に成功したときだけ確実に SMS 送信がトリガーされるのか、ネットワークの乱れで再試行した際に重複して SMS が送られてしまわないか、といったビジネス上の処理順序や境界条件に関わる細部については、簡潔な要約だけでは完全な証拠になり得ません。
したがって、確実なアプローチは次のようになります:「まず補助モデルに大まかな調査をさせて手がかりを特定させ、メインアシスタントがその重要な箇所に絞ってピンポイントで範囲指定読み込み(例えば該当メソッド周辺の約20行だけを読む)を行い、本物のコードをコンテキストに読み込んでから判断する」という方法です。もし確認ロジックや再試行の仕組みが別のメソッドに分かれている場合は、手がかりをたどってさらにピンポイントで読み足していきます。読み込み範囲が指定されているためチェックルールはそのまま通過し、メインアシスタントは本物のロジックを確認でき、かつ3,200行ものファイルを丸ごと読み込まずに済みます。
実際の運用において、補助モードにそのまま頼るべきではないケースが3つあります:
- コードを直接修正する場合や厳密な条件を確認する場合:補助モードが提供するのは場所特定の手がかりだけです。コードの細かな調整、条件の検証、実際の書き換えを伴う場合は、必ずメインアシスタント自身が本物のソースコードを読まなければなりません。
- 潜在的な不具合や複雑なアーキテクチャを調査する場合:著者の実際のテストにおいて、補助モデルが見落としてしまった目立たないスレッドセーフ(並行処理における安全性)の不具合を、Claude は正しいコンテキストを与えられるとわずか数秒で発見しました。スレッドセーフとは、平たく言えば「複数の処理が同時に同じデータにアクセスしても、システムが正常に動作し、データの整合性が保たれること」を指します(この保証がない場合、例えば同時に複数の取引が発生した際に、同期保護されていない共有の口座残高を同時に読み書きして金額が狂ってしまうような現象が起きます。これは一般的なわかりやすい例えであり、原著者がテストで具体的な業務コードを公開したわけではありません)。このような深いロジックや並行処理の相互作用の推論は、現在の役割分担においては依然としてメインモデルに委ねる必要があります。
- 行数の少ない小さなファイルの場合:外部へのリモート呼び出しには通常10〜30秒かかります。100〜200行程度の小さなファイルであれば、直接読み込んでも消費するコンテキストはわずかであり、わざわざリモート呼び出しを行って待たされるメリットはあまりありません。
実際に導入するには:3つのステップで始め、まずは小さなタスクで検証する
この仕組みを導入する前に、動作の特徴と前提条件を理解しておく必要があります:
- 1回ごとのステートレス呼び出しと追加質問の仕組み:AiKA モードは1回ごとに完結する使い捨て(エフェメラル)の呼び出しであり、クラウド側には複数ターンにわたる会話コンテキストは保持されません。もし開発者が「これらのファイルの中で、他にデータベースを操作しているメソッドはあるか?」と追加で質問したい場合、スクリプトはファイルと新しい質問を補助モデルへ再送信する必要があり、補助モデルは再びその分の料金で処理を行います。定型コード生成において、直前に生成したテスト用例をもとに追加のテストを書きたい場合は、次のコマンドで新しく生成されたファイルを参考ファイル引数(
--reference)として渡すだけで対応できます。 - プラットフォームの前提条件:この仕組みは、チームが Spotify Portal プラットフォームを導入し、AiKA 機能を有効化していることが前提となります。手元にクライアントプラグインをインストールしただけでは、クラウド側の実行環境やモデルのアカウントが自動的に用意されるわけではありません。
導入の手順は3つのステップに分かれており、各ステップに明確な確認ポイントがあります:
- ステップ1:環境の準備とプラグインの認証:ローカルに JSON 解析ツール
jqをインストールし、Claude Code にportalプラグインとshuntプラグインをインストールします。新しく立ち上げたセッションで/portal:setupを実行し、ログイン認証を完了させます。確認ポイント:ターミナルにログイン認証成功のメッセージが表示され、Portal プラットフォームへ指示を送信するための基礎的な通信路が手元に整っていること。 - ステップ2:クラウド補助モードの確認または作成:クラウド上に
bulk-readerとcode-writerという2つのモードが存在するかを確認します。もしプラットフォームに用意されていない場合は、仕様に従って作成し、対応するモデルを紐付けます。確認ポイント:コマンドラインからこれら登録済みの2つのモード名を正しく検索・一覧表示できること。 - ステップ3:最小タスクでの検証と安全確認:遮断が正しく機能するかを検証するため、現在設定されているしきい値(デフォルト350行)を超えるファイルに対して、範囲を指定せずにあえて全読み込みを試みます。確認ポイント:読み込みリクエストが Hook によって遮断され誘導メッセージが表示されること、続いて Claude が
bulk-readスクリプトを呼び出し、クラス名とメソッド名で構成された要点を返してくること、そしてその要約内容が元のコードの重要事項と合致していること。定型コードを生成する際は、保存先パスを指定した後、ファイルが実際にディスクに書き込まれているかを確認し、バージョン管理の差分比較(Git Diff)や単体テストを通じて生成されたコードをレビューします。
真に再現可能なアプローチ:「いつ切り離すか」と「誰が実行するか」を分離する
このソリューションから学べる最大のポイントは、明確なエンジニアリング上の役割分担を提供している点です。すなわち、「いつ分散させるか」と「誰が実行するか」を切り離した(疎結合にした)ことにあります。
- ローカルのクライアントプラグインが「いつ分散させるか」とプロセスの制御を担当する:手元の門番として機能し、しきい値を超える単一ファイルの全読み込みを検知した際に遮断して誘導します。同時に、入力の整理、通信の開始、結果の返却を担当し、コード生成時には結果をローカルディスクに書き込みます。
- クラウドのモードが「どのように実行するか」を担当する:タスクのプロンプトを設定してモデルを紐付け、長いテキストを受け取った後に事実の抽出やコード生成に専念します。
このように責務を分離することで、ローカル側の呼び出し手順とバックエンドの具体的なモデルが互いに独立します。バックエンドでモデルを変更しても、ローカルスクリプトは標準コマンドを通じて指定されたモードと通信し続けるため、呼び出し側のロジックを変更する必要がありません。このアーキテクチャは、エンジニアリングの観点から見ても優れた拡張性を備えています:
- プロジェクトやツールをまたいだ再利用: クラウド側の読み込み・生成モードは汎用的な機能であり、Java プロジェクトだけでなく、チーム内の他の言語のプロジェクトからもそのまま利用できます。コマンドラインや API 呼び出しをサポートする開発ツールであれば、どんなツールからでもこのバックエンドモードを再利用可能です。他のツールでも自動遮断を実現したい場合は、そのツールの拡張機能に合わせて手前のチェック層を適合させるだけで済みます。
- モデルの変更と設定の優先順位: チームがクラウド側でモードに紐付いているモデルを変更すれば、そのモードを利用するすべてのユーザーが即座にアップデートの恩恵を受けられ、開発者一人ひとりが手元のスクリプトを書き換える必要はありません。モード名の解決には優先順位ルールがあり、個人が作成した同名のモードは共通のモードよりも優先して適用されます。ただし、モード名と入出力の取り決めにおける互換性を維持する必要があり、モデル変更後には出力品質のサンプリング検証を行うことが推奨されます。
- さらなるモード拡張の構想:
著者は記事の最後で、この分散アプローチはさらに多くの長文シナリオに応用できると述べています。例えば、ドキュメント作成用のドキュメントモード(
doc-writer)、コードレビューの要約を生成するレビュアーモード(reviewer)、多言語翻訳(異なる言語版の作成)を担当する翻訳モード(translator)などです。(これらは著者のブログで提案された将来的な構想であり、現在のプラグインにあらかじめ組み込まれている機能ではありません。)
開発プロセスにおいて、重たい長文の読み込みや定型コードの記述は補助モデルに分担させ、メインモデルは核心となるロジックの推論や重要な意思決定に集中させる。そして、処理を分散させた後も品質チェックとコスト評価を一貫して行うこと。そうすることで、開発効率とトークン費用のバランスをより賢く取ることができるようになります。
開発者向け付録:インストールと呼び出しの完全コマンド集
(開発者以外の方はこのセクションを読み飛ばしてかまいません)
1. インストールと認証
ローカル環境にコマンドライン用 JSON 解析ツール jq がインストールされていることを確認してください(macOS の場合は brew install jq でインストールできます)。
ターミナルで公式マーケットプレイスを追加し、プラグインをインストールします:
# 公式プラグインマーケットプレイスのソースを追加
claude plugin marketplace add spotify/portal-ai-plugins

# Portal 接続ツールと shunt 分散プラグインをインストール
claude plugin install portal@portal
claude plugin install shunt@portal
インストールが完了したら、新しい Claude Code セッションを開始し、認証コマンドを実行してログインを完了します:
/portal:setup
2. 補助モードの確認と作成
以下のコマンドを実行し、現在の環境に対応するモードがすでに設定されているか確認します。なお、list-modes コマンドはモードが存在するかどうかを確認するためだけのものであり、実際に紐付けられている基盤モデルを確認するには、現在のインスタンスがサポートしている設定画面等で照合する必要があります:
portal-cli actions aika:list-modes --json --input '{"search": "bulk-reader"}'
portal-cli actions aika:list-modes --json --input '{"search": "code-writer"}'
事前に設定されていない場合は、コマンドを使って作成できます:
# 大ファイル読み込みモードを作成
portal-cli actions aika:create-mode --input '{
  "name": "bulk-reader",
  "description": "Bulk file reader for code analysis",
  "instructions": "You are a precise code analyst. Read the provided files and answer the question concisely. Output structured bullets only. No greetings, no prose, no preambles, no summaries. Lead every bullet with the exact name, type, or line number. Use nested bullets for details. Skip anything the caller did not ask for.",
  "tags": ["coding", "delegation"],
  "resource_limits": { "temperature": 0.2 }
}'

# 定型コード生成モードを作成
portal-cli actions aika:create-mode --input '{
  "name": "code-writer",
  "description": "Boilerplate code generator",
  "instructions": "You generate code files based on a spec and reference files. Match the existing patterns, conventions, naming, and style exactly. Output only the code — no explanations, no markdown fences unless asked. If the spec is ambiguous, make reasonable choices that match the patterns in the reference code.",
  "tags": ["coding", "delegation"],
  "resource_limits": { "temperature": 0.2 }
}'
3. スクリプトの呼び出しと穴埋めテンプレート
普段のやり取りにおいて、プラグインは完全自動でスケジューリングされるわけではありません。Hook は条件に合致する読み込みを自動で検知・遮断し、Claude に対しスキルに沿ってスクリプトを呼び出すよう促します。一方、コード生成(code-writer)は Claude がタスクを認識できるかどうかに依存しており、自動実行が保証されているわけではありません。ターミナルから手動で呼び出す場合は、/path/to/shunt をお使いのローカルプラグインの実際のインストールパスに置き換えてください。
シナリオ1:大ファイルの分析
/path/to/shunt/scripts/bulk-read --question "これら2つのクラスはそれぞれどのような役割を担い、どのようにやり取りしていますか?" --paths src/Client.java src/RetryPolicy.java
シナリオ2:定型コード生成(実際の穴埋めテンプレート)
以下は穴埋め用のテンプレートであり、そのまま実行することはできません。プラグインのパス、参考ファイルのパス、保存先ファイルのパス、および spec 内のすべてのプレースホルダーをご自身の環境に合わせて置き換えてください(パス前後の引用符は残してください)。スクリプトは spec と reference のみを送信し、対象クラスのソースコードを自動で読み込むことはありません。両者を合わせて、対象となるインターフェース、動作、スタイルを十分に指定する必要があります。
/path/to/shunt/scripts/code-write \
  --spec "【対象言語とテストフレームワーク】:<例:Java / JUnit 5>
【テスト対象と依存スタブ】:<テスト対象のクラス名を記入。スタブやモックが必要な場合は名前と型を指定し、具体的な生成・注入方法は本プロジェクトの構造に合わせて記入>
【テスト対象メソッドと期待されるロジック】:<テスト対象メソッドのシグネチャ、入力例、主な期待結果を記入>
【異常系分岐と特殊な境界条件】:<例外を発生させる入力条件と期待される例外の型を記入>
【アサーションと検証基準】:<重要なアサーション内容と依存モックの呼び出し検証ルールを記入>" \
  --reference "/path/to/ReferenceTest.java" \
  --target "/path/to/GeneratedTest.java"
4. 開発時の注意点と境界条件
- 確認なしの上書きリスク:
code-writeで--targetを指定した際、指定先のファイルがすでに存在している場合、一切の再確認なしに直接上書きされます。必ず新しい保存先ファイル名を指定してください。なお、--targetを指定しなかった場合、生成されたコードは標準出力に表示され、メインモデルのコンテキストに入ります。 - 生成後の確認手順:コードが生成された後、すぐに実行してはいけません。以下の確認手順を踏むことを推奨します:1. エディタで新しく生成されたファイルを開き、ロジックを確認する;2.
git status --shortを実行して新規ファイルのパスを確認する;3.git diff --no-index /dev/null "/path/to/GeneratedTest.java"(パスは実際の新規ファイルパスに置き換える)を実行してコードの詳細をレビューする;4. ローカルでのコンパイルと単体テスト(mvn testやnpm testなど)を実行する。 - コマンドライン引数の長さ制限:コマンドライン引数は argv を通じて渡されるため、スクリプトには OS の
E2BIG(ARG_MAX) エラーを回避するためのSHUNT_MAX_PAYLOAD_BYTES保護(macOS は 400,000 バイト、Linux は 120,000 バイト)が組み込まれています。大量のファイルを分析する必要がある場合は、複数回に分けて渡してください。 - タイムアウトの区別と対処:ブログ記事では Portal の1回の呼び出し上限は30秒とされています。現在のクライアント側のデフォルト待機時間は180秒(
SHUNT_TIMEOUT_SECONDS)で設定変更可能です。これら2つは異なる制限であり、クライアント側の時間を延ばしたからといってサーバー側の上限が伸びたと判断することはできません。クライアント側のタイムアウトであることが確認できたら、必要に応じて調整するか、タスクを小さく分割してください。 - コマンドライン読み込みチェックルールの限界:
check-bash-readはcat/head/tail/less/moreなどのコマンドを対象にチェックを行いますが、コマンドにパイプ記号|やリダイレクト記号>が含まれている場合はそのまま通過させ、パイプ以降の実際の出力行数までは検査しません。これはコマンドの特徴に基づいた案内ルールであり、回避不能なセキュリティサンドボックスではありません。 - 個人モード優先の原則:Portal は個人モード優先の原則(個人モード > チームモード > インスタンス公開モード)に従います。個人が同名のモードを作成した場合、システムは個人バージョンを優先して呼び出し、チームやグローバル公開バージョンの更新は自動同期されません。
- 再テスト用リソースと課金ログの違い:オープンソースリポジトリにある TypeScript の再テストコードでは、文字数を4で割ってトークン数を大まかに見積もっており、Java の元の課金ログそのものではありません。
参考資料とオープンソースプロジェクト:
- 元記事ブログ:Portal by Spotify cut my Claude Code token usage by 90%
- 公式オープンソースプラグインリポジトリ:GitHub - spotify/portal-ai-plugins (shunt ディレクトリ)
- Spotify Portal 公式ドキュメント:AiKA Modes コア機能とプラグイン設定ガイド
Claude Code コンテキスト分散導入・持ち帰り用ツールキット
プロジェクトへの導入を支援する2つのツールを収録しています:プロジェクト内で直接読み込みと分散前後のメインモデルコンテキスト、ワーカー消費、遅延、コード品質を比較できる未記入の評価シートと、委譲前のチェックリストおよび標準呼び出し構文を含む編集可能なテンプレートです。
完全なツールキットをダウンロード実践用持ち帰り資料
Markdown をスクロールして確認し、コピーしてチーム向けに調整できます。
Markdown を読み込み中…