Google Research、時系列基盤モデル「TimesFM-3」を公開。未来予測が可能に
予測されるのは抽象的な出来事ではなく、複数の時系列カーブと将来の既知計画によって決まる数値です。販売量、来客数、負荷、価格、そしてそれらの変化の不確実性も対象です。
- TimesFM-3は3.3億のパラメータと1兆以上の学習時点を持ち、複数ターゲット、履歴共変量、将来既知の共変量をネイティブにサポートします。
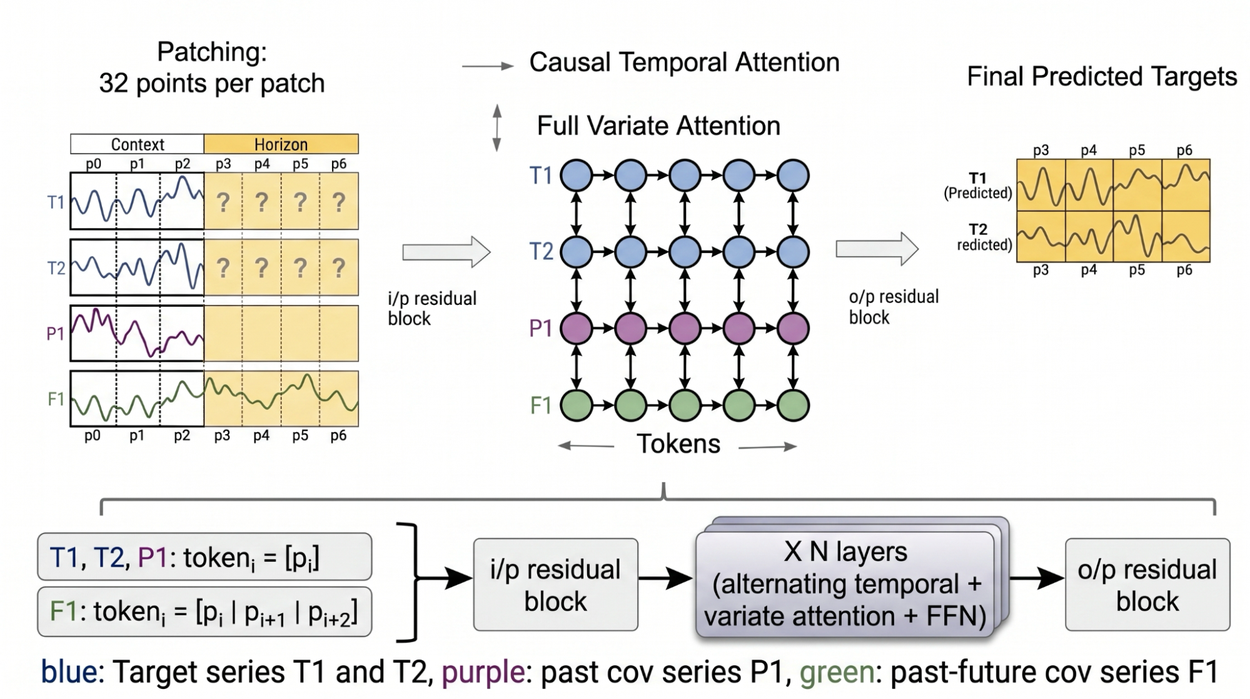
- モデルは時間と変数を2次元グリッドに整理し、2つの軸で交互に情報を交換します。その後、1回の順伝播で予測区間全体と9つの分位点を生成します。
- 公式レポートによると、GIFT-Eval、FEV-Bench、TIMEの点予測と確率予測の平均ランキングで首位を獲得しました。ただし、平均ランキングだけでは業務でのバックテストには代わりません。
- コードは公開されていますが、3.0のデフォルトの事前学習済み重みは現在、非商用・非生産用途に限定されています。
Google Research は、時系列基盤モデル「TimesFM-3」を発表しました。これは TimesFM シリーズとして初めて、多変量予測にネイティブ対応したバージョンです。このモデルは、相互に影響し合う複数の時系列を同時に予測できるほか、来客数、天気、プロモーション、祝日などの外部情報も予測に組み込めます。
理論上、これは未来を予測できることを意味します。ここで言う「未来」とは、売上、来客数、デバイス負荷、価格など、時間とともに変化する数値のことです。特定の出来事を予言するわけではありません。結果が複数の連動する曲線と、すでに判明している将来計画に依存する場合、タスクに特化した微調整なしで使える汎用モデルが、そのまま予測を行えるのでしょうか。TimesFM-3 は、時間と変数を二次元のグリッドに整理し、そのグリッドの二方向で情報を交互にやり取りすることで、この問いに答えています。
1. 単変量の限界を超え、真の多変量予測へ
以前の課題: TimesFM-2.5 の基盤モデルは、主に単一のターゲット系列の履歴データに基づいて未来を予測していました。しかし、現実の予測が一本の曲線だけに依存することはほとんどありません。来月のアイスクリーム売上を予測するには、過去の売上だけでなく、コーンやシロップの売上、過去の来客数、天気予報、プロモーション予定、祝日などを考慮する必要があります。
TimesFM-2.5 は後に XReg を通じて共変量を組み込むことができましたが、これは TimesFM-3 のネイティブな多変量機能とは異なります。前者は単変量基盤モデルに外部回帰を追加するものですが、後者は事前学習段階から複数のターゲット系列と共変量がどのように一緒に変化するかを学習します。
現在の能力: TimesFM-3 は 3.3 億のパラメータを持ち、1兆を超える実データおよび合成データの時点で事前学習されています。ゼロショット予測に対応しており、現在のタスクに特化した微調整なしで、次の三種類のデータを直接受け取ることができます。
- 複数のターゲット: 互いに影響し合う複数の時系列(例:異なるブランド、店舗、カテゴリの売上)を同時に予測します。
- 履歴共変量: 過去にのみ既知の情報(例:過去の来客数、デバイスの状態)。
- 未来既知の共変量: 履歴から予測期間まで及ぶ情報(例:確定済みのプロモーション、祝日、現時点で取得可能な天気予報)。
「未来に既知」というのは、予知を意味するわけではありません。祝日やプロモーションの予定は事前に決定できますが、天気予報自体には誤差が含まれます。モデルが受け取るのは、予測時点で利用可能な情報です。また、ゼロショットは、店舗、デバイス、業務系列ごとにモデルを再学習する必要がないという意味だけであり、データクリーニング、変数選択、時間軸の調整、バックテストは依然として必要です。
2. 時間と変数を二次元グリッドとして整理
多変量とは、複数のデータ列を単純に貼り合わせることではありません。各時点をそのまま Transformer に入力すると、系列が長くなるにつれて計算量が急増します。TimesFM-3 は TimesFM のアプローチを踏襲し、連続する32の時点を一つのパッチにまとめ、各パッチをトークンにエンコードします。また、異なる単位の系列はそれぞれ正規化され、数百円単位の売上と0から1の範囲のオン・オフ変数が、その数値範囲の違いだけで不均衡にならないようにします。
ターゲット系列と過去のみ既知の共変量の場合、各トークンは通常のパッチに対応します。未来も既知の共変量には、「未来を見る」ための追加ステップがあります。つまり、現在のパッチと後続の未来パッチを結合します。これにより、モデルが特定の時点を処理する際に、予測期間中に予定されているプロモーションや祝日を確認できるようになります。

メインの処理に入ると、アテンションは二つの方向で交互に行われます。
- 時間軸に沿って、各系列は自身の過去のみを参照します。これは因果アテンションであり、トレンド、周期的パターン、これまでの変化を学習しつつ、ターゲット系列が未来の実際の値を覗き見ることを防ぎます。
- 変数軸に沿って、同じ時点で他の系列を参照できます。アイスクリームの売上はコーンの売上を参照でき、店舗の売上は来客数を参照できます。また、ターゲット系列はプロモーションや天気などの共変量も読み取れます。
横方向は「この曲線が過去にどう進化したか」を担当し、縦方向は「同じ時点で他の曲線がどうなっているか」を担当します。多層でこれを交互に行うことで、モデルが捉えるのは、もはや独立した数本の曲線ではなく、時間とともに共に変化する関係性のセットです。
これは、多変量モードが単変量モードよりも正確になる可能性がある理由も説明します。改善は、追加情報と系列間の関係からもたらされます。複数の系列に安定した関連性がなかったり、未来共変量自体が信頼できない場合、多変量の入力は自動的には利益をもたらしません。
3. 一度の順伝播計算で予測区間全体を生成
以前の TimesFM は、まず一つのパッチを予測し、その結果を入力に戻して次のパッチを予測する、というプロセスを繰り返していました。予測期間が長くなるほどループ回数が増え、遅延と計算コストが増加し、初期に生じた誤差が後続の予測に影響を与える可能性もありました。
TimesFM-3 は、連続パッチマスキングの考え方を応用し、予測区間全体を最初からモデルに入力します。
- 未来のターゲット値と過去のみ既知の共変量は、その未来の値が不明なため、マスクされたプレースホルダーに置き換えられます。
- 祝日、プロモーション計画などの未来既知の共変量は、可視のまま保持されます。
- 時間アテンションと変数アテンションは、同じグリッド上で履歴領域と予測領域の両方を処理します。
- モデルは、予測区間全体におけるすべてのターゲット系列の結果を一度に埋めます。
公式の PyTorch 実装では、ユーザーが要求した予測長を出力パッチの整数倍に切り上げ、model.decode() を一度呼び出した後、余分な位置を切り取ります。ここでの「一度」はモデルの順伝播プロセスを指しており、計算量が予測長と無関係であることを意味するわけではありません。予測区間が長くなれば、同じ計算に投入されるトークンも増えます。
出力は、単に一本の確定的な線に見えるものだけではありません。TimesFM-3 は、各ターゲット、各未来時点に対して、10パーセンタイルから90パーセンタイルまでの9つの分位数を提供します。中央値は点予測として使用でき、低い分位数と高い分位数は不確実性の区間を構成します。予測期間が遠いか、シグナルが不安定な場合、その区間は通常より広くなります。
4. 既知の将来計画を予測に組み込む
Google は、合成されたアイスクリーム売上データのケーススタディでこのメカニズムを紹介しています。赤い線は履歴売上のみを考慮した単変量予測で、主に毎週の変動を延長したものです。青い線は将来のプロモーション日も読み取るため、予定されたプロモーション日の売上予測が高くなります。
入力条件を切り替えて、同じ予測期間内の曲線の反応を観察します。
仕組みのデモです。曲線は標準化した参考値を使い、TimesFM-3 を呼び出さず、実際のビジネス予測も生成しません。

説明用の合成事例です。約20% は例における関係性であり、実際のプロモーションの一般的な効果ではありません。
この例では、履歴データにプロモーションにより売上が約20%増加するという関係を設定しています。多変量モードは、履歴のプロモーション日と売上の共変動からこの関係を学習し、将来予定されているプロモーション日にそれを適用します。月全体で累積すると、青い線はプロモーション計画を無視した赤い線よりも、このケースで想定された売上の動きに近くなります。
この図は、モデルが未来の共変量を利用して、コンテキスト内に既に存在する関係を復元できることを示しています。しかし、現実のプロモーションが一般的に20%の増加をもたらすことを証明するものではなく、プロモーションが売上増加を引き起こすのかという因果関係の識別問題を解決するものでもありません。実際のビジネスでは、割引率、在庫、競合他社の活動、プロモーション対象の変更なども考慮する必要があります。
5. 三つのベンチマークで多変量機能の有効性を確認
Google は GIFT-Eval、FEV-Bench、TIME の各ベンチマークで、TimesFM-3、TimesFM-2.5、Chronos-2、Toto 2.0、TiRex などの時系列基盤モデルを比較しました。図の横軸は点予測タスクの平均順位、縦軸は確率予測タスクの平均順位です。どちらの数値も低いほど良いため、グラフの左下に位置するほど総合順位が高いことを示します。
横軸=点予測の平均順位。縦軸=確率予測の平均順位。左下ほど良好です。


平均順位は、採用されたタスクとモデル群における全体像を示すもので、すべてのデータセットやビジネス指標で最良という意味ではありません。
三つの図すべてで同じ結果が見られました。TimesFM-3 の多変量モードは、常に最も左下に位置しています。変数間情報と共変量をすべてオフにして単変量予測としてのみ使用した場合でも、その平均順位は、図中の他の再現可能な基盤モデルよりも優れているか、あるいは同等です。多変量モードを有効にすると、ランキングはさらに改善します。
この結果には二つの価値があります。第一に、モデルは多変量機能と引き換えに単変量機能を犠牲にしていません。共変量がない場合でも、汎用予測モデルとして使用できます。第二に、追加の変数は、プロモーションの例だけでなく、複数のタスクにわたって安定した平均的な改善をもたらします。
ただし、平均順位は差異を隠すこともあります。これはタスク全体でのモデルの全体的な位置を示すものであり、すべてのデータセットで勝つことを意味するものではなく、各企業の損失関数、在庫制約、エラーコストを網羅するものでもありません。図に示されているのは、発表時点で含まれていたモデルの集合です。ビジネスデータでトレーニングされた専用モデル、古典的な統計モデル、またはその後登場した新しいモデルは、同じバックテスト期間内で改めて比較する必要があります。
6. 未来を予測できることと、すぐに本番稼働できることは別
TimesFM-3 は、GitHub のコード と Hugging Face の重み を提供しています。公式インターフェースは、「変数の数 × 履歴の長さ」という形式のターゲット配列を受け取ります。未来既知の共変量は、「履歴の長さ + 予測の長さ」をカバーする必要があります。出力には、各ターゲット系列の点予測と9つの分位数が含まれます。
実際に試す前に、以下の四点を確認する必要があります。
- データが同じ時間頻度で整列しているか、欠損値、外れ値、未来共変量の生成時刻が明確か。
- 共変量が予測時点で実際に利用可能か。事後的に判明したデータを未来既知の情報として偽装しないこと。
- ビジネス上重要なエラー、在庫コスト、リスク指標が、ローリングバックテストで現在のベースラインを上回るか。
- 入力規模が現在の実装に適しているか。公式コードの最大履歴長は15,360時点です。ベンチマーク評価器は一回の順伝播で最大32変数まで対応し、それ以上のターゲットはチャンクに分割され、共変量が多すぎる場合はサンプリングされる可能性もあります。
ライセンスはより厳しい制約となります。リポジトリのコードは Apache-2.0 ですが、TimesFM 3.0 のデフォルトの事前学習済み重みは現在、別途非商用ライセンスが適用されており、非商用・非本番用途に限定されています。研究検証のために重みをダウンロードすることは問題ありませんが、これを有料製品や本番予測システムに直接組み込むことはライセンスの範囲外です。
Google は、TimesFM-3 の BigQuery 統合を数週間以内に展開すると述べています。発表当日にすぐ試せる AI.FORECAST は依然として TimesFM-2.5 の単変量機能です。したがって、TimesFM-3 が現在最も適しているのはローカルでの研究とビジネス向けのバックテストであり、「コードと重みが公開された」ことを「企業が無条件で本番稼働できる」と書くことはできません。
TimesFM-3 は、多変量予測を「ビジネスごとに個別にモデルを構築する」段階から、「まず汎用モデルで直接バックテストする」段階へと前進させました。これは試行のハードルを下げると同時に、利用者に新たな責任をも課します。つまり、予測時に本当に利用できる変数は何か、系列間の関係は持続するか、平均的なベンチマーク上の改善が自社の業務でも再現するか、ということです。モデルはより多くの現実的な情報を予測に取り込みましたが、最終的な判断は実データに基づいて下される必要があります。