Wan Streamer:聞きながら見ながら話すリアルタイムAI
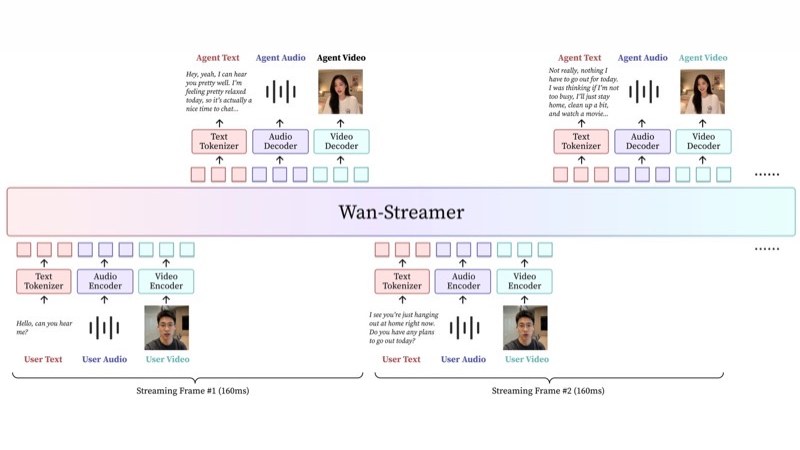
- Wan Streamer v0.1は、ネイティブにストリーミング対応した端末間(end-to-end)の対話型基盤モデルで、同一のTransformer内で言語・音声・映像を入力と出力の両方としてモデル化し、block-causal attention(ブロック因果注意)で調整しながら、入力が来た端からストリーミングで生成する。
- モデル自身が応答を計算する時間は約200ms、これに双方向のネットワーク遅延350msを加えた総対話遅延は約550ms。25fpsでは、最短のストリーミング処理単位はわずか160msしかない。
- 公式は、単一の端末間Transformerで同期した音声・映像を出力し、かつ総遅延を1秒以内に抑えられる唯一のモデルだと謳っている。既存のシステムは、音声のみを出力する(GPT-4o Realtime、豆包、Gemini Live)か、ASR+LLM+TTS+アニメーションという一連のモジュールを繋ぎ合わせるかのどちらかだ。
- 現行のv0.1は解像度がまだ192pしかなく、位置づけは端末間設計のコンセプト実証(PoC)だ。公開されているキャラクターデモはすべて編集なしの事前収録モデル出力であり、オンラインのリアルタイム体験ではない。
- 比較図の遅延数値には異なる測定基準が混在している。上のグループは端末間の対話クローズドループ、下のグループはレンダリング段階のみ(外部のLLM/ASR/TTSを含まない)を計算したもので、公式は注記を踏まえて割り引いて見るよう注意を促している。
1つのモデルでリアルタイム音声・映像対話を実現
通义万相(Wan)チームが先日、Wan Streamer v0.1というリアルタイム音声・映像対話モデルを発表した。リアルタイムで対話できるAIは今や珍しくないが、あなたの顔を見ながら、話を聞きながら、口を開いて応答し、しかも自分自身が動く顔を持っている——そんなAIはほとんど存在しない。Wan Streamerはこれを1つのモデルに凝縮した。
なぜ注目に値するか:現在リアルタイムで対話できるシステムは2種類に分かれる。1つは応答は速いが音声のみで見える顔がないもの(GPT-4o Realtime、豆包、Gemini Live)、もう1つは顔はあるが外部のASR、言語モデル、TTS、アニメーションという一連のモジュールで組み立てられているものだ。公式はWan Streamerを、単一の端末間Transformerで同期した音声・映像を同時に吐き出し、かつ総遅延を1秒以内に抑えられる唯一のモデルだとしている。
4本のキャラクターデモ+リアルタイム画面録画
以下の4本のデモはすべて同一のモデルによるもので、人物・声・シーンを変えただけだ。まず効果を見てから、原理を説明する。
以下の映像は少し違う:実際にオンラインで行われた対話の画面録画で、リアルタイム応答の全プロセスを確認できる。
旧来のやり方はなぜ遅いのか:バトンリレー方式で、各段階が待ち時間を生む
旧来のやり方が遅いのは、一連の独立したモデルを繋ぎ合わせたパイプラインだからだ。まず音声をテキストに変換し(ASR)、そのテキストを言語モデルに渡して回答を考えさせ(LLM)、回答を音声に合成し(TTS)、最後に顔を動かす(アニメーションレンダリング)。工程を1つ通過するたびに前段の受け渡しを待つ必要があり、待ち時間が段階ごとに積み重なり、認識のズレとリップシンクのズレによる誤差も蓄積していく。
知覚・推論・計画・生成をまとめて処理
端末間方式は、1人の人間が聞き終わったらすぐに口を開くようなもの。カスケード方式は伝言ゲームのようなもので、1人経由するたびに一拍遅れ、話が間違って伝わることもある。中間層はまず音声/映像をテキストに変換し、そのテキストで下流を動かす——テキストは各モジュール間に隠れた中継の橋である従来のカスケード方式では、テキストは個別に学習された複数モジュール間の中間表現だった。Wan Streamerはこの中継の橋を必要とせず、モダリティ同士が直接結合する。。橋が多いほど遅く、誤りも起きやすい。
原文はこの点について1つの判断を下している:リアルタイム音声・映像対話は「マルチモーダル理解」と「マルチモーダル生成」を単純に足し合わせたものではなく、本質的に全二重(フルデュプレックス)である。したがって、ストリーミング可能性はローンチ後のエンジニアリング最適化ではなく、モデリング上の制約なのだ。オフラインエンコーダー、双方向デコーダー、ターン制の対話の上に構築されたシステムは、いくらエンジニアリングでチューニングしても真の低遅延な全二重を取り戻すことはできない。これがまさに次のセクションで掘り下げるコアの部分だ。
そのやり方:1つのモデルが「聞く」から「話す」まで全部引き受ける
Wan Streamerの核心は一言で言える:視覚・音声・テキストの入力トークンと出力トークンを1本のシーケンスに交互に並べ、1つのTransformerに処理させる。block-causal attentionで調整し、入力が来た端から計算して吐き出させるのだ。
単一の端末間Transformerが、外部のVAD、ASR、言語モデル、TTS、アニメーション、映像生成といったモジュールを排除し、知覚・推論・応答計画・音声と映像の生成・応答タイミング・ターン管理のすべてを、同一の永続的な状態の中でまとめて最適化する。低遅延、全二重、同期した音声・映像という3つの特性は、すべてここに根がある。
モデルは対話を1本の連続した因果的な流れとして捉える:あなたの観測とモデルの応答が、共に現在のコンテキストを更新していく。各ストリーミング単位ごとに、その時点で得られるユーザーの観測をエンコードし、双方の完全な因果履歴に基づいて次の応答を予測する。言語による応答は離散トークンの列で、next-token予測で学習される。音声と映像による応答は連続的な潜在空間(latent space)に存在し、条件付きflow matchingでまとめて生成される。同一のクリーンなコンテキストを条件として、音声・動作・見た目・シーンの変化を1つの結合した全体としてノイズ除去していくのであって、それぞれ別々に生成してから繋ぎ合わせるわけではない。

このストリームを支えるため、スタック全体が設計当初から因果的(causal)に作られている:ストリーミングlatentエンコーディング用の厳密な因果音声・映像VAE、因果音声・映像エンコーダー、因果音声・映像デコーダー、そしてblock-causal attentionによって調整される時系列因果Transformerだ。ノイズ除去の後、推定されたクリーンなlatentはそのまま履歴に追加され、後続の単位のコンテキストとなる。因果デコーダーがそれらを最終的な音声・映像へとレンダリングする。この設計によって消し去られた外部モジュールは以下の通りだ:
「聞きながら話す」、いつでも割り込み可能をどう実現するか
人間と世界とのやり取りは、生まれつきストリーミングかつ全二重である:私たちはまず聞き終わってから改めて考え、最後に答えるのではなく、見ながら聞きながら話し、いつでも一時停止したり割り込んだりする。知覚と表現は音声・映像の時間スケールの上で重なり合って発生する。リアルタイム対話モデルも、こういう形に育つ必要がある。
因果エンコーダー+因果デコーダー+低遅延なマルチモーダルトークンスケジューリングにより、25fpsでのストリーミング単位を160msという短さに抑えている:入力された音声・映像は即座に出力に影響を与え、生成される音声と視覚の状態はデコード前にすでに結合されており、後から修正するものではない。吐き出された各単位は対話履歴に書き戻される。こうして「聞きながら話す」ことができ、あなたが話している間もモデルは聞き続けており、割り込まれても即座に調整できる。
全二重は普通の電話のようなもの:相手の話を聞きながら口を挟むことができる。トランシーバーのように「話し終わってボタンを離してから聞く」のは半二重だ。
この仕組みが成り立つのは、block-causal attentionのおかげだ。これは小さな塊(例えば160msの音声・映像片)を1つの処理単位として扱う:ブロック内部のトークンは互いを参照できる(双方向)が、あるブロックは過去のブロックしか見えず、未来のブロックは見えない。こうすることでブロック内のコンテキストを保ちながら、入力が来た端から計算でき、話し終わるのを待つ必要がない。
160ms
160ms
160ms
160ms
ブロック内のトークンは互いを参照し合い、ブロック間は左(過去)方向だけを見る:ブロック3が到着すればすぐ計算を始められる。なぜならブロック1とブロック2だけに依存し、未来のブロック4を待つ必要がないからだ。これがストリーミング生成である。
話すときに「フレーズ」を単位として考えるのに似ている:1つのフレーズの中では一緒に吟味できるが、まだ口に出していない次のフレーズは予知できない。ここにはさらに2つの因果的な部品が組み合わされている——因果エンコーダー/デコーダー過去しか見ず、未来は見ない。普通のエンコーダーは1段落が完全に揃わないとエンコードできないが、因果版は受信しながらエンコードでき、同時通訳が聞きながら訳すように、スピーチが終わるのを待つ必要がない。。これにより知覚も生成も、来た端から進められる。
クリックして実装の詳細を見る:thinker–performerがどうやって遅延を200msに抑えるか
Wan Streamerは学習時は単一の端末間モデルだが、実運用でのデプロイ時には、同一のモデルを2枚のGPUにまたがるthinker–performerパイプラインに分割し、計算をできる限り重ね合わせる。システムのprefillが完了すると、thinkerが初期のKV-cacheをperformerにブロードキャストし、両者は同一の全履歴状態を共有する。これにより、統一モデルとしての振る舞いが完全に保たれる。
thinkerは因果音声・映像エンコーダー、言語予測と状態更新のための短い計算、KV-cacheの構築、そして前の単位のlatentを音声・映像にデコードして即座に出力する処理を担当する。performerはlatent生成のみを担当し、共有された全履歴のKVコンテキストに基づいて、次の音声・映像単位のためのflow-matchingソルバーを実行する。performerがデコーダーを実行することは決してなく、thinkerがコストの高いソルバーを実行することも決してないため、デコードと生成は互いをブロックしない。
performerの処理時間と通信時間の合計が1つの160ms単位に収まりさえすれば、リアルタイムのスループットが維持される。そして「エンコード→状態更新→latent生成→デコード」という、信号から信号までのこの経路こそが、約200msのモデル側遅延であり、CUDA graphのキャプチャ、コンパイル、最適化された演算子によって予算内に抑えられている。

他のシステムと比べて、何が速く、何ができるのか
以下の2つの遅延数値グループは測定対象が異なるため、分けて見る必要がある。上のグループは完全な端末間対話クローズドループ(ユーザーを知覚し応答を生成する)で、その中でWan Streamerだけが映像も同時に出力する。下のグループはデジタルヒューマン/音声・映像レンダラーで、レンダリング段階までしか計算しておらず、それらが依存する外部の言語モデル、ASR、TTSは含まれていない。そのためユーザーが実際に感じる遅延は図の数値よりも高くなる。
能力の各次元のカバー状況は以下の通りで、Wan Streamerはすべての項目にチェックが入る唯一の行だ:
| システム | 映像を知覚 | 映像を出力 | 全二重 | 端末間 | 1秒以内の応答 |
|---|---|---|---|---|---|
| Wan Streamer | ✓ | ✓ | ✓ | ✓ | ✓ |
| 豆包音声 | ✓ | ✗ | ✓ | ✗ | ~ |
| GPT-4o Realtime | ✓ | ✗ | ~ | ✗ | ✓ |
| StreamAvatar | ~ | ✓ | ~ | ✗ | ✗ |
| LPM 1.0 | ~ | ✓ | ✓ | ✗ | ~ |
✓=はい ~=部分的対応/非公開 ✗=いいえ。全二重とは、システムが生成中も継続的に知覚し続けていること、つまり理解しながら応答することを指す。「~」が付いたマスは、部分的対応であるか、その指標が非公開であるかのいずれかだ。
ストリーミング可能性はモデリング上の制約であり、単なるデプロイ最適化ではない:オフラインエンコーダー、双方向デコーダー、あるいはターン制の対話の上に構築されたシステムは、エンジニアリング最適化だけでは真に低遅延な全二重能力を取り戻すことは難しい。 Wan Streamer・全二重への挑戦
リアルタイム対話AI:「一連のモジュールリレー」から「1つのモデルが聞きながら見ながら話す」へ
通义万相チーム(アリババ)が、音声認識・思考・合成・アニメーションという一連のパイプラインを丸ごと1つのモデルに詰め込み、0.5秒の応答と自ら動く顔を実現した。図付きで1ページで解説する。
↓ 1ページで読み終わる・動く図あり
リアルタイムで音声チャットできるAIは今や珍しくない。GPT-4o、豆包、Geminiもみなできる。しかしそのほとんどは音声だけで、あなたを見つめ、動く顔を持たない。通义万相チームが新たに発表したWan Streamerは、この部分を補おうとしている:AIがあなたの映像を見ながら、話を聞きながら、口を開いて応答し、顔と声を一緒に生成する。まず既存のリアルタイム対話AIがどこで詰まっているかを見てみよう。
✘ しかし動く顔がないか、その顔は別の一連のモジュールで無理やり組み立てられており、一拍遅れてリップシンクもずれている
なぜか:旧来のやり方は「聞き取る→回答を考える→声を出す→顔を動かす」を4~5個の独立したモデルによるリレーに分解しており、バトンを渡すたびに待ち時間が生じ、認識とリップシンクの誤差も積み重なっていく。
そのやり方は非常にシンプルだ:上記の一連のリレーパイプラインをすべて1つのモデルに統合し、あなたを見て聞いてから応答するまでを一気通貫で行う(これを「端末間(end-to-end)」と呼ぶ。1つのモデルが最初から最後まで丸ごと引き受け、途中で他のモジュールに渡すことはない)。
音声をテキストに変換し、回答を考え、声を合成し、顔を動かす。4~5個の独立したモデルが順番にバトンを渡していく。
あなたを見て、聞いて、考えて、口を開いて、顔を動かす。すべてが同一のモデルの中で同時に進行し、途中の受け渡しがない。
しかしいくつかのモジュールを1つに統合するのは、あくまで第一歩にすぎない。本当に難しいのは、AIを人間のように聞きながら話せるようにし、あなたが一言挟んだら即座に止まれるようにすることで、これには処理方式を根本から作り変える必要がある。
その鍵となるのが、block-causal attention(ブロック因果注意)と呼ばれる仕組みだ:あなたの映像と声を小さなブロックに細かく切り分け(各ブロック約160ミリ秒)、モデルはブロックごとに受け取りながら計算していき、あなたが一文を言い終わるのを待つ必要がない。
普通の人は「何倍速いか」にはピンとこないが、「どれくらい待つか」には実感がある。同じく「一文を言い終えてからAIが口を開くまで」というこの一点だけでも、各社のシステムには大きな差があり、しかもWan Streamerだけが応答時に動く顔まで見せてくれる。
顔がない
- × 音声をテキスト化
- × 回答をひねり出す
- × 音声合成
- × 顔を動かす
v0.1はまだ192pでぼやけたまま、
デモは事前収録でリアルタイムではなく、
「唯一」は公式の言い分
聞きながら見ながら話す