
Claude Opus 5.5 発表:コーディング、視覚表現、執筆が大幅進化、多数のベンチマークで Fable 5.1 を上回り価格は大幅低下|実践事例で見る
公式チャート、X の動画、Every による1週間の実測検証を交え、どのような長年の課題が解決され、どのような成果物が作れ、日常業務での使い勝手はどうなのかを見ていく。
Anthropic が Claude Opus 5.5 をリリースした。今回のアップグレードは、複雑なプログラミング、視覚表現とインタラクション、ナレッジワーク、そして従来不満の声が多かった執筆体験まで多岐にわたる。Anthropic による評価において、Terminal-Bench のスコアは 66.4% を記録し、Fable 5.1 の 55.8% を上回った。CursorBench では 57.8% 対 51.8% であった。コードベース内で連続して問題を解決する力と、1つのプロンプトから完成された成果物を作り出す力は、同モデルにおいて最も注目すべき2つの能力である。
価格も選択肢を大きく変える要因となっている。Opus 5.5 の API 入力・出力単価はそれぞれ 100 万トークンあたり 4 ドルと 20 ドル であり、Fable 5.1 の 10 ドルおよび 50 ドルと比べていずれも 60% 低い。前世代の Opus 5 との比較では、Anthropic によると典型的なタスクにかかるコストは約 40% 抑えられ、出力速度は 30% 以上向上しているという。
日常業務において、これらの進化はそれぞれ次のように現れている。
- プログラミング:タスク全体を継続的に推し進めるのに適している。 ファイル横断での修正や長時間のエンジニアリング作業がより安定した。CursorBench のデフォルトである medium 設定ですでに Fable 5.1 の最高設定を上回っている。通常のタスクであれば、まずは medium から始めるのが良いだろう。
- 視覚表現とインタラクション:「単一ページを作る」段階から、より完成度の高い作品へ。 水中探索ゲーム、手描きアニメーション、調整可能な投石機、ブロック組み立てツールなど、グラフィック、操作、フィードバックが一体となった完全な体験を作り出している。
- ナレッジワーク:複雑な資料の検索、整理、納品をより高精度にこなす。 決算書の検証、M&A のモデリング、アプリケーション間をまたぐ操作のパフォーマンスが向上した。別の専門業務テストでは 1846 Elo を記録し、Fable 5.1 の 1735 を上回った。
- 執筆:遠回りをせず重要な情報を先に提示し、ユーザーの表現ルールに従いやすい。 新バージョンはフィードバックを受け入れやすく、お決まりの決まり文句が減少した。ドキュメント作成や課題の解説時にも、重要な情報がより早い段階で提示される。
執筆の進化:お決まりの表現を減らし、まずは要点を明確に伝える
Opus 5 の「AI っぽさ」は、これまで頻繁に不満として挙げられていた。回答の冒頭で背景を長々と説明し、専門用語やお決まりのフレーズを並べ立て、肝心な結論を後ろの方に埋もれさせてしまう。修正を求めると、元の書き方の妥当性を弁明したり反論したりするのに終始することもあった。Every のテスターは、旧バージョンの説明は往々にして「さらにもう一度説明を求める必要があった」と述べている。ドキュメント作成や継続的な共同作業において、これは追加の質問や修正作業に時間を浪費させる要因となっていた。
Opus 5.5 が主に改善したのは、こうしたコミュニケーション体験である。 Anthropic は、本モデルが重要な情報を冒頭に配置し、回りくどい表現を減らし、ユーザーが指定した執筆ルールをより忠実に遵守すると説明している。公式の請求デバッグ事例はこの変化を明確に示している。新バージョンでは、まず金額の差異がどこにあるのかを伝え、その後にコードの問題点を説明する構成をとっている。
同じバグを特定しても、新バージョンはまず影響から伝える
両モデルとも同じ請求バグを特定した。コードが月末の締め切り時刻を「最終日の午前0時」と設定していたため、最終日丸1日分の利用量が計算から漏れていたというものだ。
違いはその展開順序にある。Opus 5 はまずどのコミットが問題を引き起こしたかを指摘し、コードを提示して時間範囲を説明した上で、計算漏れの影響とテストで検知できなかった理由を述べた。一方、Opus 5.5 は冒頭で次のように説明した。請求額の減少のうち、1.50 ドルは無料枠の調整によるものであり、残る 9.92 ドルはバグによるものである。そしてこのバグによって月末最終日の使用量が課金されていなかったことを明かした。読み手はまず影響の大きさを把握した上で、コードを読み進めて原因を理解することができる。

公式発表ではさらに2組の比較が示された。Slack の議論を要約する際、両モデルとも3つの箇条書きを用いたが、新バージョンは「課題、即時対応、長期的対策」における担当者と進捗状況を、フォローアップしやすい形で記述した。チェスプログラムの解説では、新バージョンは「2つのマスの間に遮る駒が存在するかどうか」を軸に設計を説明した。ビットマスクで中間のマスを記録し、遮蔽物の数を計算した上で、その数がゼロの場合にのみ攻撃が成立するという流れである。読者が理解すべき本質的な問題へと技術的詳細を自然に結びつけている。
より自然な文章になった一方、長文では依然として遠回りすることも
初期テスターの Theo Jaffee は、「explain how options work」という同一のプロンプトを用いて両モデルの回答を比較した。彼は、Opus 5.5 の文章はより直接的で自然であり、違和感を与える紋切り型の表現が減少したと評価している。この投稿は調査時点で約 1300 件のいいね を集めていた。
旧バージョンは「将来の取引」や基本理念から話を始め、その後に定義、種類、長めの計算例を列挙していた。新バージョンは冒頭の段落で直接定義とプレミアム(オプション料)を示し、その上で種類、専門用語、上昇・下落時のシナリオ、損益分岐点を個別に整理した。違いは読む順序にある。まずオプションとは何であるかを理解した上で、分類や具体例へと進める構成になっている。


企業からのフィードバックも、日常的な文書作成タスクの感覚に近い。Ramp のエンジニアである John Ruelas は、新バージョンはチームの執筆ルールをより忠実に守り、設計ドキュメントの修正がほとんど不要になったと述べている。さらに、モデルによって書き直されたあるプロンプトは、彼自身が書いたオリジナル版よりも優れていたという。Box の Yashodha Bhavnani によると、同社の評価において Opus 5.5 が消費したトークン数は Opus 5 の約3分の1であり、回答の冗長性が正確性を維持したまま約 40% 削減されたという。
テクノロジーメディア Every による実測 では、共同作業の円滑化 が高く評価された。新バージョンは修正指示を素直に受け入れ、提供された資料に沿って創作を継続し、トレードオフの理由もより的確に説明できるようになった。
Every が計測した英語の Flesch-Kincaid Grade Level スコアは 6.95 であり、Opus 5 の 7.97 や Fable 5.1 の 7.43 を下回った(米国の第7学年に相当する読解難易度)。Reading Ease(読みやすさ)スコアは 68.4 であった。この指標は英語の文章の読みやすさを測るものである。

もっとも、執筆には依然として明らかな弱点が残っている。文章はわかりやすくなったものの、要点が必ずしも早く提示されるとは限らない という点だ。Every が実施した記事冒頭のテストにおいて、新バージョンは著者が21文で書いた内容を表現するのに37〜39文を費やした。Dan Shipper もまた、同モデルが最も興味深い論点を見つけ出しているにもかかわらず、それを冒頭に配置しなかったことを指摘している。
このため、Opus 5.5 はアイデアのブレインストーミングや初稿の肉付けに適している一方、最終稿を仕上げる際には、第1段落で核心となる論点が直接述べられているかを確認する必要がある。執筆能力の向上は柔軟性や表現力において十分に実感できるが、要約や取捨選択には依然として人間の編集が必要である。
X 上のデモ:ゲーム、アニメーション、視覚的完成度
X 上の開発者や Anthropic のチームメンバーは、完成度の高い成果物を次々と公開した。今回の進化を観察する上で、ゲームやアニメーションは格好の題材である。シーンの構築、操作性、フィードバックが真に実現されているかが問われるためだ。
水中探索ゲーム:シーン、ミッション、フィードバックがひとつの体験として統合
Anthropic チームのメンバーである Edwin Arbus によるデモは約 1315 件のいいね を集めた。彼は Opus 5.5 にアンティキティラ島の機械から着想を得たゲームの制作を指示した。作品全体は約 3MB の単一 HTML ファイル で構成され、Three.js を通じてブラウザ内で動作し、グラフィックと音声の双方がコードによってリアルタイム生成されるという。
動画は船とダイバーの描写から始まり、やがて水中へと潜っていく。魚の群れ、海藻、差し込む光が環境を作り出し、「3つの青銅の破片を見つける」という目標、酸素のカウントダウン、ソナーがミッションを構成する。仕掛けを見つけると歯車装置が現れ、クリア画面へと移行する。このデモの価値は、視覚とインタラクションの多様な要素が、ひとつの探索目標に向かって有機的に組織化されている点にある。
ゾンビゲームの比較:同一テーマにおけるビジュアルの差異
サードパーティの評価アカウント BridgeBench が公開した比較動画は約 653 件のいいね を獲得した。投稿者によれば両モデルに同一のプロンプトを使用し、解説の中で最初に Opus 5.5、続いて GPT-6 Sol を表示したと明記している。
前半部分はより写実的な都市シューティングのシーンで、路面の反射、建物の奥行き、銃器や UI 要素が豊富に描かれている。一方の後半部分は、より簡素化されたブロック状のキャラクターと規則的なフィールドで構成されている。単一のデモの中で、両作品のシーンの密度、ビジュアルスタイル、UI の違いが直感的に確認できる。
手描きアニメーション:既存スキルを活用したスタイルとトランジションの制御
開発者 superalesha によるアニメーションは約 478 件のいいね を集めた。彼は Opus 5.5 に対し Claude モデルの進化の歩みを表現するよう指示し、自作の hand-drawn-canvas-animation スキル を用いて純粋な JavaScript で制作したと説明している。
動画は鉛筆、紙、アスタリスクのロゴから始まり、ページめくり、懐中時計の歯車、青写真の橋、嵐、色彩のトランジションを経て、最後の一言の挨拶へと着地する。統一された画風を複数のシーンにわたってどのように維持できるかを示した好例である。
公式による8つの作品:能力をより具体的に提示
Anthropic は初期のプロトタイプ集も公開した。その中には連続した物語を描くアニメーションもあれば、入力を受け付けてフィードバックを返すアプリケーションプロトタイプも含まれている。
连续叙事与数据重建
スイカの物語は Kevin Ngo が制作した。アリが種を運び、育て、嵐を乗り越え、収穫を分かち合うまでが、約 29 秒の手描きストーリーとして描かれている。これは単なる一枚のイラストにとどまらず、連続したシーンの表現力を示している。
Earthrise(地球の出)の再構築では、画像の視覚的手がかりと公開データを利用し、アポロ8号が「地球の出」を撮影した瞬間を再現している。デモは元の写真から出発し、地平線のエッジ、位置関係、レンズのフィッティング、ライティング、フィルムの感光特性といった要素を順に示し、最終的な再構築画面へと至る。画像の観察、資料、幾何学的な関係性を単一の視覚化プロセスへと結実させている。
把草图和视觉想法变成可操作界面
Kevin Ngo による Penpal は、Claude Code を紙とペンのような手書き風インターフェースに仕立て上げた。新しいセッションは紙ナプキンの形をとり、プロジェクト一覧、前回のセッションの継続、利用量の確認など、具体的な操作エントリーがしっかりと維持されている。ビジュアルスタイルを大きく変更しながらも、本来の作業効率を損なわないインターフェース設計となっている。

投石機は、鉛筆スケッチからデスクトップ上の3Dモデルへと変換された。操作者はアームを引き、カウンターウェイト(重り)を調整し、投射物が飛翔してブロックを倒す様子を観察できる。単なるオブジェクト造形にとどまらず、「パラメータを変更して結果を観察する」というインタラクティブな関係性が成立している。
Tyler Nishida による UI スロットマシンは、インターフェース要素をランダムに組み合わせ、新しいアプリケーションの発想の起点を提供する。もう1つの作品は thedesignely によるもので、甲虫のポスターをベースにした視覚エフェクトコントローラーである。パラメータを調整すると、プレビュー上のテクスチャや形状の変形がリアルタイムに連動する。前者は組み合わせの創出を、後者は変化による効果の比較を支援する。
生成之后,还能继续修改与复用
ブロック組み立てアプリは、写真やテキストの説明を受け取り、3D のブロックモデルと組み立て説明書を出力する。動画内では、説明を変更した後の城、階層ごとの組み立てステップ、パーツのガイドなどが確認できる。「モデルらしく見えるものを作る」段階から、「実際にどう組み立てるかを人に伝える」段階へと踏み込んでいる。
Kevin Ngo によるアルゴリズム作図プログラムは、同一の画風から異なる構図を生み出す。公式の説明によると各絵画には異なるランダムシードが使われており、作例では波、島、夕日の位置が変化しつつも、鉛筆のタッチや紙の質感は一貫している。まとまったビジュアル素材を必要とする作業において、単一の固定的な結果しか出せないシステムよりも高い再利用性を持つ。

コーディング能力はどれだけ向上したか:標準設定でも十分に競争力がある
ビジュアル面のデモ以外に、公式ベンチマークも客観的な視点を提供する。以下の図は、プログラミング、ナレッジワーク、コンピュータ操作、チャート認識を網羅している。このうち OSWorld は部分点(partial)方式を採用しており、Chartography はツール使用条件下で Opus 5 の 83.4% から 89.0% へと向上した。

「effort(思考レベル)」は、モデルが思考に割り当てるリソース予算と捉えることができる。高い設定にするほど通常は時間とコストがかさむが、すべてのタスクでスコアが向上するとは限らない。Opus 5.5 の大きな変化のひとつは、デフォルトの medium 設定で、従来は高レベルモデルを必要としていた多くのタスクをこなせるようになったことである。
- Terminal-Bench 4.0 はターミナル環境でのマルチステップ実行と問題解決能力を評価する。Opus 5.5 の xhigh 設定のスコアは 66.4% で、Opus 5 の 52.3%、Fable 5.1 の 55.8%、Astra の 57.9% を上回った。medium 設定は約 58% であり、公式の比較によれば、コストは Opus 5 max の約5分の1で済み、同等の性能を発揮する Astra のコストの約 40% に抑えられる。
- FrontierCode v1.1 は正しさだけでなく、修正がコードベースのマージ基準を満たしているかも問われる。Opus 5.5 の medium 設定のスコアは 54.6%、max 設定は 54.4% であった。medium 設定は Astra の約5分の1のタスクコストで、Astra の 53.3% というスコアを上回っている。こうしたタスクにおいて、予算を最大まで引き上げることは必ずしも得策ではない。
- CursorBench 4.0 は実ユーザーによる複雑なファイル横断タスクを対象とする。medium 設定のスコアは 52.5% で、すでに Fable 5.1 max の 51.8% や Opus 5 max の 46.6% を上回っており、GPT-5.6 Sol の 41.7% と比較しても約3分の1のコストで済む。Opus 5.5 max 設定のスコアはさらに 57.8% に達するが、コストも相応に増加する。


長時間タスクに関するフィードバックは、より実際の開発現場に近い。Anthropic の社内検証で HAProxy を C言語から Rust へ書き直すタスクを実施したところ、Opus 5.5 は 9.5 時間、Fable 5.1 は 12 時間を要した。両者ともほぼすべての回帰テストに合格したが、Opus 5.5 のコストは 51% 低かった。公式発表にはほかにも、初期テスターが 68 万行のコード移行を1日足らずで完了した事例や、20 万行のレガシーコードの監査と修正を3時間足らずで完了した事例が紹介されている。
Stripe のエンジニアである Cristian Rivera は、別の難題について述べている。40 個の連鎖する PR に対する複雑なリベース作業である。ひとつの Opus 5.5 セッションが十数個のセッションを連携させ、コンフリクトを明確に解説した。翌日の午後には、40 個すべての PR が CI を通過した。Clio の Sean Heintz は、6つのリポジトリにまたがるタスクでモデルが 18 時間以上稼働し続け、マイルストーンをより迅速に達成し、手戻りも少なかったと報告している。ここでの進歩には、作業を粘り強く継続することだけでなく、人間がしばらく場を離れた後でも進捗状況を容易に把握できるようにすることも含まれる。
Every の Kieran Klaassen は、同一の Ruby タスクも比較した。Fable 5.1 high は 26 行書いたのに対し、Opus 5.5 extra-high は 14 行 で記述し、彼が好まない説明的なコメントを省略した。プログラムの性能テストにおいて、Opus が生成したコードは 427 リクエスト/秒 を記録し、20 個の応答時間上限のうち 17 個を満たした。一方、Astra のコードは 463 リクエスト/秒で 14 個を満たした。前者はピーク時のスループットこそ低いものの、より多くのレイテンシ要件をクリアした。なお、これは生成されたプログラムの性能をテストしたものであり、Kieran が述べた「Fable の約9割のコーディング能力がある」という見解は個人の使用感による判断である。
Kieran はさらに、カメラを用いた心拍数測定プロトタイプと Cozy Island の3Dアイランドの構築も試みた。彼は extra-high 設定による島のディテール描写やカメラ制御が優れており、自身がテストした Fable のバージョンを上回っていると評価した。


しかし、美しいインターフェースであってもコアプロセスの動作確認は不可欠だ。Mike Taylor による音声フォームのタスクは 30 分間稼働し、約 590 万トークンを消費した。トップページやログインページは見栄えがよく、自動チェックも通過したものの、実際にビルド画面やインタビュー画面を開くとエラーが発生し、指定された AI サービスも呼び出されていなかった。コードのレビューを行った後も、アプリケーションの主要な操作を実際に自身で確認する必要がある。
ナレッジワーク:正確に調査し、成果物もより完全な形で納品
GDPval-AA v2.1 の専門業務テストにおいて、Opus 5.5 は 1846 Elo を獲得し、Fable 5.1 の 1735 や Opus 5 の 1708 を上回った。Elo は相対的なパフォーマンスを示す指標であり、正答率ではない。公式の比較曲線によれば、medium 設定ですでに Astra max を超えており、タスクあたりの推定コストはその約5分の1となっている。

具体的な一例が決算書のファクトチェックである。Anthropic は、ウェブ上で特定が困難な決算プレスリリースのコピーを検索対象とするタスクを設定し、四半期報告書の検索・作成と、数値および引用の個別照合をモデルに求めた。幻覚(捏造)が1箇所でもあればレポート全体が不合格となる。Opus 5.5 は 18 回の試行中 16 回合格 したのに対し、Fable 5.1 と Opus 5 はこのテストに合格できなかった。別の社内テストでは、架空の HR ソフトウェア企業2社の M&A を分析させ、Excel による財務モデルと経営陣向けレポートを作成させた。両モデルとも企業価値評価の結論は同じであったが、Opus 5.5 の成果物はより完成度が高く読みやすかった上、所要時間は 63 分対 93 分、コストは 50% 低かった。
アプリケーション横断の AutomationBench におけるスコアは、Opus 5 の 26.9% から 40.0% へと向上したものの、依然として Astra の 41.4% を下回っている。科学エージェントのテストでも Astra の方が高く、64.6% 対 58.7% であった。

大規模な情報収集を評価する WANDR テストでは、Opus 5.5 のスコアは low 設定の約 31% から max 設定の約 72% へと向上し、複雑な情報検索にはより多くのリソースを割り当てる価値があることが示された。
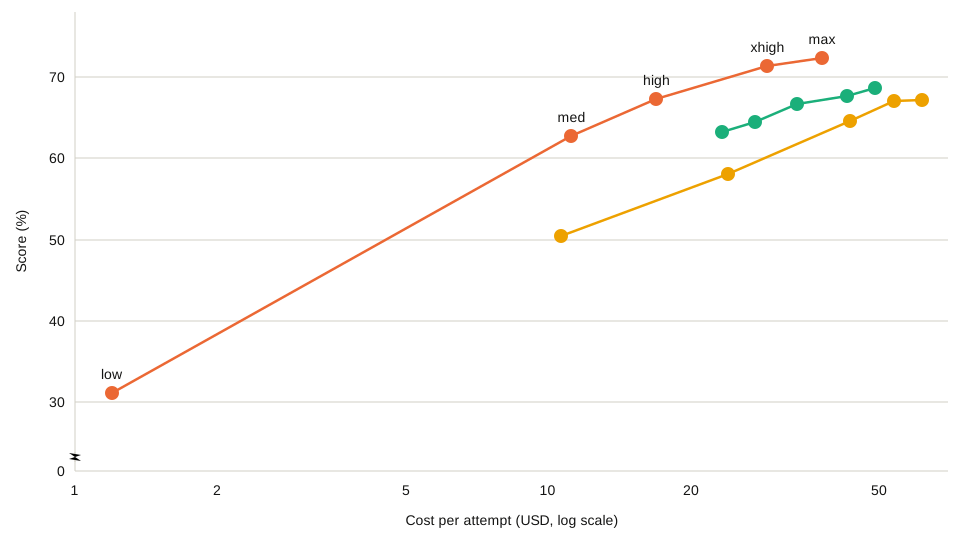
Every によるコンサルティングのテストは別の側面を浮き彫りにした。Dan Shipper を模したエージェントと交渉を行い、12 ラウンド にわたる修正の末に合意に達した。しかし、10 分間の制限時間内でクライアント向け研修のタイムスケジュール表を作成するタスクでは、最初に5分近く思考し、次にトレーニングデータを作成してバランスシートを照合し、9分目になってようやく配布資料の作成を始めたため、最終的に分刻みのスケジュール表を提出できなかった。粘り強く推敲できるからといって、納品の優先順位を正しく判断できるとは限らない。
コスト低減:単価が安く、タスク完了に必要なステップも削減
公式が謳う「典型的なタスクのコストが約 40% 低下」には、2つの側面が含まれている。トークンあたりの単価が安くなったこと、そしてタスク完了に要するトークン数が減少したこと である。トークンはモデルの処理および課金単位となるテキストの断片であり、この2つが最終的な請求額を左右する。

| 100万トークンあたり | Opus 5.5 | Opus 5 |
|---|---|---|
| 入力 | 4 ドル | 5 ドル |
| 出力 | 20 ドル | 25 ドル |
| キャッシュ読み取り | 0.20 ドル | 0.50 ドル |
| キャッシュ書き込み | 5 ドル | 6.25 ドル |
Fable 5.1 の 100 万トークンあたり入力 10 ドル、出力 50 ドルと比較して、Opus 5.5 の 4 ドル / 20 ドルはいずれも 60% 低い。
エージェントはシステムプロンプト、ツール定義、コンテキストを繰り返し引き継ぐ。再利用可能なプレフィックスがキャッシュにヒットすると、大幅に安価な読み取り単価で課金される。そのため、タスク内でキャッシュが占める割合やモデルの呼び出し回数が総コストを左右する。以下の計算ツールは、同一の使用量においてキャッシュの比率がどのように費用へ影響するかを示している。
同じトークン使用量で、キャッシュ比率は請求額をどう変えるか?
計算例:1ターンあたり累計入力100万トークン、出力10万トークン。通常モードの単価のみを比較し、キャッシュ書き込み費用は含まず、新モデルでトークン消費が減ることも仮定していません。
- Opus 5
- $3.90
- Opus 5.5
- $2.96
- 単価による削減率
- 24.1%
80% の入力がキャッシュにヒットした場合、同一使用量でのコストは 24.1% 削減されます。
計算式:通常入力トークン量 × 入力単価 + キャッシュ読み取り量 × キャッシュ読み取り単価 + 出力トークン量 × 出力単価。公式の「典型的なタスクで40%安価」にはトークン使用量の変化も含まれており、この固定使用量の試算例から直接導き出せるものではありません。標準モードの出力生成速度について、公式は Opus 5 よりも 30% 以上高速であるとしている。Claude Code や開発者向けプラットフォームには Fast mode も用意されており、生成速度は標準モードの最大 2.5 倍、入力・出力価格は 100 万トークンあたりそれぞれ 8 ドルと 40 ドル となっている。追加コストを払ってでも待ち時間を短縮したいユースケースに適している。
実際の活用に向けて:目標とともに「停止条件」を明示する
Every の Tyler Nishida がゴルフゲームに関する1本のプロンプトを与えただけで、モデルはアーキテクト1名、デザイナー3名、審判3名からなる協調チームを自律的に結成し、彼のテスト用アクセス権が終了するまで 1 時間 52 分 にわたって稼働し続けた。完成品のスクリーンショットからは、雷雨、浮島、ショットのカウントダウン、クラブのコントロールが確認できる。

タスクを自律的に継続することは、利用枠を消費し続けることでもある。Every のテスターの中には週間利用上限に達した者もいた。また、モデルが自ら生成した UI コンポーネントの 90% 以上を自発的に却下したケースもあり、Tyler はその理由から明確な評価基準を見出すことができなかった。
長時間のタスクを指示する際は、最終的な納品物、時間やコストの予算、そしてどのような条件で停止すべきかを事前に明示することが重要だ。まずは利用可能なコアとなる成果物を出力させ、その上でブラッシュアップを続けるかどうかを判断する方が、モデルに際限なくタスクを追加させ続けるよりも効果的であることが多い。Every チーム内でもモデルに対する好みは分かれており、視覚表現やプロダクト開発のために Claude に戻ったメンバーもいれば、記事の編集には引き続き Astra を使うメンバーもおり、適材適所の選択がなされている。
Opus 5.5 はすでに Anthropic の開発者プラットフォームをはじめ、AWS、Google Cloud、Microsoft Azure で提供されており、API のモデル ID は claude-opus-5-5 である。Pro、Max、Team、およびシート課金制の Enterprise における5時間の利用枠が引き上げられたほか、サブスクリプションユーザーには保存して任意のタイミングで使用できる利用枠リセット権が1回分付与された。Sonnet 5.5 および Haiku 5.5 も今後数週間以内にリリースされる予定である。
安全性について簡潔に述べると、Anthropic によれば行動監査のパフォーマンスがさらに改善され、高リスクタスクに対する本番環境レベルの保護措置が設定された。一部のシナリオではブロックされたり他のモデルへ転送されたりすることがあるが、これは具体的な製品やアクセス方法によって異なる。日常的な利用において最も注目すべきなのは、やはり強化された業務処理能力、より明確になったコミュニケーション、そして同一のタスクを完了するために必要な時間とコストの低減である。