決定モデルでAIの自動品質検査を行う方法:6モデルの実測検証
デフォルトの0.5はなぜ見逃しを生むのか?賃貸Agentの実運用ログをもとに、アラームしきい値、モデル選定、確率の較正を解き明かす。
決定モデル(Decision Models)を AI の自動評価(Evals)ツールとしてどのように活用するのか?
通常、AI システム(カスタマーサポートの対話やワークフローなど)の良し悪しを評価する際、呼び出しコストの高い大規模言語モデルを「ジャッジ」(LLM Judge)として機能させ、スコアを付けさせる手法が一般的です。これに対し、決定モデル(Decision Models)や関連する分類インターフェース(TypeSafe Jev、Perplexity Decider、Liquid d1、Cloudflare Clef、OpenAI Decisions API など)は、タスクを分類と判断に特化させ、「エラーがあるかどうか」の確率スコアを直接出力し、より低コストかつ高速にこうした評価(Evals)を実施できることを掲げています。
解決される課題と業界のペインポイント
-
大規模言語モデルによる評価者の高コストと低速性
GPTやClaudeなどの大規模言語モデルを用いてサポート対話やワークフローを1件ずつ検証する場合、評価規模の拡大に伴ってAPI費用と待機時間が累積します。決定モデルは、こうした判定タスクの推論コストとレイテンシを圧縮し、大規模な自動テスト導入のハードルを下げることを目指しています。
-
デフォルトしきい値(0.50)の盲目的な適用による性能の無駄
公式提供のデフォルトスコア0.50をそのまま合否の境界線として使用すると、大量のエラーを見逃す恐れがあります。仮にあるモデルが失敗サンプルすべてに0.40、正常サンプルすべてに0.10を付与していた場合、0.50をしきい値にするとすべてのエラーを見逃してしまいます。しかし、しきい値を0.30に調整すれば、両者を完璧に分離できます。モデルを変更しなくても、自社の実務データに合わせてしきい値を適切に調整するだけで、評価結果が劇的に改善することがあります。
-
モデルが出力する確率はそのままでは信頼できない
モデルが「0.80の失敗確率」を出力したとしても、現実世界で80%の確率で失敗することを意味するとは限りません。その数値が信頼できるかどうかは実際の結果に照らして検証する必要があり、検証なしに信頼度としてそのまま利用することは避けるべきです。
意思決定モデルとは
カスタマーサポートの対話を自動で品質検査するシステムを想定してみましょう。プログラムは完全な対話ログをモデルに入力し、「アシスタントは規定通りに有人オペレーターへ転送しなかったか」という明確な問いを添えます。意思決定モデルや専用の判定インターフェースは、タスクを事前定義された問いへと絞り込み、プログラムですぐに使える構造化された結果を直接返します。条件の成立度合を示すスコア、提示された選択肢から選ばれたカテゴリ、あるいは既定の基準に基づく評点などです。プログラムはその後、ビジネスルールに従って処理を行います。たとえばスコアがアラートの閾値に達した場合、その対話を人間による確認キューへ送る、といった形です。モデルが判定を担当し、プログラムが次のアクションの決定を担当します。
これが、意思決定モデルが Evals のジャッジを務めるロジックです。本質的には、コード内に組み込まれた分類・選択・スコアリングのコンポーネントです。各プロダクトの基盤は異なり——例えば Jev は構造化された意思決定のために専用設計されたモデルであり、OpenAI Decisions は GPT-6 Luna の判定インターフェースですが——いずれも判定結果を使ってプログラムが直接ビジネスロジックを駆動できるようにします。
アパート賃貸Agentの98件の本番ログから見る現実
決定モデルの実戦における挙動を検証するため、機械学習評価のエキスパートであるHamel HusainとAntaripa Sahaは、実運用されているアパート賃貸AIサポートアシスタントのログを抽出しました。
このAgentは電話やメッセージングを通じて、内見予約、予約キャンセルの確認、人間のオペレーターへの転送など、入居希望者の手続きを処理します。評価タスクは二値判定であり、対話ログにおいて、AIアシスタントの挙動やツール呼び出しに実質的な失敗が存在するかどうかを判定することです。
評価データセットは合計100件の記録で構成され、内部QA用の2件を除外した98件の対話ログが正式に評価されました。元の対話は非公開データです。評価にあたり、モデルには人間の手によるラベルやレビューメモを伏せた完全な記録が入力されました:
- 既知の失敗を含む61件(ラベル1):従来の人手レビューで確認された39件の失敗と、BraintrustおよびArizeのツールによるスクリーニングを経て人手で再検証された22件の失敗を含みます。評価基準では、予約の失敗、規定通りの有人転送の不履行、ツール呼び出しが失敗したにもかかわらず完了したと偽る行為、システム指示への違反、顧客への内部プレースホルダーの露出などが実質的な失敗と判定されます。
- 失敗のラベルが付いていない記録37件(ラベル0):今回のベンチマークにおいて実質的な失敗のラベルが付与されていない記録ですが、これは対話ログに一切の不備がないことを保証するものではありません。
テストでは6つの決定モデルソリューションを網羅しました:Jev 1.13、Perplexity Decider 1.1 (27B)、Liquid d1、Liquid d1-ultra、Cloudflare Clef Flash、そしてGPT-6 Lunaを使用したOpenAI Decisionsです。Perplexity、Liquid、Clef、OpenAIには同一のテキストプロンプトとシリアライズされた入力が渡され、Jevには構造化APIを通じて同等の基準が渡されました。各モデルはログごとに0から1の間の失敗傾向スコアを出力します。
デフォルトの0.50しきい値が評価を機能不全に陥らせる理由
一般的なAPIの仕様では、スコアが0.50以上であれば「失敗」と判定してアラームを発報し、それ未満であれば正常として通過させます。しかし、モデルによってスコアリングのスケールは大きく異なります。
仮にあるモデルが真の失敗ログすべてに0.40を付け、正常ログすべてに0.10を付けたとします。この仮定の状況では、合格ラインを0.30に設定しさえすれば、両方のサンプルを完璧に判別できます。ところが、デフォルトの0.50で判定してしまうと、すべての失敗を正常と判定してしまい、失敗検知率は0%になってしまいます。
実際の現場では、失敗ログと正常ログのスコアはある程度重複しますが、モデルごとの数値分布の偏りは依然として顕著です。

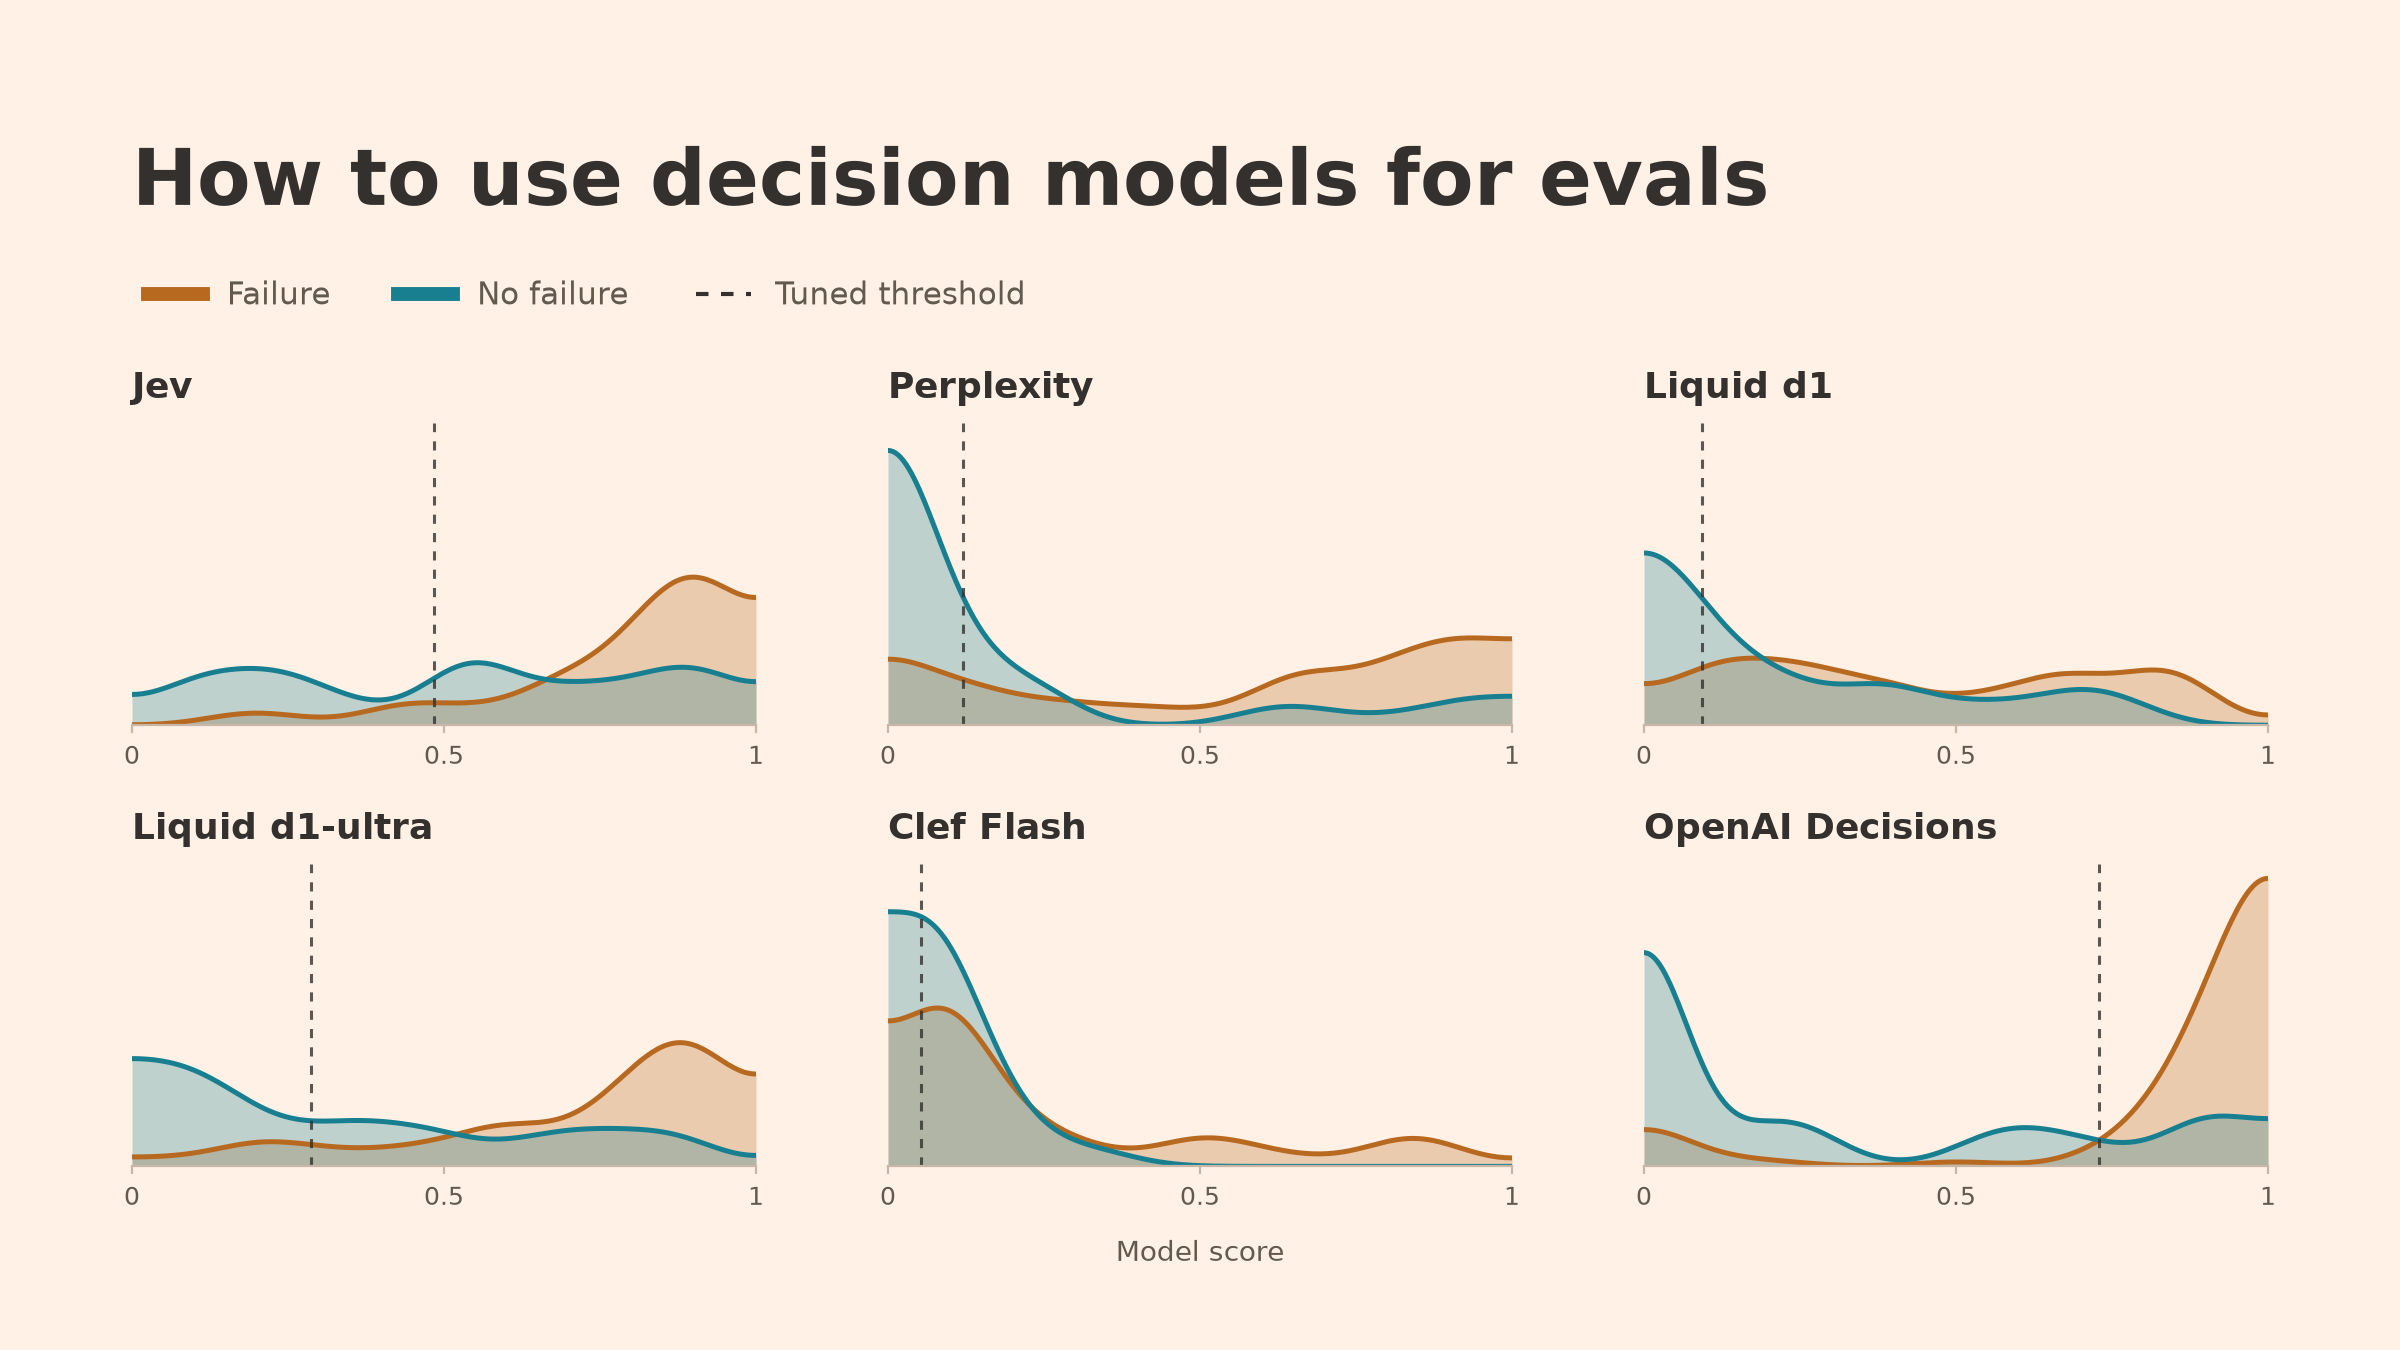
オレンジ色は既知の失敗ログのスコア密度、青色は失敗のラベルが付いていないログを示し、各曲線の曲線下面積は1に正規化されています。Clef FlashとLiquid d1のスコアは0に近い極めて低い領域に集中しています。Perplexityは0.50付近で見逃しが多く、OpenAIは2種類のログを比較的明瞭に分離できています。
デフォルトの0.50しきい値における各モデルの実際の挙動を確認します:
- Cloudflare Clef Flash:全体的にスコアが低く出ます。0.50のしきい値では全データ中わずか13回しかアラームを発報せず、その13回はすべて真の失敗(適合率100%)であったものの、61件の既知の失敗のうち48件を見逃し、再現率はわずか21.3%(F1は0.35)にとどまりました。
- Liquid d1:同様にスコアが低く、0.50のしきい値で検知できたのは28件の失敗で、33件を見逃しました。再現率は45.9%です(適合率77.8%、F1は0.58)。
- Perplexity Decider:0.50のしきい値で39件の失敗を検知し、22件を見逃しました。再現率は63.9%です(適合率84.8%、F1は0.73)。
- Liquid d1-ultra:0.50のしきい値で49件の失敗を検知、誤報は12件、適合率80.3%、再現率80.3%(F1は0.80)でした。
- OpenAI Decisions:2種類のログのスコアが比較的離れており、0.50のしきい値で55件の失敗を検知(再現率90.2%)したものの、失敗ラベルのない記録に対して15回の誤報を出しました(適合率78.6%、F1は0.84)。
モデルのスコアの絶対的な高低それ自体は優劣を意味しません。本質的なのは、数値軸上で失敗ログと正常ログを明確に引き離せているかどうかです。スコア分布を検証することなく、0.50を一律のアラーム境界線として採用してはなりません。
適合率と再現率:アラーム設計には順序付け以上の基準が必要
自動品質検査やアラームシステムを設計する際、エンジニアは適合率(Precision)と再現率(Recall)のトレードオフを慎重に判断しなければなりません。
この2つの概念は基準となる分母が異なります:
- 適合率(Precision):検知した真の失敗数 / システムが発報した全アラーム数。システムがアラームを鳴らした際、そのうち実際に失敗だった割合はどれくらいかを示します。例えばClef Flashの場合、13回アラームを鳴らして13回とも真の失敗であったため、適合率は 13 / 13 = 100% となります。適合率が低すぎると誤報が頻発し、運用担当者はアラーム疲れに陥ります。
- 再現率(Recall):検知した真の失敗数 / 既知の全失敗数。全61件の既知の失敗のうち、システムが実際に食い止めることができた割合を示します。Clef Flashは13件しか検知できなかったため、再現率は 13 / 61 ≈ 21.3% となります。再現率が低すぎると、膨大なエラーが検知をすり抜けてしまいます。
F1スコアは適合率と再現率の調和平均であり、両者のバランスを総合的に評価する指標ですが、一般的な意味での正解率とは異なります。実際の運用では、最低限の基準を無視してF1スコアの高さだけを追い求めるべきではありません。
例えば自動チケットアラームシステムにおいて、今回の検証では例として次のような基準が設定されました:適合率80%以上、かつ再現率80%以上。これは、発報されたアラームの少なくとも8割が本物の問題であり、同時に既知の失敗の少なくとも8割を現場で阻止することを意味します。これは特定の業務要件における一例であり、業界全体の絶対的な基準ではありません。

横軸は再現率(Recall)、縦軸は適合率(Precision)です。右上の網掛け部分は適合率と再現率が同時に80%以上に達する領域を表しています。全サンプルのしきい値スキャンにおいて、この領域に入り候補モデルとなったのはOpenAI Decisions、Liquid d1-ultra、Perplexityの3モデルのみであり、Jev、Liquid d1、Clef Flashは一度も到達しませんでした。
98件の全サンプルスキャンにおいて、あるしきい値範囲で「双方80%」の基準を同時に満たすことができたのは3モデルのみであり、これらが候補モデル(Candidates)として位置付けられました:
- OpenAI Decisions:最も優れた性能を示し、網掛け領域の広い範囲をカバーしました。
- Liquid d1-ultra:しきい値0.525付近で双方80%に到達しました。
- Perplexity Decider:しきい値を約0.127まで引き下げた際に到達しました。
一方、Jev、Liquid d1、Clef Flashは、しきい値をどのように調整しても、この98件の全サンプルスキャンにおいて双方80%の要件を同時に満たすことはできませんでした。
スライダー操作:しきい値の移動が誤報と見逃しに与える影響
しきい値を動かすことで誤報と見逃しがどのように変化するかを直感的に確認するため、インタラクティブデモにはこれら98件の記録の公開ラベルと各モデルの生予測スコアが組み込まれています。
モデルを自由に切り替え、スライダーをドラッグして、誤報(偽陽性)と見逃しが天秤の両端でどのように増減するかを確認できます。
固定 0.50 対照:適合率 78.6% · 再現率 90.2% · 検知 55 件 · 誤報 15 件 · 見逃し 6 件。
現在のしきい値 0.50:検知 55 件、誤報 15 件、見逃し 6 件。
上記の即時再計算から重要な事実が確認できます。しきい値を極限まで引き上げ、アラーム総数が0件になった場合、適合率は数学的に未定義(0/0)となり、決して100%と誤認してはなりません。 また、これは全サンプルを用いた教育的な再計算であり、しきい値のレバレッジ効果を直感的に示すものですが、全サンプル上で選定されたしきい値が未知のサンプルで全く同じ性能を再現できるとは限らない点に注意が必要です。
交差検証の現実:訓練セットで達成できてもホールドアウト検証で低下する理由
手元のデータで見かけ上要件を満たすしきい値を見つけたとしても、システムが本番稼働した後に安定して基準を維持できるとは限りません。
しきい値の汎化性能を評価するため、実験では層化5分割交差検証(Stratified 5-Fold Cross-Validation)が採用されました:
- 分割の分離:98件の対話ログを、既知の失敗と失敗ラベルのない記録の比率を維持したまま均等に5分割します。各ラウンドで4分割(約78件)を訓練セットとし、残り1分割(約20件)をホールドアウト検証セットとします。
- 制約付きしきい値探索:3つの候補モデルについては、訓練フォールドにおいて「適合率 ≥ 80% かつ 再現率 ≥ 80%」を満たす条件下でF1スコアを最大化するしきい値を探索します。非候補モデルについては、制約なしでF1スコアの最適化を行います。
- フォールバック戦略とホールドアウト検証:候補モデルがある訓練フォールドで双方80%を満たすしきい値を見つけられなかった場合、制約なしでF1最大値を探索するルールへとフォールバックし、そのフォールドを実行不可能として記録します。選定されたしきい値を対応するホールドアウト検証フォールドに適用して結果を記録します。実験では、フォールバックしたフォールドを含むすべてのホールドアウト検証予測をレポートに計上しています。
実験では20ラウンドの5分割交差検証が行われ、合計100回の訓練分割が実施されました:
- OpenAI Decisions:100回すべての訓練分割で双方80%を満たすしきい値の特定に成功しました。ホールドアウト検証セットでの平均性能は、適合率86.9%、再現率86.2%、F1スコア0.865でした。これは分割をまたいだ平均値であり、各フォールドや実運用環境における性能には変動が生じ得ます。
- Liquid d1-ultra:訓練フォールドのうち29回の分割で双方80%を満たすしきい値が見つからず、ルールに従って制約なし最適化へフォールバックしました。最終的な検証セットにおける平均ホールドアウト適合率は75.9%に低下しました(再現率81.7%、ホールドアウトF1は0.787)。
- Perplexity Decider:訓練フォールドのうち36回の分割で基準を満たせずフォールバックが発生しました。最終的な検証セット平均ホールドアウト適合率は75.4%でした(再現率82.5%、ホールドアウトF1は0.787)。
訓練セットで選定されたしきい値は、サンプルのばらつきによる境界の変動を完全には排除できません。未知のデータに直面した際、指標の低下が生じるのは一般的な現象です。

白抜きの円はデフォルトの0.50しきい値における98サンプルの成績を、塗りつぶした円は交差検証により調整された平均ホールドアウトF1スコアを示しています。前3つが候補モデル、後3つのグレーは双方80%の制約を満たさなかったモデルです。Clef FlashのホールドアウトF1は0.35から0.78へ、Liquid d1は0.58から0.79へ、OpenAIは0.84から0.87へと向上しました。しかし、Jevは0.79から0.78へと微減し、Liquid d1-ultraも0.80から0.79へと微減しました。これは、訓練セット上でのしきい値調整がホールドアウト検証セットでの改善を必ずしも保証するものではないことを示しています。
また、最適化の目的関数はF1スコアに限りません。業務上、誤報または見逃しのどちらかをより重視したい偏りがある場合は、F-betaスコア(betaが1未満の場合は適合率を重視し、1を超える場合は再現率を重視)を採用し、個別のビジネス目標に合わせてしきい値を選定できます。
コーディングAgentにしきい値調整を実行させるプロンプト
ラベル付けされた対話ログとモデルが出力した生スコアが手元にあれば、著者が推奨するプロンプトを参考に、コーディングAgentに交差検証を自動実行させることができます。なお、このサンプルプロンプトは基準を満たすしきい値が存在しない場合に条件を緩和せずそのまま報告するよう求めており、本記事の実験で採用されたフォールバック戦略とは挙動が異なります。
英語プロンプト原文:
Using my saved model scores and binary labels (1 means failure), tune a decision threshold to maximize F1 while requiring at least 80% precision and 80% recall. Use stratified five-fold cross-validation, choosing thresholds on the training examples and measuring performance on the remaining examples. If comparing models, use the same splits for each. Only select thresholds that meet both minimums on the training examples. If none qualifies, report that rather than relaxing either requirement. Report validation precision, recall, and F1, along with any splits where no threshold qualified or validation performance fell below my minimums. Compare with the default threshold of 0.50. Reuse the saved scores without making new model calls.完全な日本語訳:
保存されているモデルスコアと二値ラベル(1は失敗)を使用し、適合率80%以上かつ再現率80%以上を必須条件として、F1スコアを最大化するように決定しきい値を調整してください。層化5分割交差検証を採用し、訓練サンプル上でしきい値を選択し、残りの検証サンプル上で性能を測定してください。複数のモデルを比較する場合は、すべてのモデルで同一の分割を使用してください。訓練サンプル上でこれら2つの最低要件を同時に満たすしきい値のみを選択してください。該当するしきい値が存在しない場合は、いずれの要件も緩和することなく、その旨を報告してください。検証セットの適合率、再現率、F1を報告し、適切な基準を満たすしきい値が存在しなかった分割や、検証性能が最低要件を下回った分割を明記してください。デフォルトのしきい値0.50と比較してください。新たなモデル呼び出しは行わず、保存されたスコアを再利用してください。
性能と費用のトレードオフ:候補モデルの選び方
各モデルの専用しきい値を調整した後、モデル選定は性能と費用のトレードオフ(Performance vs. Cost)の検討へと移ります。
今回の費用算出は、100回の評価におけるAPIトークン消費量と実験時の料金スナップショットに基づいています(性能は内部QA用の2件を除く98件の本番ログに基づきます)。なお、Liquidの料金は本文の説明に従って再確認されており、d1は入力100万トークンあたり0.04ドルから0.02ドルに、d1-ultraは0.042ドルに更新されています。その他のモデルは実験当時の記録を踏襲しており、現行の統一市場価格とは異なる場合があります。

横軸は評価100回あたりのAPI費用(セント)、縦軸は5分割ホールドアウト検証の平均F1性能です。塗りつぶした円は候補モデルを表し、点線はPerplexityとOpenAI Decisionsを結び、候補における費用とF1のフロンティアを示しています。グレーの×印は双方80%の制約を満たさなかったモデルです。Perplexityは0.82セント/100回で最低コストの候補となり、OpenAIは最高値となる0.87のF1を達成したもののコストは3.72セントでした。このフロンティアは本評価タスク固有のものであり、将来のあらゆるシナリオに直接適用できるわけではありません。
これら3つの候補モデルの具体的なパフォーマンスを整理します:
- Perplexity Decider 1.1:評価100回あたりの費用は0.82セント、ホールドアウト平均F1は0.79(小数第6位までは0.787289)、ホールドアウト平均適合率は75.4%、再現率は82.5%でした。候補モデルの中で最も呼び出しコストの低い選択肢です。
- Liquid d1-ultra:評価100回あたりの費用は1.52セント、ホールドアウト平均F1は同様に四捨五入で0.79(小数第6位までは0.786636で、Perplexityとごくわずかに異なります)、ホールドアウト平均適合率は75.9%、再現率は81.7%でした。3つの候補の比較において、ホールドアウトF1が近いPerplexityよりも単位コストが高くなっています。
- OpenAI Decisions (GPT-6 Luna):評価100回あたりの費用は3.72セント、ホールドアウト平均F1は0.87(小数第6位までは0.865463)、ホールドアウト平均適合率は86.9%、再現率は86.2%に達しました。費用はPerplexityの約4.5倍ですが、今回の実験において平均適合率と再現率がともに80%以上を維持しました。
非候補モデルの中では、Liquid d1が調整後に98サンプルの検証で0.79のホールドアウトF1を達成し、費用も極めて安価(0.72セント)でしたが、前述の98件の全サンプルスキャンにおいて適合率と再現率の双方80%を同時に満たすことができなかったため、候補モデルには含まれませんでした。
本実験では統一条件下でのモデルのレイテンシ比較は行われていません。実際の本番稼働において、応答レイテンシはリクエストのバッチ処理や並列化の有無、プロバイダのインフラとの物理的距離、同時実行数の制限、テールレイテンシ、スループットなどの外部要因に大きく左右されるため、単一実験の平均応答時間のみをもってモデルの速度順位を決めることはできません。
スコアを確率として使えるか?モデルの較正とPlattスケーリング
合否の二値分類だけでなく、決定モデルが出力するスコアをそのまま信頼度や失敗確率として利用したいと考えるケースもあります。
較正(Calibration)の実質的な意味とは、あるモデルが0.80の失敗スコアを出力した場合、同様のスコアを付与された多数のログのうち、約80%が実際に失敗を含んでいる状態を指します。しかし実際のテストでは、一部のモデルにおいて生のスコアと実際の発生確率との間に大きな乖離が見られました。

左図は生のスコア、右図はPlattスケーリングにより調整された確率を示しています。横軸はモデルが予測した失敗確率、縦軸はそのグループ内で実際に観察された失敗の割合であり、対角線の破線は完全な較正を表します。各データポイントはスコアが近い約20件のログを示しています。較正後、Clef Flash、Perplexity、Liquid d1は対角線へ明確に近づいています。
元の分布における乖離の傾向を確認します:
- サンプルは予測確率の低い順から高い順へ5つのグループ(各グループ19件または20件のログ)に分割されています。図中の点が対角線の上側にある場合、モデルが失敗リスクを過小評価していることを示し、下側にある場合は過大評価していることを示します。
- Cloudflare Clef Flash:あるグループにおいて、モデルが予測した平均失敗確率はわずか約8%でしたが、そのグループのサンプル中、実際には60%に失敗が含まれていました。この割合はそのグループの傾向を示したものであり、将来の単一記録のリスクについては新たなデータでの検証が必要です。
- Perplexity および Liquid d1:同様に複数のグループ範囲において失敗リスクを過小評価する傾向が見られました。
こうした偏りを補正するための一般的な手法がプラットスケーリング(Platt Scaling)です。具体的な手順としては、訓練フォールドにおけるモデルの生スコアと0/1ラベルを用いて、スコアを確率へと変換する滑らかな曲線(対数オッズに基づくロジスティック回帰)をフィッティングします。その後、学習に関与していないホールドアウト検証フォールドにその曲線を適用して確率変換を行います。各フォールドをループさせてホールドアウト予測結果を集約することで、同一データによる過学習評価を防止します。
較正を実施するにあたっては、以下の点に留意する必要があります:
- 今回のデータセットにおいて調整が小さかったモデルが存在する:Jev 1.13とLiquid d1-ultraは、今回のデータにおける生スコアがすでに対角線に比較的近く、スケーリングによる補正幅はわずかでした。これは本データにおける傾向であり、両モデルに普遍的な性質とは限りません。
- フィッティング手法に対する感度が高い:較正の検証には通常ブライアスコア(Brier Score)が用いられます。これは予測確率と真の0/1ラベルとの差の二乗平均であり、数値が低いほど優れています(判別能力と較正精度の両方に影響を受けます)。本実験で示された対数オッズによるPlattフィッティングでは、OpenAI Decisionsのブライアスコアが0.159から0.164へと微増しました。これは確率誤差がやや拡大したことを示していますが、モデルのランキング判別能力が損なわれたことを意味するわけではありません。対照的に、確率スケール上で直接探索的な再フィッティングを行った場合、OpenAIのブライアスコアは0.154まで低下しました。このことは較正効果がフィッティング形式に対して非常に敏感であり、未知の新規データで常に最適になるとは限らないことを示しています。
コーディングAgentに較正を評価させるプロンプト
英語プロンプト原文:
Using my saved failure probabilities and binary labels (1 means failure), test whether Platt scaling improves each model’s probabilities. Use stratified five-fold cross-validation with the same splits for every model. Fit the calibration mapping on each training split and apply it to the remaining traces. Fit on log-odds, clipping probabilities away from 0 and 1 first. Plot predicted probabilities against observed failure rates before and after calibration. Report Brier scores (lower is better), and explain which models improved or got worse. Reuse the saved scores without making new model calls.完全な日本語訳:
保存されている失敗確率と二値ラベル(1は失敗)を使用し、プラットスケーリング(Platt scaling)によって各モデルの確率出力が改善されるかどうかをテストしてください。すべてのモデルに対して同一の分割を用いた層化5分割交差検証を採用してください。各訓練分割で較正マッピングをフィッティングし、それを該当分割の残りの対話ログに適用してください。対数オッズ(log-odds)に基づいてフィッティングを行い、事前に確率を0と1からわずかに離れた範囲に収まるようクリップ(clip)してください。較正前後の予測確率と実際の観測失敗率の対比プロットを作成してください。ブライアスコア(Brier score、低いほど良い)を報告し、どのモデルが改善し、どのモデルが悪化したかを説明してください。新たなモデル呼び出しは行わず、保存されたスコアを再利用してください。
本番運用のための実践ルール
決定モデルを実際のAIシステムの自動評価に導入するにあたり、以下の実践的な知見が参考になります:
- 評価範囲の細分化(One Judge per Failure Mode):本実験では比較的包括的な全体評価ルールを採用しました。実運用においては、具体的な失敗モードごとに専任の評価者を構築することを推奨します(例えば、予約失敗専用の評価者、有人転送ルール遵守専用の評価者などを個別に設置する)。著者は、タスクの対象を絞り込むことで、大規模モデルと小規模モデルの性能差が縮まる可能性があると予想しています。
- 大から小へと代替手段を探る:まずは対象タスクにおいて十分な性能を発揮する大規模モデルを確認し、その上で軽量モデルがより低コストで同等の効果を達成できるかを検証します。高品質な人手アノテーションは評価の土台です。プロンプトの開発や最適化を行う際は、最終確認用の独立したテストセットを必ず確保してください。
- 業務要件に基づき専用のしきい値を調整する:デフォルトの0.50しきい値をそのまま使い回してはなりません。適合率と再現率に対する自社業務の許容水準を明確にし、訓練セット上での交差検証を通じて適切なしきい値を探索してください。将来的にプロンプトを改定したりモデルを置き換えたりした場合は、しきい値と較正状態を再検証する必要があります。
- 判別能力、判定しきい値、確率の解釈を切り離す:モデルが正常と異常を正しく順序付けできることとデフォルトしきい値が適切であることは別問題であり、訓練セットで基準を満たしても検証セットで性能が低下することは珍しくありません。また、スコアの高低をそのまま実際の失敗確率と見なすことは避けるべきです。
読者が再現可能な演習ステップ
上述の分析プロセスを自ら体験したい場合、原著者がチャートに対応するJSONデータ(98件の対話ログと1対1で対応する0/1ラベル、および各モデルの予測スコア)を公開しています:
- 公開スコアとラベルをローカルファイル
chart-data.jsonとして保存します(labelsは0/1ラベルであり、models[].scoresは同一順序で各ログに対応しています)。 - データをコーディングAgentに渡し、まずしきい値調整プロンプト(日本語訳または英語原文のいずれかを選択)を実行させて、交差検証におけるホールドアウト適合率、再現率、しきい値の選定状況を確認します。
- スコアを信頼確率に変換する必要がある場合は、続いて較正プロンプトを実行させ、Plattスケーリングによって各モデルのブライアスコアが改善されるかを評価します。
元のサポート対話は非公開ですが、公開されているスコアとラベルを用いることでしきい値調整と確率の較正を体験できます。モデルを再呼び出しして判定自体をやり直すには、対話の原本が必要となります。
付録:実験で使用された評価プロンプト
テストにおいて、Perplexity、Liquid d1/d1-ultra、Clef Flash、OpenAI Decisionsには共通のテキストプロンプトが渡され、Jevには専用APIを通じて構造化されたJSON指示文が渡されました。
汎用評価プロンプトを確認する(英語原文と日本語対訳)
汎用テキストプロンプト原文 (General Prompt)
Decide whether `messages` contains at least one substantive failure, risk, or quality problem in the AI assistant's behavior or tool use. This is one complete production trace from an AI that handles apartment-leasing customer support over phone or messaging. The trace includes the conversation plus any tool calls and tool outputs.

Evaluate the AI assistant and its tool use, not the customer. Treat system messages inside `messages` as the instructions governing the assistant's behavior and allowed capabilities. Inspect the full trace, including final turns and all tool calls and outputs. Base the judgment only on evidence visible in this trace. Do not assume external policies, channel behavior, or business requirements that are not present. Do not assume every trace failed. A short, ambiguous, or inconclusive trace is not an issue unless visible evidence establishes a substantive failure.

Return the probability that at least one substantive issue is present; the issue does not need to be named or clustered.

Count as an issue when supported by the trace: the assistant contradicts an applicable system instruction or tool result; makes an unsupported factual or operational claim; misses, misuses, repeats, or falsely claims completion of a required tool action, transfer, booking, cancellation, follow-up, or confirmation; materially misunderstands or leaves an explicit user request unresolved; or exposes internal actions, placeholders, or broken content to the customer in a way that materially harms the interaction.

Do not count as an issue: a minor stylistic preference with no meaningful effect; a failure caused only by the customer's behavior; internal tool metadata that was not exposed to the customer and did not cause an incorrect response; a hypothetical concern requiring information outside the trace; or insufficient evidence and inconclusive conversations.
汎用テキストプロンプトの日本語対訳
`messages` の中に、AIアシスタントの挙動またはツール利用に関して、少なくとも1つの実質的な失敗、リスク、または品質上の問題が含まれているかどうかを判断してください。これは電話またはメッセージングでアパート賃貸のカスタマーサポートを行うAIからの完全な本番ログ1件分です。このログには会話全体に加え、すべてのツール呼び出しとその出力が含まれています。

顧客ではなく、AIアシスタントおよびそのツール利用のみを評価してください。`messages` 内のシステムメッセージは、アシスタントの挙動および許可された機能を規定する指示として扱ってください。最終ターンやすべてのツール呼び出し・出力を含め、ログ全体を精査してください。本ログ内で確認できる証拠のみに基づいて判断してください。ここに存在しない外部ポリシー、チャネル固有の挙動、または業務要件を推測して適用しないでください。すべてのログが失敗していると決めつけないでください。可視的な証拠によって実質的な失敗が証明されない限り、短小、曖昧、または決定打に欠けるログは問題と見なしません。

少なくとも1つの実質的な問題が存在する確率を返してください。問題の具体的な名称を特定したり分類したりする必要はありません。

ログの証拠によって裏付けられる場合、以下を問題としてカウントしてください:アシスタントが適用されるシステム指示やツールの結果に違反している;根拠のない事実上または運用上の主張を行っている;必要なツール操作、転送、予約、キャンセル、フォローアップ、または確認を怠る、誤用する、繰り返す、あるいは完了していないのに完了したと偽る;明示的なユーザーの要望を実質的に誤解している、または未解決のまま放置している;対話に実質的な悪影響を与える形で、内部の操作、プレースホルダー、または破損したコンテンツを顧客に露出させている。

以下は問題としてカウントしないでください:実質的な影響のない軽微な文体の好み;顧客自身の行動のみに起因する失敗;顧客に露出しておらず誤った応答の原因にもなっていない内部ツールのメタデータ;ログ外部の情報を必要とする仮説的な懸念;あるいは証拠が不十分で結論が出ない会話。
TypeSafe Jev 専用構造化プロンプトを確認する(JSON原文と日本語対訳)
Jev 構造化プロンプト原文 (Structured JSON)
{
  "version": "nurtureboss-any-issue-v1",
  "question_id": "has_substantive_issue",
  "type": "noul",
  "instructions": {
    "task": "Does `messages` contain at least one substantive failure, risk, or quality problem in the AI assistant's behavior or tool use?",
    "context": "This is one production trace from an AI that handles apartment-leasing customer support over phone or messaging. The trace contains the complete conversation plus any tool calls and tool outputs.",
    "evaluation_rules": [
      "Evaluate the AI assistant and its tool use, not the customer.",
      "Treat system messages inside `messages` as the instructions governing the assistant's behavior and allowed capabilities.",
      "Inspect the full trace, including the final turns and all tool calls and outputs.",
      "Base the judgment only on evidence visible in this trace. Do not assume external policies, channel behavior, or business requirements that are not present.",
      "Do not assume every trace failed. A short, ambiguous, or inconclusive trace is not an issue unless the visible evidence establishes a substantive failure.",
      "Return the probability that at least one substantive issue is present. The issue does not need to be named or clustered."
    ]
  },
  "criteria": {
    "true": {
      "definition": "At least one substantive problem is supported by evidence in the trace.",
      "examples_of_qualifying_evidence": [
        "The assistant contradicts an applicable system instruction or a tool result.",
        "The assistant makes an unsupported factual or operational claim.",
        "A required tool action, transfer, booking, cancellation, follow-up, or confirmation is missing, incorrect, repeated, or falsely claimed as complete.",
        "The assistant materially misunderstands or leaves an explicit user request unresolved.",
        "Customer-facing text exposes internal actions, placeholders, or broken content that materially harms the interaction."
      ]
    },
    "false": {
      "definition": "No substantive assistant problem can be established from the visible trace.",
      "do_not_count_as_an_issue": [
        "A minor stylistic preference with no meaningful effect.",
        "A failure caused only by the customer's behavior.",
        "Internal tool metadata that was not exposed to the customer and did not cause an incorrect response.",
        "A hypothetical concern that requires information outside the trace.",
        "Insufficient evidence or an inconclusive conversation."
      ]
    }
  }
}
Jev 構造化プロンプトの日本語対訳
{
  "version": "nurtureboss-any-issue-v1",
  "question_id": "has_substantive_issue",
  "type": "noul",
  "instructions": {
    "task": "`messages` に、AIアシスタントの挙動またはツール利用に関する実質的な失敗、リスク、または品質上の問題が少なくとも1つ含まれていますか?",
    "context": "これは電話またはメッセージングでアパート賃貸のカスタマーサポートを行うAIからの本番ログ1件分です。このログには会話全体に加え、すべてのツール呼び出しとその出力が含まれています。",
    "evaluation_rules": [
      "顧客ではなく、AIアシスタントおよびそのツール利用のみを評価してください。",
      "`messages` 内のシステムメッセージは、アシスタントの挙動および許可された機能を規定する指示として扱ってください。",
      "最終ターンやすべてのツール呼び出し・出力を含め、ログ全体を精査してください。",
      "本ログ内で確認できる証拠のみに基づいて判断してください。ここに存在しない外部ポリシー、チャネル固有の挙動、または業務要件を推測して適用しないでください。",
      "すべてのログが失敗していると決めつけないでください。可視的な証拠によって実質的な失敗が証明されない限り、短小、曖昧、または決定打に欠けるログは問題と見なしません。",
      "少なくとも1つの実質的な問題が存在する確率を返してください。問題の具体的な名称を特定したり分類したりする必要はありません。"
    ]
  },
  "criteria": {
    "true": {
      "definition": "ログ内の証拠によって、少なくとも1つの実質的な問題が裏付けられている状態。",
      "examples_of_qualifying_evidence": [
        "アシスタントが適用されるシステム指示またはツールの結果に違反している。",
        "アシスタントが根拠のない事実上または運用上の主張を行っている。",
        "必要なツール操作、転送、予約、キャンセル、フォローアップ、または確認が欠落、誤謬、重複している、あるいは完了していないのに完了したと偽っている。",
        "アシスタントが明示的なユーザーの要望を実質的に誤解している、または未解決のまま放置している。",
        "顧客向けテキストに対話に実質的な悪影響を与える内部操作、プレースホルダー、または破損したコンテンツが露出している。"
      ]
    },
    "false": {
      "definition": "確認可能なログからは、アシスタントの実質的な問題が何ら立証されない状態。",
      "do_not_count_as_an_issue": [
        "実質的な影響のない軽微な文体の好み。",
        "顧客自身の行動のみに起因する失敗。",
        "顧客に露出しておらず誤った応答の原因にもなっていない内部ツールのメタデータ。",
        "ログ外部の情報を必要とする仮説的な懸念。",
        "証拠が不十分であるか、または結論が出ない会話。"
      ]
    }
  }
}