OpenAIも「意思決定モデル」に参入?Decisions APIとJevはどれほど似ているのか
リード振り分け、ゲームの障害物回避から表情が変わるカエルまで:Decisions APIがどのように判断をソフトウェアに委ねるのか、なぜJevと似ているのか、そして確率、スコア、「最大10倍高速」の意味を解き明かす。
顧客から「二重請求された」というメッセージが届いた際、アプリケーションはまず請求部門に回すべきか技術サポートに回すべきかを判断しなければなりません。ユーザーが「ページを更新して」と言ったなら、アプリケーションは即座にリロードアクションを選択する必要があります。これらのタスクで求められるのは、後続の処理を進めるための「判断」そのものです。
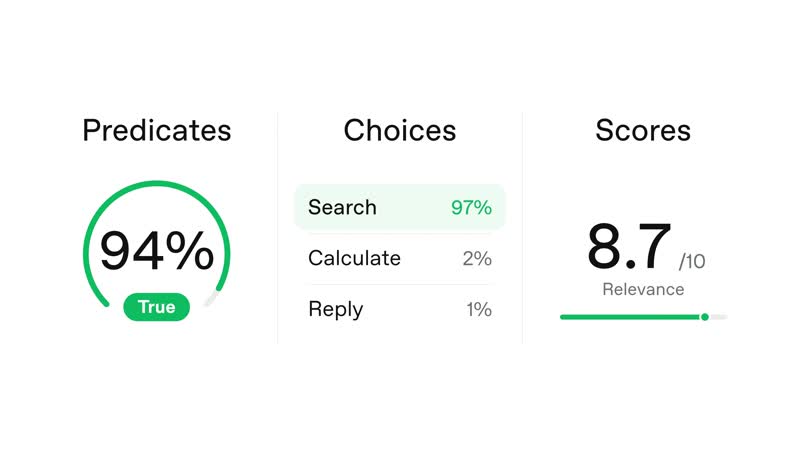
OpenAIは全開発者向けに Decisions API のパブリックベータを開始しました。GPT-6 Luna を用いてテキストや画像を評価し、条件が成立する確率、事前定義された選択肢、あるいは階層別の重み付けスコアを直接返します。
Decisions API はこうした需要に応える専用エンドポイント(POST /v1/decisions)を提供しており、現在は gpt-6-luna モデルに対応しています。自由形式のテキストや解説の生成は行わず、固定された設問形式に対する回答を直接返すことに特化しています。
これは本サイトで紹介した Jev と非常に近いアプローチです。どちらも条件判断、選択、スコアリングをソフトウェアがそのまま扱える結果として確率付きで出力し、コードが次のステップを決定できるようにしています。Jev は TypeSafe による専用の System One 意思決定モデルであるのに対し、こちらは OpenAI が GPT-6 Luna を用いて提供する専用インターフェースです。共通しているのは、その用途と出力の形式です。
なぜ「選択問題だけを解く」独立したインターフェースが必要なのか?
実際のアプリケーションにおいて、こうした「細かな判断」はワークフローの各分岐点で繰り返し発生します。ユーザーのリクエストをどの部門に割り振るか、セールスリードにどのアクションを紐付けるか、ミニゲームの画面で障害物を避けるレーンを選択するか、あるいはある問い合わせに対して天気ツールを呼ぶべきか複雑な推論モデルを起動すべきかを判定するか、といった場面です。
従来の Responses API (自然言語や構造化コンテンツを生成するための OpenAI の主力生成インターフェース) と Structured Outputs (モデルにあらかじめ定めた JSON 形式で出力させる構造化出力機能) を組み合わせる場合、モデルはテキストまたは指定された形式のオブジェクトを生成し、それをプログラムが処理します。一方、既存の選択肢から1つを選ぶだけでよいリクエストであれば、固定された設問形式の回答を直接返す決定インターフェースに切り替えることができます。
その価値は、アプリケーションがまず進むべきパスを選択し、その上で対応する処理フローに入れる点にあります。天気の問い合わせは天気ツールに任せ、提案の比較は推論モデルに回し、人手による確認が必要な操作は審査キューに送るといった具合です。こうした判断は、あらゆるリクエスト、ページ操作、検査対象の画像の手前に配置できます。単一の判断がより高速かつ低コストであれば、繰り返し発生する細かな意思決定を担うのに適しています。バックエンドのツールが実際のタスク実行を担当し、コンテンツ生成が必要になった時点で生成インターフェースを呼び出せばよいのです。
OpenAI によると、Decisions API による意思決定の速度は、Responses API を介して同一の GPT-6 Luna を呼び出す場合と比べて最大10倍高速であるとされています。ただし、この比較は意思決定タスク単体を対象としたものであり、アプリケーションにはネットワーク転送やその後のアクション実行も含まれるため、アプリケーション全体が10倍速くなると単純に捉えることはできません。
3つのコア設問タイプ:どのように結論を導き出すのか?
Decisions API を呼び出す際、リクエストは3つの要素で構成されます。指定されたモデル(現在は gpt-6-luna をサポート)、共有の入力コンテンツ(プレーンテキストまたはテキストと画像の混合をサポート)、そして設問の配列である questions です。設問には3つのタイプが用意されています。条件が成立するかを評価する predicate、事前定義された選択肢から単一選択を行う choice、そして順序付けられたレベルに基づいてスコアリングを行う score です。インターフェースから返される answers 配列には、各設問の名前(name)、タイプ(type)、およびそれに対応する計算済みの回答が格納されます。
1. Predicate(条件が成立する確率問題)
特定の主張や条件が成立している確率を推定するために使用します。インターフェースは硬直的な True または False を出力するのではなく、条件が真であるとモデルが推定した確率値(0から1の間の probability)を、その設問の name や type と共に返します。
- 代表的な用途:アップロードされた商品の写真にひび割れ、破れ、へこみなどの損傷があるかどうかの検査、特定のテキストが現在のコンテキストと関連しているかの判定など。
- 仕組み:開発者は観察可能な客観的基準に基づいた明確な判定基準を指示します。誤検知(偽陽性)と見逃し(偽陰性)に関する業務上の許容コストに応じて、アプリケーション層側で独自の判断しきい値を設定します。損傷した写真を見逃すコストと、正常な写真を誤って損傷ありと判定するコストは異なるため、実際の業務でラベル付けされたサンプルを用いてしきい値を決定すべきです。
2. Choice(非順序選択問題)
開発者が提供した一連の事前定義された候補の中から、最も適合するものを単一選択します。
- 代表的な用途:チケットのルーティング(返金、テクニカルサポート、配送などのカテゴリ分類)、呼び出し経路の選択(雑談、ツール呼び出し、推論モデルへの転送など)。
- 仕組み:返される結果には、選択された選択肢の値(
choice)、すべての選択肢ごとの確率分布(probabilities)、そして個別の信頼度スコア(confidence)が含まれます。事前定義されたカテゴリリストが潜在的な入力を完全に網羅できない場合、ドキュメントでは未分類の入力を受け止めるために"other"選択肢を設定することを推奨しています。一方、モデルから返された信頼度が低い場合は別次元の判断となり、アプリケーション層があらかじめ定めた信頼度しきい値に基づいて、人手による確認へ回すかフォールバック戦略をとるかを決定すべきです。前者はカテゴリの未網羅を解決し、後者は判断の不確実性を処理します。
3. Score(順序階層スコアリング問題)
入力内容を、厳密に順序付けられた一連の離散レベルと照らし合わせてスコアリングするために使用します。孤立したスコアを自由に生成するのではなく、モデルが各離散レベルの確率分布を出力し、各レベルの数値インデックスの確率加重平均を算出します。
-
代表的な用途:問題の重大度評価、チケットの優先順位付け、順序付けされた品質評価など。
-
計算ロジック: 開発者は低から高へと並ぶ一連のレベル(
levels、インデックスは 0 から昇順で開始)を定義します。公式ドキュメントではソフトウェアの障害の重大度を例に挙げています:- レベル 0(Cosmetic):外見上の問題のみで、機能には影響がない。
- レベル 1(Workaround available):特定のタスクが失敗するが、別の回避策が存在する。
- レベル 2(Fully blocked):特定のタスクが失敗し、代替手段がない。
入力が「エクスポート機能が Safari では失敗するが Chrome では正常に動作する」という内容の場合、モデルが推定する確率分布は、レベル 0 が 0.1(10%)、レベル 1 が 0.7(70%)、レベル 2 が 0.2(20%)となる可能性があります。 最終的に返されるスコアは、各レベルのインデックスに確率を掛け合わせて加重計算された連続値となります:
0 × 10% + 1 × 70% + 2 × 20% = 1.1
1.1 は確率分布全体を要約した数値であり、「レベル 1.1」という新たな段階が生じたわけではありません。この例ではレベル 1 に分類される可能性が最も高いものの、レベル 2 に分類される可能性も残されています。業務上1つのカテゴリだけが必要な場合は
choiceを使用すべきであり、重大度順にソートしたい場合はscoreの方が比較に適しています。
同じ 1.1 スコアでも、判断の分布は大きく異なる
これは公式ドキュメントの数式に基づく試算例です。第1の確率グループのみドキュメントの例に基づいており、残りは数学的な比較用です。
0 × 10% + 1 × 70% + 2 × 20% = 1.1
最も可能性が高いのはレベル 1 ですが、依然として 20% の確率でレベル 2 に分類されます。
(スコアは分布全体を要約したものです。人手による確認へ回すかどうかの判断には、各レベルの確率、返された信頼度、そして業務上のエラーコストを総合的に考慮する必要があります。ここではモデルを呼び出しておらず、信頼度のシミュレーションも行っていません。)
「最大10倍高速」と100万入力トークンあたり0.10ドルは、それぞれ何を意味するのか?
Decisions API は、料金体系および呼び出しルールにおいて専用の価格メカニズムを備えています。
価格面において、gpt-6-luna モデルを用いた Decisions API は入力トークン単位で課金され、価格は 100万入力トークンあたり0.10ドル($0.10 per 1M tokens)です。このエンドポイントの呼び出しでは出力トークン料金は発生せず、キャッシュの読み取りや書き込みの料金もかかりません。この価格は /v1/decisions エンドポイントに適用され、リージョン処理の追加料金や長コンテキスト倍率の課金ルールの制約は引き続き受けます。
高トラフィックのアプリケーションであれば、入力ボリュームからコストを試算できます。たとえば、1回のリクエストで平均 1,000 入力トークンを消費すると仮定した場合、100万回の呼び出しで発生する累計入力トークン数は10億トークンとなり、対応する基本入力コストは100ドルとなります。この計算はプレーンテキストの基本入力定価のみを含んでおり、画像入力によって生じるトークン量、リージョン追加料金、長コンテキスト乗数、ならびにネットワークの往復、音声処理、ダウンストリームのツール実行といったバックエンドシステムのオーバーヘッドは含まれていません。
応答速度に関しては、公式スレッドのデモにおけるセールスリード分類の場面でサーバー側の応答時間が100ミリ秒未満であることが示されましたが、これはあくまでそのリード分類デモにおけるサーバー側処理時間に対応するものに過ぎず、エンドツーエンドの遅延や全体的なSLAを保証するものではありません。実際の商用環境では、クライアントとサーバー間のネットワーク転送、ローカルアプリケーションのロジック、およびその後のアクション実行にかかる時間も全体の対話遅延に含まれます。
6つの用途が共通して行っていること:まず判断し、その後のフローに引き渡す
公式の技術デモにおいて、Decisions API はルーティング、離散タスクのタグ付け、画像スクリーニング、UIの意思決定、リスク管理、集約分析にわたる6つの応用パターンを示しました:
- インテリジェントルーティング(Routing):言語モデル、外部ツール、専任の Agent の間でリクエストを振り分けます。たとえば、単純な天気の問い合わせは天気ツールを直接選択し、複雑な分析要求は推論モデルへと誘導します。これにより、異なるタスクを適切な処理フローへと進めることができます。どれだけコストを節約できるかは、バックエンドツールやモデルの実際のコストに依存します。アニメーションに表示される金額はパスごとのコストの目安です。
- テキスト分類(Text classification):非構造化テキストに対して素早くカテゴリ判定と優先順位付けを行います。たとえばユーザーが「二重請求された」と発言した場合、インターフェースは
Billing部門に分類し、その重大度レベルを評価できます。デモ内の信頼度や優先度は表示効果のためのサンプルデータです。 - 視覚スクリーニングとキーフレーム抽出(Image analysis):指示と組み合わせて、画像の損傷検査、属性分類、画像コンテンツの比較を行います。公式デモの約10秒の返品検査では、オレンジ色のバックパックの画像が入力され、画面には品目(Category: Backpack)および損傷の有無(Damage: None detected)が表示されます。提供されている設問タイプに従い、アプリケーションは「どのカテゴリの商品か」を選択問題として記述し、「損傷があるか」を条件が成立する確率問題として記述した上で、回答を画面のフィールドとして構成できます。これは事前定義された設問の組み合わせであり、任意のフィールドを自由に抽出したい場合は引き続き生成インターフェースを使用します。動画を処理する場合も、アプリケーション側でまずフレームを抽出し、その後にタスクに関連するキーフレームをインターフェースによって素早く選別します。
- コンピューター操作の補助(Computer use):自動化タスクにおいて、画面のスクリーンショットと実行可能なアクションのリストをインターフェースに送信し、次の操作(候補となるUI要素の中から「次へ」を選択するなど)の決定を支援します。Decisions API は離散的な選択を行うことのみを担当し、画面座標へのマッピングやクリック操作の実行は外部アプリケーション側で実装する必要があります。
- 安全ガードレール(Guardrails):システムや Agent が危険度の高い操作(共有ディレクトリの再帰的削除など)を実行する前に、Decisions API を利用してリスクレベルを評価します。アプリケーションは返されたリスク判定に基づいて実行を阻止し、人手による確認へ回します。権限管理やブロッキングのロジックはアプリケーション側が担当します。
- パターンおよび傾向分析(Analytics):大規模なデータセットに対してバッチ形式でタグ付けを行い、全体の傾向を集計します。公式デモでは、商品のレビューを肯定的(Positive)、混合(Mixed)、否定的(Negative)の事前定義タグに分類して分布を集計しています。アニメーション内のレビュー件数や分布はサンプルデータであり、実際のデータセットの統計値ではありません。

デモにおける代表的事例:リード振り分けとレーン選択デモ
デモ動画の中で、公式は2つの具体的なシナリオにおける実践的な活用方法を詳しく紹介しています:
- セールスリードの迅速な振り分け:様々な経路から集まる見込み顧客の登録情報に対し、システムは意図と規模を迅速に判定し、それぞれに応じた販売プロセスに引き渡すことができます。たとえば、2〜10人のエージェンシーチームで「購入準備完了(Ready to buy)」と明記され、今月中の導入を希望しているリードに対しては、画面上で次のステップが「製品デモ(Product demo)」と判定されます。一方で、調査段階にある個人ユーザーのリードに対しては、次のステップが「プラン比較(Plan comparison)」と表示されます。これは、事前定義された設問を用いて素早く分類を行い、それらのタグを異なる業務フローに引き渡すという設計思想を反映しています。

- ミニゲーム画面でのレーン選択:もう1つのミニゲームのデモでは、3本のレーン、障害物、自車が含まれるゲームのフレーム画像が Decisions API に継続して送られ、候補となるレーンの中から障害物を避けるためのレーンが選択されます。ゲームのスピードを上げても、画面上ではレーン選択による障害物回避が継続して行われます。これはミニゲームにおける画面判断とアクション選択を示したものであり、実際の車線変更はゲームプログラム側で実行されます。

音声は通常通り対話し、アクションは個別で選択:カエルの表情はいかにして会話に追従するのか?
音声コントロールの場面において、Decisions API は OpenAI の Live API (双方向の低遅延音声対話のためのインターフェース) と連携して動作させることができます。Live API に備わっているクライアント委任パターン(Client Delegation)を活用することで、音声対話とアクションの決定をアプリケーション層で明確に分担させることが可能です。GPT-Live が音声ストリームの聞き取りと発話を維持し、具体的なアクションの選択は Decisions API が担当します。
その標準的な対話と実行のフローは以下の通りです:
- 委任セッションの確立:アプリケーションはクライアント委任を設定した Live セッションを開始し、セッション内でサポートするアクションの集合を宣言します。システムが
session.delegation.createdイベントを受信した際、そこに含まれる委任 ID(event.delegation.id)を保存します。 - 決定入力の組み立て:アプリケーションのサーバー側は、ユーザーとアシスタントの会話書き起こしテキストを収集し、ユーザーからの最新のリクエスト、アプリケーションの現在の状態(アクティブなタブや読み込み状態など)、および現在利用可能なアクションリスト(
back、reload、noopなど)と組み合わせて Decisions API への入力を構成します。 - アクションの選択と実行:Decisions API は利用可能な選択肢の中からターゲットとなるアクションを選択します。アプリケーションは実際に実行する前に、リクエストがすでにキャンセルされていないか、また選択されたアクションが依然として現在の画面状態に合致しているかを検証する必要があります。検証を通過した後、アプリケーションがそのアクションを実行し、状態を更新します。
- 委任 ID 付きのコールバック:アクションの実行が完了すると、アプリケーションは事前に保存しておいた委任 ID を付与し、
session.commentary.appendを介して実行結果を GPT-Live に戻し、ユーザーに音声で伝えるよう促します。音声発話をトリガーせずにコンテキストの更新のみを行いたい場合は、session.thinking.appendを使用します。
単なるUI操作を超えた複雑なタスクに直面した場合、Decisions API はフロントエンドの振り分け役としても機能します。たとえばスライド操作のデモにおいて、ユーザーが「これら2つのプランを比較しておすすめを教えて」と求めた場合、Decisions API は選択肢を reason に分類し、アプリケーションはすかさず Responses API と推論モデルを組み合わせて詳細な分析を実行させ、得られた結論を同じ委任 ID で音声セッションへと送り返すことができます。
公式の技術デモでは、技術者が GPT-Live とカートゥーン調のカエルのキャラクターを組み合わせた例も披露しました。GPT-Live が音声対話を担当し、Decisions API は対話内容に基づいてカエルが表示すべき表情アニメーションを選択します。ユーザーが「今週はクレイジーな1週間だった(crazy week)」と言った際、GPT-Live が「それは疲れ果ててしまいそうですね」と返答すると、カエルの表情は疲弊した状態に切り替わります。ユーザーが「良い意味でのクレイジーさだったんだ(crazy in a good way)」と訂正し、製品のリリースについて言及すると、GPT-Live は直ちに「それはとてもエキサイティングですね!」と返し、カエルも同期して笑顔の表情へと戻ります。双方がアプリケーション層で協調して動作することで、音声による応答と視覚的な表情選択の役割分担が実現されています。

導入時にまず確認すべきこと:必要なのは1つの「判断」か、それとも「新たなコンテンツ」か?
Decisions API は固定された設問形式の判断を担当します。インターフェースを選択する際は、アプリケーションがどのような結果を得る必要があるのかをまず確認してください:
適しているユースケース
- 離散条件と確率推定:ある条件が成立しているかを評価し、確率推定値を取得する必要がある場合。インターフェースが直接Yes/Noの結論を出すのではなく、アプリケーション層が業務上設定されたしきい値に基づいて判定ロジックに変換します。
- 選択肢が事前に閉じた離散的な意思決定:チケットのルーティング先選択、次のUI操作の選定、リクエストパスのルーティングなど。
- 指標に基づく段階的レベルのスコアリング:固定された基準に従って問題の重大度や優先度を離散レベルで採点し、加重数値を取得する場合。
適していないユースケースと実装上の詳細
- 長文テキストの出力や理由の説明が必要な場合:Decisions API は固定フォーマットの判定データのみを出力し、自然言語による解説は行いません。テキストの生成や詳細な論証が必要な場合は、通常の Responses API を使用すべきです。
- 動的な JSON フィールドの抽出が必要な場合:入力テキストから連絡先、金額、明細テーブルなどの構造化オブジェクトを自由に抽出する必要がある場合は、Responses API の Structured Outputs (構造化出力) を使用すべきです。
- パラメータを伴うツール呼び出しが必要な場合:モデルがツールの引数を自律的に生成する必要がある場合(条件付きクエリ文の構築や API パラメータの組み立てなど)は、依然として Function Calling (関数呼び出し) を使用する必要があります。
- 実装上の重要ポイント:
- 観察可能な基準に基づいて設問を設計する:設問は明確で観察可能な客観的基準に基づくべきであり、異なる次元の判断は別々の設問に分割すべきです。分類の選択肢(
choices)間は明確に定義され、境界がはっきりしていなければなりません。階層スコアリング(levels)の隣接するランクには互いに重複しない具体的な根拠を与え、各回答が説明可能な判断基準に対応するようにします。 - 独立した設問は統合し、依存関係のある設問は分割する:単一のリクエストの
questions配列内で、相互に独立した複数の設問を同時に送信し、同一の入力データを共有させることができます(たとえば同じ商品の画像に対して、損傷の有無の検出と商品カテゴリの分類を同時に行うなど)。ただし、後続の設問が先行する設問の回答に依存している場合は、複数のリクエストに分割して段階的に実行する必要があります。 - 設問の命名:各設問には一意の
nameを指定する必要があります。インターフェースはレスポンス内でこのフィールドをそのまま返すため、アプリケーション層での正確な解析と対応する回答の紐付けが容易になります。 - 画像入力フォーマット:現在のエンドポイントはインラインの Base64 Data URL による画像送信のみをサポートしており、ホストされた HTTP/HTTPS 画像 URL や
file_idの受け渡しには対応していません。
- 観察可能な基準に基づいて設問を設計する:設問は明確で観察可能な客観的基準に基づくべきであり、異なる次元の判断は別々の設問に分割すべきです。分類の選択肢(
実際のアーキテクチャにおいて、Decisions API は開発者が事前に設定した設問や選択肢に基づいて確率、選択、加重スコアを返すことのみを担います。しきい値の判定、プロセスの遮断、フォールバック処理、およびその後のアクションの実行は、すべてアプリケーション層自身が担当する役割分担となります。