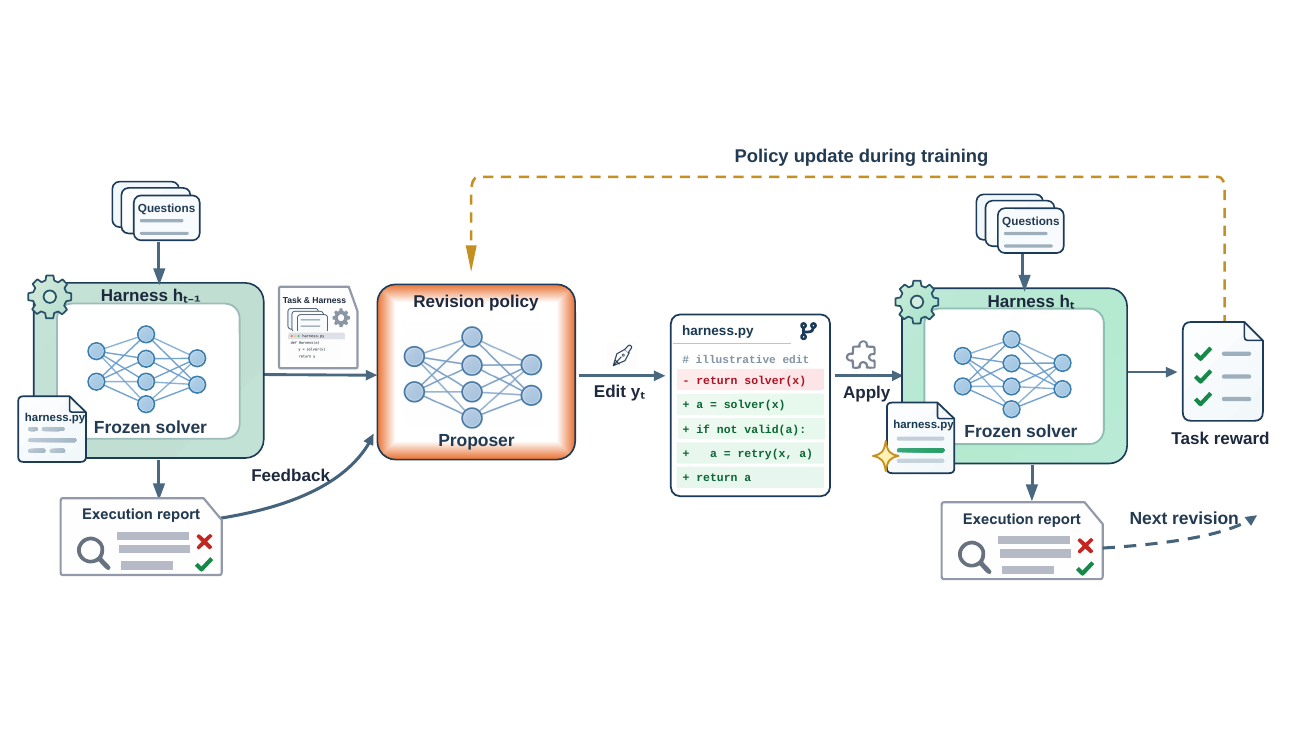
Harness Learning:モデル自身に Harness のソースコードを修正させて新タスクに適応、自己進化する Harness を構築
1つのモデルが問題を解き、もう1つのモデルがタスクのフィードバックに応じて実行コードを修正する:どの資料を読むべきか、いつ検索を続けるか、どうツールを呼び出すかをテスト時に調整可能にする。
普段私たちが「大規模言語モデル(LLM)エージェント」と呼ぶものは、実のところ2つの要素が組み合わさってできています。
- モデルの頭脳(Solver / 解答モデル):LLM 本体であり、問題の理解、推論、回答の生成を担当します。
- 外部の足場(Harness / 実行フレームワーク):この頭脳がどのように働くかを制御する Python コードです。たとえば、最初にどのツールを呼び出すか、どうプロンプトを与えるか、エラーが出た際にどう再試行するか、検索して得た文書をどうまとめるかなどを担います。
これまでの課題はどこにあったのでしょうか? 従来のモデルファインチューニングには重みの更新が必要で、訓練コストが高くなりがちであり、新しいタスクに直面した際にリアルタイムで調整することも困難でした。多くの人は手作業でプロンプトチェーンやワークフローを書いていますが、タスクが変わると作り込んだ手順がそのまま通用するとは限らず、結局手動で再調整しなければならないことが少なくありませんでした。
ジョンズ・ホプキンス大学(JHU)とカーネギーメロン大学(CMU)の研究チームは、Harness Learning(ハーネス学習 / 実行フレームワーク学習) を提案しました。これは、AI エージェントがテスト時にモデルパラメータを更新することなく、自身の実行コードを書き換えることで新しいタスクに適応する手法です。
研究チームは論文 Harness Learning Enables Generalizable Test-Time Adaptation でこの手法の詳細を報告しています。
彼らの解決策は、「大規模言語モデルの頭脳はそのままに、外側の“服”にあたるコードを変える」ことです。 論文では Proposer(提案モデル / コード修正器) と呼ばれるモデルを訓練しました。エージェントが新しいタスクを実行する際、Proposer は実行ログ(どのステップでエラーが出たか、どの事例で誤答したか)を確認し、Harness の Python ソースコードを修正します。たとえば、コードインタープリタのループを追加したり、検索パイプラインを書き換えたり、回答の検証処理を付け加えたりします。
修正されたプログラムを再度実行し、その結果がさらに次の修正ループへのフィードバックとなります。テスト段階に入ると、Solver と Proposer のモデルパラメータは両方とも固定されたまま、更新されるのは実行コードのみとなります。
1回の修正はどのように進められるのか?
このプロセスは、「まず試しに動かし、問題を見つけ、ワークフローを改修し、再度検証する」 と捉えることができます。ここで調整されるのは、目の前の問題1問に対する答えを差し替えることではなく、たとえば数独を解くのに適した実行手順といった、ある特定のタスク種別に対応する実行プログラムです。
- 少量の問題で試走する。 現在のコードを使って正解データがある問題を解かせ、どのツールを呼び出したか、どんな資料を読み取ったか、どの答えを間違えたか、どこでエラーが発生したかを記録します。最初に使われるコードは、論文中で「シード Harness(初期プログラム)」と呼ばれています。
- コードとレポートを修正モデルに渡す。 Proposer はタスクの要求、現在の Python コード、実行レポートを同時に確認し、修正案を提示します。推論タスクでは SEARCH/REPLACE パッチ(古いコードの一部を見つけ、置換テキストを提示する形式)を用い、質問応答タスクでは修正済みの Python プログラム全体を出力します。
- 問題を再度走らせてスコアを測定する。 システムが修正を適用し、評価用の問題を再度実行して、新しいプログラムが正常に動作するか、どの程度正しく答えられたかを検証します。
- 使い続けるバージョンを選定する。 実験ごとの選定ルールは後述します。
- 新しいレポートをもとに修正を繰り返す。 残されたプログラムを再度実行し、新たな結果が次のラウンドのフィードバックになります。
- 推論タスク(Reasoning Gym): 各ラウンドで1種類の修正案を試み、最大5ラウンドまで実施。新バージョンのスコアが厳密に向上した場合のみ置き換え、そうでなければ元のバージョンを維持します。
- マルチホップ質問応答(Multi-hop QA): 各ラウンドで8種類の修正案を試み、最大10ラウンドまで実施。元のバージョンよりスコアが低くても、そのラウンドで正常に動作した最高スコアのバージョンを選択します。8種類すべてが失敗した場合のみ元のバージョンを維持します。
「コードの直し方を学ぶ段階」と「実際にコードを直す段階」は別のフェーズです。 訓練時、研究チームは Proposer のパラメータを更新し、ワークフローをどのように修正すべきかを学ばせます。未知の新しいタスクに直面した際は、学習済みの手法を用いてコードを修正し続けます。この際、Proposer と Solver のパラメータは固定されたままです。
このように、まず「適応の仕方」を学習し、その適応手法を未知のタスクに適用するアプローチは、メタ学習(Meta-Learning) に属します。本論文では適応プロセスにおいて変更される対象が実行可能プログラムであるため、「実行可能プログラム上のメタ学習」と呼ばれています。
具体的にどのようなコードが修正されるのか?
主な変更は3つに大別されます。回答モデルにより完全な資料を読ませる、検索を継続するかどうかを判定する、計算を Python に任せる という点です。以下の図で修正前後のワークフローを切り替えて確認できます。
同一の解答モデルで、ワークフローを切り替える
修正タイプを選択し、修正前後のワークフローを比較します。
修正前
修正後
要約は引き続き「次に何を検索するか」を支援し、原文は「何に基づいて回答するか」を受け持ちます。変わったのは情報の流れであり、検索結果や回答の正しさが必ず保証されるわけではありません。
この修正のコード例を確認
# 処理ロジックの概要例(論文の元コードやそのまま実行可能な実装ではありません)
- answer = answer_from_summaries(s1, s2)
+ answer = answer_from_passages(passages1 + passages2)
論文の図 7、図 12、および第 6.2 節に基づく。計算ループは一般的な修正構造の要約であり、具体的な実装や呼び出し回数は事例ごとに異なります。
回答時は原文を直接読み、要約は検索の誘導だけに使う
マルチホップ質問応答とは、手がかりをたどって複数回資料を検索し、それらを組み合わせて初めて答えにたどり着くタスクです。「ホップ」とは、前ステップで見つかった手がかりに沿って、再度検索を行うこと を意味します。
分かりやすい例を挙げましょう。「ある作家の出生都市はどの国に属しているか?」という問いに対し、まず作家を検索して出生都市を見つけ、次にその都市を検索して所属する国を特定します。これには、前後が連動した2回の検索が必要です。
初期プログラムの流れは以下の通りでした:
1回目の検索 → 要約と次の検索クエリの作成 → 2回目の検索 → 要約 → 2つの要約をもとに回答。
ここでの問題は、要約の段階で回答に必要な詳細が削ぎ落とされてしまう可能性があることです。たとえば、2回目の検索原文には都市が属する国名が書かれていたのに、要約では人口と地理的位置だけが残された場合、最終的なモデルは要約しか見ないため、国名という情報を得られなくなってしまいます。
Proposer が導き出した修正策は以下の通りです。要約は引き続き「次に何を検索するか」を決めるために活用しつつ、最終的な回答時には2回の検索で得られたすべての原文パッセージを直接読み込ませる というものです。これにより、要約によって詳細情報が失われて誤答するリスクを軽減できます(事前の検索とキーワード生成は引き続き適切に行われる必要があります)。
3つの質問応答ベンチマークにおいて、単ステップ強化学習(Single-step RL)で訓練された修正モデルが残したプログラムのうち、84% がこの「原文直接読み込み」の構造を採用していました。多ステップ訓練モデルでは 69%、本研究の特別な訓練を受けていないベースモデルでは 47% でした。(各手法で3つのベンチマーク × 4回の実行 × 10ラウンド、計120個の採用バージョンを統計。84% はプログラム構造の採用比率であり、回答正解率ではありません。2つの訓練方式については後述します)
2回の検索で足りない場合、さらに検索を追加する
論文では、検索を増やす2種類の修正パターンも示されています:
- 検索回数を固定で1回増やす。 2回目の検索と資料整理を終えた後、3つ目の検索クエリを生成して3回目の検索を行い、最後に収集したすべての資料を合わせて回答します。これは修正結果の一例であり、すべてのプログラムが一律で3回検索するわけではありません。
- まず下書きを作成し、必要に応じて再検索する。 モデルがまず仮の回答(下書き)を作成し、Python コードが原文内にその下書きの文字列が含まれているかチェックします。含まれていればそのまま出力し、含まれていなければ下書きの回答をキーワードとして追加検索を行い、新たな資料をもとに改めて回答します。
後者の修正では、「さらに資料を探すべきかどうか」を判断する分岐ルールが追加されています。原文内に回答文字列が含まれているからといって、その回答が設問に正しく答えているとは限りません。このチェックはあくまで追加検索を行うかどうかを決めるための条件に過ぎません。
モデルに解答コードを書かせ、演算を Python に任せる
算術、数独、迷路などの推論タスクにおいて、初期プログラムはモデルを1回だけ呼び出し、直接答えを出力させていました。一方、修正後のプログラムでは、モデルに解答用のコードを書かせ、それを実際に実行させる形式が多く見られました。
「1から10000までの平方和を計算する」という例を考えてみましょう。モデルは sum(i*i for i in range(1, 10001)) のようなコードを生成し、Python に計算を実行させることができます。ここには3者の役割分担があります:
- Proposer が実行フローを改修する: エージェントに「コード生成 → 実行 → 結果またはエラーの取得 → 処理継続」というループを付与します。
- Solver が解答ステップを記述する: 具体的な問題に対し、その問題を解くために必要な Python コードを生成します。
- 実行環境が計算を担う: 結果を返します。エラーが出た場合、Harness はエラー情報を Solver に戻し、解答コードを修正させて再試行させます。
これがインタープリタループ(Interpreter Loop) です。修正によって得られるのは問題を処理するための汎用的なフローであり、特定の問題の答えをハードコードすることではありません。
補助ツールの使用が明示的に求められていない未知のタスクにおいて、成功事例を見せたモデル(SFT)が生成したプログラムの 77% がインタープリタループを採用し、強化学習を経たモデルでは 78% に達しました。(これは生成されたプログラム構造の比率であり、解答の正解率ではありません) 入力解析と解答コード自体が正確である必要があり、コード実行に必要な安全性の制限もシステム側で担保されなければなりません。
Proposer にコードの直し方をどう学ばせるか?
訓練手法は大きく2つの学習アプローチに例えることができます。「他人の修正例をお手本にする」ことと、「自分で修正を試行錯誤し、成績に応じて調整する」こと です。
- 推論タスク:まずお手本を見て、次に自分で試す。 35B の教師モデルが生成した432個の成功した修正事例を用いて、Proposer に修正のフォーマットとやり方を学習させます。このステップは教師ありファインチューニング(SFT)と呼ばれます。その後、自身で修正案を提示して実際に走らせ、その成績に基づいて強化学習(RL)を行います。Proposer と Solver にはそれぞれ Qwen3.5-4B が使われ、教師モデルには Qwen3.6-35B-A3B が使われました。
- マルチホップ質問応答:最初から自分で試す。 教師による模範段階をスキップし、HotpotQA 質問応答データセット上で直接強化学習を実施します。Proposer には Qwen3-4B、Solver には Qwen3-8B が使われました。
4B は約40億パラメータ、35B は約350億パラメータを意味します。2系統の実験ではそれぞれ個別の修正モデルが訓練されました。訓練時も更新されるのは Proposer だけであり、問題を解く Solver は常に固定されています。
どんな問題を見せて修正し、どんな問題で効果を検証するのか?
学生が問題を解く過程に例えることができます。練習問題で苦手な部分を見つけ、小テストで練習後の実力を確認し、最後に独立した試験で本当に身についたかを判定します。論文中の問題にも3つの用途があります:
- 練習問題:問題の診断。 現在のプログラムを実行してレポートを生成し、どこでエラーが起き、どこで誤答したかを Proposer に確認させます。
- 小テスト:修正案の選定。 修正後の候補プログラムを実行して採点し、訓練時の報酬計算やバージョンの選定に利用します。
- 独立試験:効果の最終検証。 修正や選定には一切関与せず、プログラムが他の未知の問題でどの程度の成績を出せるかを最終測定します。
なぜこのような設計にするのでしょうか? 目に見えている誤答だけを修正した場合、特定の事例だけに無理やり合わせた対症療法になっていたり、かえって他の問題を壊してしまったりする可能性があるからです。修正が汎用性を持つかどうかを確かめるには、別の問題群でチェックする必要があります。
3つの用途が必ずしも完全に異なる3つの問題セットに対応しているとは限りません。 訓練時、2つの実験では診断用と採点用の問題を分離していますが、未知のタスクに直面して修正能力をテストする際の設定は以下の通りです:
- 推論タスク: タスク種別ごとに同じ25問を使ってフィードバックを提供し、バージョンの選定にも利用します。残りの75問は最終的な効果の独立検証に用いられます。
- マルチホップ質問応答: 500問の開発セットから各ラウンドで6問を抽出してフィードバックを提供します(レポートには正解ラベルと根拠文書が含まれます)。同じラウンドで別の64問を抽出して候補プログラムを採点します。そして約300問を用いて最終的な効果を独立検証します。
したがって、ここでの「新タスクへの適応」には、依然として正解データがあり、採点可能な問題によるフィードバックが不可欠であり、正解や検証シグナルが全く存在しないタスクにそのまま適用することはできません。
有効な修正にどう報酬を与えるのか?
同一のタスク要件、現在のコード、実行レポートに対して、Proposer は一度に 8種類の修正案 を生成します。システムは修正されたプログラムを個別に実行し、すべて同じ採点用問題セットでテストします。
訓練アルゴリズムはこれら8種類の修正案の成績を比較します。グループ内の平均を上回る修正は今後生成されやすくなり、平均を下回る修正は抑制されます。このように訓練を繰り返すことで、Proposer は有効な修正を提示しやすくなります。このグループ内比較の手法は GRPO(グループ相対方策最適化) と呼ばれます。
各修正に対する報酬は2つの要素で構成されます:
報酬 = 修正後プログラムの解答スコア + プログラムが正常に動作したことに対する報酬。
解答スコアは 0 から 1 の間です。推論問題では評価器による部分点も得られます。プログラムが正常に動作したかどうかについては、別途以下の報酬が与えられます:
- 推論タスク: 修正フォーマットが解析できれば 0.05、修正が正常に適用できればさらに 0.10、テスト実行が完了した割合に応じて最大 0.15 が加算されます。合計で最大 0.30 となります。
- マルチホップ質問応答: コードが構文解析でき、
run関数が定義されており、200行以下で、評価実行を完了した場合に一律 0.10 の報酬が与えられます。それ以外の場合、その候補の報酬は 0 となります。
「プログラムが動くこと」と「正しく解けたこと」は別問題です。 あるプログラムが実行報酬の満点である 0.30 を獲得したとしても、解答が全問不正解であることもあり得ます。推論実験では、失敗した修正でもそれまでに得たわずかな有効性報酬が保持されることがあり、いずれの実験でも報酬がマイナスに差し引かれることはありません。
訓練していない未知のタスクでも適切に修正できるのか?
重要なのは、モデルが訓練用の問題を直すことだけを覚えたのか、それとも新しいタスク種別に対しても修正手法を応用できるのかという点です。研究チームは推論問題とマルチホップ質問応答のそれぞれを検証し、1回だけの修正と連続した複数回の修正の効果も比較しました。
高難度の 5 つのタスクを加えると、スコアはどう変化するか?
異なる修正モデルにコードを修正させ、修正後プログラムの解答スコアを比較します。ボタンをクリックすると、高難度の 5 タスクを含めた場合と除外した場合の差を確認できます。
訓練後の 4B 修正モデルは教師モデルを 0.06 リード。全タスクを含めても優位を維持しますが、差は縮まります。
メイン図では knight_swap、letter_jumble、modulo_grid、sokoban、ab の 5 つの高難度タスクを除外しています。ここでは修正後の問題解決パフォーマンスを比較しており、2 つの修正モデルは同一の固定された Solver を使用しています。出典:論文図 3 / 9、表 9、付録 B.1。21 タスクの SFT 値はグラフからの推定値です。
メイン図の 21 タスクにおいて、固定された Python ツールループのスコアは 0.69 であり、学習による修正の平均スコア 0.62 を上回っています。初期プログラムは解答モデルを 1 回だけ呼び出しますが、ツールループは最大 5 ターンの対話を許可します。この結果は、学習による修正があらゆる手動設計に勝ることや、同一コスト下でより優れていることを証明するものではありません。
小さな修正モデルは、巨大な教師モデルを超えられるか?
Reasoning Gym 推論評価において、修正モデルが訓練時に見たタスク種別とテスト時の種別は明確に分けられています。成功例による訓練には21種別、強化学習には5種別が使われ(重複あり)、主たるテストは訓練で一度も使われていない別の21種別のタスクで行われました。(論文中では OOD と表記。タスク種別全体が修正モデルの訓練に使われていないことを指し、ベースモデルの事前学習時に関連知識に一切触れていないという意味ではありません)
上の図は、異なるモデルがコードを修正した後の、プログラムの平均解答スコア を比較したものです。スコアは 0 から 1 の間で、高いほど優れています。
コードを修正しない初期プログラム(Seed)のスコアは約 0.49、特別な訓練を受けていない修正モデル(Base)による修正後は 0.32、成功事例のお手本を見たモデル(SFT)による修正後は約 0.49、強化学習を経た 4B モデルによる修正後は 0.62、35B 教師モデルによる修正後は 0.56 でした。(初期プログラムおよび SFT の約 0.49 はグラフからの読み取り推定値です)
これは、コードを修正すること自体が進歩を保証するわけではない ことを示しています。特別な訓練を受けていないモデルが修正すると、スコアはかえって約 0.49 から 0.32 へと低下しました。しかし強化学習を経ることで、修正後プログラムの平均スコアは 0.62 に達し、教師モデルによる修正後の 0.56 を上回りました。
ここで比較されているのは「どちらが平均してより有効な修正を行えたか」であり、2つのモデル自体の問題解決能力を網羅的に比較したものではありません。テスト後の成績を確認し、各グループの8つの候補から最も良いものを1つ選んだ場合(oracle)、教師モデルは 0.85、4B モデルは 0.83 となり、教師モデルの方が依然としてやや高いスコアを示します。(テスト成績を知った上で最良を選ぶ集計を oracle と呼びます。実際の運用でバージョンを選ぶ際は開発用問題の成績を用います)
また強化学習は、実行不可能だったりスコアがゼロになったりする修正を減らす効果もありました。ゼロ点という結果には「プログラムは完走したが答えが全問不正解だった」場合も含まれ、必ずしもコードのクラッシュだけを意味するわけではありません。
もう1つ注目すべき比較対象があります。人間があらかじめ作成した固定の Python ツールループの平均スコアは 0.69 であり、学習による単一ステップ修正の 0.62 よりも高くなっています。 この固定ツールループは Solver に最大5ターンの対話を許可しますが、初期プログラムはモデル呼び出しが1回のみです。本研究は修正能力が学習可能であり転移できることを実証しましたが、この結果は固定ツールループを上回ったわけでも、同一の計算コスト下でより優れていることを証明したわけでもありません。
メインの図からは高難度の5種別のタスクが除外されています。これらを加えた全26種別のタスクにおける平均スコアは、Base が 0.282、SFT が 0.415、4B RL が 0.528、教師モデルが 0.501 でした。4B モデルが平均で優位を保っているものの、その差は縮まっています。上の図でこれら2つの集計範囲を切り替えて確認できます。(除外されたタスクは knight_swap、letter_jumble、modulo_grid、sokoban、ab)
1回の修正では効果が平凡でも、10ラウンド連続で修正するとどうなるか?
マルチホップ質問応答において、Proposer は HotpotQA のみで訓練され、訓練には一切使われていない2つの質問応答データセット MuSiQue および 2WikiMultihopQA に適用されました。
まず、2つのアプローチの違いを整理しましょう:
- 80回の独立した試行: 毎回同一の初期コードから修正を行い、80個の単一ステップ修正案を得ます。
- 10ラウンドの連続リレー: 各ラウンドで8種類の修正案を出し、開発用問題を使って1つのバージョンを選定し、次のラウンドではそのコードと新たなレポートを引き継いで修正を続けます。
結果は以下の通りです。質問応答のスコアは完全一致率(EM)です。回答テキストを正規化した上で正解データと比較します(MuSiQue と 2Wiki では別名リストに含まれる正解も許容されます)。(前述の推論タスクの採点基準とは異なるため、2つのタスク間でスコアの高低を単純に比較することはできません)
| 修正のアプローチ | MuSiQue | 2WikiMultihopQA |
|---|---|---|
| 修正なし(初期プログラムを使用) | 0.1438 | 0.2500 |
| 80個の独立した修正の平均スコア | 0.1467 | 0.3090 |
| 80個の中から事後的に選んだ最高スコア | 0.2408 | 0.5200 |
| 10ラウンドのリレー修正後の平均スコア | 約 0.27 | 約 0.55 |
(単一ステップのデータは表23より。10ラウンドの結果は4回実行した最終平均値。2Wiki の約 0.55 はグラフ曲線からの読み取り推定値)
MuSiQue では、初期プログラムが 0.1438、1ステップのみ修正した平均スコアは 0.1467 とほぼ横ばいでしたが、10ラウンド連続で修正すると約 0.27 まで向上しました。2Wiki では、初期プログラムが 0.2500、単一ステップ修正の平均スコアは 0.3090 で、67.5% の案が初期プログラムを上回りました。10ラウンド後の平均スコアはさらに約 0.55 に達しました。
表中の「事後最高スコア」は、最終テストの成績を見た上で、後から振り返って最高得点のプログラムを選び出したものであり、その候補群の中にどれほど優れた結果が含まれていたかを示しています。実際の運用では最終テストの答えを見ることはできないため、バージョンの選定は開発用問題のフィードバックのみに頼ることになります。
フィードバックに沿ってリレー形式で修正していくことには価値がありますが、比較には消費された計算量も考慮する必要があります。 10ラウンドの実行1回につき 8 × 10 = 80 個の案が提示され、4回実施すると計320個になります。一方、独立試行のプールは80個です。1回の実行あたりの候補案の数は同じであっても、得られるフィードバックや実行プロセスは異なっており、実験では総計算コストを厳密に一致させているわけではありません。
さらに、検索はいずれも指定されたコーパス内で行われます。HotpotQA は523万件の Wikipedia 要約、MuSiQue は21,100個のパッセージ、2Wiki は54,957個のパッセージを使用しています。ここで検証されているのは、これらのコーパス内において検索し回答する能力です。
テスト時に何ラウンドも修正するなら、訓練時も何ラウンドも繰り返すべきか?
単ステップ訓練 とは、「現在のコードとレポートを見て、1回の有効な修正をどう完結させるか」をモデルに学ばせるものです。テスト時には、この方法を繰り返し適用することができます。目の前の不具合を1つ修正したら、新しいエラーログを読み、次の箇所を直すという感覚に似ています。(単ステップだからといって、訓練入力が初期コードだけに限られるわけではありません。推論実験では、より洗練された既存プログラムのバージョンも入力として使われました)
多ステップ訓練 では、連続した修正の中で生まれた新しいバージョンも訓練入力として用い、過去に自分が修正したコードを扱う練習をモデルに積ませます。
実験において、多ステップ訓練が単ステップ訓練を一貫して上回ることはありませんでした:
- マルチホップ質問応答における10ラウンド後の最終成績は非常に近い結果となりました(HotpotQA 約 0.62、MuSiQue 約 0.27、2Wiki 約 0.55)。
- 推論タスクでは、多ステップ訓練は標準形式の問題でわずかに高く、問題の表現形式を変更したテストではわずかに低くなりました。
したがって、1回だけの修正能力を訓練しておくだけでも、テスト時に連続して複数ラウンドの修正を行うことが可能 です。どちらの訓練も「今回行った修正の成績」に基づいて報酬を与えており、修正チェーン全体の最終的な利益を初期の修正に分配する設計にはなっていません。長期的な報酬を学習させることで結果が変わるかどうかは、今後の検証課題です。
アルゴリズムは正しく書けたのに、なぜ誤答するのか?
解答アルゴリズムを正しく改修することは全体の一環に過ぎず、実行コードは問題、ツール、解答の受け渡しをしっかりと接続しなければなりません。
問題を正しく読み取り、ツールを呼び出し、結果を返す
研究チームは「複合指示」を通じて、迷路の経路探索、数独の解答、素数を見つける処理といった専用プログラムを修正モデルに書かせ、それらをエージェントのツールフローに組み込む実験も試みました。
32個の候補プログラムを精査したところ、12個が補助アルゴリズムをツールフローに組み込んでいたものの、補助アルゴリズムが最終的な答えの生成に実際に寄与していたのはわずか3個 にとどまりました。(ここでカウントしているのはツールが解答に貢献したかどうかであり、これら3つのプログラムのスコアが必ず向上したことを意味するわけではありません)
コード内にアルゴリズムが存在するのに、なぜ役に立たなかったのでしょうか? 論文では実際に生じた3つの不具合が記録されています:
- アルゴリズムに問題を渡す際のエラー: パース用コードが問題のゴールを示すマーカーを欠落させてしまい、アルゴリズムに正しくタスクを渡せず、通常のモデル呼び出しへフォールバックしてしまった。
- ツールを呼び出す際のエラー: ツール呼び出しメッセージのフォーマットが不正で、ツールが実行できなかった。
- 結果を返す際のエラー: 最終的に提出されたのが未だ解かれていない数独グリッドのままであり、解答が不完全だった。
つまり、「問題を解くプログラムを書くこと」と「エージェントがそれを実際に使って正解すること」の間には、入力解析、ツール呼び出し、結果抽出という3つの関門が存在するのです。
なぜ一部のタスクは1ラウンドで伸びてその後頭打ちになり、別のタスクは伸び続けるのか?
推論タスクの成績は比較的早い段階で伸びが止まりました。表現形式を変更した問題では、単ステップ訓練モデルによる改善の大半が第1ラウンドで生じていました。一方、マルチホップ質問応答では10ラウンドにわたってスコアが伸び続け、第1ラウンドが寄与したのは全体の向上の3分の1から3分の2程度でした。
初期フローの違いが一因と考えられます。推論問題は「1回の呼び出しで直接回答する」状態から始まるため、第1ラウンドで計算ツールを追加することが、大きな変更になった可能性があります。これに対して質問応答は2回の検索から始まるため、原文をどう渡すか、もう1回検索を追加するか、どのような状況で再試行するかなど、後続のラウンドでも調整の余地が多く残されています。
ただし、2つの実験では訓練手法やバージョンの選定ルールも異なっています。この推測だけでは、あるタスクが急速に頭打ちになり、別のタスクが向上し続けた理由を単独で完全に説明することはできません。
継続的な学習の実現には、まだ何が足りないのか?
モデルに実行フレームワークの構築や修正を行わせる試みとしては、すでに Harness-R1、JIT-Agent、Ornith などの先行研究が存在します。本論文はさらに踏み込み、訓練によって獲得したコード修正手法が、訓練に使われていないタスク種別に対しても適用可能であり、複数ラウンドのフィードバックを通じて調整を続けられること を実証しました。
長期的に経験を蓄積できるエージェントを実現するためには、まだ解決すべき課題がいくつか残されています:
- 自律的なデバッグ手法の決定。 現在の実験では、外部システムがコードと実行レポートを整理して Proposer に渡しています。次のステップとしては、モデル自身がコードを検証し、テストを選択し、修正案を比較できるようにすることが挙げられます。
- 正解データがない状況での検証手法の確立。 現状では誤答の判定やコードバージョンの選定を、正解ラベルが存在する開発用問題に依存しています。実際のビジネス環境における多くのタスクには既成の正解が存在しないため、別の信頼できる検証シグナルが必要になります。
- 経験が長期的に保持されるかの検証。 今回示されたのは、あるタスク種別における数ラウンドから10ラウンド程度の調整に過ぎません。多種多様なタスクに連続して直面した際に、修正の経験が蓄積されるのか、あるいは過去の能力が退化してしまわないかは未検証です。
- 2つのモデルを同時に共同訓練する可能性の探索。 今回は Solver を固定し、Proposer のみを訓練しました。共同訓練によって問題解決能力とワークフロー設計が相互に高め合えるかどうかは、今後の探求課題です。
エージェント開発者にとって、本研究は有望な道筋を提示しています。モデルに問題を解かせる訓練を行うだけでなく、実行結果に応じてツールの利用法や情報伝達のフローを修正する訓練を行うというアプローチです。本研究ではタスク横断的な適応効果が実証されました。自律的なデバッグや長期的な経験の蓄積については、今後のさらなる検証が待たれます。