同じ AI モデルでも、Agent フレームワークを替えるとなぜ性能が大きく変わるのか?
小さなモデルを Claude Code、Codex、OpenCode などの実際の Agent ツールで訓練し、タスク完了と無駄な操作の削減を学ばせます。
Hugging Face と Liquid AI のチームが、技術ガイド『The ultimate guide to multi-harness RL』を公開しました。
取り上げているのは、AI Agent を作る際の現実的な問題です。同じ大規模言語モデルでも、組み込む Agent フレームワーク(Harness)が違うと性能が大きく変わります。あるフレームワークに合わせて訓練しても、その能力が別のフレームワークにそのまま移るとは限りません。
このガイドは違いが生まれる理由を説明し、Claude Code、Codex、OpenCode などの既存ツールを強化学習に接続する方法を示しています。モデルが複数の実際のツールでタスクを完了し、不要な操作を減らす練習をする仕組みです。まず問題を整理し、訓練方法と実験結果を見ていきます。
同じモデルなのに、外側の仕組みでなぜ別物になるのか
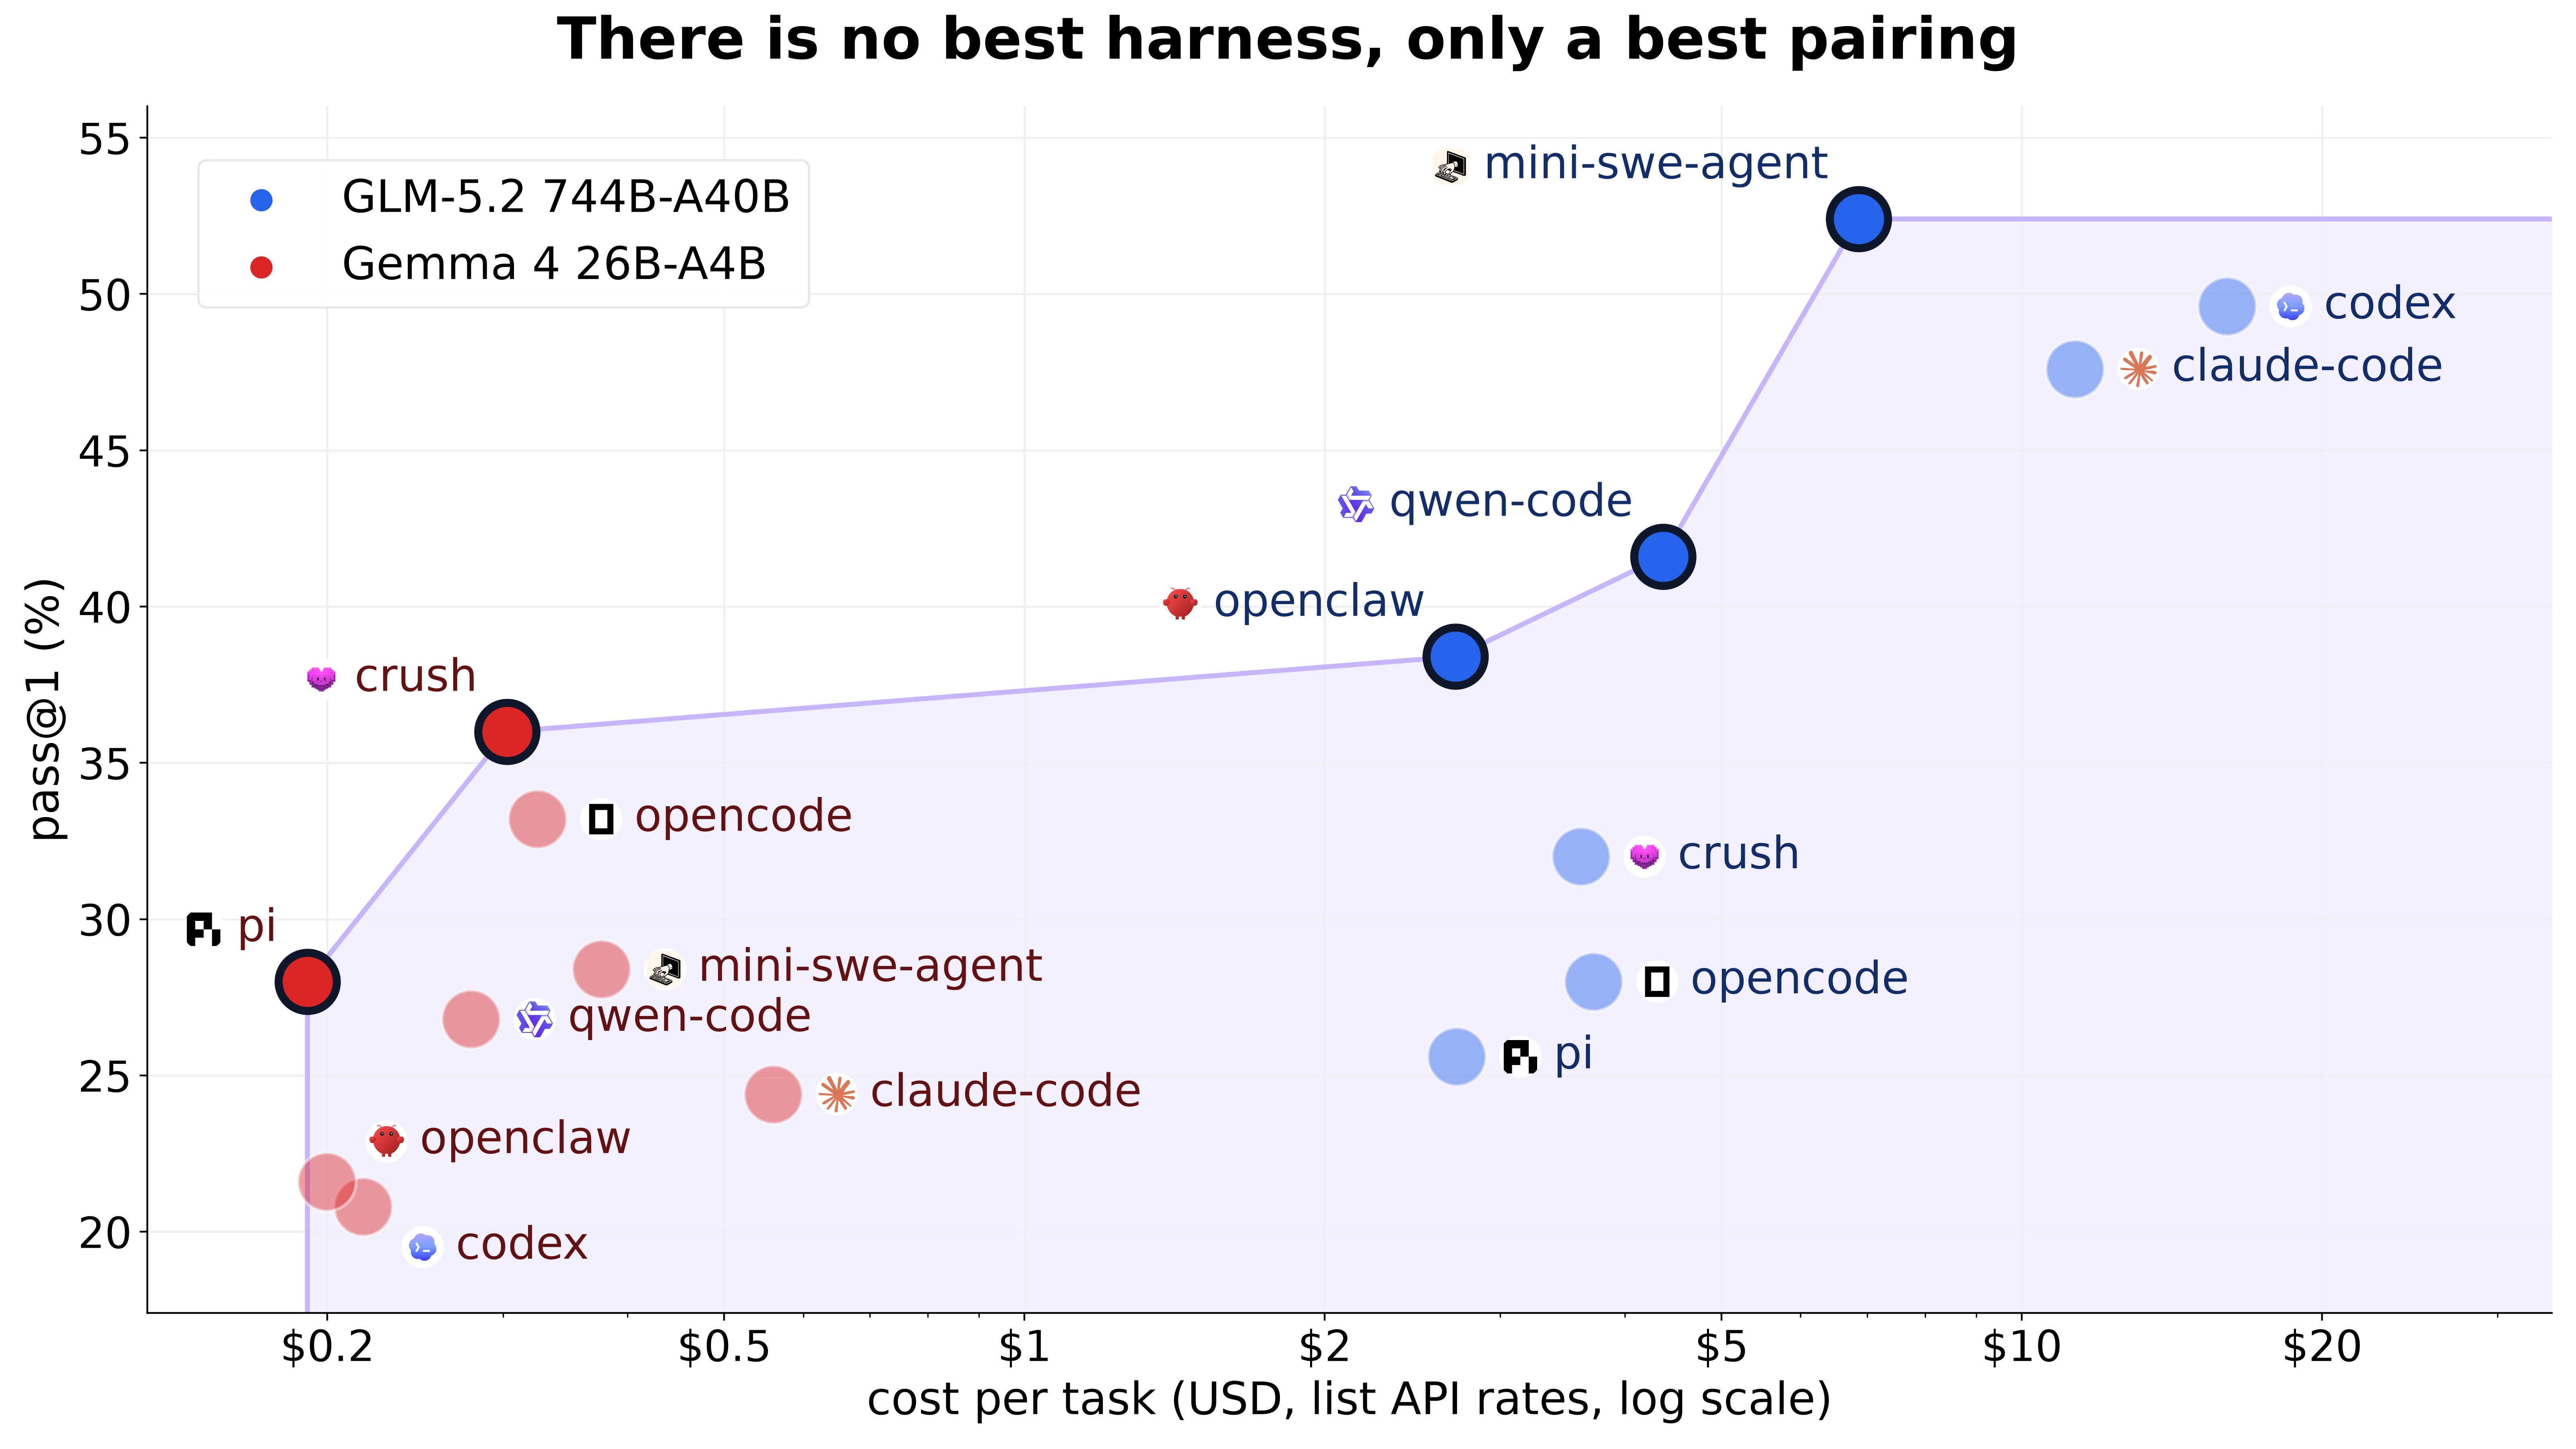
研究者 Joel Niklaus は、同じ GLM-5.2 モデルを複数の Harness で動かし、コーディングベンチマーク SWE-bench Pro で評価しました。外側のプログラムを変えるだけで、タスク解決率が明らかに変わりました。さらに、ツールの順位はモデル間でそのまま使えません。10 種類の仕組みのうち Codex は GLM-5.2 の 2 番目に優れた組み合わせでしたが、Gemma 4 26B-A4B では下から 2 番目、9 位でした。

青い点と赤い点をそれぞれ追ってください。GLM の最良の組み合わせは Mini-SWE-Agent、Gemma の最良の組み合わせは Crush です。上に行くほど多くのタスクを解き、左に行くほど 1 問あたりの費用が低くなります。費用が高くても解決率が高いとは限りません。「最も優れたツール」はモデルとの組み合わせで判断する必要があります。また、横軸は今回の RL 実験の訓練費用ではありません。
ガイドは条件をそろえた評価も紹介しています。同じ SWE-bench Verified の 100 問、同じコンテナ、50 ステップの操作予算とタイムアウトを使い、Harness の構成だけを変更しました。最小構成には履歴圧縮と再試行がありません。改善構成はツールを簡素化し、圧縮と再試行を加えます。完全構成はさらに自己チェック、ドリフトチェック、ロールバックを加えます。
| モデル | 最小構成 | 改善構成 | 完全構成 |
|---|---|---|---|
| GLM-5.1 | 52.5% | 56.5% | 65.5% |
| GPT-5.4 | 55.0% | 58.5% | 63.5% |
| Kimi K2.6 | 52.0% | 59.0% | 60.5% |
3 構成で首位になるのは、それぞれ GPT、Kimi、GLM です。Harness がモデルの順位も変えることが具体的に分かります。ランキングで上位のモデルが、自分の実行ループでも上位とは限りません。データはガイドが引用する Zhang らの Table 2によるものです。
基盤モデルを包むこのプログラムは、研究や産業の分野で Agent Harness と呼ばれます。
混同しやすい役割を整理する
仕組みを理解するため、よく使う概念を分けておきます。
- Policy(方策/基盤モデル):モデルの重みそのものです。プロンプトを入力し、テキストや token を生成します。呼び出しをまたぐ記憶はありません。モデルはツールと引数を選び、外側のプログラムが実行します。
- Harness:モデルの外側のプログラムです。コンテキストを構成し、利用できるツールを提示し、ツール呼び出しを捕捉・実行します。引数の解析、エラー処理、再試行や終了の判断も担当します。
- Agent:Policy を Harness に組み込んだ全体です。ユーザーが利用するのは、ループで動作するこのプログラムです。
- Sandbox(サンドボックス):ツールがコードを実行する隔離環境です。Docker コンテナ、軽量仮想マシン、リモート Linux セッションなどが該当します。
- Benchmark(ベンチマーク):固定された問題集と採点ルールです。
モデルはツール呼び出しや最終回答を提案します。Harness が操作を実行して次のコンテキストを組み立て、自分のルールで再試行または停止します。Harness を替えると、モデルが読む情報と呼び出せるツールが変わります。
RL 環境と Harness も別の役割です。環境はタスクの状態を保持し、行動を受け取り、状態を変え、観測を返し、条件が満たされると報酬を与えます。Harness はモデルと環境のやり取りを継続させます。ファイルや計算結果は環境の状態です。一方、いつファイルを読み、いつモデルを再度呼び、いつ止めるかは Harness のループが決めます。
1 種類のツールだけで訓練すると、なぜ偏るのか
オープンモデルを自分で運用するとき、重みがあるだけでは選んだツールのインターフェースに適応できるとは限りません。
快手の KwaiKAT チームは KAT-Coder 研究で、固定された 1 種類の仕組みだけで Agent の強化学習を行うと、問題の解き方より、その仕組み特有の作法を学びがちだと指摘しています。過適合を 3 種類に整理しています。
- 形式(Format):ツール呼び出しの API 方言はさまざまです。標準の OpenAI 形式、Anthropic の構造、Aider のように通常のテキスト内に特定のコード編集ブロックを要求する方式があります。ツール名も違います。A は
bash、B はterminal、C はexecute_commandと呼びます。A の引数名を覚え込んだモデルは、B では引数が不正として拒否されることがあります。 - コンテキスト構造(Context):履歴をどう圧縮するか、Markdown でコンテキストを組むか、構造化メッセージのリストを使うかは Harness ごとに異なります。ある並びに慣れたモデルは、別の形式でつまずく可能性があります。
- 制御フロー(Control Flow):構文修復や再試行の保護を自動で行う仕組みもあれば、1 回の失敗で終了する厳しい仕組みもあります。自動回復に依存するモデルは、慣れた環境を離れると先に進めなくなるかもしれません。
Orchard 論文は大きな性能低下を記録しています。OpenHands で調整した OpenSWE-32B を、最小限の Mini-SWE-Agent で動かすと解決率が 7.5 ポイント下がりました。未経験の Kimi-CLI では SWE-bench Verified のスコアが約 60% から 3.6% に急落し、Terminal-Bench 2.0 ではゼロでした。同じ論文は、別のシステム Scale-SWE が元のツール以外では有効なツール呼び出しを生成できないことも観測しました。解決率の低下と呼び出し形式の失敗は別の問題です。
ガイドが整理する Poolside Laguna、Kimi K3、Qwen、Xiaomi MiMo などは、訓練で接する Harness の種類を増やしています。ただし方法は異なります。Poolside は教師あり学習に外部ツールの軌跡を混ぜますが、その後の RL は製品ツール pool のみで行います。Kimi はモジュールを組み合わせて実行構成を変えます。Qwen3-Coder-Next は 6 種類のツールでコーディングデータを生成します。「複数ツールでの訓練」が、データ収集、教師あり微調整、強化学習のどの段階で行われるかを確認する必要があります。ただ、オープンソース開発者には共通する難題があります。成熟したツールは他者が作った独立プログラムで、訓練用には設計されていません。そこへどう RL を接続するのでしょうか。
ブラックボックスの Harness を訓練するには、なぜ最終テキストだけでは足りないのか
従来の強化学習では、環境は一般に Gymnasium のような標準的な関数ライブラリです。Microsoft の Agent Lightning チームは、この違いをホワイトボックス環境とブラックボックス環境として説明しています。
- ホワイトボックス環境(訓練器がループを制御):訓練エンジンが主導します。生成する各 token と、環境の
env.step()を呼ぶ各段階を完全に管理します。TRL のような訓練フレームワークも、元はこの前提で作られています。 - ブラックボックス環境(Harness がループを制御):Claude Code や Codex のような実際のツールは、起動するとサンドボックスで自分のロジックを実行します。コンテキストの圧縮、内部での再試行、不完全な JSON の修復を自分で行います。訓練器は外側から、モデルのエンドポイントへ届く HTTP リクエストを見る形になります。
ここでは「やり取りのループを誰が制御するか」で区別しています。他の報告では、履歴を圧縮するかどうかをこの言葉で区別する場合もあり、意味が違います。内部ループが単純な Harness でも、自分でタスクを制御できます。
ブラックボックスなら、ツールの終了後に画面へ出た対話全体を保存し、報酬と一緒に訓練に使えばよい、と考えたくなります。
しかし、正確なサンプリング記録を必要とする今回の方策勾配法では、テキストと最終スコアだけで生成時の出来事を確実に復元できません。
token のずれと対数確率の欠落
PPO、GRPO などの方策勾配法が正しい方向へパラメータを更新するには、2 つの記録が必要です。
- 生成時に実際にサンプリングした token ID は何か。
- その時点でモデルがその token に与えた確率はいくつか。Logprob はその確率の対数です。
テキストだけを残し、後から再トークン化すると、いくつかの問題が生じます。
- token のずれ(Token Drift):同じ文字と空白でも、コンテキスト境界が違うと再トークン化後の token ID が変わる場合があります。訓練器が、実際にはモデルがサンプリングしていない token を更新してしまいます。
- 親切な修復による混入:Harness は次の段階に履歴を送る前に、空白を整理し、抜けた括弧や JSON の項目を補うことがあります。最終テキストで損失を計算すると、モデルが自分では生成していない修正済みの回答に責任を負うことになります。
- 非同期訓練での比率の無効化:大規模 RL では軌跡の生成と逆伝播を並行します。更新時の重みは、その軌跡を生成したときより数ステップ新しい場合があります。重要度サンプリングには、現在の確率を生成時の本当の確率で割る計算が必要です。生成時の logprob がなく、現在の重みで再計算すると、新旧の比率が区別のない 1 になり、方策の違いを補正する情報を失います。
この研究は、テキストから推測せず、推論エンジンが返した元の token ID と生成時の logprob を保持します。原文はリクエストとレスポンスからサンプルを再構築する OpenForgeRL も紹介し、有効な結果が報告されていると説明しています。正確な記録は今回の方式であり、他の方式では訓練できないと証明したわけではありません。
同じテキストでも token 境界が変わる
原文の境界の模式図です。各枠が 1 token で、3 枠目から 2 つの列が異なります。
上段はサンプリングした 2 token とテンプレート後続を別々に保持します。下段は改行と特殊マーカーを別の token にまとめます。同じテキストでも生成時の token ID が同じとは限りません。模式図は境界を示し、実際の語彙 ID は示しません。
原文 Figure 7 の token drift 図をローカライズ。
OpenEnv、Harbor、TRL をつなぐ 3 つの仕組み
未改変の既存ツールと厳密な強化学習を接続するため、この研究は 3 つのオープンソース要素を組み合わせています。
OpenEnv は環境、Harness、訓練器が共有するインターフェースとサービスを提供します。記録用プロキシはその一部です。報酬はタスクの検証器が出し、パラメータは TRL が更新します。通信をつなぐだけで、モデルがタスクを解けるようになるわけではありません。
1 回のタスクで、Harbor は隔離サンドボックス内に実際の Harness を起動します。モデルへの各リクエストは OpenEnv の記録用プロキシを経由して、vLLM または SGLang に届きます。プロキシは生成記録を保持し、レスポンスを Harness の要求する形式へ戻します。終了後、訓練器はプロキシの軌跡と Harbor の採点を取得し、TRL が重みを更新します。
既存ツールを保てるのは、どの Harness もモデルのエンドポイントを呼ぶ必要があるからです。rollout ごとに独立した記録セッションを割り当てます。Harness はプロキシの base URL を使い、セッション ID を API key として渡します。プロキシはそれを使って並行リクエストを各タスクへ振り分けます。ツールは自分の規則で実行、再試行、コンテキスト整理を続けます。
ツールはそのまま動き、訓練記録を取得する
構成の模式図:上はモデル呼び出し、下は訓練に必要な 2 系統のデータです。
同じ訓練器に異なる Harness を接続できます。8 試行の各グループは同じ Harness を使い、グループ間で切り替えます。
記録用プロキシ(Capture Proxy)の設計
このプロキシは、複数プロトコルに対応したモデルゲートウェイとして中核を担います。
- API 方言の変換:既存ツールは Anthropic Messages、OpenAI Chat Completions、Gemini 形式、OpenAI Responses などを使います。プロキシはパス、Header、Body から形式を判別し、NVIDIA Polar ゲートウェイ由来の変換器で標準的な補完リクエストにそろえます。推論エンジンには統一形式が届きます。
- 完全なレスポンスを記録してからストリームを再生:ツールが Streaming を要求しても、プロキシは推論エンジンから不完全な Delta を分割取得しません。完全なレスポンスを待ち、すべての token ID と元の logprob を保存してから、ツールへストリームとして送ります。Harness は必要な形式を受け取れますが、最初の token までの待ち時間は長くなります。
- サンプリングの偏りを除く:プロキシは
top_p=1.0に固定し、全分布からサンプリングしてprocessed_logprobsを有効にします。低確率 token の切り捨ては生成分布をゆがめ、RL のエントロピー崩壊につながる可能性があります。実験ではtop_pを 1.0 にすると、重要度サンプリング比率が偏った 0.985〜0.993 から、1 に近い 0.9984〜0.9999 になりました。 - 呼び出しの網を訓練用の木へ整理:実際のコーディング作業は一問一答ではありません。エラー後の再試行、子 Agent の起動、上限に達した履歴の圧縮があります。プロキシは token の最長共通接頭辞を探し、呼び出しを分岐するグラフにつなぎます。
- 放棄した再試行は、後続のない枝になります。
- 子 Agent は独自のシステムプロンプトを持ち、新しい木の根になります。
- 根から葉までの接続された各経路を訓練シーケンスとして出力します。ツールが入力したコンテキストは Mask=0 で損失計算から除外し、モデル自身の生成は Mask=1 で勾配計算の対象にします。
Harbor と TRL の接続
- Harbor はタスクのサンドボックスを管理します。40 種類以上の主要 Harness と、E2B、Daytona、ローカル Docker など 26 種類の実行バックエンドを標準でサポートします。タスクのディレクトリには指示、環境構成、検証スクリプトがあり、Harness とサンドボックスは実行時に選びます。rollout の指示でタスク、ツール、サンドボックスを指定し、タスクとツールを分離できます。
- Harbor の公式軌跡 ATIF と照合します。通信異常で訓練データが欠落しないよう、プロキシの token シーケンスと ATIF を各ステップの token 数とステップ数で確認します。チームは以前、空のツール配列で 400 エラーが起き、途中の軌跡が気づかないうちに切れる問題を発見しました。
- TRL の
AsyncGRPOTrainerで、軌跡生成と逆伝播を非同期に分離します。2 枚の H100 のうち、1 枚は vLLM で推論して軌跡を生成し、もう 1 枚は訓練シーケンスから勾配を計算します。並行動作により最も遅い Agent を待つ時間を減らします。軌跡は通常 2 ステップ前、最大 4 ステップ前の重みから生成されるため、生成時の確率を残す必要があります。
環境サーバーと訓練器の間には HTTP の境界もあります。初期は Harness を訓練プロセス内に置き、異常で 1 つのプロセスが落ちると他が同期を待ち続けることがありました。今は ok=False、reward=None を返し、訓練器が失敗状態を処理します。検証器が実行されていない場合を、「回答が誤りで報酬 0」とは扱いません。
プロキシは推論バックエンドの能力を確認します。回答できることと訓練データを提供できることは別です。正確な token と対応する確率を返さないホスト型 API は、ツール評価には使えてもこの訓練方式には使えません。確率の欠落や不整合がある呼び出しはコンテキストとしてのみ残し、訓練対象にはしません。履歴圧縮で呼び出しグラフに新しい根ができる場合もあります。
小さなモデルを 4 種類のツールで訓練すると何が改善するのか
チームは Liquid AI の LFM2.5-2.6B、26 億パラメータのモデルを出発点にし、Kaggle notebooks から作った SmolDataEnvs のデータ分析問題で訓練しました。モデルはデータを調べ、計算し、結果を読み、検証できる回答を提出します。開始から終了までの 1 回の試行が rollout です。1 つの回答だけでなく、複数のツール操作を含みます。
中程度の問題例は「全サッカー試合のうち、引き分けは何パーセントか」です。サンドボックスに database.sqlite があり、データを確認して計算し、単一の数値を /workdir/answer.txt に書いて終了するよう指示されます。正解の 25.4% はタスク構成を通じて検証器に渡されます。モデルは入力データから計算してファイルを提出しなければなりません。数値を言えるかだけでなく、正しいデータを読み、ツールを使い、提出形式を守り、検証器が回答を取得できるかまで試します。
訓練プールは 1,000 問で、中程度が 400 問、難問が 600 問です。2 グループは同じタスク順序で各 1,000 ステップ訓練します。一方は OpenCode のみ、もう一方は OpenCode、Claude Code、Codex、Mini-SWE-Agent を切り替えます。同じ問題の GRPO の 8 試行はすべて同じツールを使い、グループ間で切り替えます。ツール自体の違いを行動の良し悪しと混同しないためです。
評価には訓練と notebook、問題、指示が重ならない保留済みの 250 問を使います。各問題を 4 ツールで 1 回ずつ試し、1,000 評価単位になります。Pass@1 は最初の採点可能な試行が正解かを示します。これはデータ分析タスクの結果で、実際のコードリポジトリを修正する成功率とは直接同一視できません。
正解したときだけ効率のボーナスを付ける
初期の Qwen 実験は正誤だけを報酬にし、一部の処理が長くなり続けました。LFM には小さな効率報酬を加えました。誤答は 0、正答は 1 + 1.5 ÷(15 + ツール呼び出し回数)です。追加分は最大 0.1 で、呼び出しが増えるほど小さくなります。
GRPO(グループ相対方策最適化)は同じ問題への 8 試行の報酬を比較し、グループ平均に対する高低から学習信号を作ります。8 試行すべて正解なら、単純な 0/1 報酬は全部 1 で差がありません。効率報酬があると、短い正解過程の報酬が高く、長い正解過程は低くなります。誤答なら、3 回しか呼ばなくても 0 のままです。
保持された訓練更新に寄与するグループのうち、OpenCode-only は 97/555 グループ、17.5%、複数ツールは 155/686 グループ、22.6% で、採点可能な試行がすべて正解ながら呼び出し回数は異なりました。こうしたグループではボーナスだけが報酬差を生みます。これはグループ数であり、最適化ステップ数ではありません。
8 試行すべて正解でも、何を学べるのか?
実験の実際のグループです。Claude Code、80 ステップ、同じ難問。正誤だけなら 8 試行すべて 1 点ですが、効率報酬を加えると呼び出しの少ない試行が高得点になります。
8 試行すべて正解で報酬が同じなので、グループ内に使える報酬差がありません。
| 試行 | 結果 | ツール呼び出し | 報酬 | グループ平均との差 |
|---|---|---|---|---|
| 1 | 正解 | 10 | 1.0000 | 0.0000 |
| 2 | 正解 | 4 | 1.0000 | 0.0000 |
| 3 | 正解 | 6 | 1.0000 | 0.0000 |
| 4 | 正解 | 4 | 1.0000 | 0.0000 |
| 5 | 正解 | 9 | 1.0000 | 0.0000 |
| 6 | 正解 | 8 | 1.0000 | 0.0000 |
| 7 | 正解 | 5 | 1.0000 | 0.0000 |
| 8 | 正解 | 9 | 1.0000 | 0.0000 |
実験の式:正解の報酬 = 1 + 1.5 ÷(15 + 呼び出し回数)、誤答は 0。ここでは方向を見るために報酬からグループ平均を引いています。実際の GRPO はグループ内標準偏差でも正規化します。スクリプトなしでも既定の比較を読めます。
全体平均の前にツール別の結果を見る
最終 1,000 ステップ時点の結果です。基盤モデルは 998/1,000 評価単位で採点が完了し、最終の両グループは全 1,000 単位で完了しました。
| ツール | 基盤モデル | OpenCode のみで訓練 | 4 ツールで訓練 |
|---|---|---|---|
| OpenCode | 33.6% | 58.0% | 49.6% |
| Claude Code | 33.2% | 42.0% | 48.8% |
| Codex | 40.0% | 43.2% | 53.6% |
| Mini-SWE-Agent | 62.1% | 66.0% | 64.8% |
| 全体 | 42.2% | 52.3% | 54.2% |
同じ基盤モデルでも Mini-SWE-Agent では約 6 割、Claude Code では約 3 割しか解けません。これがモデルとツールの組み合わせの影響です。OpenCode のみで訓練すると、最大の改善は OpenCode に現れます。4 ツールで訓練すると全インターフェースで基盤モデルを上回り、Claude Code と Codex では単一ツール訓練も上回ります。
ただし 54.2% と 52.3% の差は 1.9 ポイントです。原文はノイズの範囲と判断しており、複数ツール訓練の全体正解率が有意に高いとは言えません。Mini-SWE-Agent の 64.8% と 66.0% も近い値であり、同じ値ではありません。複数ツールグループは訓練済みの 4 インターフェースで新しい問題を評価しており、完全に未知の Harness は試していません。
曲線は最終表だけでは見えない情報を補います。両グループは主に最初の 200 ステップで上昇し、その後は変動しながらも改善をおおむね 1,000 ステップまで保ちます。各チェックポイントでは各問題・各ツールで 1 回しか試していません。1〜2 ポイントの上下をそのまま能力変化とは判断できず、全体の推移に意味があります。

呼び出し数には一見矛盾する現象があります。複数ツールグループは訓練中の平均呼び出しが多いのに、評価では 4 ツールすべてで単一ツールグループより少なくなります。訓練平均には、元から OpenCode より呼び出しの多い Claude Code、Codex、Mini-SWE-Agent が混ざっています。評価では両モデルが同じ 4 ツールを使うので、同じインターフェース内で比較できます。訓練平均はツールの組み合わせが違うため、それだけで効率を判断できません。
正解する問題で操作は減るが、「31% 削減」には分母がある
基盤モデルと訓練後モデルの両方が正解した同じタスク・ツールの組だけを比べると、最終的に複数ツール訓練は呼び出し総数を約 31%、単一ツール訓練は約 11% 減らしました。複数ツールは OpenCode で 32.8%、Claude Code で 28.3%、Codex で 53.0%、Mini-SWE-Agent で 16.2% 減っています。
呼び出しが減ると、毎回送り直す履歴も減り、入力 token も減少します。31% は対応する問題での呼び出し総数の相対的な減少です。全問題の平均でも、請求額や所要時間の削減率でもありません。単一ツール訓練は Claude Code の正解率を上げましたが、最終的な呼び出しと入力 token は増えました。500 ステップ時点の出力 token は約 62% 多くなったこともあります。正解率と実行効率は分けて見る必要があります。

| ツール | 単一ツール群の対応問題数 | 複数ツール群の対応問題数 | 複数ツール群の出力 token 削減 | 複数ツール群の入力 token 削減 |
|---|---|---|---|---|
| OpenCode | 74 | 66 | 37.9% | 27.2% |
| Claude Code | 55 | 69 | 16.8% | 24.8% |
| Codex | 71 | 89 | 39.7% | 45.9% |
| Mini-SWE-Agent | 137 | 132 | 16.6% | 11.2% |
呼び出し、出力、入力は別々の作業量です。Codex では呼び出しが 53.0%、出力 token が 39.7%、入力 token が 45.9% 減っています。「呼び出しが半減」を「計算がすべて半減」に置き換えることはできません。
LFM には効率報酬を外した対照実験がなく、削減のすべてをボーナスだけの効果とは言えません。訓練で接した量も異なります。単一ツールと複数ツールが実際に見た異なるタスクは 555 と 626、教師信号の token は 12.5M と 18.7M、処理した token は 162M と 451M です。Claude Code は履歴を書き換え、軌跡あたり平均約 8 行の訓練データを生みますが、他のツールは約 1 行です。各設定の乱数シードは 1 つで、観測的な比較です。
大きなモデルの成功過程を模倣するとどうなるのか
チームは Qwen3.8-27B を教師にも使いました。各問題・各ツールで最大 3 回試し、検証器が最初に正解とした軌跡を残した結果、888 問から 3,189 の成功軌跡を得ました。SFT(教師あり微調整)は、それまでの対話とツール出力をコンテキストにして、教師の次の応答を学びます。RL は小さなモデル自身の試行に対する報酬から学びます。
単一ツール SFT は 801 の OpenCode 軌跡を使います。複数ツール SFT はすべての軌跡を混ぜ、ツール別に均等化していません。どちらも 2 エポック訓練します。
成功軌跡 1 つが訓練サンプル 1 つになるわけではありません。assistant の各ターンを「それまでのコンテキスト → 次の応答」に展開し、その応答だけを訓練します。原文は学生の LFM 自身のチャットテンプレートでトークン化します。これは先ほどの RL の記録要件と矛盾しません。SFT は学生モデルで教師の回答の確率を学びます。一方、今回の RL は新旧方策を比べるため、学生が実際にサンプリングした token と生成確率を一致させる必要があります。
| 訓練方法 | 全体 Pass@1 | 両モデルが正解した問題の呼び出し削減 |
|---|---|---|
| 基盤モデル | 42.2% | 基準 |
| 単一ツール SFT、2 エポック後 | 47.5% | 8.5% |
| 複数ツール SFT、2 エポック後 | 43.1% | 24.2% |
| 単一ツール RL、900 ステップ | 52.4% | 13.2% |
| 複数ツール RL、700 ステップ | 54.6% | 26.7% |
複数ツール SFT は Claude Code(33.2% → 42.4%)、Codex(40.0% → 46.8%)、OpenCode(33.6% → 38.0%)を改善しました。しかし Mini-SWE-Agent は 62.1% から 45.2% に下がり、他の改善を打ち消しました。全体の 43.1% は基盤モデルの 42.2% に近い値です。単一ツール SFT は主に OpenCode を 33.6% → 51.6% に改善し、Claude Code は 33.2% のまま、Mini-SWE-Agent は 58.8% に下がりました。SFT が Mini-SWE-Agent を損なう理由は、まだ説明されていません。

今回の RL は正解率が高いものの、「SFT は答えを暗記するだけで、RL だけが修正を学ぶ」とは結論できません。目的、データ源、タスク群、計算量が違い、各設定は 1 回しか実行していません。複数ツール SFT の教師信号 token は単一ツールの約 7 倍です。表の SFT は 2 エポック後、RL はテストセットで選んだ最良チェックポイントなので、やや RL に有利です。それでも、この RL のチェックポイントと最終 1,000 ステップの全体スコアとの差は、いずれも 0.5 ポイント未満です。
また、ツール効率の報酬がない複数ツール SFT でも、呼び出しが 24.2% 減り、4 インターフェースすべてで減少しました。効率改善は異なる訓練方式でも生じます。呼び出しが減ったという事実だけから、特定の報酬が原因だとは言えません。
予定される対照実験は、こうした交絡要因に対応しています。「SFT 後に RL」と「基盤モデルから直接 RL」を比べ、模倣で得た出発点の効果を調べます。教師が 4 ツールすべてで解いた 692 問で混合方法を比較し、問題選択の差を減らします。さらにツールごとの教師信号 token 数をそろえ、サンプル量の差を減らします。これらは未実施で、どの変更が利益を生むかをより明確にするための実験です。
Qwen はなぜ上昇した後に下がったのか
初期の Qwen3.5-2B は易しめの 1,000 問を使い、正誤だけを報酬にしました。複数ツール群は 14.6% から 500 ステップの 37.0% へ上がり、OpenCode-only は 700 ステップで 39.5% に達しました。しかし両方とも 1,000 ステップで約 26% に戻りました。別の独立した OpenCode 環境の実験はゆっくり上昇し、1,000 ステップで最良の 29.8% に達しました。

軌跡からは別々の問題が分かります。
- 複数ツール群は訓練で最大 16,384 出力 token を許し、評価は 4,096 に制限します。後半は回答が長くなり、計算すべき場面で長い説明を出します。評価で上限に達した単位は 9 から 556 に増えました。訓練で身についた出力習慣が評価予算で打ち切られます。上限を広げれば解けるかは、この結果では検証されていません。
- OpenCode-only は操作を続けても提出しません。呼び出しは訓練で約 10 回から 20 回、評価で 17 回から 21 回に増えました。提出記録のある単位のうち、回答を提出する割合は 69% から 41% に下がりました。
- 複数ツール群は 684 ステップの再起動後、ほぼ既出の問題ばかり取得し、後半のデータ接触が変わりました。ただし低下は 500 ステップから始まっているため、再起動バグではその始まりを説明できません。
「順番に訓練する」という説明で見落としやすい現象も 2 つあります。最適化ステップの 35%〜58% では、どのグループにも報酬差がありません。4 ツールは軌跡を約 4 分の 1 ずつ提供しますが、Claude Code は訓練行の 77%、教師信号 token の 35% を占めます。軌跡を均等にしても実際の訓練量は均等ではありません。新しい難問群で訓練を続けても、複数ツール群のピークは回復しませんでした。
後の LFM は 3 点を同時に変更しました。効率報酬を加え、問題群を中程度と難問にし、訓練と評価の出力上限をともに 4,096 にしました。改善は 1,000 ステップまで維持しましたが、同時変更なので個々の寄与は分離できません。訓練予算、評価予算、提出の有無、グループ内の報酬差を一緒に調べる必要があり、訓練報酬の上昇だけでは不十分です。
開発者が持ち帰れること
まず、Agent の性能はモデルと実行プログラムの両方で決まります。Harness を切り離したモデル順位だけで選ばず、自分のツール、タスク、コンテキスト管理、予算で評価してください。モデルでもツールでも、変更するとシステム全体の振る舞いが変わり得ます。
次に、この研究はオープンな実装経路を示します。実際の Harness のツールとループを保ち、モデルのインターフェースで訓練に必要な記録を集め、同じ訓練器に複数のツールを接続します。対応するモデル API を使うプログラムを支援しますが、互換性のある推論バックエンド、構成設定、検証可能なタスクも必要です。任意のプログラムにプロキシを足すだけで訓練できるわけではありません。
報酬も本当の目標に対応させる必要があります。原文は「何か提出すれば 0.2 点加える」試みを記録しています。モデルはすぐ提出するようになり、訓練報酬は正常に見えましたが、保留問題の正解率は 74.0% から 17.8% に下がりました。正解と効率の関係を目的に組み込み、少ない手順や早い提出をタスク完了の代わりにしてはいけません。
今回の LFM は各群で 2 枚の H100 を使い、単一ツールで約 32 時間、複数ツールで約 46 時間でした。評価、待ち行列、再起動は含まず、総費用は集計されていません。小さなモデルの試作はある種類のデータ分析問題で実行可能性を示しましたが、すべてのモデル、タスク、ツール混合方式の一般順位は確立していません。
再現の入口:まず訓練記録を取得できるか確認する
原文の入口は OpenEnv の 4 コマンドです。info はバックエンド、タスク、ツールの能力を確認し、rollout は単独でタスクを実行します。serve は環境サービスを提供し、push は同じサービスをデプロイします。単一タスクと記録の照合が通ってから訓練器を接続すると、ツール実行とサービス層の問題を分けて調べられます。
依存関係には Python 3.12、OpenEnv の Harbor 拡張と型付き TrainingTrace API、TRL の HarnessRolloutWorker があります。原文公開時、この worker は TRL の main ブランチの実験モジュールにあり、当時の安定版には含まれていませんでした。再現時は付属例に合わせて依存関係を確認してください。
vLLM は --return-tokens-as-token-ids と --logprobs-mode processed_logprobs が必要です。原文は SGLang の非ストリーミング token 返却が v0.5.17 から対応すると説明しますが、チームが試したのは main ビルドだけです。vLLM のこれらのフラグを SGLang にそのままコピーしてはいけません。普通のチャットが成功しても、token と確率を完全に記録できた証明にはなりません。
サービスの容量も 1 グループ全体に対応させます。原文の環境サービスの max_concurrent_envs は既定値 4 ですが、GRPO の 1 グループは 8 rollout です。上限を超えると CAPACITY_REACHED が返るため、訓練前に実際の並行数へ設定します。記録用プロキシ自体は単一プロセスです。チームは約 200 並行セッションでヘルスチェックに負荷がかかり、320 でクラッシュしたことを観測しました。その実行での観測値なので、拡張前に自分の負荷を測る必要があります。
SmolDataEnvs の完全な訓練セットは約 5,000 問で、この実験は 1,000 問を選びます。過去の実験は E2B、現在のチュートリアルは Daytona を使い、独立 OpenCode 環境との比較も含みます。そのため、現在のチュートリアルは過去実験の厳密な再現ではありません。
モデルとデータのコレクションは実験成果をまとめています。LFM 複数ツール RL モデルの既定版は 1,000 ステップで、step-700 ブランチが最良のテストチェックポイントです。訓練比較ダッシュボードでは元の曲線を見られます。SFT データセットはツール別の分割と事前トークン化構成を提供します。新しい実行には Harbor の OpenCode アダプターを使ってください。原文に残る独立した opencode_env は、過去の比較用の入口と明記されています。