動画生成が再生より速く:fal が MiniMax H3 を追加学習し、リアルタイム生成を実現
fal はオープンウェイトの MiniMax H3 を追加学習し、自社の推論スタックと共同で最適化しました。5 秒の動画が約 3 秒で返り、15 秒のコンテンツは再生終了前に次のセグメントを生成できます。
- H3 Max は 5 秒・768p の動画を約 3 秒で返し、一部のリクエストでは生成速度が再生速度を上回ります。
- fal はオープンウェイトの MiniMax H3 を追加学習し、モデルを自社の推論スタックと共同で最適化しました。
- H3 Max はオーディオ付き画像生成動画のリーダーボードでトップに立ち、テキスト・画像・最初と最後のフレーム・参照素材を使った動画生成に対応します。
- 通常の 768p 価格は出力 1 秒あたり 0.08 ドル。リアルタイムシステムはバッファリング、キャッシュ、失敗時のフォールバック、コスト管理によって長期運用を実現します。
個人開発者の Pieter Levels が、あるTwitch配信をリポストしました。画面に映るアニメーションは、事前に用意された再生リストではなく、ビデオモデルが次々と生成しているものです。実演者の Rehan Sheikh 氏は、fal の MiniMax H3 Max を配信パイプラインに組み込み、生成を続けられる「次元を超えたテレビ」を視聴者に見せました。
Levels 氏はこれをAI動画生成における歴史的な瞬間と呼び、大胆なアイデアも示しました。これまで15秒の動画を生成するのに2〜5分待つことが多かったのに対し、このシステムは9秒で15秒分のコンテンツを返せます。次の動画は、現在の動画が再生し終わる前に準備できるため、配信は事前に作り込んだ番組表に依存する必要がなくなります。視聴者の投票やチャット、選択はすべて次の生成に反映できます。同じキャラクターが異なる世界に入っていくことも可能で、自分だけのために生成され続けるチャンネルを、各自が持つことさえできるのです。動画は「生成してから見る」ファイルから、見ながら動作するコンテンツシステムへと変わり、遊び心や想像力の幅は大幅に広がります。
この配信で呼び出されているのは、fal が提供する H3 Max です。これはオープンウェイトの MiniMax H3 を基盤としています。H3 はテキスト、画像、動画、音声を同じコンテキストに入れることができ、同期した音声付きの動画を直接生成できます。fal はこれをさらに後続学習させ、モデルを自社の推論システムと共に最適化しました。
H3 Max の速度は、H3 が持つマルチモーダル能力に由来します。統一された入力、2K生成、ネイティブ音声、オープンウェイトという特徴が、fal が何を追加学習できるかを決定づけ、H3 Max と標準の H3 がそれぞれどのようなタスクに適しているかも左右します。
生成時間が再生時間を下回るとき
15秒のクリップを生成するのに二分かかる場合、製品はユーザーに待つか、事前にバッチ生成するしかありません。生成が9秒で完了するなら、システムはクリップAを再生しながらクリップBを生成できます。クリップAが終わる前に、クリップBはバッファに入るのです。このサイクルが回り続けることで、生成モデルは単発の動画ファイルを納品するツールから、画面に供給し続けるリアルタイムコンポーネントへと変わります。
ここで言う「リアルタイム」は、ゲームエンジンのように毎フレームを即時レンダリングすることを要求しません。重要なのは、生産速度が長期的に消費速度に追いつくことです。クリップ時間が15秒で、エンドツーエンドの生成が15秒を下回れば、システムには正の時間余裕が生まれます。さらに一つか二つのクリップ分のバッファを追加すれば、遅延のばらつきをある程度吸収できます。
長時間の運用には、キャラクターや画風、ストーリーの繋がりを保つこと、リクエストが失敗した時の代替クリップの準備、チャット入力を次のプロンプトに変換すること、コンテンツとコストの継続的な管理も必要です。ピーク時の同時接続や常時運用の信頼性も、配信システム全体で担うことになります。
H3 Max はどのようにして生まれたか
fal Research は、オープンウェイトの MiniMax H3 を出発点に、新しいデータを加えて後続学習を行いました。重点的に強化したのは、プロンプトへの追従、映像の美しさ、視聴覚の質です。fal の推論チームは同時に、自社の推論エンジンに合わせてモデルとサービスの経路を調整しました。
統一マルチモーダル + ネイティブオーディオ
プロンプトへの追従と美学
スループットとレイテンシー
マネージドエンドポイント
後続学習は、モデルが何を生成しやすいかに影響を与えます。fal は学習に、実際の生成ワークロード、人間の好み、検証可能な強化学習タスクを組み込み、全体的な好み、プロンプト理解、美しさをそれぞれ評価しました。推論の最適化は、同じリクエストをより速く完了させるためのもので、モデルの実行、サンプリングプロセス、基盤となるシステムが関わります。
二つのチームは、モデルが完成する前に、品質と速度を一緒に調整しました。研究チームは遅延目標を後続学習に組み込み、推論チームは最終的なウェイトに特化した最適化を行いました。fal の目標は、社内の品質評価でリードを保ちながらスループットを上げることであり、単純にサンプリングステップを減らすことではありません。
ベースとなる H3 の統一されたマルチモーダルコンテキストと、ネイティブのステレオ音声も引き継がれています。入力で映像、カメラワーク、音声を同時に記述でき、出力は同期した音声付きです。そのため、ショート動画の制作では、ナレーションや環境音を別途生成したり、音声トラックを同期させたりする手間が省けます。
fal は15秒の「1984」という動画で、テキスト、構図、連続する動きの組み合わせ制御を示しました。画面内のタイポグラフィ、スタンプ、文字が、カメラの動きに合わせて連続的に変形します。
続いて fal は、六本の動画で、ローアングルの追従撮影、ファースト/ラストフレーム間の遷移、同じキャラクターの六つのシーンへの登場、ネイティブの同期音声、複数カットにわたるスタイル維持、複雑なプロンプトを順番に実行すること、をそれぞれ紹介しました。
さらに fal は、「一つのプロンプト、一回の生成、後処理なし」の作品を六組披露しました。連続する災害の長回し、レトロなピクセルアートのパルクール、鏡に向かっての台詞とリップシンク、クレイアニメーション、ハチドリのスローモーション、コーヒー製品のクローズアップです。映画のカメラワーク、ゲーム映像、人物の演技、スタイライズされたアニメーション、自然撮影、商業製品という六つの用途をカバーしています。
これらの能力をプロンプトに書き込む際は、「主体と素材」「カメラと動き」「音声とテンポ」の三つの層で整理すると、モデルは何を、どのように撮るのか、そして音声がどのように映像に合わせて進むのかを、同時に把握できます。
2.5秒、3秒、9秒、35倍は、それぞれ何を指すのか
fal の5秒・768pのテキストから動画へのリクエストでは、例として timings.inference = 2.5286 秒、画像から動画へでは 2.7652 秒が記録されました。一般的な仕様では、ウォールタイムは3秒未満です。timings.inference はバックエンドのノイズ除去推論を記録したもので、エンドツーエンドの体験には、待ち行列、ネットワーク転送、入力のアップロード、プロンプトの拡張などがさらに加わります。
Levels 氏が示したのは、15秒の動画が9秒で返ってくるというものでした。fal は15秒の生成について、およそ15秒という一般的な見込みを示しています。この両方の数字は、異なるリクエスト、プロンプトの複雑さ、システム負荷、記録方法に由来する可能性があります。インタラクティブな製品では、9秒はすでに出現したデモ結果として捉え、15秒をより堅実な初期見込みとして、自社のリクエストログで調整していくのが良いでしょう。
fal の測定では、H3 Max のスループットは MiniMax 公式の H3 エンドポイントの約35倍で、平均して同程度の品質のモデルより15倍高速です。実際の製品では、各レスポンスの timings.inference に加え、エンドツーエンドのP50、P95、失敗率、待ち行列時間も記録する必要があります。
プロンプトの拡張も、体感速度を変えます。fal は768p、5〜10秒、balanced モードを推奨しています。fast での拡張は約一秒ですが、quality モードでの書き換え自体に最大30秒かかる場合があります。インタラクティブなアプリケーションでは、プロンプト処理、待ち行列、推論、転送、最初のフレーム再生をそれぞれ記録する必要があります。
H3 Max、二つの画像生成動画リーダーボードで首位
fal は H3 Max を12のビデオモデルとペア比較し、全体的な好み、プロンプトへの追従、映像の美しさをそれぞれ評価しました。そして、ベイズ方式のEloレーティングと95%信頼区間で集計しました。H3 Max は三つの項目全てで首位となり、対戦した全てのモデルに対して、一対一の比較の過半数で勝利しました。
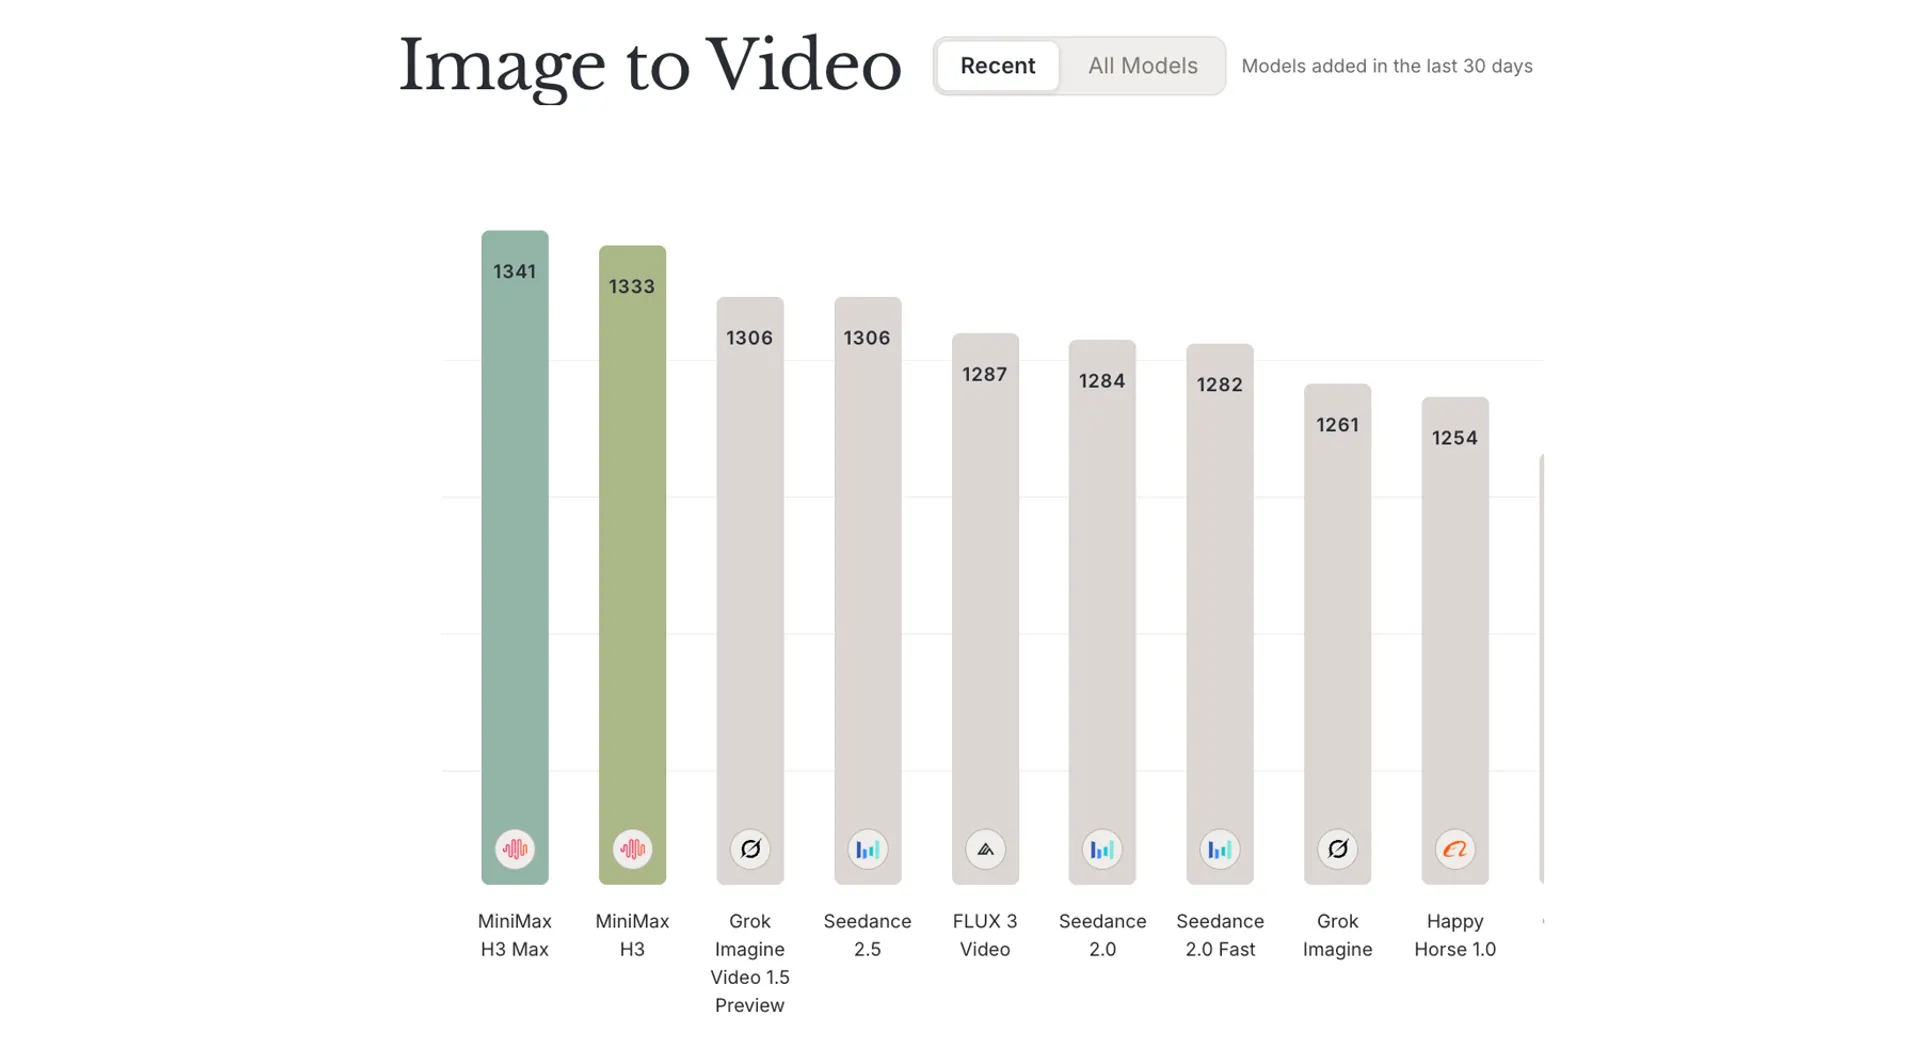
Design Arena は当時、H3 Max を画像生成動画のトップにランク付けし、Eloは1341でした。Artificial Analysis は当時、これを H3 Turbo 768p という名前で記録しており、Eloは1201、±11、サンプル数は2177でした。
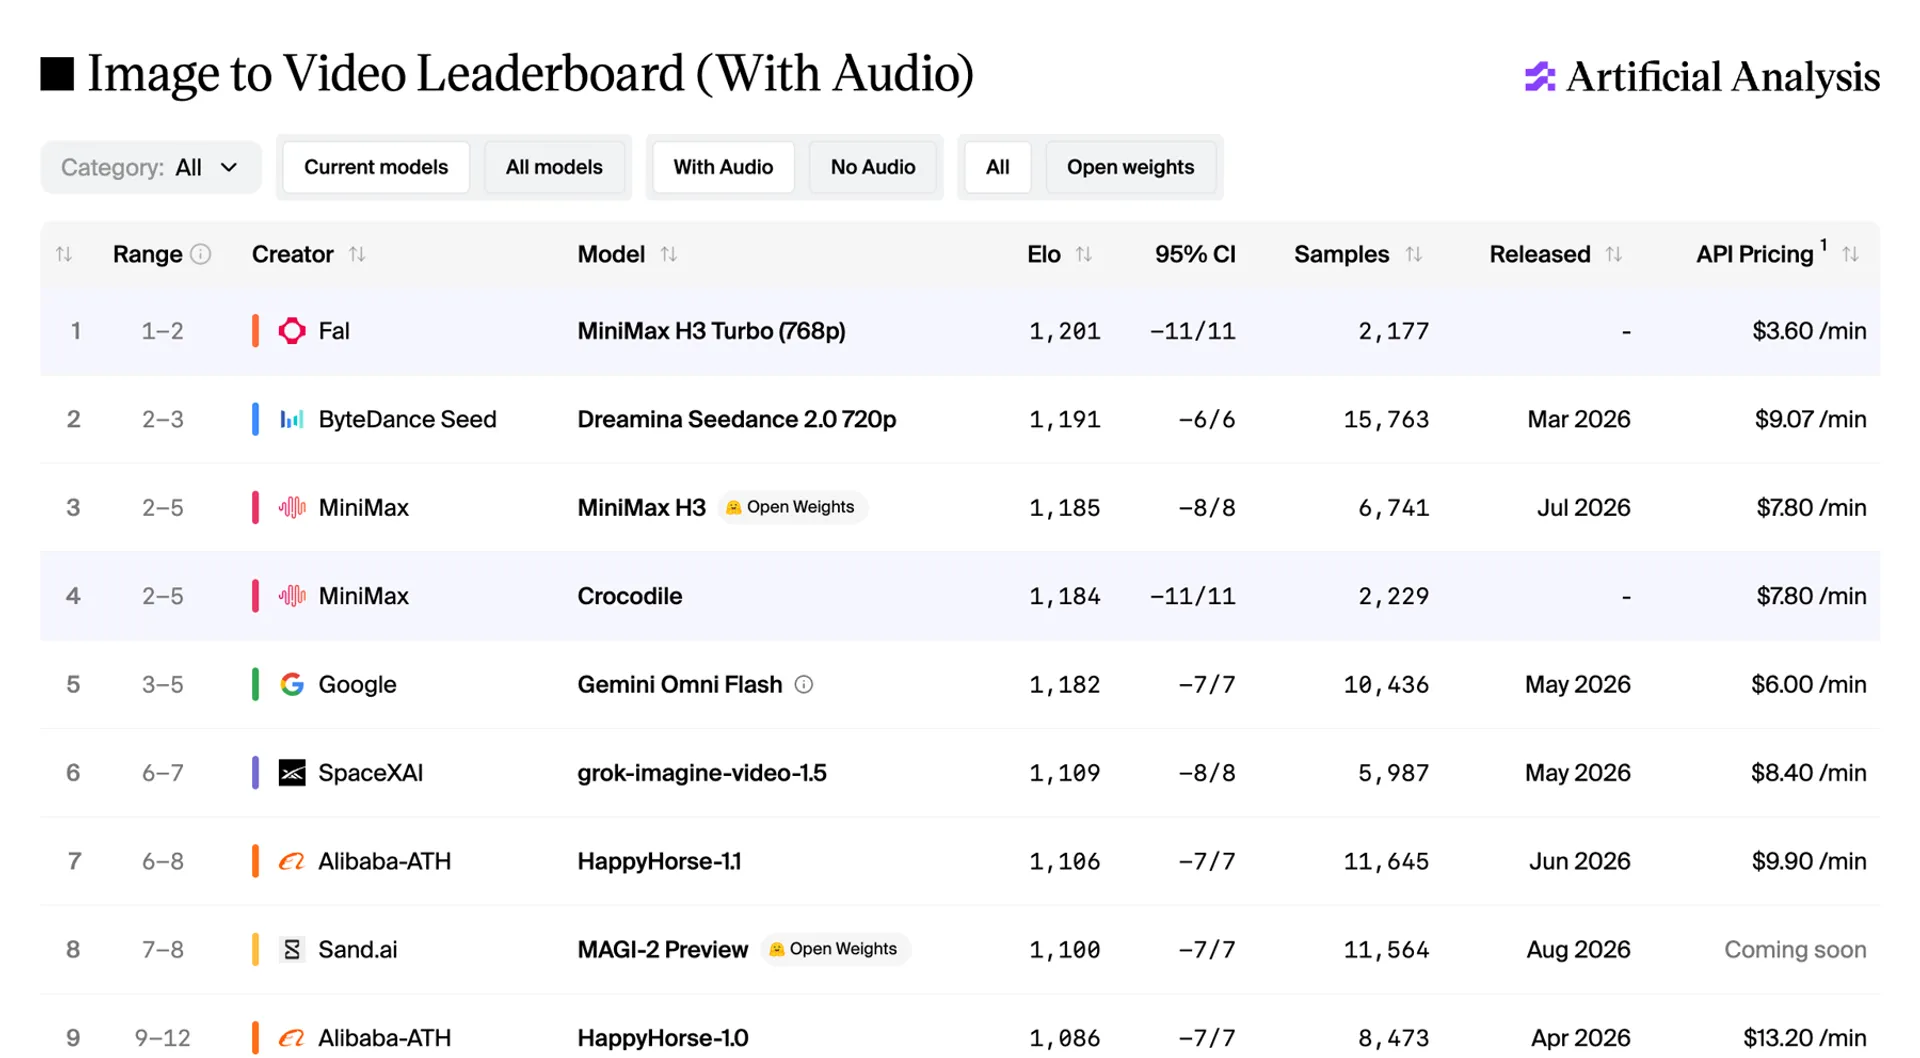
2026年9月1日時点で、Artificial Analysis の「音声付き画像生成動画」リーダーボードでは、H3 Max が Elo 1203、95%信頼区間 ±9、サンプル数5400で首位です。次点の Dreamina Seedance 2.0 は1190、標準の MiniMax H3 は1185、Gemini Omni Flash は1179でした。このリストは、新しい投票が行われるたびに更新されます。
12モデルと比較全体的な嗜好 / プロンプト理解 / 美学
5400サンプル2026年9月1日に音声付き画像生成動画でトップ
Artificial Analysis が評価しているのは、音声付きの画像生成動画です。テキストからの動画生成、動画編集、15秒の長回し、キャラクターの一貫性は、それぞれ別のタスクであり、個別にテストする必要があります。
H3 Max と標準 H3、どちらを選ぶか
H3 Max は主に480pと768pで動作し、768pがチューニングの重点です。16:9出力は1344×768、24fps、一回の生成で5〜15秒、ネイティブの同期音声に対応します。fal は、テキストからの動画生成、画像からの動画生成、ファースト/ラストフレーム制御、参照からの動画生成のエンドポイントを提供しています。
標準の MiniMax H3 は、2K・最大15秒に対応し、より完全なマルチモーダル参照と動画編集機能を持ちます。ベースウェイトはすでに公開されているため、セルフホスト、研究、カスタムトレーニングを行うチームに適しています。H3 Max は同じオープンベースを使用していますが、現在は fal のAPIを通じて利用します。
| ニーズ | より適した選択肢 | 理由 |
|---|---|---|
| クイックプレビュー、インタラクティブな物語、配信クリップ | H3 Max | 5秒のクリップが約3秒で生成され、プロンプトへの追従と768p出力が優先される |
| 2Kの最終成果物 | 標準 H3 | H3 Max の上限は768p |
| セルフホスト、研究、独自のファインチューニング | 標準 H3 | 標準 H3 はベースウェイトが公開されており、H3 Max はホスト型API |
| 精密な動画編集 | 標準 H3 | 標準 H3 の方がより完全な編集エンドポイントを提供 |
| 参照画像、動画、音声による高速生成 | H3 Max reference-to-video | 現在のエンドポイントは稼働中で、参照入力は別途課金 |
インタラクティブなプロトタイプでは、低遅延、十分な明瞭さ、安定したレスポンスが優先されます。一方、広告映像、映画的なショット、ポストプロダクションでは、解像度、編集のしやすさ、複数カットにわたるコントロールがより重要です。チームはまず H3 Max で素早く探索し、確定した少数のショットを標準の H3 や後続の制作フローに任せるという使い分けができます。
価格が、それがどれだけ続けられるかを決める
fal の768p の通常価格は、出力秒あたり0.08ドルです。5秒で0.40ドル、15秒で1.20ドルになります。9月1日時点では、エンドポイントはローンチ記念の半額、秒あたり0.04ドルを表示しており、割引は当日限りと注記されていました。無料枠はログイン状態や出力解像度によって変わるため、利用時はアカウント画面で確認してください。
通常価格で生成し続けた場合、一時間の出力は3600秒となり、モデル費用は約288ドルです。終日止めずに動かすと約6912ドルになります。さらに、失敗時の再試行、参照入力、オーケストレーションサービス、ストリーミング配信のコストが加わります。参照からの動画生成は参照入力トークンで課金され、参照動画によっては入力コストが出力コストを上回る可能性もあります。
継続的な配信には、ユーザーによるトリガー、分岐の事前生成、人気クリップのキャッシュ、低アクティビティ時の頻度低下、失敗時のフォールバックを組み込むことで、計算リソースの投入を実際の視聴やインタラクションにマッチさせることができます。
プロトタイプの構築は、次の五つのステップから始めることができます。
- 5秒、768p、
balancedモードで安定したベースラインを確立する。 - プロンプトに、主体、アクション、カメラワーク、時間的テンポ、音声を同時に明記する。
expanded_promptを保存し、拡張によって元の意図が変わっていないことを確認する。- エンドツーエンドの遅延と
timings.inferenceを同時に記録し、数十回連続で実行してP95を確認する。 - 連続生成のために、少なくとも一クリップ分のバッファを確保し、タイムアウトや失敗時に再生できる代替コンテンツを用意する。
ビデオモデルが「ランタイム」に入る
これまでのビデオモデルは、主に制作サイクルを短縮するものでした。数分後には、広告や一つのショット、コンセプトが納品される。H3 Max は、別の時間スケールを製品設計に持ち込みました。ユーザーが見たり、選んだり、入力したりしている間に、モデルは次のコンテンツを生成し続けることができるのです。
継続的なライブ配信は、最もわかりやすい例に過ぎません。インタラクティブなストーリーは、視聴者の投票に応じて次のシーンを生成できます。ゲームでは、プレイヤーが選択肢を読んでいる間に、三つの分岐を並行して事前生成できます。ECや広告のツールでは、クリエイターが現在のワークフローから離れることなく、連続してショットを試せます。教育コンテンツでは、学習者の回答に応じて次のデモを即座に書き換えられます。
継続的に動くビデオシステムには、ワールドステートの維持、どの情報をプロンプトに入れるかの決定、出力のチェック、音声と映像の同期、予算管理、遅延が急増した時の再生継続も求められます。H3 Max は、その中で最も希少な条件を提供しています。それは、高品質なショート動画の生産速度が、消費速度に近く、一部のリクエストではそれを上回ることです。
この不等式が安定して成り立つとき、AI動画の単位は、生成されたファイルに限定されなくなります。それは、ソフトウェアのランタイムが継続的に呼び出すことのできる、ひとつのメディアになるのです。