コードが汎用インターフェースになるとき:OpenAI社内の「ソフトウェア工場」はどのように稼働しているのか
Codexは仕事の基本単位を1行ごとのコーディングから目標の委譲へと変え、ボトルネックをCI、レビュー、リリース、運用保守へとシフトさせた。本稿では、OpenAIにおける9ステップのソフトウェア工場の証拠、人間の関門、そして自動化の将来方向を解き明かす。
技術ライターの Gergely Orosz が再び OpenAI 本社を訪れたとき、前回の訪問からわずか1年しか経っていなかったが、社内の働き方の土台はすでに様変わりしていた。Codex は「あれば便利」なプログラミングツールから、エンジニアリング、リサーチ、財務、採用、法務、マーケティングの各チームが共通して利用する業務の入り口へと進化した。汎用業務向けの ChatGPT Work もまた、Codex harness という実行フレームワークの上に構築されている。従業員にとって最終成果物がコードであるとは限らないが、Agent が舞台裏でコードを書き、ツールを呼び出し、ドキュメントやスプレッドシートを生成して、目標を納品可能な成果物へと変換していく。
この観察は、7人のインタビュー対象者からもたらされた。アプリケーションインフラストラクチャ担当エンジニアリングVPの Venkat Venkataramani、ChatGPT エンジニアリング責任者の Sulman Choudhry、デスクトップ担当責任者の Andrew Ambrosino、コアAgentチーム責任者の Joe Gershenson、生産性チームエンジニアリング責任者の Akshay Nathan、Codex エンジニアの Ahmed Ibrahim、そして Responses API エンジニアの Steve Coffey である。異なる持ち場の証言がひとつの完全な連鎖を浮かび上がらせる。Agent はまず個人の働き方を変え、続いてコードの生産量を増大させ、最終的にはテスト、レビュー、リリース、そして本番運用の同時再構築を迫るのである。
ここで、明確にしておかなければならない資料の境界がある。元レポートのメタデータでは全文が7,686英単語の有料コンテンツとされているが、現在公開されているページで読めるのは導入部、第1〜3節の全文、および第4節の冒頭1段落のみで、実質約3,536単語、全文の約46%にすぎない。内部ツールとデバッグ、10億人規模のユーザーインフラストラクチャ、APIの信頼性とパフォーマンス、そしてエンジニア職の変化に関する後続の本文は公開されていない。以下では、一項目ずつ検証可能な公開内容のみを解説し、目次の予告に基づいて後半の論拠を補うような再構成は行わない。
プログラミングツールから全社的な業務の入り口へ
転換は急速に起きた。Codex デスクトップアプリは2月にMac版、3月にWindows版がリリースされ、その後7月に Codex harness で駆動する ChatGPT Work が登場した。数カ月のうちに、財務、採用、法務などの非エンジニアリングチームは、Codex をほとんど使わない状態から、大半のメンバーが毎週利用する状態へと移行した。この広がりは、経営陣からの強制によるものではなかった。

図:各部門の平均ユーザーにおける月間出力Tokenのうち、Codexが占める割合。出所:OpenAI / The Pragmatic Engineer。
さらに注目すべきは、当時のプロダクトが決して使いやすいものではなかった点だ。2月から4月にかけての Codex アプリは画面上にコードがそのまま表示され、非技術系ユーザーにとってはかなり不親切だったが、それでも非エンジニアリングチームの導入率は40%近くに達していた。理由は極めて現実的だった。UIが開発ツールのようであっても、リサーチ、プレゼンテーション資料の作成、ドキュメント生成、スプレッドシートの処理といった複雑な業務をすでにこなすことができ、生み出される価値が利用のハードルを補って余りあったからである。
その後、長期タスク機能が利用率を約60%から90%へと押し上げた。ユーザーは /goal を通じて目標を伝えるだけで、Agent に作業を継続させることができ、スレッドが数日間に及ぶこともある。Andrew Ambrosino は直感に反する変化を観察した。Agent が稼働する時間が長くなるほど、人間が同時に複数のタスクを管理するケースがむしろ減ったのである。なぜなら、ひとつの長いスレッドが自律的に他の Agent を派生させ、サブ課題を並行処理するからだ。人間が担当する対象は、数多くの細かな対話から、ごく少数の目標とその検収へと集約されていった。
もうひとつの推進力は、Akshay Nathan が「認知ギャップ」(awareness gap)と呼ぶものだった。モデルの能力は以前から存在していたが、多くの人はその能力がどの業務に適用できるのかを知らなかった。あるタスクに Codex を使った人が、同僚から Slack の監視、Airtable の更新、オンボーディング資料の作成にも使えることを教わる。用途は口コミで広がり、各チームは成熟したワークフローを役割別プラグインやチームプラグインとしてパッケージ化していった。これにより、汎用 Agent は単なる空白の入力欄ではなく、業務のコンテキストと使い慣れたツールを携えて具体的な現場へと入っていった。
こうした適応は、エンジニアリングチームの知識の限界をも浮き彫りにした。開発者は harness の構築方法は知っていても、優れたプレゼンテーション資料、スプレッドシート、事業報告書がどのような水準を満たすべきかまでは必ずしも把握していない。そのため、OpenAI は専門分野のエキスパートを ChatGPT Work のエンジニアリングチームに組み込み、専門職が「良い成果物」のテイストと要件を直接定義できるようにした。ここでのポイントは、モデルがすべての領域で専門家に勝っているということではなく、開発者が自身の経験だけであらゆる専門領域の品質基準を設定することはできないという点にある。
OpenAI 社内の Codex は一般公開版のプロダクトに比べ、より多くの社内システムと接続されている点も、外部との安易なアナロジーを制限している。すでに業務上の依存関係を形成するほど深く統合されており、軽微な障害であっても、同僚から Codex チームや Work チームへ届く連絡が、自動監視アラートと同時、あるいはそれより早く届くことさえある。外部のチームが同名のプロダクトを導入しただけで、自然と同じ効果が得られると思い込むことはできない。
OpenAI が後に公表したデータはこのインタビューを補完するが、統計の定義を正確に捉えておく必要がある:
- 平均的な1人の OpenAI 従業員にとって、Codex は社内AIツールの出力Tokenの85%以上を占めており、全社で毎週生成される出力Tokenのうち、Codex が99.8%を占めている。これは Token のシェアであり、利用者数や労働時間の割合ではない。
- OpenAI のデイリーアクティブユーザーのうち、上位1%(第99パーセンタイル)のヘビーユーザーは、複数の並行 Agent を通じて1日あたり60時間を超える agent-turn 実行時間を生成している。並行実行時間は1日の24時間を超えることがあり、人間が1日に60時間働いたことと同等視することはできない。
- 2026年5月のサンプリング調査(個人ユーザー)では、80.6%がモデル推定で人間の作業30分超に相当するリクエストを少なくとも1回送信しており、70.2%が少なくとも1回は1時間超、25.6%が少なくとも1回は8時間超のリクエストを送信していた。これらの数値は「同等の人間のタスク所要時間」に対するモデルの方向性を示す推計値であり、リクエストが実際に実行された実経過時間(ウォールクロック時間)ではなく、独立して測定された生産性でもない。
これらのデータは、業務が短い一問一答から長期的な委託へと移行していることを証明できても、それ単体でコード品質の向上や人員需要の減少、あるいはどの企業でも同様に進めれば同じ生産性が得られることを証明するものではない。
IDE は消滅せず、仕事の基本単位が先に変わった
Codex デスクトップアプリは、危うくリリースされないところだった。2025年12月の時点で、チームにはすでに Codex CLI があり、市場には十分な機能を備えた IDE も存在していたため、ターミナルと IDE の中間に位置するツールに独自の価値があるかどうかは自明ではなかった。Andrew Ambrosino はこの懸念を iPad に例えた。ユーザーはより携帯性に優れたスマートフォンか、より高性能なノートPCを選び、中間的なデバイスには居場所がなくなるのではないかという懸念だ。
同時に、11月に Antigravity が VS Code のフォークという形で登場したことも、成熟したエディタを踏襲する方向へとチームを誘惑した。しかし、OpenAI は最終的に VS Code をフォークしなかった。彼らが賭けたのは、Agent の能力が向上するにつれて、開発者が IDE を直接操作する頻度が減り、仕事の重心が目標の定義、タスクの委託、成果物の判断へと移行するという未来だった。社内での IDE 利用量が1月から減少したことは、この変化が実際に起きていることを示している。ただし、Codex アプリにも6月にファイル編集機能が追加された。これらの一連の事実は、「IDE が開発の入り口を独占しなくなった」と解釈するのが適切であり、IDE が死んだと宣言するものではない。
真に変わったのは、仕事の基本単位である。かつて開発者は、エディタの中で行単位の修正セットを完結させていた。現在では、人間が結果を指示すれば、Agent がコンテキストを探し出し、複数のファイルを修正し、検証を実行して、その後のフィードバックを処理する。成果物の単位が「コードの一部を修正する」から「ひとつの目標を完遂する」へと拡大したことで、コード生成のスピードは従来の開発インフラの設計容量をはるかに超えることになった。
Venkat Venkataramani によれば、エンジニア1人あたりが作成する PR の数は「ホッケースティック」曲線を描いて急増し、一部のビルド、テスト、デプロイシステムは約6カ月の間に10倍近い負荷にさらされた。他社なら2〜3年かけて経験するような成長を、OpenAI はほぼ毎月のように新たなスケーリングの課題として直面した。バージョン管理はより多くのコードを受け止め、CI/CD はより多くのタスクを実行し、リリースシステムはより高頻度の変更を吸収しなければならない。モデルの能力が一歩前進するたびに、ボトルネックは下流へと移動していった。
従来の PR やコードレビューが時代遅れに感じられ始めたのもこのためだ。すべての変更において人間が1行ずつチェックすることに依存し続ければ、人間の受容スピードが固定の上限となってしまう。しかし、レビューを廃止しても問題は解決せず、リスクを本番環境にそのまま押し付けるだけだ。OpenAI のアプローチは、レビューを専門化された Agent、リスクのトリアージ、明確な人間の関門へと分割し、レビュー能力を変更量に合わせて拡張できるようにすることだった。
一方、ネイティブモバイルアプリは、社内の自動化だけでは直接解消できない別種のボトルネックを示している。iOS と Android のアップデートは依然として Apple や Google のアプリストアによる審査を経る必要があり、数時間から数日かかることが多い。Sulman Choudhry の回想によれば、Facebook は2010年代にモバイルのリリース頻度を月1回から隔週、そして週1回へと引き上げ、同時に実験システムと Feature Flag に頼ることで、コードをまずバージョンとともにクライアントに配信し、機能の有効化はリモートで決定していた。これは当時、モバイルチームのスピードを大幅に向上させたが、今日のように数分で生成されるソフトウェア変更の前では依然として遅く感じられる。OpenAI の Codex 利用はモバイル向けに大きく偏っているが、ネイティブアプリのリリースの速さは、ウェブのデプロイ速度には遠く及ばない。
この事例は、ソフトウェア工場の真の制約を浮き彫りにしている。Agent は社内の生産時間を短縮できても、ストアの審査、コンプライアンス要件、本番リスクを魔法のように消し去ることはできない。生成が高速化された後には、それまで目立たなかった外部の待機時間が、デリバリーサイクルを左右する新たな主たるボトルネックとなるのだ。
9ステップの完結ループ:コード生成は中間の1コマにすぎない
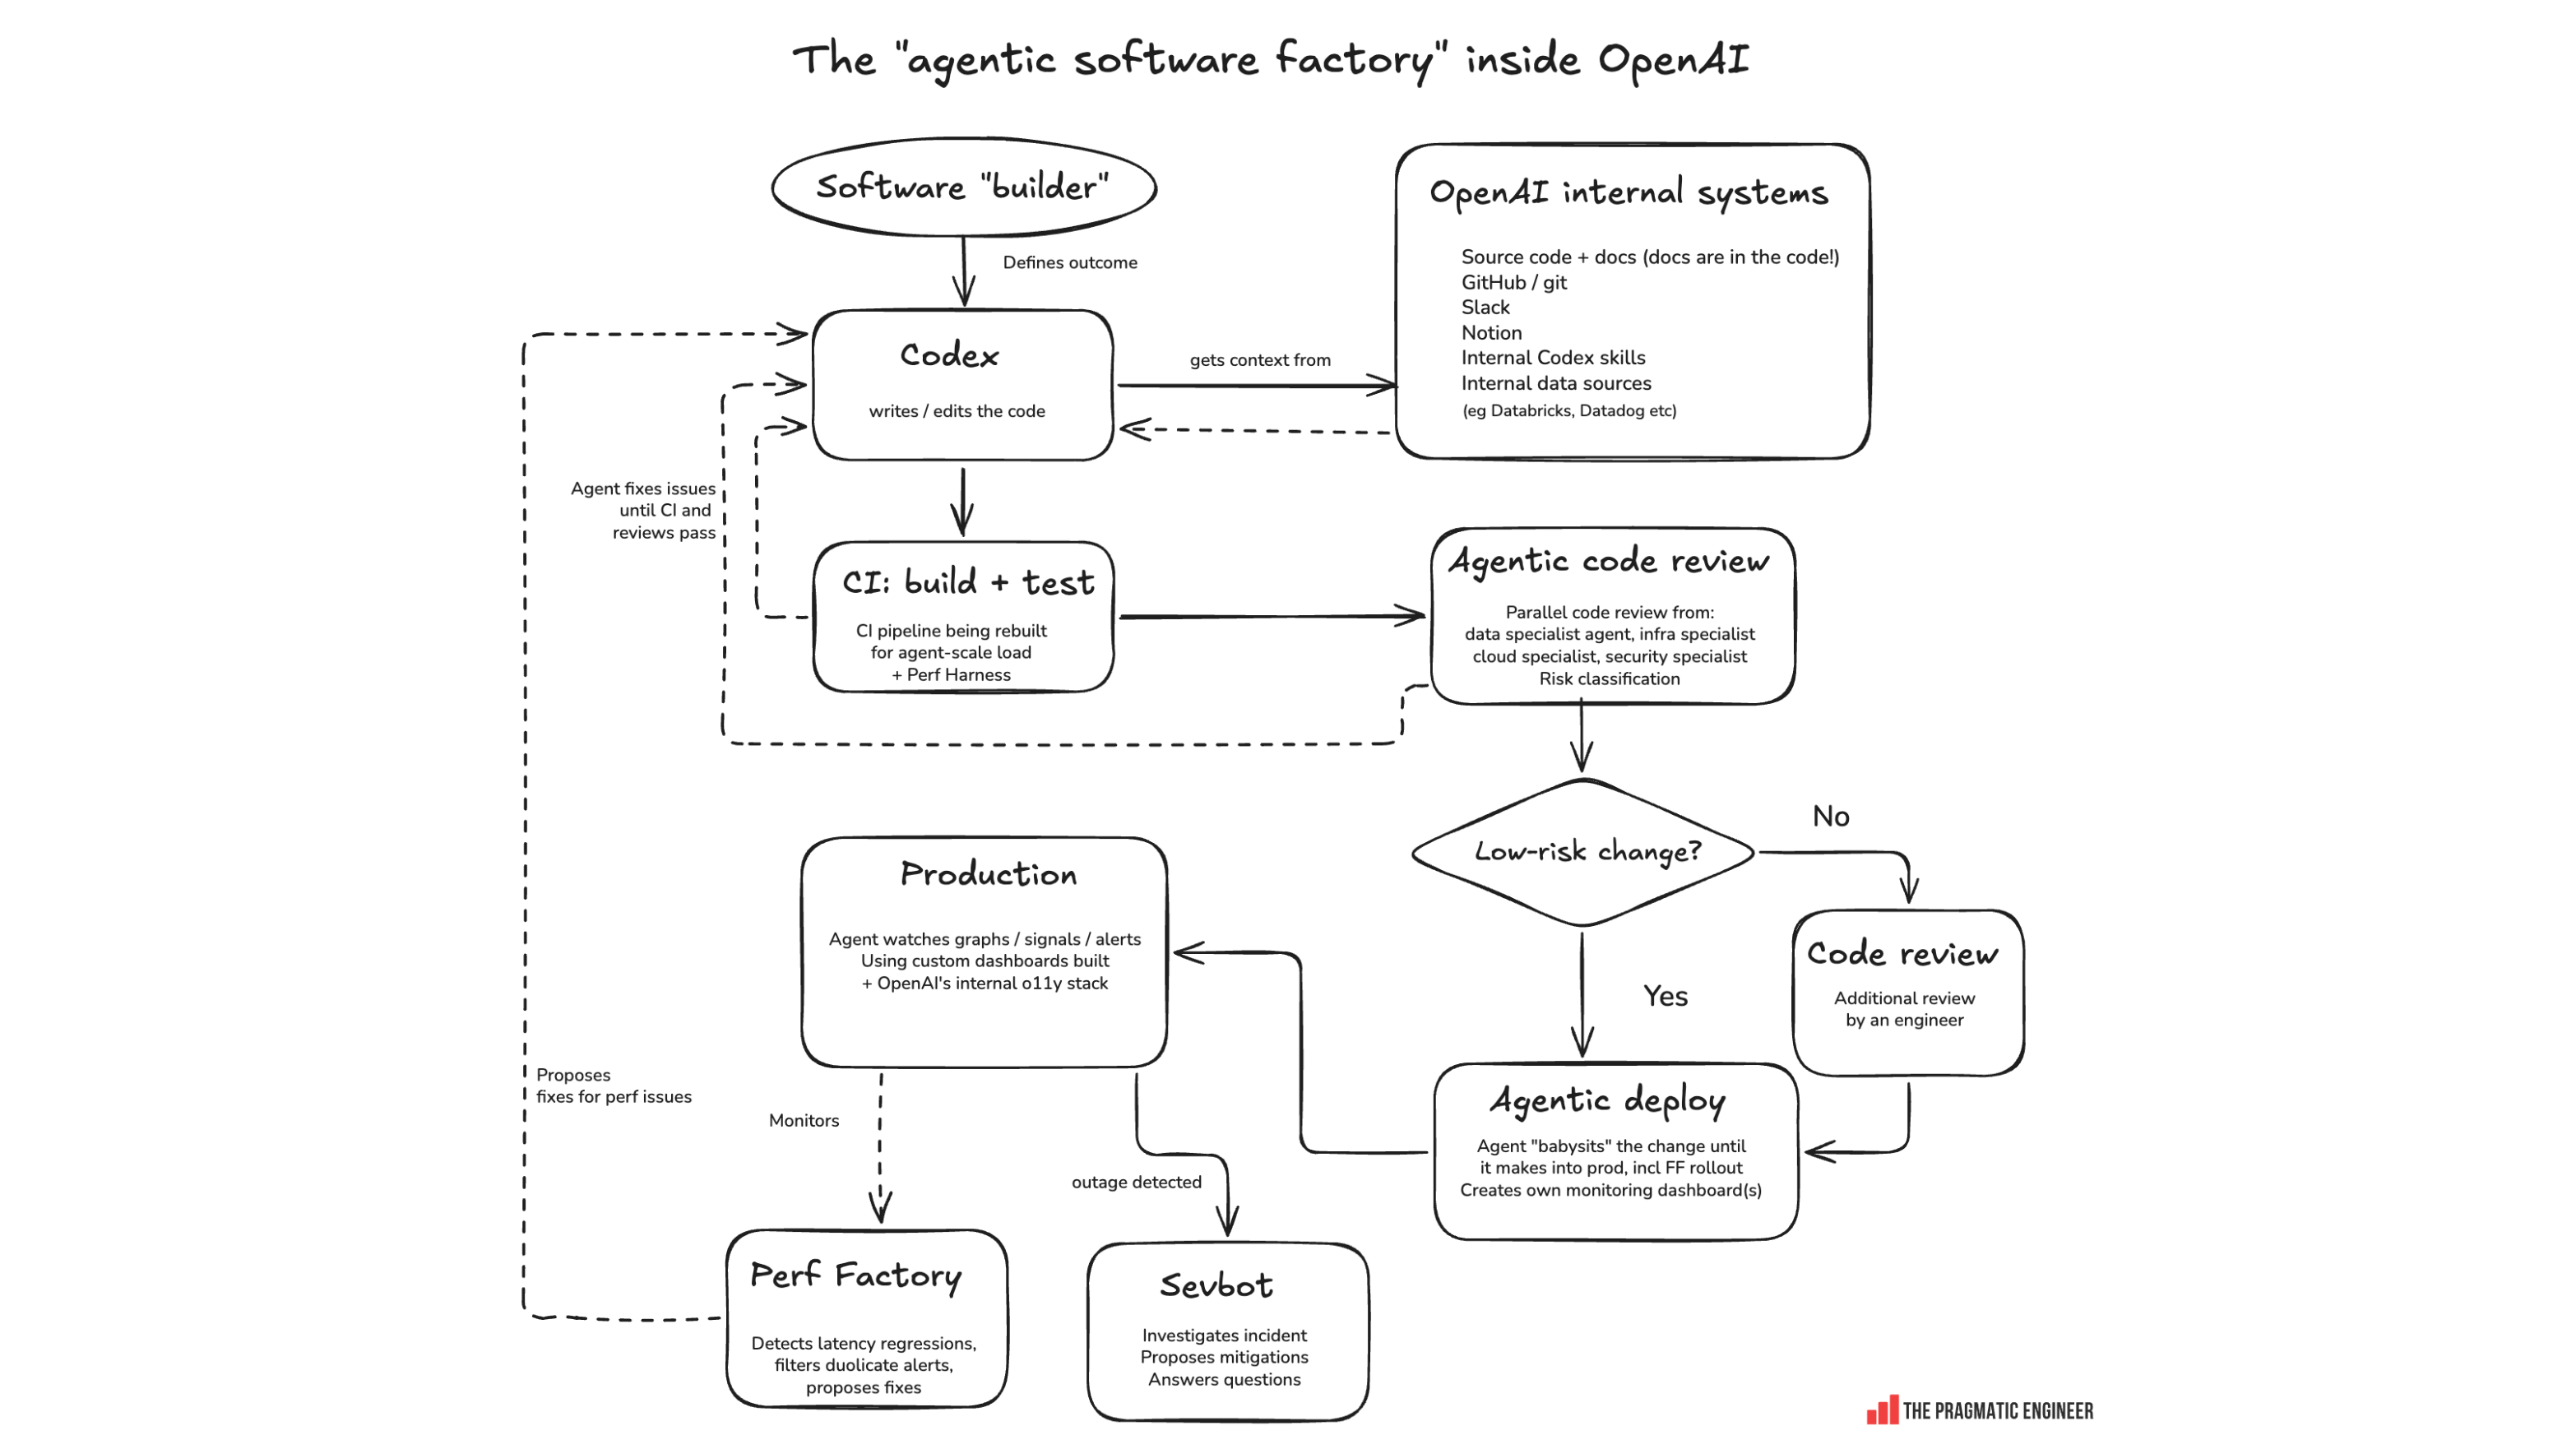
「ソフトウェア工場」という言葉は、製造業のアナロジーを借用している。人間とロボットが協力して自動車を製造するように、ソフトウェアの世界では人間と Agent が共同でシステムを開発、リリース、保守する。製造業には照明すら必要としない「ダークファクトリー(消灯工場)」も存在するが、OpenAI の現在のプロセスはまだ無人システムではない。人間が目標を定義し、本番リリースを承認する。障害対応 Agent も現時点では軽減策を提案するにとどまり、エンジニアが明示的に承認しない限り実行することはない。

図:人間が目標を定義した後、Codex とコンテキスト、CI、レビュー、リリース、本番観測、Perf Factory、Sevbot がフィードバックループを形成する。出所:The Pragmatic Engineer。
完全なプロセスは、相互にフィードバックし合う9つのステップから構成されている:
- 人間が結果を定義する。 ソフトウェアエンジニアまたはプロダクトマネージャーが、まず課題と期待する結果を説明する。Venkat の観察によれば、エンジニアはプロダクトマネージャーに近づきつつあるという。コーディングが大量に委託されるようになったことで、判断力、優先順位付け、テイストがより重要度を増している。Agent は実行力を拡大できても、何を作る価値があるのか、どのような結果が許容できるのかを組織に代わって決めることはできない。
- Codex がコンテキストを集約する。 OpenAI はドキュメントをソースコードのリポジトリ内に移し、コードと説明が足並みを揃えて進化しやすくした。Codex は Git リポジトリや GitHub、Slack、Notion、Databricks、Datadog、社内ログ、チームスキルにもアクセスできる。一部の社内スキルに至っては Codex 自身によって保守されている。統合が極めて深いため、新入社員はシステムの質問を直接 Codex に尋ねるよう推奨される。
- Agent が変更を実装・検証する。 Codex は目標に基づき、要件を満たすまでコードを修正し続け、ソフトウェアの振る舞いを検証する。公開資料には特定のサンドボックスを使用することが明記されておらず、検証がローカル環境のみで行われるとも限定されていないため、非公開の実行環境を確定した事実として扱うことはできない。
- ビルド、テスト、そして CI の通過を待つ。 Agent はコードをビルドし、テストを実行し、失敗結果に基づいて実装を修正した後、PR を作成して、より包括的なリンターやテストスイートをトリガーする。Agent は PR を継続的に監視し、CI の失敗に対応して変更を更新する。追加のパフォーマンス harness は、問題がある可能性があると判定された PR のみを Synthetics A/B フレームワークに送り、パフォーマンスへの影響を評価する。すべての PR が高コストな同一のパフォーマンステストを受けるわけではない。
- 専門レビュー、リスクのトリアージ、コンプライアンスのルーティング。 システムは単一の汎用コードレビュアーを呼び出すのではなく、ドメイン設定を持つ複数のレビュー Agent を派生させる。Gergely は当初これに懐疑的だった。プロンプト内でモデルに「クラウドインフラの専門家になりきれ」と指示するだけでは、専門的な判断力は自動的にもたらされないからだ。このアプローチが機能し得るのは、Agent が関連するコードやドキュメントにアクセスでき、限られたコンテキストを狭い領域に集中させられるからである。低リスクの PR は、該当するコード領域で明示的に opt-in された場合にのみ、Agent によって自動承認される可能性がある。高リスクの変更には、さらなる AI レビューを追加するか、人間のレビューを義務付けることができる。システムはリスクに応じて、追加の自動コンプライアンスチェックや人間のコンプライアンス意見がいつ必要かを自動判断することもできる。コーディング Agent はレビューコメントを追跡し続け、問題を修正する。
- Agent によるリリースの護送。 人間が変更の本番適用を承認して初めて、システムはその変更にリリース Agent を割り当てる。Agent は Feature Flag を特定し、変更内容を理解し、どのシグナルが成功または失敗を表すかを判断して、その変更専用の監視ダッシュボードを生成し、リリースの状態を継続的に観察する。OpenAI の長期目標は、「変更ごとに1つの自律 SRE」に近い能力を確立することである。これは方向性であり、現時点で完全に自律リリースが実現されているという事実ではない。
- 変更粒度での本番観測。 観測ソースには、前ステップで生成されたダッシュボードに加え、ログ、メトリクス、トレース、wide events を生成する OpenAI 社内のオブザーバビリティシステムが含まれる。かつてはエンジニアがサービス単位でダッシュボードを構築していたが、現在では Agent が単一の変更に対して観測ビューを生成できるため、「今回の変更が正常かどうか」を独立して追跡可能な問題へと変えた。
- 本番シグナルの開発へのフィードバック。 Perf Factory はアラートやダッシュボードからシグナルを抽出・重複排除し、真のレイテンシ劣化を特定して根本原因を突き止め、修正案を提示する。レポートの導入部では、パフォーマンス問題に対処するために Codex Agent を起動できるとも要約されているが、公開されているプロセスの説明で裏付けられているのは修正案を提示することまでであり、パッチがレビューを回避して自動的にマージまたはデプロイされると推測することはできない。
- Sevbot によるインシデント対応支援。 インシデント発生時、Sevbot はコンテキストを収集し、考えられる軽減策を判断し、Slack チャンネルで開発者の質問に回答する。現時点では自律的に軽減措置を実行することはなく、エンジニアが特定の対策を指定した上で実行を指示する。OpenAI は将来、Sevbot が一部の定常的インシデントを自律処理し、人間が時間外に起こされることなく後からそのアクションをレビューできるようにすることを目指しているが、現段階では依然として on-call が存在する。
責任境界クイックリファレンス
9つのステップで、誰が実行し、誰が見守るのか?
絞り込みは関連するステップを強調表示するのみで、他のステップは非表示になりません。3つの責任区分を常に対照して確認できます。
-
01
結果の定義人間が課題、優先順位、検収基準を決定人間の意思決定
-
02
コンテキストの集約コード、ドキュメント、協業履歴、本番データを読み取りAgent実行
-
03
変更の実装コードを修正しソフトウェアの振る舞いを検証Agent実行
-
04
テストとCI失敗を修正。問題の疑いがあるPRは性能評価へ自動フィードバック
-
05
レビューとトリアージ専門Agentが先行レビュー。高リスク変更は人間による再確認を義務付けAgent実行人間の関門
-
06
リリースの護送人間の承認後にAgentが変更を監視。目標は変更単位の自律SRE人間の承認自律性の拡張
-
07
本番観測単一の変更ごとにダッシュボードを生成し本番シグナルと連携Agent実行
-
08
性能フィードバックシグナルの重複排除、劣化の特定、修正案の提示Agent実行
-
09
インシデント対応現在は人間が軽減アクションを指定。目標は一部の定常的インシデントの自律処理人間の承認限定的な自治
現在表示中:全9ステップ。
これら9つのステップを結びつけて見ると、工場の核心は「1つのモデルがすべてのコードを書き上げる」ことではなく、3つの能力が互いを制約し合っている点にある。すなわち、マシンによる高頻度の実行と継続的な観察、自動化システムによる検証可能なフィードバック、そして目標、リスク、本番アクションに対する人間の責任である。どの層が欠けても、コードのスループット向上は、待機時間、ノイズ、またはインシデントをより速く生み出すだけに終わりかねない。
現在の人間の関門と、将来の自動化の方向性
現在の事実から見れば、人間は依然として3つの重要ノードを押さえている。冒頭での課題と期待する結果の決定、コードが本番に入る前の承認、そして Sevbot が具体的な軽減策を実行する際の明確な指示である。リスクの高いコードは、人間のレビューへの提出が義務付けられることもある。OpenAI の現状を、人間が一切関与しない「消灯ソフトウェア工場」と表現するのは正確ではない。
しかし、これは境界が恒久的にここに留まることを意味しない。OpenAI はリリース Agent に変更レベルのより包括的な SRE の責務を担わせることを模索しており、最終的には Sevbot が一部の定常的なインシデントを自律的に処置できるようにすることも目指している。真の進化プロセスは、十分に信頼できるコンテキスト、リスク分類、テスト、本番シグナルをまず確立し、その上で自律実行可能な範囲を徐々に拡大していくことだ。現在の状態と長期目標の双方が保たれなければならず、ビジョンをすでに実現された能力と誤認しても、今日の人間の関門が決して動かないものと決めつけてもならない。
他のチームが真に学べることは何か
OpenAI の実践は、滅多にない恵まれた前提条件の上に成り立っている。ドキュメントとコードが同一リポジトリにあること、Agent が GitHub、Slack、Notion、Databricks、Datadog、ログ、社内スキルを読み取れること、ビルド、テスト、CI、本番観測が迅速なフィードバックを返せること、コード変更にリスク分類とコンプライアンスのルーティングが備わっていること、そして会社が潤沢な Token と計算リソースの予算を提供できることだ。公開資料に示されているのは OpenAI 社内でのインタビューによる観察と公式の統計であり、この手法が普遍的に安全であると実証されたわけでも、すべての企業がそのまま模倣するのに適していると証明されたわけでもない。
より移植性の高い順序は、コード生成量を増やす前に、まずシステムをマシンが理解可能にし、テストで検証可能にし、本番シグナルで制約できるようにすることである:
- 実装に真の影響を与えるドキュメントをコードの近くに配置し、コードとともに更新する責任体制を築く。
- Agent がタスクを完遂するために必要なコンテキストを獲得できるようにしつつ、読み書き権限、監査、本番アクションの境界を明確にする。
- テスト、CI、パフォーマンス評価、本番観測によって短いフィードバックループを構築し、エラーをできるだけ早い段階で表面化させる。
- すべてのコードに画一的なフローを適用するのではなく、変更のリスクに応じて必要な Agent レビュー、コンプライアンスのインプット、人間の承認の度合いを決める。
- 生成スピードをさらに引き上げる前に、下流のビルド、レビュー、リリース、運用保守がどれだけのスループットに耐えられるかをまず測定する。
このソフトウェア工場がもたらす最大の教訓は、コードがもはや唯一の希少資源ではないということだ。Agent が実装コストを劇的に引き下げたとき、希少性は質の高いコンテキスト、実行可能な判断力、検証能力、そしてリスクの引き受けへとシフトする。エンジニアリング組織が作り変えるべきなのは、ひとつのエディタの入り口ではなく、目標から本番フィードバックに至るまでの連鎖全体なのである。