Ploy 社が本番環境 AI を Opus 4.8 から GPT-5.6 Sol に切り替え:品質を落とさずに所要時間を半分以下に短縮、コストは27%削減
- Ploy は自社サイト構築 AI agent のデフォルトモデルを Claude Opus 4.8 から、その日リリースされたばかりの GPT-5.6 Sol に切り替えた
- 自社評価では:同種のサイト構築タスクを完了する所要時間が8分00秒から3分42秒に短縮、コストは3.06ドルから2.22ドルに低下、視覚評価スコアは0.936から0.970に上昇
- 移行の過程で、GPT-5.6 がツール呼び出しの中で不要なパラメータにまで既定値をでっち上げる(例:
offset: 0)ことが判明し、一時は52%から64%のファイル読み込みが気づかぬうちに空の内容を返していた - OpenAI の prompt キャッシュの仕組みは Anthropic とはまったく別物で、workspace 単位の cache key に切り替えてキャッシュ階層を設計し直した結果、初回呼び出しのキャッシュヒット率が0%から83.7%に上昇した
- チームはさらに、自社の評価フレームワーク自体が使い慣れた旧モデルを暗黙に優遇していたことにも気づき、評価結果を信用する前にまず評価フレームワークを修正する必要があった
Ploy がデフォルトモデルを GPT-5.6 Sol に切り替えた
AI サイト構築プロダクト Ploy は 2026年7月9日、自社 agent のデフォルトモデルを Claude Opus 4.8 から、OpenAI がその日発表した GPT-5.6 Sol に切り替えた。
モデルを切り替えるという行為は、単に API エンドポイントを差し替えるよりもはるかに複雑だ。Ploy の agent はページを設計し、コードベースを読み、コンポーネントを書き、画像を生成し、自分の成果をスクリーンショットで確認し、最後に本当に完成したかどうかを判断する。この一連の流れを Claude から GPT-5.6 に移す中で、チームは評価の失敗を一つまた一つと重ねながら気づいていった――「モデル」だと思っていたものは実は各社サービスごとの挙動の癖であり、技術スタック全体がいつの間にか旧モデルに合わせた特定の形に育っていたのだ、と。

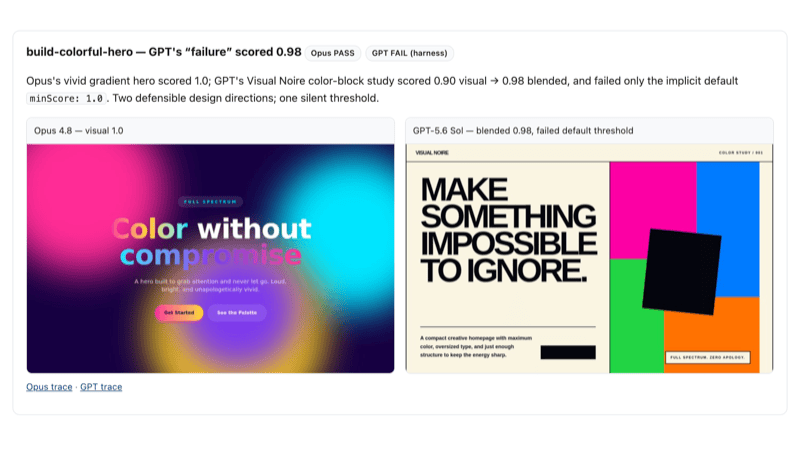
以下は、そのブランドページ再構築評価スイートから取ったサンプルの一組で、agent は参考デザインを見ながらブランドのホームページを作り直す。
| 1回のサイト構築あたり平均 | Claude Opus 4.8(n=11) | GPT-5.6(n=10) |
|---|---|---|
| コスト | $3.06 | $2.22 |
| 所要時間 | 8分00秒 | 3分42秒 |
| 入力トークン | 2.60M | 1.70M |
| 出力トークン | 33.0K | 17.1K |
| 視覚評価スコア | 0.936 | 0.970 |
GPT-5.6 が書くコードはより無駄がない。ある比較サンプルでは、Opus が生成した globals.css は17,957文字、CSS変数174個(色階のかなりの部分は使われていない)だったのに対し、GPT-5.6 はわずか2,508文字、変数45個で、同等(時にはより良い)ページをレンダリングした。


まず評価フレームワークが公平かを見て、それからモデルの強さを見る
2つのモデルのスコアを単純比較する前に、まず問うべきことがある――評価フレームワーク自体は公平なのか。Ploy は同一の評価スイートを2つのモデルファミリーにまたがって走らせ、最も意外だった発見は、評価フレームワークがすでに旧モデル向けに調整されていたのに、チーム自身がそれに気づいていなかったことだった。
初めて異なるモデル間で走らせたとき、具体的には次の点に偏りが見つかった。
- ツール呼び出しの予算は Opus の逐次呼び出しスタイルに合わせて設定されていた。GPT-5.6 は多数の呼び出しを並列に展開するため、実際には正解している問題でも予算を使い切ってしまう。
- 評価エグゼキューターがバッチファイル読み込みに対応しておらず、この手法は Opus はほとんど使わないが GPT-5.6 は常用していた。
- あるデータセットで
minScoreの閾値記入が漏れており、既定値の1.0を暗黙に継承していた。その結果、0.98点を取った GPT-5.6 の hero が「不合格」と判定される一方、個別チェックすべて通過した Opus の問題も「失敗」扱いになった。どちらも成立するデザインの方向性だったが、見えない閾値がそれを阻んでいた。
この回の元の失敗を掘り下げると、およそ3分の1は実は評価フレームワーク側の前提が原因であり、モデルの挙動とは無関係だった。しかも2つのモデルが踏んだ数もそれぞれ違っていた。

結論はシンプルだ。挑戦者モデルを評価する際は、まず一件ずつトレースを見てから通過率を信じること。さもないと、新モデルを「どれだけ旧モデルに似ているか」で採点していることになる。
デザインスタイル:クリーンで見栄えは良いが、画一化しやすい
GPT-5.6 のデザイン能力に対する Ploy の全体的な判断はこうだ――クリーンでモダン、グリッドがきっちり整ったレイアウトが得意だが、うまく誘導されないと、その方向に一直線に収束していく。Opus 4.8 向けに設計された旧評価フレームワークの下では、GPT-5.6 は既存のデザインシステムを無視しがちで、洗練され抑制の効いた、しかし一目で汎用的だとわかるページを作りがちだった。

どうやってそれを世界トップクラスのブランド再現度へと誘導するかは、別記事の範囲だ。ここでは実際にある能力の特徴として記録するにとどめる。落とし穴というほどのものではない。
モデルは使わないパラメータにまで偽の値を作ってしまう
Ploy の code ツールにはトップレベルのパラメータが25個あり、必須なのは action だけで、残りはすべて任意だ。Claude は必要な2、3個だけを送り、それ以外は省略する。GPT-5.6 は毎回25個すべてを埋めてしまい、使わないものにはそれらしく見える値をでっち上げる――offset には0、timeout には120000、siteId にはすべて0で埋まった UUID を入れる、といった具合だ。
肝心なのは、でっち上げられた値と本物の値がインターフェースのレベルではまったく見分けがつかないことだ。offset: 0 は一見普通のパラメータに見えるため、Ploy のファイル読み込み実装はそのまま真に受けてしまい、GPT-5.6 は52%から64%のファイル読み込みが気づかぬうちに空の内容を返すことになった。しかもツールはどちらの場合も success: true を返すため、モデルは自分が空ファイルを読んでいることにまったく気づかず、黙って作業の質を落としながら、呼び出しだけがどんどん積み重なっていく。
3日間の本番トラフィックで、code(read) 呼び出しのうち25個のパラメータすべてを携えている割合を見ると、同じ事象とは思えないほどの差があった。
絶対数に換算すると:GPT-5.6 の6,635回の呼び出しは6,635回すべてがフル装備、Opus 4.8 の2,898回のうちわずか4回のみ、Sonnet 5 は1,933回のうち1回もなかった。
プロンプトではこれは治せない。Ploy は「説得」できそうな道をひと通り試したが、すべてそのまま失敗に終わった。
それでも25個すべてを埋める。
それでも25個すべてを埋める。
strict モードを有効にする挙動はまったく同じ(Ploy 実測)。しかもこれを使うには、各 schema から pattern、format、配列の境界検証を削除しなければならず、代償の方が大きい。
これはモデルが関数呼び出しを生成する方式に組み込まれた根本的な挙動であり、指示で説得できるものではない。回避策を設計するしかない。
本当に効いた修正方法は、provider の境界で一度 schema 変換を行うことだった。OpenAI 系のモデルに対してだけ、任意のプロパティをすべて「必須だが null を許容する」(anyOf: [T, null] を使う)形に書き換える。こうすればモデルは「これは使いません」とはっきり表明できる正式な手段を手に入れる。そして、すべてのツール呼び出しが必ず通過する関門で、その null を剥がしてしまえばよい。ツール側のコードは1行も変更する必要がない。まとめると、モデルが目にするのは正直さを表現できる schema であり、ツールが受け取るのは相変わらずこれまでと同じ入力だ。
// Before: 25 keys, every one carrying an invented value
{ "action": "read", "file_paths": [...], "offset": 0, "timeout": 120000, ... }

// After: 25 keys, 4 real values, 21 explicit nulls (stripped before the tool runs)
{ "action": "read", "file_paths": [...], "offset": null, "timeout": null, ... }
両社の prompt キャッシュはそもそも根本的に別物の設計だ
表面上はどちらも prompt キャッシュと呼ばれているが、「キャッシュ」という言葉の下にはまったく異なる2つのアーキテクチャが隠れている。移行の中で最も慎重に扱うべきだったのはまさにこの点だ。正しく移行する前は、GPT-5.6 は Opus よりも約50%割高に見えていたが、その割高分は Ploy 自身のキャッシュ設定に起因するもので、モデルの価格設定とは関係がなかった。
Ploy の prompt の冒頭には約29Kトークンの静的プレフィックス(ツール schema とコアシステムプロンプト)があり、どの会話でもまったく同じものだ。この部分をどうキャッシュするか、両社では大きく違っていた。
cache_control でブレークポイントを付け、その29Kの静的プレフィックスは組織全体で共有される。どの会話、どのワークスペースでも同じ1つを使い回せ、1分あたりどれだけリクエストを捌けるかを気にする必要もない。ヒット率は92%から96%で安定しており、キャッシュはほぼ意識せずに済む。OpenAI が用意している正式な仕組みは明示的なものだ――prompt_cache_breakpoint でマークし、必須の prompt_cache_key を合わせて指定する。そしてこの key こそが設計を本当に分岐させる場所であり、これがキャッシュの識別子の一部だからだ。prompt がまったく同じでも key が違えば、ヒット率は0になる。key ごとに1つのキャッシュノードが対応し、そのノードは1分あたりおよそ15リクエストしか捌けず、それを超えると OpenAI は別の未ウォームなキャッシュノードにトラフィックを振り分けてしまう。
prompt_cache_key は図書館の指定席札のようなものだ。同じ札を持つ人は同じエリアに案内され、次に来たときも続きから使える。key が同じなら同じキャッシュエントリを共有できるが、key が変われば別のエリアに移ったのと同じで、それまで保存されていたキャッシュは一つも使えなくなる。
そのため「キャッシュを使うかどうか」は実質的な設計判断になる――この key をどの階層に紐づけるか、という判断だ。3通りの紐づけ方には、それぞれ違う末路が待っている。
新しい会話は永遠に共有プレフィックスに当たらず、初回呼び出しのヒット率は0%になる(Ploy が実際に踏んだ落とし穴で、代償はかなり大きかった)。
すべてのリクエストが同じキャッシュノードにハッシュされ、本番トラフィックが1分あたり15回という予算を直接押し潰してしまい、リクエストはキャッシュのない未ウォームなノードへ振り分けられ、結局またヒットしない状態に戻る。
同一顧客のワークスペース内のすべての会話がキャッシュエントリを共有でき、1つの key にかかるトラフィック圧力を低く保てる。
Ploy が最終的に本番投入したのは workspace 単位の key で、リクエストはハッシュによってスループットの限られたキャッシュノードに振り分けられる。これは各顧客ワークスペースに専用レーンを1本ずつ割り当てるようなものだ。
key だけでは不十分で、Ploy はさらにシステムプロンプトを3層のブレークポイントに分割し、各層に1つの役割だけを持たせ、Anthropic 向けに使っている構造と揃えた。
この改修が終わると、GPT-5.6 の評価スイートあたりのコストは Opus を下回るところまで落ちた。それまでチームが注視していた価格差は、そのすべてがキャッシュ設定の誤りによるもので、モデルの価格設定とは関係がなかった。
もう一つ、避けられない構造的な制約がある:OpenAI 上では、その静的プレフィックスをワークスペースをまたいで共有することは構造上できない。Anthropic で共有できるのは、そのキャッシュが組織単位で区切られており、key 単位で区分されていないからだ。GPT-5.6 上では、各ワークスペースのキャッシュがいったんアイドル状態で期限切れになると、次の呼び出しでは29Kの冷たい書き込みを約0.18ドルで払い直すことになる。これは実質的なコストだが、上限があり予測可能だ。
前ターンの推論記録が突然取り出せなくなる問題は、スイッチ1つで解決する
最後の落とし穴は最も短いが、会話を実際に壊してしまうものだ。GPT-5.6 の Responses API はデフォルトで、前ターンの推論プロセスを「サーバー側 item 参照」として保存する――サーバーが番号を記録し、次のターンは直接その番号を問い合わせる。Ploy の会話は、途中で断続的にエラーを出すようになった:Item 'rs_...' not found。
サーバー側のポインタは、荷物そのものではなく引換券を渡されているようなものだ。引換券が失効すれば、荷物を取り出せなくなる。store: false は荷物そのものを直接手渡すのと同じで、引換券が失効する心配がもうなくなる。
rs_...)として保存され、次のターンは直接その番号を問い合わせる。番号がいったん失効すると Item 'rs_...' not found というエラーになる。store: false — 让 SDK 改为请求「加密推理内容」,把推理重放做成自包含的数据块, 而不是指向服务器状态的指针引用;否则中途可能报错 Item 'rs_...' not found
さらに Ploy が丸一日調査に費やしたことがもう一つある:一度サーバー側の推論状態が回路に組み込まれると、たとえ自分が送信したバイト列が厳密に末尾追加のみで一つも変更していなくても、上流の有効な prompt が変わってしまう場合があるのだ。
移行が完了して――最終成績表と、同種のチームへ向けたチェックリスト
4つの落とし穴を一つずつ埋めていった結果、冒頭で示した数字はすべて実現した。所要時間は約2.2倍速くなり、コストは27%下がり、視覚評価スコアは横ばいからやや上昇。キャッシュを再構築した後は初回ヒット率が0%から83.7%まで上がり、ヒットしなかった入力トークンは28%減少、評価スイートあたりのコストは Opus を下回る水準まで落ちた。schema を改修した後は空ファイル読み込みがゼロになり、ツール呼び出しは約30%減った。
この4つのステップには順序があり、まずフレームワークを直さない限り、それ以降のどの数字も信用できない。
minScore の既定値1.0のような見えない閾値も潜んでいた。最初のラウンドの失敗の約3分の1は、実はフレームワーク側の責任であって、モデルのせいではなかった。anyOf: [T, null] に書き換え、実行前に null を剥がす。prompt_cache_breakpoint と prompt_cache_key が必要で、key は workspace 単位で紐づけ、system prompt を A / B / C の3層に分割する。初回ヒット率は0% → 83.7%に。store: false を追加し、サーバー側ポインタを暗号化された自己完結型データブロックに置き換え、Item 'rs_...' not found エラーを解消する。もしあなたが2つのモデルのコストを比べていて、片方のキャッシュがまだ冷たいままなら、あなたが比べているのは自分の設定であって、モデルとは関係ない。Ploy 公式エンジニアリングブログ
AIの頭脳を入れ替える難しさは、新しいインターフェースを繋ぐことではなく → ツールのパラメータ・キャッシュ・推論記録に散らばる差異を一つずつ繋ぎ直すことにある
AIサイト構築プロダクトPloyは、agentのデフォルトモデルをClaudeからGPT-5.6に切り替えた。速く、安くなったが、移行の道中には見えない4つの落とし穴があった。一枚の図で丸ごと説明する。
↓ 一枚で読み切り · 動く図が1つあります
Ployは AI サイト構築プロダクトで、サイトが欲しいと言えば、自分で動くAIプログラムであるagentを1体派遣し、ページを設計し、コードを書き、配図を生成し、さらに自分でスクリーンショットを撮って出来上がったか確認までしてくれる。2026年7月9日、このagentのデフォルトの「頭脳」を、Claude Opus 4.8から、OpenAIがその日発表したGPT-5.6 Solに切り替えた。
同じagent、同じ開発ツール一式のまま、デフォルトの頭脳だけを入れ替えた。Ploy自社の評価では、agentに参考デザインどおりブランドのホームページを再構築させたところ、平均して次のようになった。
コスト $3.06
ビジュアルスコア 0.936
(満点1.0、参考デザインに近いほど高い)
コスト $2.22(27%節約)
ビジュアルスコア 0.970
同じ作業を、半分以上の時間で済ませられる
チームはさらに、GPT-5.6にはある癖があることに気づいた。特に誘導しないと、デザインがきれいだが没個性になりがちで、既存のブランドスタイルを見落としやすい(これは能力上の特徴で、本文で詳しく展開する)。だが本当に結果を狂わせるのは、他の見えない4つの落とし穴のほうだ。最も陰湿な一つは、こっそり空のファイルを読んでおきながら、自分では成功したと思い込んでしまうことだ。
GPT-5.6にはある癖があり、ツールを呼び出すたびに、全パラメータ欄を埋め尽くそうとし、使わない項目にはそれっぽい値をでっち上げる。厄介なのは、でっち上げた値と本物の値が、インターフェース上ではまったく見分けがつかないことだ。
「約2.2倍速い」を同じサイト構築タスクに置き換えて、実際どれくらい待つのか換算してみる。
Claudeと交代
何度も読み直すしかない
やはり25項目全部埋まる
モデルは素直にnullを埋め、実行前に取り除く。
この4つを一つずつ繋ぎ直す必要がある:
- × 評価フレームワークが旧モデルにこっそり有利
- × ツールパラメータの埋め方
- × 重複コンテンツの節約計算
- × 前の思考ログの保存方法
→③キャッシュ再構築→④推論ログに文脈を持たせる
あちこちに隠れた旧来のクセを一つずつ繋ぎ直すことだ。