
OpenAI が API設定を2つオンにしただけ、GPT-5.6 Sol の ARC-AGI-3 スコアが 13.3% から 38.3% へ
- OpenAI が自社モデルの「大失敗」を振り返った:同じ GPT-5.6 Sol、同じ評価問題で、API設定を2つオンにしただけ。ARC-AGI-3 公開セットのスコアが 13.3% から 38.3% へ上がった。
- 原因はモデルではなく、それを動かすプログラム(業界ではハーネスと呼ぶ)側。1手ごとに、自分向けに書いたプライベート推論が丸ごと捨てられ、次の手はゲーム理解をゼロからやり直しになる。
- もう一つは、文脈が満杯になると最も古いメッセージを消すこと。過去に押したキーの記録まで押し出され、モデルに「過去」が残らない。
- 直し方はスイッチ2つ:Responses API で前回レスポンスの ID を返すと推論が自動で残り、コンパクションを有効にすれば閾値で要約へ圧縮して継続し、先頭は消さない。
- 削減の方がスコアより目立つ:最高レベルで1試合の出力トークンが 290 万から 49 万へ。新プログラムは「高」レベルだけで、旧プログラムが「最高」レベルまで上げたのと同じスコアに届き、トークン差は約12倍。
- ARC 自身の5月の分析は別の説明で、世界モデルが作れない3つの失敗パターン。ARC Prize が独立検証したのは旧プログラム下の 13.33%(公開セット)と 7.78%(半プライベートセット)だけだ。
同じモデル、同じ問題でスコアが約3倍
OpenAI が、かなり具体的な失敗の振り返りを公開した。同じ GPT-5.6 Sol、同じ評価問題で、API設定を2つオンにしただけ。スコアは 13.3% から 38.3% へ、1試合の出力トークンは約6分の1まで落ちた。API で多ステップの仕事を走らせているなら、この2つのオン/オフが成績と請求を直接決める。
要するに、モデルのスコアが低いとまず「能力不足」と思うが、今回の答えは「モデルを動かすプログラムが記憶を切っていた」だ。そのプログラムを業界ではハーネスと呼ぶ。OpenAI は説明書なしの謎解き評価 ARC-AGI-3 で実験し、推論強度の5レベルをそれぞれ走らせた。
「大失敗」と言うのは、Sol が他の場ではこんな様子ではないからだ。グラフ理論で数十年未解決だった循環二重被覆予想を解いたり、画面だけ見て情報なしで『ポケットモンスター ファイアレッド』(Pokémon FireRed)をクリアしたり、Codex で『Slay the Spire』をクリアし、Baba Is You の序盤もこなしている。ウォートンの Ethan Mollick が公開した記録では、Codex 上で『Slay the Spire 2』のデイリーランダム挑戦に勝っている。このゲームは Sol の知識カットオフ後に発売された。

これだけ遊べるのに、25 試合の 2D 謎解きミニゲームでは1割強しか取れない。下の左右比較映像は同じゲーム(番号 cd82)、同じ Sol。左が公式プログラム、右が OpenAI が Responses API で書き直したプログラム。全6ステージで、リーダーボード上はどの最先端モデルも第1ステージを抜けられず。プログラムを換えたら6つ全部通った。
説明書なし。スコアは「正解数」ではない
ARC-AGI-3 は ARC Prize の評価で、手作業で作った小ゲーム環境が全部で 135、公開デモは 25。誰でも arcprize.org で遊べる。共通条件は説明書なし。オブジェクト一覧も、ルール説明も、目標の記述も、途中の報酬点もない。
モデルが1手ごとに受け取るのはこれだけ:64×64 の格子図で、各マスは 0 から 15 の色番号。加えて押せるキーが全部で7つ。
- RESET
- 試合をやり直す
- ACTION1
- 上
- ACTION2
- 下
- ACTION3
- 左
- ACTION4
- 右
- ACTION5
- 確定 / 削除
- ACTION6
- 座標を指定(x・y 各 0–63)
クリアへの道は一つだけ:手を動かしながらルールを推測し、間違えたら直す。キーを押し、画面のどこが変わったかを見て、そのキーの役割を推測し、次の手で確かめる。
このスコアは「正解数」ではない
ARC-AGI-3 のスコアは RHAE(相対的人間操作効率)。正解数は数えず、人と何歩歩いたかだけを比べる。モデルが各ステージを通った歩数を、そのゲームを初見で通した人の歩数と比較する。しかも減点は二乗比例だ。
採点の細部がもう3つ。知らないと数字が読めない。各ステージのスコアはステージ番号で重み付けされ、後ろほど価値が高く、冒頭のチュートリアルはほぼ効かない。1試合の上限は「どこまで進んだか」に縛られ、最終ステージ未クリアならいくら効率よくても 100% に届かない。人間基準は同じステージの初見プレイヤーのうち、歩数がやや上位の一人。だから一般人が受けても 100% は取れない。OpenAI が推計した人間平均は 48% だ。
画面を変えない操作は1歩も歩数に入らない。ツール呼び出し、思考過程、再試行も全部カウント外。
つまり 13.3% から 38.3% への上昇が測っているのは「遠回りをどれだけ減らせたか」だけで、「どれだけ考えを減らしたか」とは無関係。出力トークンが5分の4減ったのは別の帳簿で、2つの帳簿は独立している。今回は両方まとめて勝った。
モデルは鈍くない。1手ごとに記憶が消される
スコアが罰するのは遠回りだけなら、Sol の遠回りはどこから来たのか。OpenAI が対局ログを見ると、第一印象は ARC と同じ:あまり賢そうに見えず、1手ごとに長く悩み、同じ場所を回り続ける。もっと読むとモデル自体に問題はなく、プログラム側に2つあった。
第一に、1手を終えるたびに、自分向けに書いたプライベート推論が丸ごと捨てられる。次の手では Sol がゲーム理解をゼロからやり直す。押したキーと短いメモは見えるが、なぜ押したか、当時何が分かっていたか、次の計画は何か、は全部消える。
第二に、このプログラムはローリング切り捨て(rolling truncation)を使う。文脈が閾値を超えると、最も古いメッセージを捨てる。過去の考えが残らないだけでなく、押したキーの記録も少しずつ窓の外へ押し出される。
謎解きをやらせて、キーを押すたびに直前の思考を消し、手元には「右・右・上を押した」一覧だけ残すようなものだ。当時何が分かっていたかは書かれていない。通った道は見えるのに、なぜそう歩いたか思い出せない。毎手ゼロから推論し直し、すでに排除した道をまた歩きやすい。
この2点は ARC のオープンソース実装で直接見える
ARC は評価用プログラムを GitHub で公開している(ARC-AGI-3-Agents、最新コミット 2026年5月28日)。本サイトが取得して確認すると、両方とも実物があった。
第一に、リポジトリ全体で OpenAI を呼ぶ箇所はすべて chat.completions.create、計20か所。responses.create も previous_response_id もゼロ。これは「設定を有効にしていない」より決定的だ:旧インタフェースは構造上、暗号化された推論内容を次のラウンドに戻せない。推論が捨てられるのは設定漏れではない。このインタフェースを選んだ時点で結果は必然だ。
第二に、メッセージスタックは本当に FIFO で最も古いものを切っている:
agents/templates/llm_agents.pydef push_message(self, message):
"""Push a message onto stack, store up to MESSAGE_LIMIT with FIFO."""
self.messages.append(message)
if len(self.messages) > self.MESSAGE_LIMIT:
self.messages = self.messages[-self.MESSAGE_LIMIT :]
最後の行がローリング切り捨て:直近 MESSAGE_LIMIT 件だけ残し、前は捨てる。公開テンプレートの上限はメッセージ件数(通常版10、推論版5)。
満杯でも先頭は消さず、要約に圧縮する
原因が覚えられないことなら、直し方は2つ:覚えさせることと、空きを作るのに削除を使わないこと。
OpenAI のモデルは学習時から「まずプライベート推論を書き、それから返答やツール呼び出し」という形で、その推論メッセージは対話履歴に残す前提だ。履歴が収まらなくなれば圧縮して続ける。ChatGPT と Codex の本番もそう動いている。実験をこの本番環境に揃えるため、Responses API で ARC-AGI-3 のプログラムを書き直した。
スイッチ1:推論の保持 — 前回レスポンスの ID を返す
このスイッチは推論の保持(retained reasoning)。Responses API では、前回レスポンスの ID(previous_response_id)を次のリクエストに入れると、推論がツール呼び出しやラウンドをまたいで自動で残る。効果は2つ:毎手の考え込みが短くなる(ゲームを頭から理解し直さなくていい)、そして明らかに「学ぶ」ようになり、戦略がつながり、毎手がバラバラにならなくなる。
スイッチ2:コンパクションでローリング切り捨てを置き換える
コンパクションは文脈圧縮だ。OpenAI の API ドキュメントでは、リクエストに context_management の compact_threshold を置く。レンダリング後のトークン数がこの閾値を超えると、サーバが圧縮を走らせ、それまでの状態と推論を暗号化された圧縮エントリにまとめ、そのまま続ける。このエントリは人には見えないブラックボックスだが、「この対話を続けるのに要るもの」は運ぶ。
差は一言で言える。ローリング切り捨てはメモリ満杯で最も古い記録を消し、消えたら二度と戻らない。圧縮は満杯になったら記録を濃縮版に書き、空けたあとも記録を続ける。前者は本当に忘れる。後者は省略版で覚える。
OpenAI 自身が描いた図は、この仕組みが実際の1ラウンドでどう見えるかを示している:
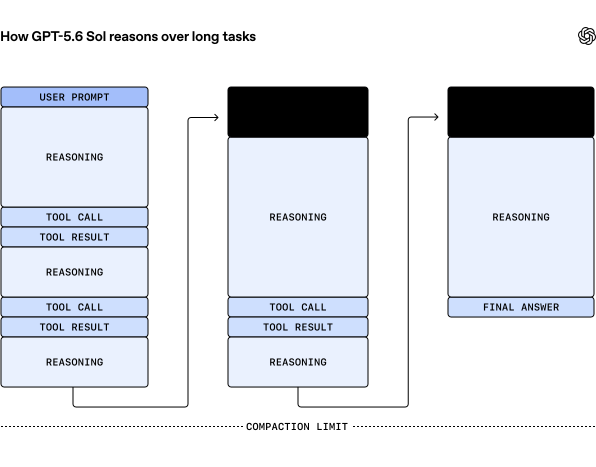
ローリング切り捨てには副次効果もある。モデルが大半の時間をほぼ満杯の文脈ウィンドウで動くことになり、窓が満杯だと性能は少し落ちる。圧縮は窓を空け直し、この点も避ける。
推論5レベルすべて上振れ、同スコアならトークン差は約12倍
下の図は2つのプログラムの実測を重ねたもの。横軸は1試合の出力トークン、縦軸はスコア。各線5点で、低・中・高・超高・最高の推論強度レベルに対応する。
2本の形の差は一目で分かる。公式プログラムは右へ這い上がり、1試合 290 万トークンでやっと 13.3%。新プログラムはほぼ縦軸に沿って上がり、最高レベルでも1試合 49 万トークンで 38.3%。
| 推論強度 | 公式 スコア | 公式 1試合トークン | 推論保持+圧縮 スコア | 新 1試合トークン |
|---|---|---|---|---|
| 低 | 0.9% | 58,809 | 3.7% | 84,316 |
| 中 | 1.5% | 207,188 | 7.3% | 141,939 |
| 高 | 5.2% | 728,188 | 13.4% | 243,258 |
| 超高 | 7.2% | 1,285,393 | 25.7% | 428,540 |
| 最高 | 13.3% | 2,900,997 | 38.3% | 485,485 |
5レベルすべてが上振れしたのが第一層。OpenAI 自身のまとめは、最高レベルで約3倍のスコア、出力トークンは約6分の1。
前の採点ルールに戻すと、2つの帳簿がはっきりする。RHAE は思考の歩数を歩数に入れない。だから 13.3% から 38.3% への上昇は、遠回りをどれだけ減らせたかだけを言う:自分の判断を覚えていれば、排除済みの道をまた歩かない。出力トークンの低下は、毎手ゲーム理解を頭からやり直さなくてよくなったことを言う。一つの変更で、重ならない2つの利得。
OpenAI はさらに 4分29秒のアニメーションを作り、Sol の 17.5 万文脈ウィンドウに沿って一連のステージを追った:
ARC 自身の分析は別の説明を出す
OpenAI は、今回の精査が ARC の分析に触発されたと書いている。5月1日公開で、ARC は 160 本の対局リプレイと推論軌跡を読み、結論は別の場所に落ちる:モデルがゲームの理解を築けない。同じ材料から双方が見たものを並べる。
混乱はプログラム側:プライベート推論が毎手捨てられ、古い動作が切り捨てで押し出され、モデルに「過去」がなく、学べない。
証拠は、この2点を換えたあと同じモデルでスコア約3倍、トークン約6分の1。
モデルがゲームの作業理解を築けない。失敗パターンは3つ:
- 局所効果は合っているが、大域ルールが立たない。ACTION3 でオブジェクトが回転するのは分かるのに、「樽を正しい向きにしてから塗料を付ける」まで届かない。
- 学習データ内の古いゲームに無理に当てはめる。cd82 を砂の物理や Flood-It、ls20 をブロック崩しにする。
- このステージは通ったが、ゲームは学んでいない。第1ステージを誤った理解で偶然抜け、第2ステージでその誤理解に閉じ込められる。
ARC の締めは対照の一文:Opus 4.7 は自信たっぷりの誤った理論に圧縮し、GPT-5.5 はそもそも圧縮できない。
観察が足りなくて失敗したのではない。観察を世界モデルに定着できなかったから失敗した。
ARC Prize、『Analyzing GPT-5.5 and Opus 4.7 with ARC-AGI-3』、2026-05-01
2つの説明は排他ではない。一歩前の判断を覚えられないなら、一貫した世界モデルはより作りにくい。だが指す場所は違う。一方はプログラム、一方はモデル。
事実を2つ並べておきたい。第一に、ARC はその分析の脚注で自ら書いている:既定テストでは GPT-5.5 は推論軌跡を返さない。定性分析は別の専用設定で走らせた結果で、公式スコアはそのモード由来ではない。推論が取れない現象が ARC 側からも確認される。
第二に、ARC が7月に出した GPT-5.6 系列の成績ページでは、Sol 自体への評価はかなり前向きだ。この世代で戦える唯一のモデルで、ゲーム固有の語彙で未知の場面を正しく読み、仮説が覆ると再計画して場当たりにせず、公開 ARC-AGI-3 ゲームを丸ごとクリアした最初のモデルでもある(番号 ft09、87%)。「あまり賢そうに見えない」は OpenAI がリプレイを見た印象であり、ARC の Sol への定論ではない。
プログラムをもっと徹底的に換えれば、数字はさらに上がりうる。
新 API に換え、思考を残し、削除を圧縮に置き換える
実装に落とすと、OpenAI が API 開発者に勧めるのは3つだけ。原文も3行で、展開はない。
具体的に書くフィールドは次のとおり。
previous_response_id
context_management.compact_threshold
store=false
POST /responses/compact
1つ目は前回レスポンスの ID を返すことで、推論がツール呼び出しとラウンドをまたいで自動保持される。2つ目は圧縮閾値で、レンダリング後トークン数が超えるとサーバが自動圧縮し、別 API は不要。3つ目を付けると、データ非保存の場面でもサーバ側圧縮が使える。最後は独立の圧縮エンドポイントで完全ステートレス。いつ圧縮するかを自分で決め、全文脈を送ると圧縮された新文脈が返り、次リクエストにそのまま渡せる。
彼らの締めの主張はこうだ:評価はモデルだけを測ることは少なく、見えにくい選択一式も同時に測る。API 設定、プログラム設計、プロンプト。初めてでもない。公開評価で意外に低く出たとき、調べると評価側の汎用プログラムが推論メッセージを捨てていた、という前例もある。
これらの実験が注意を促すことを願う。評価がモデルだけを測ることは少なく、目立たない選択一式 — API 設定、プログラム設計、プロンプト — も同時に測っている。
Ilan Bigio、Ted Sanders、OpenAI、2026-07-29
もう一段考えると:Sol のこの評価での成績は、ARC 検証の 13.33% から OpenAI 自社計測の 38.3%、Schema 自己申告の 95.35% まで動くのに、モデルの重みは一度も動いていない。人間基準は 48%。この数字を並べると、「モデルの能力はどれくらいか」の計算そのものが、まだ決着していない。
OpenAIが自社モデルの惨敗を振り返る:モデルを動かす層が、一歩ごとに思考を捨てていた
OpenAIのIlan BigioとTed SandersがARC-AGI-3の採点プログラムを新APIに切り替え、2つの設定をオンにしただけで、同じGPT-5.6 Solの点数と請求が同時に変わった話を、一枚の図で説明します。
↓ 一枚で読了 · 動く図つき
同じGPT-5.6 Sol、同じ評価問題、同じ推論強度帯。変えたのはAPI設定(モデル呼び出し時のインターフェースオプション)2つだけ。ARC-AGI-3公開問題セットの点数が13.3%から38.3%へ上がりました。モデルの重みは1バイトも触っていません。
38.3%はOpenAIが自前で出した成績です。ARC Prizeが独立に検証したものは、公式プログラム下の13.33%(公開問題セット)と7.78%(半プライベート問題セット)だけです。以下の3つの数字はいずれも、OpenAIが2026-07-29に出した振り返り記事からのものです。
ARC-AGI-3はARC Prizeが作った謎解きゲーム評価です。説明書は一切ありません。ルール説明も目標記述もなく、途中の報酬点もありません。モデルは一歩ごとに64×64のカラー格子図1枚と、押せるキー(計7つ)だけを受け取ります。クリアするには押しながらルールを当て、外れれば直すしかありません。
点数はRHAE(相対的人間操作効率)と呼ばれます。比べるのは歩数です。モデルが各ステージをクリアした歩数を、そのゲームを初めて遊んだ人が同ステージをクリアした歩数と比べ、余分に歩いた分を二乗で減点します。このパーセンテージは「何問正解したか」とは無関係です。
もう一つ、後の数字の読み方を決めるルールがあります。ゲーム画面を変えない操作は、1歩も歩数に入りません。思考、ツール呼び出し、再試行はすべてカウント外です。したがって点数の上昇が示すのは「どれだけ回り道が減ったか」であり、削れた出力量は別の勘定です。
OpenAIは何局分かの対局記録を見ました。第一印象では、このモデルはあまり賢くないように見えます。一歩ごとに長く考え、同じ場所をぐるぐる回る。しかし掘り下げると、問題はモデルを動かす外側のプログラム(業界ではハーネスと呼ぶ。画面をモデルに渡し、選んだ動作を返し、どれだけ履歴を見せるかを決める外部コード)にありました。
モデルが一歩終えるたび、自分用に書いたプライベート推論が丸ごと捨てられます。文脈が満杯になると、過去に押したキーの記録まで、いちばん古い側から削られます。次の一歩は、そのゲームをゼロから理解し直すしかありません。手元に残るのは次のようなものだけです。
✔ 短いメモ1行
✘ そのキーをなぜ押したか
✘ 前の一歩で何を理解したか
✘ 次に予定していた計画
原因は「覚えていられない」こと。直し方は2つだけです。自分が考えたことを残すこと、そして場所を空けるのに削除を使わないこと。
旧APIはモデルのプライベート推論を返せません。下の行がローリング切り捨てで、直近の数件だけ残します(公開テンプレは10件、推論版は5件)。それより前は丸ごと捨てます。
1行目は前回レスポンスのIDを返し、推論がツール呼び出しやターンをまたいで自動で残ります。2つ目はコンパクション閾値で、超えるとサーバー側が自動で1回圧縮します。別途APIを呼ぶ必要はありません。
5つの推論強度帯がすべて上にずれました。OpenAI自身のまとめでは、最高帯で点数が約3倍、出力トークン(モデルが生成した内容、従量課金)が約6分の1。より実用的なのは同点の比較です。
25 局の謎解き
ミニゲーム
1フレームずつ巻き戻した。
後戻りする?
- × そのキーを押した理由
- × 前の手で理解したこと
- × 次の手の予定プラン
さっきの思考が
消される。
最も古いものを削除。
一度消したら戻らない
学んだ内容は残る
compact_threshold|この量に達したら1回圧縮
自分の思考を覚えている。
13.3% → 38.3%
↓
49 万