外側の仕組みを変えるだけで:Opus 4.8 と Fable 5 を ARC-AGI-3 で99%まで引き上げる
- ARC-AGI-3 は「ルールを教えてくれない」タイプのゲーム群です。AI が受け取るのは64×64のカラーグリッドと、押せる操作がいくつかだけ。オブジェクトの一覧も、目標の説明も、報酬のヒントもありません。今年3月の公開時点では、最強のモデルでも0.51点しか取れませんでした。
- Schema は外側の仕組み(harness)です。モデルの重みは一切変えず、「使い方」だけを変えます。モデルに各ゲームのルールを実行可能なプログラムとして書かせ、それまでに記録した一手ずつを使って検証し、通ったらそのプログラム内で次の一手を探索させます。
- 公開25ゲームで、Opus 4.8とFable 5の組み合わせが98.98点、GPT-5.6 Solが95.35点を獲得。いずれもチームによる自己評価で、ARC Prizeの公式検証は経ていません。
- 同じOpus 4.8とFable 5の組み合わせでも、素のClaude Codeの外側の仕組みに置き換えると42.83点しか出ません。外側の仕組みをSchemaに変えるだけで56.15点上乗せされます。
- この99%が測っているのはステップ数の効率です(AIのステップ数を人間の初回プレイのステップ数で比べた比率の2乗)。つまりほぼ全ゲームを人間並みの効率でクリアしたことを意味しますが、単に解けただけでは足りません。
ルールを教えてくれないゲーム
Impossible Research(カリフォルニア大学バークレー校、カーネギーメロン大学と共同)がSchemaを発表しました。前沿モデルに物理学者のようにゲームをプレイさせる、外側の仕組みです。挑んでいるのは、AIを苦しめるために作られた専用のテスト、ARC-AGI-3です。
ARC-AGI-3はAIにゲームを渡しますが、何を見ているのかは説明しません。一手ごとにAIが得られるのは64×64のグリッド(16色)と、「今押せるキー」の一覧だけ。オブジェクトの一覧も、ルールの説明も、明示された目標も、「この手は正解だった」という報酬のヒントもありません。前に進む道は一つしかありません。物理学者のように、手を動かしながらルールを推測し、間違えたら直す。
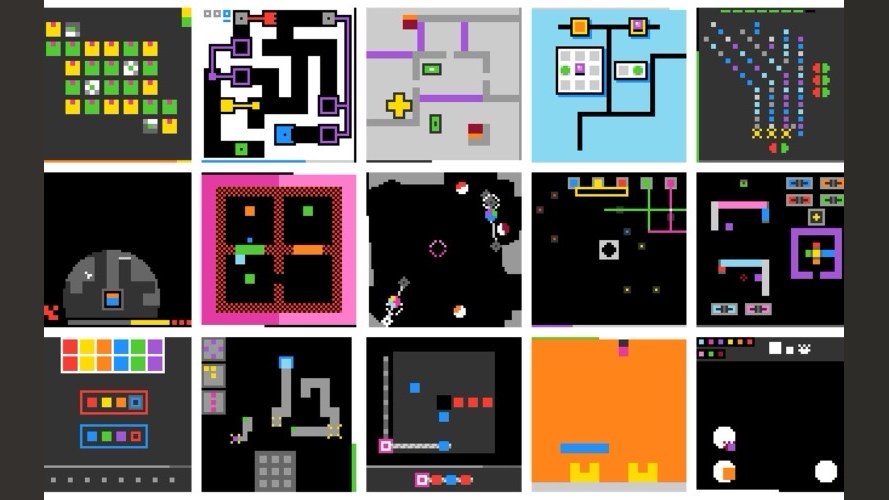
下の図は、AIが公開25ゲームで実際に目にした画面そのものです。1マスが1ゲーム。それぞれで自分で解き明かさなければなりません。この色付きブロックの集まりのうち、どれが自分の操作するキャラクターで、どれが壁で、どのバーがカウントダウンしていて、どうすればクリアなのか。

このテストは前沿モデルにとって極めて過酷です。公式指標のRHAE(相対人間行動効率)は、AIが各関門で使うステップ数を初回プレイの人間と比較します。今年3月の公開時点で、検証済みの前沿モデルの最高は0.51点。7月時点で最も優秀なGPT-5.6 Sol(推論を最大まで上げた設定)でも半公開セットで7.78点、公開セットで13.33点でした。参考までに、人間の行動効率は満点の100点です。
変わったのはモデルではなく「モデルの使い方」です。Schemaは外側の仕組み(harness)であり、画面をどう与えるか、モデルが観察をどう理解へと変換するか、その理解を実際の記録でどう検証するか、計画をどう実行・修正するかを再編成しているだけです。同じOpus 4.8とFable 5の組み合わせで、この外側の仕組みだけを入れ替えると、公開スコアは42.83から98.98に跳ね上がります。
99点は何を意味するのか
「25ゲームのうち何ゲーム解けたか」の通過率ではありません。RHAEが測るのはステップ数の効率で、しかもかなり重い2乗のペナルティが付きます。
計算方法はこうです。各関門で「人間のステップ数 ÷ AIのステップ数」を取り、それを2乗し、上限は1.15。ゲーム内で後になるほど関門の重みは大きくなり(1からnまで増加)、重みに紐づいた完了度の上限もあります。どれか一つでも通過できない関門があると、そのゲーム全体で満点は取れません。ゲーム内で実際に押した操作は、探索のために試した手も含めて、すべてAIのステップ数に数えられます。2乗であるため、余分に使ったステップ数はスコアを急速に下げます。
だから「だいたい全部クリアした」という点では同じでも、効率の差でスコアには天と地の差が出ます。原文には次のような対比例が示されています。
7関門を全通過、合計785ステップ。人間の基準の776ステップとほぼ同じ。クリアも節約もできたことで、ほぼ満点を獲得。
最初の6関門だけで1591ステップを使い、対応する人間基準の2.7倍。7番目の関門は未通過。2乗のペナルティと未通過による上限のせいで、スコアは14点未満に落ち込む。
つまりこの98.98点は、「完了度」と「ステップ効率」の両方を合わせた総合点であり、解答率とは同じではありません。うまくプレイするだけでなく、熟練した人間並みに省エネでプレイすることを要求しているのです。
物理学者のように考える
物理学者は法則を書き下す前に、まず「この法則は何についてのものか」を決めなければなりません。無数の観察の中で、どれを「物体」とみなし、どの属性が「状態」を定義するのか。これが決まってはじめて、「状態がどう変化するか」を論じられます。Schemaはこれを、同時に解決しなければならない二つの問題に分けています。
一つ目は状態の接地です。生の画面を、追跡可能な物体・変数・関係に変換すること。どのピクセルが自分自身で、どれが壁で、どれが「残りステップ数」を示すカウンターなのかを教えてくれるものは何もなく、AIは自分で見極めなければなりません。二つ目は機構の発見です。ある操作を行うとこれらの状態がどう変わるかを見出し、そのルールを実際に動くプログラムとして書き出すこと。
肝心なのは、この二つの問題を別々に解くことができない点です。一見筋の通った状態表現でも、後の実験でボロが出ることがあります。以降の結果を説明できる一貫したルールがどうやっても見つからないのです。このとき、ルールを直すだけでは足りず、「状態とは何か」そのものを直す必要があります。
潜在的な世界表現は一つのプログラムであり、一群のベクトルではありません。プログラムだからこそ三つの性質を同時に持てます。読める(開いてdiffできる一つのテキストファイル)、検証できる(記録された実際のプロセスを一手ずつ再生する)、探索できる(プログラム自体がシミュレーターであり、その中での計画立案には実際のコストがかからない)。
マイケルソンとモーリーが、光が「あるはず」の振動媒質(エーテル)を検出できなかったとき、ローレンツは一つ目の道を選びました。エーテルを保持したまま、ルールに補正を加え、収縮仮説によってこの検出できない結果を吸収したのです。アインシュタインは二つ目の道を選びました。エーテルを「状態」から丸ごと削除し、同時性を相対的なものにしたのです。予測が失敗し続けるとき、物理学者が動かすのは法則だけでなく、「状態そのものが何であるか」であることも多い。Schemaも同じことをAIに許しています。表現を変える、あるいはルールを変える。そしてもう一方を後から整合させる。
先にプログラムを書き、検証してから動く
一つのプログラムを持つだけでは足りません。Schemaは「このプログラムをどう使うか」にかなり厳格な規則を課しています。外側で回るのは4段階のループです。観察 → 熟考 → 実行 → 記録。
記録(record)はシステムが変更できない交互作用の履歴です。AIは自分の仮説やノートをいつでも書き換えられますが、すでに受け取った画面や、すでに押した操作は書き換えられません。この追記専用のタイムラインこそが、唯一の真実の基準です。
熟考のたびに、AIはゲームについての理論、すなわちstep(state, action)というプログラムを更新します。run_backtestを使って、このプログラムを完全な交互作用の履歴に照らし合わせます。予測と実際が食い違う一手があれば、その不一致を使って誤りの位置を特定します。さらにrun_bfsでこのモデル内の経路を探索し、結論をノートに書き込みます。これらの操作はどれも実環境に触れず、commit_actionsだけが動作をゲームに送信します。「内部でのモデル化と探索」と「外部との実際の交互作用」を完全に分離しているのです。
計画を実行する際、実際の変化のすべてが理論の予測と照合されます。一箇所でも食い違えば、現在の計画を即座に停止し、この反例を熟考に持ち帰ります。モデルがそれを説明できるように修正してからでなければ、再計画は許されません。モデルが目にした現実を凌駕することは決してありません。
もう一つ直感に反する点があります。AIはクリアのためだけに動くのではなく、「隠れた機構を明らかにする」ためだけに動くこともあります。まだ履歴と整合する候補ルールが複数残っているとき、それらを区別できる実験を探します。異なる仮説が異なる予測を出す操作を選んで実行し、結果を比較してstep()を更新するのです。RHAEが余分なステップ数に2乗のペナルティを課すため、最良の実験とはまさに「最小の実際の交互作用で、最大の不確実性を除去する」ものになります。step()が履歴内のすべての変化を再現できるようになれば、以降の解答はモデル内での探索に移され、実際のステップ数を追加で消費しなくなります。
実際の軌跡:LS20、642ステップ vs 人間780ステップ
AIは64×64、16色のグリッドを観察し、操作は0〜4。プラス記号のスプライト、シアンと赤の方形、枠付きの栗色のシンボル、11番色の長いバーがあります。ノートには次のように推論しています。自機はその5×5のシアン+赤の方形(プラス記号のスプライトは静止している)、バーは「移動予算」で、移動が成功したときだけ減る。
step()を書き、バックテストで記録中の36回の変化を再生し、すべて一致しました。続けて一連の動作を提出したところ、予想外の結果に。77マスの予測が外れ、方形はインジケーターを栗色に塗り替えていて、計画は無効になりました。「塗り替え」というルールをモデルに補い、バックテストが緑になったところでrun_bfsを使って最短経路を見つけ、次の関門に進みました。こうして7つの関門を通過:642ステップ、人間の基準780ステップに対し、このゲームのRHAEは100点でした。
使い方を変えただけで、同じモデルが43点から99点に
「99点は外側の仕組みの功績であり、モデルが強くなったわけではない」ことを証明するには、対照実験が必要です。モデルは固定し、外側の仕組みだけを入れ替える。原文では同じOpus 4.8とFable 5でこれを実行しています。
最終的なClaude Codeネイティブのドラフトのスナップショットを基準の出力とすると、成績は42.83点。同じ組み合わせでSchemaを装着すると98.98点、純増56.15点です。
Claude Code自体は非常に強力な汎用の外側の仕組みで、ファイル操作や長いコンテキスト管理が得意です。原理的にはSchemaの流れを模倣できますが、モデルに強制はしません。汎用の外側の仕組みの下では、モデルは直接ゲームに手を出すこともでき、自分の判断をずっとコンテキストに含めたまま、コードに落とし込まずに済ませることもできます。Schemaはこれに対し、三つの制約を強制的に課しています。
| Schemaが強制する規則 | それが塞ぐもの |
|---|---|
現在の世界モデルを、実行可能なstep()プログラムとして符号化する | 理解をコンテキストにだけ含め、説明できない状態のままにすることを禁じる |
| 記録された変化それぞれと照合して検証してから、計画に使う | 検証されていない思い込みで探索することを禁じる |
動作はcommit_actionsを経てのみ発行し、予測が一つ外れたら即座に残りの計画を破棄する | すでに誤っているモデルを抱えたまま進むことを禁じる |
この対照設定の下で、SchemaはClaude Codeベースラインに対して56.15点の向上をもたらしました。GPT-5.6に切り替えると、SchemaのSol xhighとSol maxの組み合わせは95.35点を獲得しましたが、注意すべきは、これに最も近い公式の参照点(Sol maxの公開13.33、半公開7.78)は同じ外側の仕組みでの対照実験ではないという点です。つまり図中の82点の差は「参考」であり、対照実験で測定された増分ではありません。
25ゲームを一つずつ見ると、Claudeの組み合わせで残った結果は14ゲームがOpus、11ゲームがFableで、そのうち19ゲームがちょうど満点の100。Solの組み合わせでは20ゲームが満点。100に届かなかった残りのいくつかは、89から99の間にスコアが集中し、差はごくわずかで、かなり集中しています。
「これは何か」を正しく認識すれば、勝てる
効率はいったいどこから来るのか。原文は二つの観察を示していて、それによってOpus 4.8とFable 5がこの外側の仕組みの下でどう違うかも自然と見えてきます。
観察一:プログラムを正しく認識すれば、行動は省エネになる
AIが「全履歴を精密に再現できる」プログラム形式の世界モデルを導き出せた14ゲームで、使用したステップ数は人間参照の1/1.6から1/5でした。理由はコストのかかる場所が変わったことです。実際のステップは「ある機構を発見する」ときにだけ一度支払われ、その後はモデル内で無料で計画を立てられます。同じ機構を試行錯誤で何度も再発見する必要がありません。人間が難しいと感じる場所ほど、この優位性は際立ちます。M0R0の第4関門では、人間は500ステップ必要でしたが、AIはわずか42ステップでした。
RE86ではこのプロセス全体が完結しています。run_backtestがモデルを393件の記録に対して一手ずつ再生し、すべて精密に一致。検証済みのモデルがそのまま計画を出し、余分な試行錯誤なしに関門を丸ごと突破しました。61ステップの単発計画で、実行時の予測エラーはゼロ、そのまま勝利です。「一回の操作で数百フレームの精密な画面を照合する」というこの能力に、補助なしの人間のプレイでは対応するものがありません。

観察二:Fableのほうが早く「認識自体が間違っている」と疑う
両モデルが試した同じゲームでOpus 4.8 MaxとFable 5を比べると、Fableのほうが高いRHAEを取っています。その理由は二つのパターンです。一部のゲームでは、Fableが見出したモデルがOpusでは通過できない関門を通過できた。別のゲームでは両者とも通過できたが、Fableのほうがより少ない実際のステップ数で同じ結果に到達している。
対になった軌跡は同じ解釈を指し示しています。一度予測が失敗すると、Fableはより頻繁に「表現方法そのもの」を疑い、本当に重要な不確実性を見極め、「異なる仮説が異なる結果を出す」操作を選んで試し、観察を再利用可能なルールへと変換します。Opusも最終的には同じ機構を見出すことが多いのですが、既存の表現方法の枠内で、目標や条件、設定をいろいろ試すためによりステップ数を使う傾向があります。
目標のロジックにこだわらず、まず装飾だと思われていた物体自体が動かせるかを試す。
同じ矛盾に気づいても、旧表現の枠内で目標を繰り返し修正し、長く迂回してから同じ機構に到達した。
FT09では、盤面が現在の目標ロジックを満たしても先に進まない状況で、Fableはより根本的な問いに切り替えました。装飾だと思われていた「チェッカー」自体はクリックできるのか?クリックすると、「押すと自分と上下左右の隣接マスを反転させる」十字ボタンが現れました。Fableはこの観察をコードに書き起こし、11ステップでクリア、次の関門は13ステップでした。Opusは同じ矛盾に気づいていましたが、その後もおよそ240ステップを使って別の目標状態の解釈を試し続け、287ステップ目にしてようやくそのチェッカーを押し、同じ隠れた機構を記録しました。両モデルともこのルールを表現し、使うことができます。違いは「誰がより早く、欠けていた手がかりを浮き上がらせる実験を選べたか」だけです。
AIは「この方形のモデルを完全に間違えていた」と認め、「方形は自機の携行状態によって変化する」というルールに切り替えたその瞬間、予測誤りは関門あたり数十件から4件へと激減しました。以降の第5、8、9関門では、人間のステップ数の1/4から1/6しか使わず、同じモデルをずっと再利用し、再発見はしていません。
第2から第4関門では、方形を「直接操作できる物体」として扱い、ステップ数は人間よりも多くかかっていました。新しい観察がこのモデルと絶えず衝突し、衝突するたびにさらに多くの実際の実験を強いられていました。
三つのケースはいずれも同じ一文に帰結します。汎用的な機構とは「決して変わらない」ことを意味するのではなく、「修正のたびに以前の説明の枠組みを保ちながら、新しい関門でのコストを下げていく」機構を指します。探索はそれが依拠する世界モデルの内部でのみ完全になります。欠けていた物体・状態変数・変化が一度表現されれば、既存の検証器と計画器で十分な場合が多い。しかし観察からどちらが正しい表現かを区別できないとき、同じ機構が誤った表現を検証・網羅してしまうこともあります。
一つの新たな出発点
ARC-AGI-3は、この急速に進化する分野における重要なベンチマークです。3月の公開時点で、先行する前沿エージェントは0.51点しか取れませんでした。7月時点で最も優秀な公式Sol Maxは公開セットで13.33、半公開セットで7.78。一方、自己評価の結果は一時、ゲームごとのRHAE平均で58.12点まで上がっています。
Schemaが自己評価で出した98.98点は、この軌跡の延長線上にあり、断絶ではありません。原文自身がはっきりと述べています。ここに挙げた数字はすべて公開25ゲームでのみ測定されたものです。Sol maxは評価セット間を横断する唯一の公式な校正点(公開13.33対半公開7.78)を提供していますが、これだけでは、ほぼ満点の公開成績を半公開セットへ数値的に外挿するには足りません。公開の98.98が半公開でどうなるかは、実際に測定するまで誰にもわかりません。入手可能な実行データが記録しているのは公開セットのみであるため、この発表では「外側の仕組みを固定した」検証や「留保セットでの成績」についての主張は行っていません。加えて、両成績は自己評価であり、ARC Prizeの独立検証は経ていません。図中のSolの曲線も、完全な評価資料が公開される前に、元のグラフから読み取った暫定値です。
研究者たちは、飽和したARC-3を新たな出発点として捉えています。「機構発見」を汎用的な能力にすること。行動と知覚のエージェントループを通じて、世界の因果構造を接地させること。しかもその世界は、64×64のグリッドよりもはるかに豊かなものになる。それが彼らの目指す方向です。
肝心な材料はすでに姿を現していました。陌生な環境に適応できる前沿モデル、プログラミングエージェントの外側の仕組み、そしてプログラム形式の世界モデル。Schemaは、それらを一つに束ねたシステムです。 Impossible Research、Schema発表ブログ
説明書のないゲームで、AIはやり方を変えた:「プレイしながら推測」→「まずプログラムとして書き、検証してから動く」
Impossible ResearchはSchemaと呼ぶ外側の仕組みを作り、モデルには触れず使い方だけを変えて、同じAIを公開25ゲームで自己評価99点まで押し上げた。その仕組みを1枚の図解で説明する。
↓ 1枚読めば全部わかる · 動く図が1つ入っています
ARC-AGI-3は、AIを苦しめるために作られたゲーム群(AIが「自分でルールを推測できるか」を測るテスト)です。画面に出てくるのは64×64のカラーグリッドと押せるキーがいくつかだけで、目標が何か、どのブロックが自分か、押すとどうなるかは一切教えてくれず、すべてプレイしながら推測するしかありません。
どれだけ難しいのか。今年3月の公開時点で、最強のモデルでも0.51点しか取れませんでした。7月になっても、最高の成績はまだ13.33点(満点100は初回プレイの人間の水準)でした。
✘ 「ルールを教えてくれない」ゲームに当たるとほぼお手上げ
なぜなら、これまでは直接プレイに手を出し、推測したルールを頭の中に留めたまま、間違えても引き続きそのまま進み、逐一巻き戻して照合することがなかったから。誤ったルールを最後まで引きずってしまう。
Schemaは「外側の仕組み」(harness、モデル自体には触れず、画面をどう与えるか・どう考えさせるか・どう動作に変換するかという仕組みだけを再編成するもの)です。AIにやり方を変えさせます。まずこの関門のルールを実際に動く小さなプログラムとして書き出し、それまでの一手一手を再生して検証し、すべて一致したら、そのプログラムの中で次の一手を探索する。
ルールを頭の中に記憶
→ そのままキー入力、間違えても続行
42.83点
step(グリッド、キー) → 新しいグリッド
run_backtestで再生検証
run_bfsで最短経路を無料探索
commit_actionsでのみ実際に動作
98.98点
同じOpus 4.8とFable 5で、モデルは一バイトも変えていないのに、外側の仕組みだけ入れ替えたら43点から99点に跳ね上がった。でも「プログラムとして書く」だけで、なぜこんなに差が出るのか?
AIがゲームをプレイするやり方は、これまでずっと「プレイしながら推測、間違えても続行」でした。Schemaはそれをこのループに置き換えます。まずルールをプログラムとして書き、検証してから動く。
この99点は「25ゲームのうち何ゲーム解けたか」ではなく、AIの各関門のステップ数を人間の初回プレイのステップ数と比較したもので、節約できるほど点数が上がり、2乗のペナルティも付きます。「同じ関門を何ステップで通過するか」に換算すると、いちばん体感しやすい。
試行錯誤を繰り返す
ルールを認識した後は探索するだけ
押したらどうなる?
- × オブジェクト一覧なし
- × 目標説明なし
- × 報酬ヒントなし
プログラムにする。
モデルは一バイトも変更なし
本当に正しい?
一手ずつ一致して、
それでこそ有効。
実際に押す。
もう一周やり直す
人間が最も難しいと感じた関門
vs 人間500ステップ
推測しなくていいんだ。
変わったのはやり方。
まずプログラムとして書き、検証してから動く。