Claude Code effort 実践ガイド:Low を使う場面と設定を上げる場面
effort が変える作業を理解し、3 組の開発実測を見てから、要件インタビュー、素早い実装、人のレビュー、詳細な検証の 4 段階で設定を選びます。
Claude の新モデル Opus 5.5 は、effort の設定に応じて投入する計算量を調整でき、Claude Code で設定を切り替えてもプロンプトキャッシュが無効になりません。原文のテストでは、より低い設定でも近い成績を得られる可能性も示されています。Opus 5.5 の High での合格率は、Fable 5.1 の Max に近い値でした。それでもユーザーからは、effort とは何か、なぜ必要なのか、どの設定を選べばよいのか、という質問がよく寄せられます。Anthropic の Thariq Shihipar は、その使い方を詳しく解説する記事を書いています。
こうした疑問に答えるため、Shihipar は日常的な開発の実験を行い、Terminal-Bench 3.0 の内部実行も詳しく調べました。注目したのは、追加の投入によって、どのような自律的判断、検証、境界条件のテストが増えるのかという点です。本稿では「仕組みを理解する → 実測を見る → 開発フローに取り入れる」の順に、原文を設定選びのガイドとして整理します。
effort とは何か、実際に何が変わるのか
ここでいう effort は、そのタスクにどの程度の計算資源を使う価値があるかを、モデルにおおよそ伝える設定です。厳密な制限時間でも、最終回答の文字数だけを調整するスイッチでもありません。どの設定でもタスクの完了を目指しますが、低い設定では、現在の要件を満たす版を早く出す傾向があります。高い設定では、追加調査、別の解法の試行、自分の実装の見直し、プロンプトに一つずつ書かれていない境界条件の確認を続ける可能性が高まります。著者は人の作業時間に例えています。1 時間なら議論の土台を作り、12 時間なら自分で磨き込み、検証する余裕が生まれるということです。
そのため、「高い」ことが必ずしも「適している」ことを意味しません。タスクがまだ曖昧なら、追加の労力は、あなたに代わって製品上の判断をすることに使われるかもしれません。一方、セキュリティフィルターやストレージエンジンの不具合のように、特殊なケースを見落としやすい仕事では、検証を増やすことに価値があります。設定を選ぶ前に、今ほしいのは次のフィードバックにつながる初稿なのか、それともできるだけ自己完結した成果物なのかを考えましょう。
同じタスクで投入の仕方を変える
設定を変えると Claude の重点はどう変わる?
Low · フィードバックしやすい土台を早く出す
- モデルが進めること
- 現在の要件を満たす初版を早く作り、方向性を判断しやすくします。
- 検証の重点
- 小さな変更や素早い反復に向きます。重要な境界条件のテストは、別の検証段階に設けられます。
- 人が行うこと
- 早めに確認してフィードバックし、次に変える点を明確にします。
選択のポイント:次の議論へ早く進める一方、自律的な磨き込みは通常少なくなります。
原文に基づく動作の例であり、固定の時間・token 予算・品質保証ではありません。実際の動作はタスクとプロンプトによって変わります。低い設定でも適切な完了を目指し、高い設定でも方向を誤ることがあります。
3 組の実測:要件の明確さで選び方はどう変わるか
著者は 3 つの小規模な開発タスクを使い、effort による動作の違いを観察しました。以下の所要時間は、記事で紹介された実行の記録です。選択の利点と代償を理解するためのもので、毎回再現される時間表ではありません。
曖昧な要件:低い設定は土台を早く出し、高い設定は判断を多く補う
最初のタスクでは、Opus 5.5 に「個人向けのフィットネス・トレーニング記録アプリを作って」という一文だけを渡しました。この実演では、low は約 1.5 分で記録機能と簡単なグラフを作成しました。medium は約 4 分、high は約 11 分でした。max は約 67 分を使い、ヒートマップなどの細部を含む、より完成度の高いアプリを作りました。図 A のインタラクティブな比較では、low 版は記録、週間トレーニング量、履歴が中心で、max 版には、より充実したナビゲーションやトレーニングフローもあります。増えたのは機能だけでなく、どの機能や画面を作る価値があるかという Claude 自身の判断でもあります。
選び方: 土台を手に入れてすぐにフィードバックしたいなら Low。モデルが 1 回でどこまで自律的に仕上げるかを見たいなら設定を上げられますが、その分、モデルに任せる判断が増えることを受け入れる必要があります。
探索的なデザイン:方向性を先に見るか、完成度の高い試作を見るか
次のタスクは、Claude Code の /config メニューの再設計です。どの設定でも基本的な発想は似ていて、サブメニューと検索の改善を使っていました。low は約 1 分で方向性の分かる操作可能なスケッチを出しましたが、既存の Claude Code の見た目にはあまり似ていませんでした。max は約 28 分をかけ、製品に近い試作を作り、複数の操作経路も確認しました。このタスクで著者が好んだのは、むしろ low でした。まず方向性を見て、自分でフィードバックしたかったからです。一度の納品でできるだけ完成に近づけたい場合には、max の仕上がりが魅力になります。
選び方: 初期の探索は Low から。方向性が決まってから、細部や操作フローの充実に時間をかけるとよいでしょう。
詳細な仕様:成果は似てくるが、所要時間の差は残る
著者はさらに条件を変えました。まず Claude に詳しくインタビューしてもらい、フィットネスアプリの要件を補完したうえで、同じ詳細仕様を異なるモデル・異なる effort 設定に渡しました。low、medium、high、max の所要時間はそれぞれ約 16、22、33、79 分でしたが、デザインと実装はかなり似たものになりました。max は一部の細部をさらに簡略化していました。この比較は、仕様を明確にすると、Claude が推測しなければならないことを減らせると示しています。effort を上げても、要件を明確にすることの代わりにはなりません。以上の 3 組はいずれも著者が紹介した具体的な実行であり、作業の進め方を理解する材料です。分数を自分のタスクの所要時間の保証として扱うことはできません。
選び方: 仕様が十分で、人が確認する初期実装なら Low または Medium から始められます。重要なテストは後の段階に組み込みましょう。この一つのアプリの実演から、あらゆる複雑なタスクを低い設定で完了できるとはいえません。
3 組の実測 · 3 種類のタスク条件
タスクを切り替え、待ち時間の使い道を見る
フィットネス記録アプリ:一文だけの依頼
記録、週間トレーニング量のグラフ、履歴。すぐに次の修正へ進める土台です。
より充実したアプリとトレーニングフロー。ヒートマップなどの細部と、より多くの製品上の判断を含みます。
選択のポイント:フィードバックにつなげるなら Low。1 回で自律的に仕上げてほしい場合に、より多くの投入を検討します。
著者が示した個別の実行に基づきます。3 組とも上限 80 分の同じ目盛を使い、未報告の時間は補っていません。
難しいタスクのテスト結果:どの仕事で設定を上げる価値があるか
日常的なアプリの実演は、いずれもモデルが対応できる範囲の仕事でした。effort が成否に影響する場面を見るため、著者はコミュニティがタスクを提供する Terminal-Bench 3.0 も調べました。セキュリティ、ハードウェア、機械学習、科学、ソフトウェア、業務処理、メディアなどを扱い、一般的な開発依頼より難しい課題が多く含まれます。たとえば、テスト ROM を動かせる 8 ビットゲーム機を Verilog で構築する課題、Lean 4 で定理を形式的に証明する課題、混合エキスパートモデルの重み 16 シャードを結合する課題、企業の月末の EU 貿易統計申告を最初から最後まで行う課題、ポスターを編集可能なレイアウトとして再現する課題があります。普通の「コードを少し書く」仕事とは難しさが違います。
設定を上げると合格率が上がる場合があるが、投入量も増える
全体を示すグラフでは、合格率と 1 回の試行で消費した token 数が並べられています。著者が報告した Opus 5.5 の合格率は、このタスク群で low の 36.6% から max の 65.7% に上がりました。high の 58.9% は Fable 5.1 の max の 58.0% に近く、token 数の中央値は約半分でした。横軸は試行 1 回あたりの消費 token 数の中央値であり、料金でも実行時間でもありません。モデルと設定によって「合格率と投入量」の組み合わせが変わることを示しています。一方、効果が頭打ちになる例もあります。Fable 5 は xhigh から max に上げても、合格率は 43.4% のままでした。したがって、どのモデルでも、どのタスクでも同じ効果が得られるとはいえません。
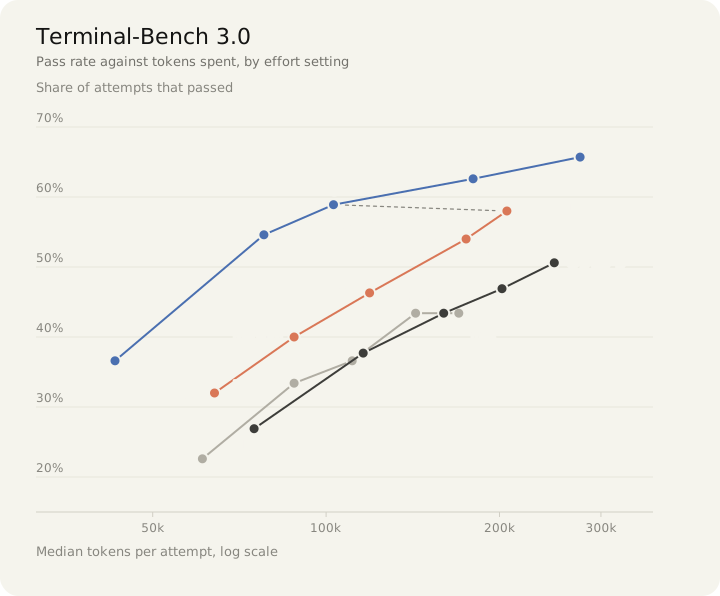
比較には共通の 70 問を使い、GPU を使う 4 問を除外しています。Opus 5.5 の実行は約 3 週間後で、出力上限は 128k、GitHub と PyPI へのアクセスはありませんでした。図中の Opus 5 max は effort-120 の実行に対応します。モデル間の順位を読む際には、こうした条件を考慮する必要があります。
増えた時間は、どの確認に使われたのか
仕組みが特によく分かるのが、HTML サニタイザーの課題 html-js-filter です。さまざまな方法でページに JavaScript を紛れ込ませる入力を除去する必要があります。Anthropic の内部実行では、Fable 5.1 は low の 5 回中 1 回合格から、xhigh では 5 回すべて合格になりました。著者が追跡した低い設定の実行は約 2 分で、ほぼ一度で書き上げ、手書きのページだけでテストしていました。追跡した高い設定の実行は約 33 分で、まず攻撃者の視点から初稿を見直し、インストール済みパーサーのコードを読み、正常な入力を壊さないことを確かめ、XSS テスト集を実行し、最後にランダムな文書の生成器を書いてさらに穴を探しました。「一つ入口を見落とすと失敗する」仕事では、追加時間が有意義な確認につながる可能性があります。
見落としは減っても、誤った方向は残り得る
ただし、高い effort が判断ミスをすべて修正するわけではありません。図 D は Fable 5.1 の各設定 370 回の試行を分類しています。low から max にすると、合格数は 140 から 214 に、token 数の中央値は 7.3 万から 22.2 万に増えました。「あるケースを見落とした」失敗は 59 から 24 に、「判断を誤った」失敗の合計は 133 から 107 に減りました。後者は依然として多く、その内訳の「問題の解釈を誤った」という項目は、むしろ 25 から 47 に増えています。失敗分類はモデルによる評価のおおよそのラベルであり、厳密な因果関係の内訳ではありません。
| 結果(各 370 回) | low | max |
|---|---|---|
| 合格 | 140 | 214 |
| ケースの見落とし | 59 | 24 |
| 判断の誤り | 133 | 107 |
| その他の失敗 | 38 | 25 |
| 1 回あたりの token 中央値 | 7.3 万 | 22.2 万 |
妥当な読み方は、追加の投入が一部の見落としを大きく減らした一方、問題の解釈や解決方針を正しく選ぶ保証はないというものです。
3 つの難題:「書き終えた」から「有効性を確かめた」へ
原文のほかの課題でも、同様の作業の違いが見られます。
- ストレージエンジンの圧縮処理の不具合を修正する
mvcc-lsm-compactionでは、Opus 5.5 が low の 0/5 から xhigh の 4/5 に改善しました。low は 1 回あたり約 1 分で、ビルドや不具合の再現を行う前にコードを変えることが多くありました。xhigh は 1 回あたり約 11 分を使い、まずクラッシュを再現し、圧縮しない参照実装とランダムな比較を行い、修正が不十分な版をテストで検出できることも確かめました。 - Python のコマンドライン線形計画ソルバーを作る
cli-2ph-simplexは、low の 0/5 から high の 5/5 になりました。低い設定では少数の小さな問題だけを実行し、約 1 万 token で停止しました。大きな問題は遅いかもしれないと注意書きはしたものの、測定はしませんでした。高い設定では、ランダムな問題を独立した総当たりソルバーの答えと比較し、大きな問題の負荷テストも行い、遅さやクラッシュを発見すると探索処理を作り直しました。 - プロテオミクスデータの 8 つの処理群から対象組織に似た処理群を探す
gsea-proteomicsは、low の 0/5 から high の 4/5 になりました。低い設定は一見妥当な前処理を選び、そのまま結果を報告しました。高い設定は 2 通りの前処理を試し、有意とされた群の一覧が変わる原因を調べてから方法を選びました。問題の本質は、最後のコードではなく分析の前提にある場合もあります。著者によれば、人が関与していれば Claude は分析の設定を尋ねるかもしれませんが、人が関与しないこのケースでは、高い effort のほうがよい結果でした。
どの分野で追加投入の効果が大きかったか
分野別にまとめると、Fable 5.1 の合格率は 7 分野すべてで上がっていますが、伸び幅は異なります。
| 分野(問題数) | 低い設定の合算 | 高い設定の合算 |
|---|---|---|
| セキュリティ(7) | 64% | 87% |
| ハードウェア(5) | 34% | 75% |
| 機械学習(13) | 54% | 73% |
| 科学(15) | 41% | 61% |
| ソフトウェア(20) | 43% | 56% |
| メディア(4) | 18% | 30% |
| 業務処理(10) | 12% | 22% |
ここでの「低い設定」と「高い設定」は、各分野の問題数が少ないため、それぞれ下位 2 段階と上位 3 段階をまとめたものです。low から max にだけ変更した効果を厳密に示す数字ではありません。問題数の合計は 74 問で、GPU 問題を除外した全体グラフの 70 問とは分母が異なります。この実行群ではセキュリティとハードウェアの伸びが目立ちました。一方、業務ルールに沿って処理する課題は、設定を上げても合格率が低いままでした。多くの検証を要し、隠れた境界条件が多い仕事ほど、追加の effort に費用をかける価値がありそうです。主な障害がルールの理解や方針の選択にあるなら、計算量を増やすだけでは解決しないことがあります。
実践ガイド:各段階に effort を配分する
著者は、目標を伝えて Claude にインタビューしてもらい、仕様の不足を見つける → low で初版を作る → 人が方向を確認し、必要なら low で修正を続ける → 最後に high で検証とテストを行う、という実用的なサイクルを使っています。
今のタスクに合う出発点を選ぶ
著者の経験則では、low はブレインストーミング、スケッチ、簡単な変更、人がすぐにフィードバックする仕事に向いています。medium は通常の機能開発、high は既存コードベースの不具合調査、重要な検証、境界条件の多いタスクに使います。max は、アプリを最初から最後まで構築・検証する仕事や、重要なソフトウェアの脆弱性監査など、Claude に高い自律性で進めてほしい難しいタスクに残しておきます。
自分の仕事に当てはめるなら、次の 4 つの状況を出発点にできます。ここでの Low、Medium、High、Max は著者が勧める一般的な開始設定です。前半の実験に登場した xhigh は、High と Max の間にある、さらに投入量の多い設定です。
- Low:早くフィードバックにつなげる。 ブレインストーミング、操作のスケッチ、小さな変更、または要件が明確で、初版をすぐに確認する仕事。まず方向性と主要フローを見ます。初版を十分に検証済みの完成品として扱わないことが大切です。
- Medium:通常の実装を進める。 目標が比較的明確で、新機能をある程度まとまった形で実装したいときの日常的な出発点。すぐに議論するための骨組みだけがほしいなら、Low から始めてもよいでしょう。
- High:潜む問題を調べる。 既存コードベースの Bug 修正、性能検証、セキュリティ確認、境界条件の多いタスクに使います。Brownfield とは、既存のシステムと制約の中でコードを変えることです。パッチが従来の動作を壊していないか確認する必要があります。
- Max:より多くの自律的作業を任せる。 モデルに難しいタスクを自力で進め、方針を選び、検証まで完了してほしく、長い待ち時間と多い消費を受け入れられるときに検討します。その場合も、目標、受け入れ基準、権限の範囲は明確に伝える必要があります。
今回の作業に合わせて選ぶ
今はどの設定から始める?
仕様が明確で、すぐにレビューできます。動く初版を早く受け取り、フィードバックまでの待ち時間を減らします。
次の行動:主要フローを確認し、方向が決まったら High で重要な検証を行います。
原文の経験則に基づく開始設定の提案です。理由と次の行動を見てから、採用するか判断してください。
Claude にインタビューさせ、仕様を補う
最初の目標を伝えたら、Claude から質問してもらいます。実装を左右する選択を優先して埋めましょう。誰が使うのか、主要な操作フローは何か、データをどう保存するのか、どの失敗に対応する必要があるのか、何をもって完了とするのか、といった点です。回答を確認可能な仕様にまとめてから実装に入ります。曖昧な要件を、モデルが当然のように決める製品の細部へ変えてしまわないことが大切です。
この段階の成果: 合意した範囲、確認待ちの判断、受け入れ基準。主要な要件をまだ推測しているなら、引き続き明確にします。この段階で設定だけを上げても、業務上の問いにあなたの代わりに答えることはできません。
Low で方向を判断できる初版を作る
素早く実装する段階では、最も重要な一つのユーザーフローに範囲を絞ります。Claude が決めてよいことと、あなたに確認すべきことを指定しましょう。詳細仕様によって推測する部分はすでに減っているので、Low なら議論しやすい版を早く出せます。通常の機能をある程度完成した形で実装してほしく、各段階を細かく追う予定がなければ、Medium から始める方法もあります。
この段階の成果: 動作し、主要なロジックが分かる初版と、実施済み・未実施事項の一覧。基本的な動作確認はここでも行い、深い検証は後の専用段階に回します。
人がレビューし、正しいものを作っているか確認する
主要なフローを自分で操作し、仕様と照らして 3 点を確認します。対象ユーザーが主なタスクを完了できるか、重要なデータとロジックが期待どおりか、Claude が機能範囲を勝手に広げていないか、です。画面の美しさやコード量は、この確認の代わりにはなりません。
方向が違えば具体的なフィードバックを渡し、Low で修正を続けます。仕様に不足があれば、先に補います。主要なロジックが正しく、残る問題がテストの抜けや隠れた不具合なら、High での検証へ進みます。こうすると、作り直すことになる方針に追加の計算を使わずに済みます。
High に切り替え、「問題はある?」だけで終わらせず証拠で検証する
検証対象、受け入れ基準、重点的なリスクをまとめて Claude に渡します。Bug 修正では、元の問題を再現させ、新しいテストが古い実装で失敗することを確認します。性能改善では、想定規模のデータで実測します。複雑なアルゴリズムは独立した参照実装と比較できます。セキュリティフィルターでは、危険な入力だけでなく、正常な内容まで誤って除去していないかも調べます。
これらは原文の難題の事例から得られる方法です。共通するのは、モデルの外に確認可能な結果を置き、「一通り見たので問題なさそう」で検証を終わらせないことです。
この段階の成果: 実際に行った確認、観測結果、修正した問題、まだ検証していない部分。失敗の原因が見落としやテスト不足なら、対象を絞った検証を追加できます。要件の誤解や方法の前提に原因があれば、仕様や方針に戻って修正します。追加の投入は一部の見落としを大きく減らしましたが、問題の解釈や解決方針を正しく選ぶ保証はありません。
そのまま使える 4 段階の依頼文
以下は著者のワークフローを基に整理したプロンプト例で、段階ごとに分けて使えます。原文の逐語的なプロンプトではありません。始める前に、目標、プロジェクト環境、変更を許可する範囲を記入してください。文中の「Low / High」は、設定の選択を促すための表示です。著者は Opus 5.5 と Fable 5.1 について、Claude Code の /effort を使い、同じ会話の中でも段階に合わせて切り替えることを勧めています。新しいモデルでは effort を切り替えてもプロンプトキャッシュが無効にならず、再利用可能な既存のプロンプト内容は、設定変更だけを理由にキャッシュを失いません。そのため、現在の会話のまま「Low で実装 → High で検証」と進められます。
【要件インタビュー】
目標:[目標]。利用者:[ユーザー]。
プロジェクト環境と変更を許可する範囲:[環境、ディレクトリ、制限]。
まず実装に影響する不足情報を質問し、範囲、確認待ちの判断、受け入れ基準を整理してください。
重要な業務上の選択は私に確認し、要件を独自に広げないでください。

【初版の実装|先に Low を選択】
確定した仕様に従って主要フローを実装してください:[主要フロー]。
動作し、私がレビューしやすい版を作り、基本的な動作確認を行ってください。
納品時に実施済み、未実施、私の判断が必要な事項を列挙してください。

【人によるレビュー後の修正】
確認結果:[具体的な問題と期待する動作]。
これらの問題だけに対応し、影響を受ける主要フローを再確認してください。
フィードバックが要件と矛盾する場合は、先にその箇所を指摘してください。

【詳細な検証|High に切り替え】
確定した受け入れ基準に照らして現在の実装を確認してください。重点リスク:[リスク]。
関連する確認を実際に実行し、Bug 修正ではテストが元のエラーを検出できることを確かめてください。
必要に応じて、参照結果、想定規模のデータ、正常・異常な入力と比較してください。
実施した確認、結果、修正、未検証の部分を報告してください。
いつ上げ、いつ下げるか
下げる目安: 今は方向性を素早く議論したいだけなのに、モデルが依頼していない細部を追加し続ける場合。または、仕様がすでに明確で、こまめにフィードバックしたい場合です。今回のタスクを小さくし、モデルが自分で決める範囲を減らします。
上げる目安: 方向性は確認済みだが、隠れた境界条件が多い、パッチの有効性を証明する必要がある、またはモデルに長時間自律的に進めてほしい場合です。設定を上げるときは、重点的に確認する内容と完了基準も明示します。
先に入力を直す目安: 問題を誤解している、間違った前提に依存している、業務上どの動作が正しいか分かっていない場合です。先に情報を補い、方針を直してから、検証への投入量を決めます。
原文のデータは Anthropic の内部実行で、各問題につき 5 回試行しています。Fable 5.1 のセキュリティ課題では本番環境の安全介入を無効にし、セキュリティ課題にはネットワークアクセスがありませんでした。実際の Claude 製品では、一部のセキュリティ関連リクエストが Opus に転送されます。動作分析は個別の実行に基づき、一部では中間の effort 設定を使っています。一つの実行記録の時間を、その設定における 5 回の平均時間として扱わないでください。これらの条件は、公開ランキングや普段の利用との比較に影響します。上記の設定を出発点として、自分のタスクで成果の品質、時間、消費量を比べながら調整しましょう。