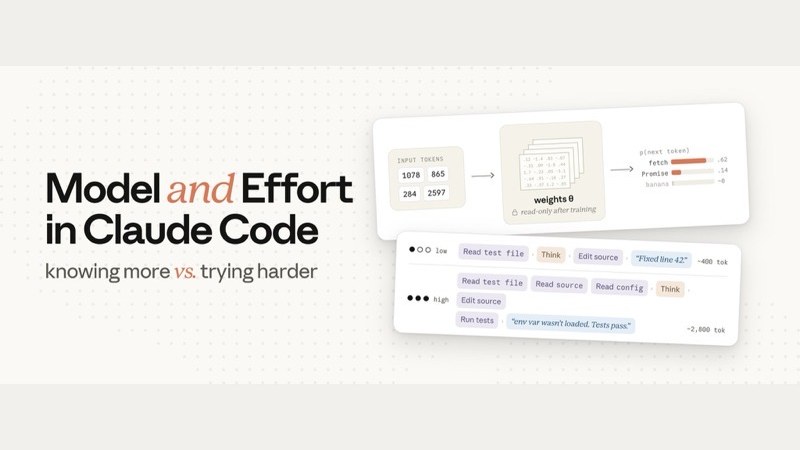
Claude Code チームが教えるこの2つのつまみの使い方:1つは「できるかどうか」を、もう1つは「どこまでやる気があるか」を司る
- Anthropicの開発者向けアカウント@ClaudeDevsが2026年7月8日に長文を公開、著者はClaude Codeチームのメンバー Lydia Hallie(@lydiahallie)。
- effort(努力度)は、このタスクでClaudeがどれだけの作業をトータルで行うかを制御する:どれだけ考え、どれだけファイルを読み、どれだけテストを走らせ、どれだけ検証し、どこまで多段階に進めてから聞き返すか。API側でよく見る5段階:low / medium / high / xhigh / max;多くのタスクはモデルのデフォルト段階で十分。
- モデル設定はどのセットの訓練済みの凍結された重みを使うかを決める、つまり「何を知っているか」;effortは「どこまで徹底的にやるか」を決める。答えが間違っていたらまずコンテキストを確認し、次に問う:「できない」のか「本気を出していない」のか?
- 役割の例え:Fableは専門医のよう、Opusは専門家のよう、Sonnetは頼れる総合診療医のよう;effortは彼らがあなたのこの案件にどれだけ時間をかける気があるか。
- シンプルなタスクでは大きいモデルの方が高くつく;難しい多段階タスクでは大きいモデルの方が総合的な支払いが低くなることもあり、小さいモデルでは終えられない仕事もこなせる。Opus 4.8のデフォルトeffortはテストにおいて4.7のデフォルトのtoken量とほぼ同等で、効果はより良い。
2つのつまみ、どちらも「答えを良くする」ように見える
2026年7月8日、Anthropicの開発者アカウント@ClaudeDevsがClaude Codeの長文を投稿した、著者はClaude Codeチームのメンバー Lydia Hallie。
effortとは何か:同じモデルで、この案件をどこまで徹底的にやるか
Claude Codeでは、effort(努力度)はモデル選択と並ぶ設定である。それはモデルが「できるかどうか」を変えるのではなく、同じモデルセットに、今回どれだけ手間をかけてから提出するかを伝えるだけだ。よくある誤解はeffortを「より長く考える」ことだと理解すること;実際にそれが司るのは、この作業全体をどこまで徹底的にやるかである。
原文には率直に書かれている:effortが制御するのはこの一回のリクエストでClaudeがトータルでどれだけの作業を行うかであり、どれだけ長く考えるかだけでなく、以下も含む:
ソースコード、設定、ログを多く開くか、それとも対話ボックスに入れたその数段落だけを見るか
修正後にテストを走らせるか、結論を見直すか、境界のケースを自分でもう一度確認するか
多段階のタスクを一気にどこまで進めるか、それともすぐに止まってあなたにコンテキストの補足を聞くか
まず計画を書くかどうか、計画がどれだけ深いか、答えを見つけた後にもう一段検証するかどうか
APIドキュメントでは、effortは行動シグナルであり、硬直的なtoken上限ではない:低段階でも本当に難しい問題に遭遇すれば依然として考える可能性はあるが、同じ問題において高段階に比べて「考える量が少なく、動く量が少ない」。公式が挙げている段階は、省エネから徹底まで大まかに5段階である(Claude Codeの画面ではマルチエージェント権限と結びついたultracodeのような入口も見られるが、それは製品側の組み合わせであり、API段階名がもう1つ増えたわけではない)。
タスク固定:「本番のログインインターフェースがときどき500を返す、調べて。」下記の5段階は公式のlow → max順に並んでいる;バーは相対的な高低を表すのみで、実測のtoken数ではない。デフォルトはまずhigh(APIがeffortを設定しない場合の挙動段階)を見る。
原文の提案:ほとんどのタスクでは直接そのモデルのデフォルトeffortを使う。デフォルトはチームが「大多数の人がこの種のタスクにどれだけのtokenを費やす気があるか」と考えた段階である。それを全体的な好みの手動上書きとして扱う:長期的に速さが欲しい、あるいは長期的に節約したいときにだけ動かせばよく、タスクごとに毎回調整する必要はない。もう1点:Opus 4.8のデフォルトeffortはチームのテストにおいて、Opus 4.7のデフォルトと近いtoken量を使いながら、効果はより良い。上げてもいい加減にこなし、読み漏らし・検証漏れがあるなら、それこそ「本気を出していない」シグナルである;単純な文言修正なのに毎日maxを使うのは、たいてい無駄である。
モデルが変えるのは「何を知っているか」、effortが変えるのは「どれだけやるか」
モデルが大きいほど、業界でよく使われるベンチマークによれば、能力はより強い。この点は原文でも率直に認めている。effortは「できるかどうか」を変えるのではなく、「この一回をどこまで徹底的にやるか」だけを変える。
effortが高い:自分で読み、自分で検証し、自分で推し進めてから提出する気になる。effortが低い:自分でtokenを費やして推測するより、先にあなたにコンテキストの補足を求める気になる。
あなたがEnterを押した瞬間から、リクエストの中で何が起きているのか
Claude Codeはあなたのメッセージ、システムプロンプト、ツール定義、CLAUDE.md、対話履歴、現在のコンテキスト内のファイルをまとめて1回のAPIリクエストとして送信する。

モデルは直接「中国語の文を読む」わけではない。サーバー上でまずtokenization(トークン化)を行う:テキストを小さな断片に切り分け、各断片を語彙表内の整数にマッピングする。原文の例:constは1978かもしれず、awaitは4293かもしれない。この瞬間から、プロンプトはモデルにとって一連の整数になる。

モデルの仕事は:現在のこの一連のtokenに基づいて、語彙表内のあり得る次のtokenそれぞれに確率を付け、そこからサンプリングすることである。「const x = await」の後ろでは、「fetch」の確率は高くなり、「banana」はほぼゼロになる。

入力を確率に変えるのはweights(重み/パラメータ)である:訓練時にモデルに書き込まれた、数十億規模に及ぶ行列の数値である。1つのtokenを予測するとは、入力をこれらの行列上で一連の長い演算にかけ、末尾の確率を読み取ることである。重みの中にはモデルが「知っている」ものが入っている;推論時、重みは読み取り専用である。あなたのprompt、CLAUDE.md、コンテキストはどれも重みを変えることはできず、次の予測を「誘導」しているだけである。

TypeScript、一般的なフレームワーク、一般的なプログラミングの常識は、すべて訓練時に重みに書き込まれたものである。あなたの実際のコードをコンテキストに入れることは、steering(誘導)である:この一回のリクエストには非常に有効だが、重みに新しい知識を「教える」わけではない。訓練時にまだ存在しなかったライブラリは、重みの中にはない;ドキュメントを貼ってそれを使わせることはできるが、影響するのはこの一回だけである。幻覚も、重みが「正しそうに見える」token列を生成しているだけであり、表を引いて失敗しているわけではない。
したがってモデルを変えるとは=別のセットの凍結された重みに切り替えてあなたのリクエストを処理することである。モデルも一度に段落全体の答えを書き出すわけではなく、token単位で予測している:1つ書き出し、シーケンスの末尾に繋げ、また一続き全体を再計算して次を出す。200 tokenの返答=重み上を200回歩くこと。待ち時間と出力費用の多くは、このループから来ている。

モデル設定はさらに出力token1つあたりの単価も決める。それが直接「何個のtokenを生成するか」を決めるわけではない。同じ一言のプロンプトでも、Claudeがどれだけの作業をすると決めるかによって、出力量は大きく変わりうる。その部分を制御しているのが、effortである。
思考すること、ツールを呼ぶこと、あなたに話すこと、すべて同じ種類の出力token
Claude Codeが作業をしているとき、吐き出されるtokenは大まかに3種類に分けられる:思考(streamingで見える推論)、ツール呼び出し(Read/Editなどの構造化されたブロック)、あなたへの発言(計画、進捗、まとめ)。
3種類はすべて同じ生成ループ内の普通の出力tokenであり、同じ料率で課金される。思考tokenはこのラウンドの後続のコンテキストに残る:コードを書くとき、より早い段階の推論はすでに「読んだファイル」のように入力に組み込まれている。

effortの等級はリクエストの一部としてモデルに送られる。モデルは訓練の中で各effort段階でどう振る舞うべきかを学んでおり、これらの挙動も凍結された重みの中に書き込まれている。本番では、effortはモデルが応答すべきもう1つの入力にすぎず、あなたのプロンプトと同様に:どれだけ徹底的に、どれだけ確信を持てて初めてタスク完了と見なすかを規定する。毎ラウンド改めて重み付けが行われる;より高い確信度には通常より多くのtokenがかかる。

高effortのとき、Claudeはよく先に計画を書き、しかも計画はより深く、より広くなる。計画は固定されたものではない:ツールの結果が返ってくると、「どこまで進んだか、結果にどれだけ確信を持てるか」を更新する。デバッグ計画の中の3つの仮説のうち、最初の一歩でバグが見つかれば、たいてい残り2つは不要だとはっきり述べ、タスクリストも途中で書き換えられる。
高effortはまた、もう一段検証したがる:すでに答えを見つけていても見直したり、本来なら飛ばせるはずの仮説を依然として一通り確認したりする。ただし原文が強調しているのは:訓練時に「考えすぎ」を特に監視しており、effortを最大にしたからといって単純なタスクで無理に使用量を水増しすることはない;使用量を水増しすれば実際の効果を損なうからだ。
普段どう段階を調整するかは上文「まずeffortを理解する」を参照;ここではメカニズムのみ補足する:段階はリクエストの入力として、プロンプトと同様に凍結された重みが学んだ挙動に入っていく。
まずコンテキストを確認し、それから「できない」のか「本気を出していない」のかを見分ける
Claudeがしくじったとき、最初の反応は設定を変えることではなく、あなたが何を与えたかを見るべきである:プロンプトが曖昧でないか、ツールが正しいか、スキルが揃っているか。
もし高effortにすべきでないタスクで無理にeffortを上げているなら、問題は通常もっと上流にある:コンテキスト、CLAUDE.md、タスクの分割の仕方である。
コンテキストがすでにはっきりしているのにまだ間違えるなら、この一言を問いかける:
それは十分にできないのか、それとも十分に本気を出していないのか?

問題自体が難しい:見えにくいバグ、不慣れな領域、アーキテクチャのトレードオフ。小さいモデルにさらにコンテキストを詰め込んでも依然として自信満々に間違えるなら、より大きいモデルに切り替える。大きいモデルは曖昧さにもより耐えられる;小さいモデルは実行手順を固定して書けるような指示により適している。
- 大きいモデルを使うべき:難しい、曖昧、繰り返し自信満々に間違える
- 小さいモデルを使うべき:機械的な変更、コンテキストにすでに答えがある、記述が正確な定型作業
読むべきファイルを読んでいない、走らせるべきテストを走らせていない、見直すべきものを見直していない。特にあなたがeffortをデフォルトより低く設定したときに最も関係が深い。
- effortを上げる:明らかに手を抜いている、検証漏れ、途中で提出してしまう
- 上げない:コンテキストがひどい、タスクが曖昧、まず上流を直す
専門医、専門家、総合診療医:誰が担当するか、そしてどれだけ時間をかけるか
著者が使った例え:Fableはほとんど他の人が手に負えないときに呼ばれる専門医;Opusは専門家;Sonnetは非常に強い総合診療医である。effortは彼らがあなたのこの案件にどれだけ時間をかけるかを決める。
他の人が行き詰まったときに呼ばれる。低effortでも他の人には見えないポイントを見抜ける。単価は最も高く、本当に必要なタスクのために取っておく。
低effortは専門家と5分間話すようなもの:コードベースの外にあるパターンや落とし穴は元々備えているが、ざっと目を通すだけで、ファイルごとに細かく掘り下げることはしない。
高effortは総合診療医が午後いっぱい時間をかけるようなもの:プログラミングの基礎がしっかりしていて、読み、走らせ、見直すことができ、あなたのこのコードを徹底的に理解する。
モデル設定≈どれだけ有能か;effort設定≈どれだけ徹底的か。universally better(普遍的に優れた)組み合わせは存在しない。多くの実際のタスクでは両方が少しずつ必要になる:Opusの低effort≠Sonnetの高effortの単純な代替であり、Fableも日常のデフォルトではない。
簡単なタスクと非常に難しいタスクでは、請求のロジックが逆転する
モデル、effort、token消費がどう絡み合うかは、タスクが難しいかどうかにかかっている。
定型作業、同じeffort
大小のモデルはどちらも一般的に正しくこなせる。大きいモデルはよく数ステップ多く検証を行い、tokenがより多く、しかも単価がより高い。したがって定型的な段階では小さいモデルに下げることで、実際にお金を節約でき、品質もたいてい損なわれない。

難しい多段階の作業
小さいモデルは能力の上限付近で粘り強く食い下がる必要があり、反復に費やす量が多い;大きいモデルはより少ないステップ数で同じ品質に到達できる。単価はより高いが、1タスクあたりの総コストはかえって低くなることがある。より重要なのは:一部の作業は大きいモデルでしかこなせず、effortを最大にしても小さいモデルを救うことはできない。
Fableは長時間・多段階のタスクで差を最も明確に広げる。チームのテストでは、Opus/Sonnetがどのeffortでも届かない作業をこなすことができる;単価も最も高いので、本当に必要な作業のために取っておくべきである。

effortはClaudeが曲線に沿ってどこまで進む気があるかを決めるが、必ずそこまで進んでから切り上げるという意味ではない。effortは使用量を形作るが、ハードな天井ではない。システム内で本当のハードな打ち切りはmax_tokensである:ぶつかると途中で切断され、やや無骨で、主にAPI開発者向けである。より柔らかい制約、例えばtask budgetsや、プロンプトで簡潔さを求めることは、訓練を通じて従うようになったガイドである:上限に近づくと収束する傾向があり、壁にぶつかるわけではない。
| シナリオ | よりお得な傾向 | 理由(原文に基づく) |
|---|---|---|
| 定型的で、記述が明確な変更 | より小さいモデル+デフォルトeffort | どちらも正しくこなせる;大きいモデルは検証が多く、単価が高い |
| 難しい、多段階、曖昧 | より大きいモデル、effortはデフォルトか必要に応じて上げる | 少ないラウンドで品質ラインに到達;総tokenがより少なくなることもある;一部の作業は大きいモデルでしか届かない |
| 明らかな読み漏らし・検証漏れ | まずeffortを上げる(特にデフォルトより低いとき) | 問題は徹底性であり、重みの中の知識ではない |
| 小さいモデルが自信満々に間違える、コンテキストはすでに十分 | より大きいモデルに換える | 問題は能力の上限であり、もう何度か読み直すことではない |
一言で覚えて、またつまみを調整しに戻る
effortが変えるのはClaudeがどれだけの作業をするかであり;モデルが変えるのはClaudeが何を知っているかである。
結果に満足できないとき:まずはっきりしたプロンプト、正しいツールとスキル、そして自己検証の経路を与える。それでも合っていなければ、また問う:できないのか、それとも本気を出していないのか?できないのはモデルの問題、本気を出していないのはeffortの問題である。
「Effort changes how much work Claude does. The model changes what Claude knows.」
どちらも「答えを良くする」ように見える2つのつまみ:1つは「できるかどうか」を、もう1つは「どこまでやる気があるか」を司る
Claude Codeチームが混同しやすい設定のペアを解きほぐす、モデルを変えるのはその頭脳を変えること、effortを調整するのはこの一回でどこまで徹底的にやる気があるかを変えること。1ページ、図付きで語り尽くす。
↓ 1ページで読み終える・動く図が1枚あります
Claude CodeはAnthropicがプログラマー向けに提供するAIコーディングアシスタントである(パソコンのターミナルの中であなたのコード作成やバグ調査を手伝う)。それには調整可能な2つの設定があり、調整するとどちらも「答えが良くなった」ように感じられ、同一のものと混同しやすい。
1つが変えるのはそれが「何を知っているか」で、もう1つが変えるのはこの一回で「どれだけやるか」である。
どのセットの「凍結された重み」(モデルの訓練が終わると固定され、推論時には読み取りしかできず変更できない大量のパラメータで、それが「知っている」ものが詰まっている)を使うかを変える。モデルを変える=より強い、あるいはより弱い頭脳に換えること、能力、知識、どれだけの落とし穴を経験したか。
同じ頭脳で、この一回の作業でもっと多くのファイルを読む気があるか、テストを走らせるか、見直すか、自分でどこまで推し進めるか、それともすぐに止まってあなたに聞くか。それが司るのは「どこまで徹底的にやるか」であり、「より長く考える」ことではない。
高effort:「ログイン関連のコードを何か所も読み、偶発的なエラーを再現し、テストを走らせて確認した、根本原因は接続タイムアウトでリトライしていなかったこと。」
同じ一言を与えても、「どれだけやるか」は大きく異なりうる。では、いったい何段階に分かれているのか?
小互がClaude Codeにあるバグを調べさせる:「本番のログイン機能がときどき500を返す(サーバーエラー、ユーザーがログインできない)。」同じバグで、effortの5段階それぞれがどれだけの作業をするか、
「tokenをより多く消費する(モデルが文字を処理する最小単位)」には体感がないが、お金に換算すれば体感できる:同じバグで、高effortは低effortの約7倍のtokenを消費する、余分にかかったお金は、それが自分で読み終え、検証し終え、見直し終えることと引き換えであり、パッチを1つ投げてまたあなたに聞き返すのとは違う。
animateMotionでトラックに沿って走る、段階が高いほどトラックが長く、走る時間も長くなり、「徹底的なほど遅く、より高くつく」ことが一目でわかり、④の7×と呼応している。シナリオは終始、小互が「ログイン500」を調べる設定にかけている。
- **④は数字の整合性**:トラックのバーは84%対12%で、割ると≈7になり、数字カードの「約7×」と辻褄が合う;op-race-noteの中でこの7×は原文の模式図であり実際のbenchmarkではないと明記し、「どの話を全部信じてはいけないか」をこの1行+why枠に凝縮し、単独の締めくくり注釈セクションは設けていない。
- **コスト反転、役割の例え**:コスト反転は④のwhyの一文に折り込んだ;役割の例え(Fable/Opus/Sonnet)は本文で展開すべき詳細だと判断し、一枚でわかるページでは画面をはみ出さないよう単独のセクションは設けていない、もしそれも一枚でわかるページに登場させたいなら、②か④に軽く1行加えることができるので、教えてください。
これをjiedu-explainerの入庫パスに接続しましょうか(この記事の一枚でわかるタブに書き込んでサイトを再構築する)?それとも、まずプレビューでアニメーションが正しいか見てから決めますか。
調べて!
ダメならログを送って。
結局どっちを回せばいいの?
さすがに大丈夫でしょ!
まま提出された!
もっと大きいモデルに換える。
effortを上げる。
- × あの7×は、原文自身が描いた模式図
- × コストカーブは、実際のテストではない
- × 第三者による再現もされていない
つまみを回す。
effortが変えるのは「どれだけ作業するか」