Anthropic 官方支招:Claude Fable 5 当“顾问”,Claude Sonnet 5 干活能扛下账单大头
- Anthropic 官方开发者账号 @ClaudeDevs 于 2026 年 7 月 7 日分享了团队内部常用的两种 Claude 多模型协作模式:顾问模式、编排模式。
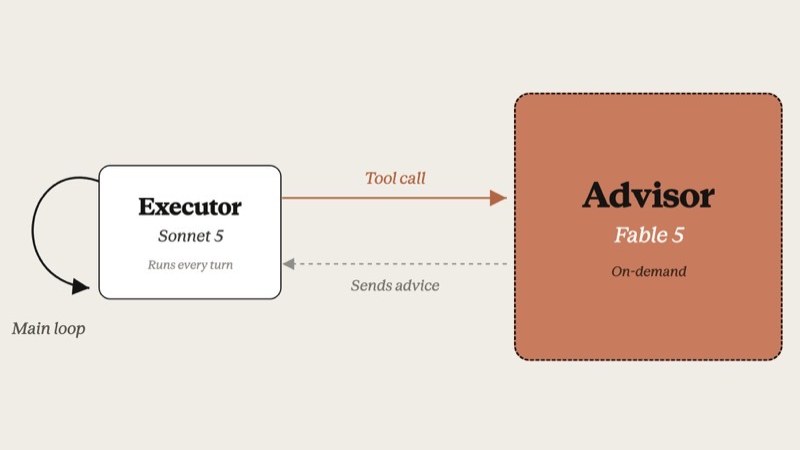
- 顾问模式:执行模型 Claude Sonnet 5 遇到关键判断才调用顾问模型 Claude Fable 5。在 SWE-bench Pro 上,这套组合以 Fable 5 约 63% 的成本,拿到了它约 92% 的得分,Fable 5 平均每个任务只被叫一次。
- 编排模式:Claude Fable 5 当编排者拆解任务、把活派给工作者 Claude Sonnet 5 子代理并行干。在 BrowseComp 上,这套组合以 Fable 5 约 46% 的成本,拿到了它约 96% 的得分。
- 两种模式背后都是 Anthropic 官方的 Claude Managed Agents(多智能体会话)能力:顾问模式对应一个具体的 beta API 工具(advisor tool),编排模式对应多智能体协调功能,均有官方文档和示例代码,不是团队自己拼出来的土办法。
- 子代理和顾问各自占独立的会话线程,线程本身是持久的,重复找同一个子代理追问,不用把整段历史重新喂一遍再全额付费。
这条建议是谁给的
Anthropic 面向开发者的官方账号 @ClaudeDevs,2026 年 7 月 7 日分享了团队内部常用的两套 Claude 多模型协作模式。
顾问模型和干活模型怎么分工
顾问模式不是团队自己攒的土办法,而是 Anthropic API 里一个正式的 beta 功能,advisor tool。执行模型 Claude Sonnet 5 拿到任务后自己往下做,只有走到需要拿主意的节点,才向顾问模型 Claude Fable 5 请教一次,拿到判断后接着把任务做完。
顾问、执行双模型分工:让更高阶的 Claude Fable 5 只负责“出主意”,不负责“写内容”;真正消耗大量 token 的生成任务全部留给费率更低的 Claude Sonnet 5,账单大头因此落在执行模型的价位上。
这不是靠你自己的代码手动发两次请求拼出来的:在 tools 里声明一个 advisor_20260301 类型的工具、指定顾问用哪个模型,剩下的全由 Anthropic 服务器端接管,执行模型像调用普通工具一样决定何时请教,服务器另起一次顾问模型的推理,顾问看到的是执行模型到当前为止的完整对话记录(含系统提示、工具结果、已经写出的内容),给出判断后原样塞回执行模型的对话里,执行模型带着这份建议接着写。全程在同一次 API 请求里完成:
response = client.beta.messages.create(
    model="claude-sonnet-4-6",
    max_tokens=4096,
    betas=["advisor-tool-2026-03-01"],
    tools=[
        {
            "type": "advisor_20260301",
            "name": "advisor",
            "model": "claude-opus-4-8",
        }
    ],
    messages=[{"role": "user", "content": "Build a concurrent worker pool in Go with graceful shutdown."}],
)
模型搭配有硬规则:顾问必须至少和执行模型一样强,不能反过来。文档给的两个典型配法,已经在用 Sonnet 跑复杂任务的,配 Fable 5/Opus 当顾问换质量提升;已经在用 Haiku 但想要更聪明一点的,配 Opus 顾问,成本比把执行模型直接换成大模型低。

为什么便宜:顾问的输出通常只有 400 到 700 个文本 token(算上思考过程也就 1400 到 1800 token),它只负责给一句关键建议,不负责把最终答案从头写到尾;账单上,顾问调用按顾问模型的费率单独计入 usage.iterations[],不会并进执行模型的总数里。原帖里"Fable 5 每个任务仅被罕见调用(约一次)",说的就是这套省钱逻辑的落地效果。
官方给的最佳实践是:该在动手写之前叫顾问,而不是写完了才回头问。针对 Haiku 执行模型容易"该问的时候没问"的问题,Anthropic 给了一段系统提示模板(提醒模型在写文件、下判断、卡壳时主动请教顾问),在内部编程基准上把 Haiku 的通过率提高了约 7.5 个百分点,这是一个有实测支撑的具体数字,不是泛泛的建议。
另一种分工:不咨询,直接分派任务
顾问模式里 Fable 5 全程不碰活,只在被问到时说一句话;编排模式不一样,Fable 5 一开始就当“编排者”,把任务拆成几块,分派给多个 Sonnet 5“工作者”子代理去并行干,自己只管规划和汇总结果,不亲自动手。

这套编排能力同样有正式的官方支撑,Claude Managed Agents 的多智能体会话功能。定义一个“编排者”agent 时,用 multiagent 字段声明它能调度的花名册(最多 20 个 agent,只能往下派一层,不能一直嵌套):
coordinator = client.beta.agents.create(
    name="coordinator",
    model="claude-opus-4-8",
    tools=[{"type": "agent_toolset_20260401"}],
    multiagent={
        "type": "coordinator",
        "agents": [{"type": "agent", "id": research_agent.id}],
    },
)
session = client.beta.sessions.create(agent=coordinator.id, environment_id=environment.id)
每个工作者子代理都在自己独立的“会话线程”里跑,有自己的模型、系统提示、工具配置,彼此互不干扰(最多支持 25 个并发线程)。官方文档总结了三种适合往下派活的场景:并行拆解(同时分头查多个信息源、分析多个文件,编排者最后汇总)、按专长分派(把安全审查、写文档这类活交给对应领域的专精 agent,而不是让一个 agent 什么都干)、能力升级(只把一小部分特别难的子任务,临时升级给更强的 agent 处理)。
Anthropic 官方 cookbook 里有一个具体到能跑的例子,叫“协调者模式”(CMA_plan_big_execute_small.ipynb):任务是核对 10 个国家公园、共 20 条事实是否与官方信源一致。一个顶级模型独自读完所有网页来核对,和让顶级模型只管拆题、把读网页的苦活派给多个便宜的工作者子代理并行干,效果对比:
官方跑出来的结果:分工团队比单打独斗便宜约 2.5 倍、快约 3 倍。但 notebook 也老实交代了四条踩坑经验,都是实测出来的,不是场面话:
notebook 也给了什么时候不该用这套拆法的判断:如果问题本身信息量小、没多少东西可查,硬拆成编排+工作者只是白付一次编排者的往返成本;如果编排者压根没委派任务、自己凭记忆就答了,等于白花一次顶级模型的钱;如果任务需要顶级模型亲自读懂原始材料里的微妙之处(不是简单核对事实),便宜的工作者子代理可能会在总结时把关键信息弄丢。

为什么重复调用不用重新全额付费
原帖提到"每个子代理都保留自己的缓存",这句话背后对应两层具体机制,顾问模式和编排模式各有一套。
编排模式这边:每个工作者子代理都跑在独立的会话线程里,线程本身是持久的,编排者过一会儿再回头找同一个工作者追问,那个工作者记得自己之前干过什么、说过什么,不需要把整段历史重新喂一遍才能继续对话。
顾问模式这边有更具体的开关:advisor 工具支持独立的 prompt caching,因为顾问在同一段对话里被多次请教时,它看到的转录内容前缀是稳定的(第 N 次请教=第 N-1 次的内容后面多一段),开启缓存后,重复的那部分只按缓存命中价计费。官方给的经验值是:一段对话里顾问被叫两次以下,开缓存反而不划算(写缓存的成本比省下来的还高),大概到第三次调用才开始回本,长对话、多轮请教的场景才值得开。
顾问模式还是编排模式,看哪个条件
两种模式都是"让更强的模型少干活、把体力活让给便宜模型",区别在于强模型到底"要不要接触活本身"。
| 顾问模式 | 编排模式 | |
|---|---|---|
| 强模型的角色 | 不写内容,只在被问时给一句判断 | 不写内容,但主动拆任务、派活、最后汇总 |
| 适合的活 | 一条主线任务,中间有少数几个关键判断点 | 能拆成多个相对独立的子任务,可以并行干 |
| 触发方式 | 执行模型自己决定"要不要问" | 编排者一开始就规划好"谁干哪块" |
| 对应的官方能力 | advisor tool(beta 工具) | Managed Agents 多智能体会话 |
任务本身是一条主线(比如一段连续的代码改动、一次持续对话),生成量大,但真正需要更强判断力的岔路口只有少数几个。
任务能天然拆成几块互相独立、可以同时进行的子活(比如同时核对多条信息、分头分析多份文件),拆完之后需要有人汇总。
顾问模式像团队里请了一位资深顾问:不参与日常写材料、发邮件,只在关键决策点被叫进会议室问一句"这个方向对不对";编排模式像项目经理带一组实习生:经理自己不下场干活,而是把任务拆成几份分给不同的人同时做,最后自己汇总检查。两种安排里,团队整体成本都主要落在薪水更低的那一边。
想试试看,从哪一步开始
两种模式的最小实现都只要三步,挑跟自己场景匹配的那一套先试。
tools 里加一个 advisor_20260301 工具、指定顾问模型(必须≥执行模型能力),默认让执行模型接手任务从头做到尾。multiagent 花名册,声明它能调度哪些工作者 agent;每个工作者独立配置模型和工具范围。把 Fable 5 当"顾问"用。执行模型(Sonnet 5)向它请教。大部分 token 按执行模型更低的费率计费。 @ClaudeDevs,2026 年 7 月 7 日(X)
- Claude Platform Docs · Advisor tool:顾问模式的官方 API 文档,含代码示例、计费细节、最佳实践
- Claude Platform Docs · Multi-agent sessions:编排模式的官方 API 文档,含 coordinator 配置方式
- GitHub · claude-cookbooks / CMA_plan_big_execute_small.ipynb:官方可运行的协调者模式实例(核对国家公园事实的真实成本对比 + 四条踩坑经验)
多模型省钱法:从「全用最贵的模型」→「贵模型只出主意,便宜模型干大头」
Anthropic 官方开发者账号支招两种搭法:谁出主意、谁打字分开,一页带图讲完钱省在哪。
↓ 一页读完 · 有一张会动的图
现在越来越多人用 AI 搭「能自己一步步把活干完的系统」(业内叫 AI agent)。搭的时候要挑用哪个模型,模型就是不同档次的 AI,越强越贵。最强的 Claude Fable 5 什么难题都接得住,但要是整批活从头到尾都靠它,账单很快就爆。
✘ 可让它一个字一个字从头写到尾:每个字都按最贵的价算。
一整批活里,绝大多数是不需要顶级判断力的「体力活」,全用贵模型干,等于花大钱买打字。
@ClaudeDevs 是 Claude 开发商 Anthropic 面向程序员的官方账号,2026 年 7 月 7 日给了个办法:贵模型只在该拿主意的时候出手,便宜的 Claude Sonnet 5 负责把大量内容写出来。
官方给了两种具体搭法,区别就在贵模型到底要不要碰活本身,一张图看懂。
两种搭法都让贵模型少干活。顾问模式:便宜模型自己往下干,卡在关键判断才问贵模型一句。编排模式:贵模型开头就把活拆成几块,派给几个便宜模型同时干,自己只管拆题和汇总。
官方拿两个公开测试量过账单。把「全程只用最强模型」的花费当作 100 块,看分工后各要花多少、成绩掉多少:
以上数字全部来自 Anthropic 官方自测,没有独立第三方复现。
全按最贵价打
又拿主意又打字
→ 全按贵价
Sonnet 5 打字干大头
→ 大头便宜
字便宜模型打!
(SWE-bench Pro)
没有第三方复现
让它只出主意;
体力活交便宜模型,
账单大头自然省