只换一层外壳:让 Opus 4.8 和 Fable 5 在 ARC-AGI-3 评测中冲到 99%
- ARC-AGI-3 是一类「不告诉你规则」的游戏:AI 只拿到一块 64×64 的彩色格子和几个能按的操作,没有物体清单、没有目标说明、没有奖励提示。今年 3 月刚上线时,最强的模型也只拿到 0.51 分。
- Schema 是一层外壳,不改模型的权重,只改「怎么用它」:让模型把每一局游戏的规则写成一段能跑的程序,拿之前记录的每一步去验证,通过后再在这段程序里搜索下一步。
- 公开的 25 局里,Opus 4.8 搭配 Fable 5 拿到 98.98 分,GPT-5.6 Sol 拿到 95.35 分。两个成绩都是团队自评,没经过 ARC Prize 官方核验。
- 同样是 Opus 4.8 加 Fable 5,换成原生的 Claude Code 外壳只有 42.83 分;只把外壳换成 Schema,就多了 56.15 分。
- 这个 99% 衡量的是步数效率:拿 AI 的步数去比人类第一次玩的步数(步数比的平方)。它意味着几乎每一局都用不输给人类的效率通关了,光解出来还不够。
一种不告诉你规则的游戏
Impossible Research(与加州大学伯克利分校、卡内基梅隆大学合作)发布了 Schema,一套让前沿模型像物理学家一样玩游戏的外壳。它挑战的是一个专门为难 AI 的测试,ARC-AGI-3。
ARC-AGI-3 会丢给 AI 一局游戏,但不解释它在看什么。每走一步,AI 拿到的只有一块 64×64 的格子(16 种颜色)和一组「现在能按哪些键」。没有物体清单,没有规则说明,没有写明的目标,也没有「这一步做对了」的奖励提示。想往前走只有一条路:像物理学家那样,一边动手一边猜规则,猜错了就改。
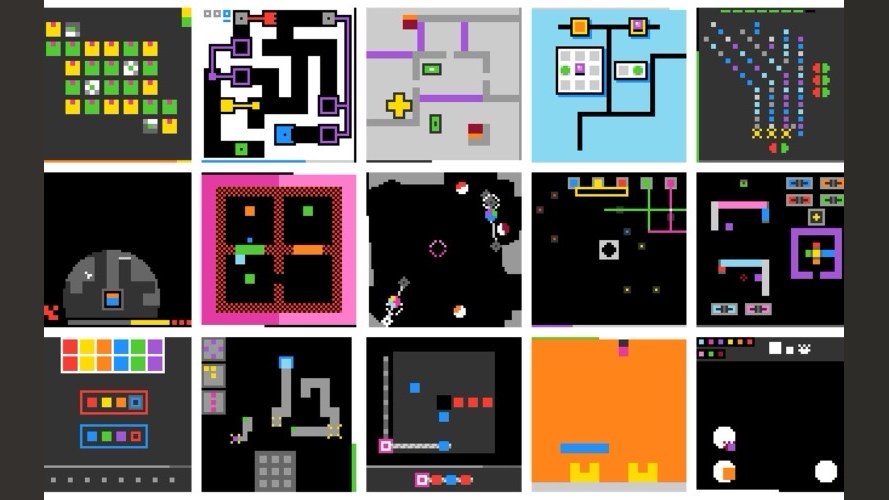
下面这张图,就是 AI 在 25 局公开游戏里真正看到的画面。每一格是一局,它得自己搞清楚:这一堆彩色方块里,哪个是我操纵的角色,哪些是墙,哪根条子在倒计时,怎样才算通关。

这个测试对前沿模型极其残酷。它的官方指标叫 RHAE(相对人类行动效率),拿 AI 每关用的步数去比一个第一次玩的人。今年 3 月刚上线时,经核验的前沿模型最高只有 0.51 分;到 7 月,最好的 GPT-5.6 Sol(开到最高推理档)在半公开集也才 7.78 分,公开集 13.33 分。作为参照,人类的行动效率就是满分 100。
变的不是模型,是「怎么用模型」。Schema 是一层外壳(harness):它只重新安排了画面怎么喂进去、模型怎么把观察变成一份对游戏的理解、这份理解怎么拿真实记录去验证、计划又怎么执行和修正。同一个 Opus 4.8 加 Fable 5,换掉这层外壳,公开分从 42.83 跳到 98.98。
99 分到底是什么意思
它不是「25 局解出了几局」的通关率。RHAE 衡量的是步数效率,而且带一个很重的平方惩罚。
算法是这样:每一关拿「人类的步数 ÷ AI 的步数」,再平方,上限 1.15。一局游戏里越靠后的关卡权重越高(从 1 递增到 n);而且有个和权重挂钩的完成度上限,只要有一关没通,这一局就拿不到满分。所有在游戏里真正按下去的操作,包括为了试探而走的探索步,全都算进 AI 的步数里。因为是平方,多花的步数会让分数掉得很快。
所以同样是「差不多都通关」,效率不同,分数可以天差地别。原文给了一组对照:
7 关全通,一共 785 步,和人类基准的 776 步几乎一样。既通关又没浪费步数,拿到接近满分。
前 6 关就用掉 1591 步,是对应人类基准的 2.7 倍,第 7 关还没通。平方惩罚加上没通关的上限,分数压到 14 分以下。
所以这 98.98 分,是「完成度」和「步数效率」两件事一起打出来的综合分,不等于解题率。它逼着 AI 不光要会玩,还得玩得跟熟练的人一样省。
像物理学家一样思考
物理学家在写下一条定律之前,得先决定「这条定律是关于什么的」:一堆观察里,哪些东西算「物体」,哪些属性定义了「状态」。定了这个,才谈得上「状态怎么变」。Schema 把这拆成两个必须一起解决的问题。
第一个问题叫状态接地:把生的画面变成能追踪的物体、变量和关系。没有任何东西告诉 AI 哪块像素是它自己、哪块是墙、哪块是「还剩几步」的计数条,它得自己认。第二个问题叫机制发现:找出这些状态在某个操作下怎么变,并把这条规则写成一段能真正运行的程序。
关键在于,这两个问题不能分开解。一个看起来说得通的状态表示,可能在后面的实验里露馅:怎么都找不到一条一致的规则去解释接下来的结果。这时候,光改规则不够,得改「状态到底是什么」。
潜在的世界表示是一段程序,不是一团向量。因为是程序,它就同时具备三种性质:能读(一份你能打开、能 diff 的文本文件)、能验证(拿记录下来的真实过程一条一条重放)、能搜索(一段程序就是一个模拟器,在里面做规划不花任何真实代价)。
当迈克尔逊和莫雷测不到光「应该」振动所在的那种介质(以太)时,洛伦兹选了第一条路:保留以太,给规则打补丁,用收缩假设去吸收这个测不到的结果。爱因斯坦选了第二条:直接把以太从「状态」里删掉,让同时性变成相对的,预测老是失败时,物理学家动的常常不只是定律,还有「状态本身是什么」。Schema 允许 AI 做同样的事:改表示,或改规则,然后回过头把另一边补一致。
先写程序,验证过了才动手
光有一份程序还不够,Schema 对「怎么用这份程序」下了很死的规矩。它跑一个四步的外循环:观察 → 熟虑 → 执行 → 记录。
记录(record)是系统不可更改的交互史。AI 可以随时修改自己的假设和笔记,但它改不了已经收到的画面、也改不了已经按下去的操作。这条只增不改的时间线,是唯一的真相基准。
每一次熟虑,AI 都在更新它对游戏的理论,也就是那段 step(state, action) 程序。它用 run_backtest 拿这段程序去对完整的交互史,哪一步预测和真实对不上,就用这个不匹配去定位错误;再用 run_bfs 在这个模型里搜出一条路线,把结论写进笔记。这些操作没有一个会碰到真实环境,只有 commit_actions 才把动作发给游戏,把「内部建模和搜索」跟「对外真实交互」彻底分开。
执行计划时,每一个真实的转变都拿去和理论的预测比对。只要有一处对不上,就立刻停下当前计划,把这个反例带回熟虑,必须先把模型改到能解释它,才能重新规划。模型永远不许凌驾于它见到的现实之上。
还有一个反直觉的地方:AI 不只是为了通关而行动,也会专门为「搞清楚隐藏机制」而行动。当有好几条候选规则都还和历史对得上时,它会去找一个能把它们区分开的实验:一个这些规则会给出不同预测的操作,按下去,比对结果,更新 step()。因为 RHAE 对多余步数是平方惩罚,最好的实验恰恰就是「用最少的真实交互,消除最多的不确定」。一旦 step() 能重现历史里的每一步转变,接下来的解题就搬进模型里搜索,不再花额外的真实步数。
一段真实轨迹:LS20,642 步 vs 人类 780 步
AI 观察到一块 64×64、16 色的格子,操作 0–4:一个加号形状的精灵、一个青红相间的方块、一个带框的栗色符号、一根 11 号色的长条。它在笔记里推断:自机是那个 5×5 的青红方块(加号精灵是静止的),长条是「移动预算」,只在移动成功时才减少。
它写出 step(),回测重放了记录里的 36 步转变、全部对上。接着提交一串动作,结果出乎意料:77 个格子预测错了,方块把指示器重新涂成了栗色,计划作废。它把「重涂」这条规则补进模型,回测转绿,再用 run_bfs 找到最短路线,升级。就这样过了 7 关:642 步,对比人类 780 步的基准,这一局 RHAE 拿到 100。
换个用法,同一个模型从 43 分到 99 分
要证明「99 分是外壳的功劳,不是模型换强了」,得做受控对比:模型固定不动,只换外壳。原文用同样的 Opus 4.8 加 Fable 5 做了这件事。
把最终那份 Claude Code 的原生草稿快照当成基线输出,成绩是 42.83 分;同样这对模型,套上 Schema,拿到 98.98 分,净涨 56.15 分。
Claude Code 本身是个很强的通用外壳,擅长文件操作和长上下文管理,原则上它能模仿 Schema 的流程,但它不强制模型这么做。在通用外壳下,模型直接对游戏出手,也可以把自己的判断一直含在上下文里、不落成代码。Schema 则硬加了三条约束:
| Schema 强加的规矩 | 它堵住了什么 |
|---|---|
把当前世界模型编码成一段能跑的 step() 程序 | 不许把理解只含在上下文里、说不清道不明 |
| 拿它对着每一条记录下来的转变验证过,才能用来规划 | 不许用没验证的臆想去搜索 |
动作只经 commit_actions 发出,预测一错就立刻丢掉剩下的计划 | 不许带着已经错了的模型继续走 |
在这个受控配置下,Schema 相对 Claude Code 基线带来 56.15 分的提升。换 GPT-5.6 时,Schema 的 Sol xhigh 与 Sol max 搭配拿到 95.35 分,但要注意,它最接近的官方参照(Sol max 公开 13.33、半公开 7.78)并不是同一个外壳的对照实验,所以图里那 82 分的差距是「参考」而非受控测出来的增益。
把 25 局逐一看:Claude 这套保留的结果里,14 局用 Opus、11 局用 Fable,其中 19 局正好满分 100;Sol 这套里 20 局满分。剩下没到 100 的那几局,分数集中在 89 到 99 之间,差距很小,而且很集中。
把「东西是什么」认对,就赢了
效率到底从哪来?原文给了两个观察,也顺带露出了 Opus 4.8 和 Fable 5 在这套外壳下的真实差别。
观察一:认对了程序,行动就变省
在 AI 归纳出「能精确重现全部历史」的程序世界模型的那 14 局里,它用的步数是人类参照的 1/1.6 到 1/5。原因是花钱的地方变了:真实步数只在「发现某条机制」时付一次,之后就在模型里免费规划,而不是靠反复试错重新发现同一条机制。人类越觉得难的地方,这个优势越明显:在 M0R0 第 4 关,人类要 500 步,AI 只用 42 步。
RE86 这局把整套流程走全了:run_backtest 把模型对着 393 条记录逐条重放、全部精确对上,验证过的模型再交出一条计划,一整关不靠任何额外试错就清掉:61 步的单次计划,执行时零预测错误,直接赢。这种「一次操作里核对几百帧精确画面」的能力,在无辅助的人类玩法里没有对应物。

观察二:Fable 更早去怀疑「东西认错了」
在两个模型都尝试过的游戏上比 Opus 4.8 Max 和 Fable 5,Fable 拿到更高的 RHAE,靠的是两种方式:有的局它发现的模型能通 Opus 通不了的关;有的局两者都通,但 Fable 用更少的真实步数到达同一个终点。
成对的轨迹指向同一个解释:一次预测失败之后,Fable 更常去质疑「表示法本身」,识别出真正要紧的那个不确定,然后挑一个「不同假设会给出不同结果」的操作去试,再把观察变成一条可复用的规则。Opus 往往最后也能发现同一条机制,但要先在它现有的表示法里,多花些步数去测各种目标、条件、配置。
不纠结目标逻辑,先去试那个被当成装饰的物体本身能不能动。
注意到同样的矛盾,却在旧表示里反复修目标,绕了很久才认到同一条机制。
在 FT09 这局,棋盘满足了当前的目标逻辑却不推进,Fable 转而去试一个更基本的问题:那个被当成装饰的「检查器」本身能不能点?一点,露出一个「点一下会翻转自己和上下左右邻居」的十字按钮。Fable 把这个观察写成代码,11 步后清关,下一关 13 步搞定。Opus 注意到了同样的矛盾,却又花了大约 240 步去测别的目标状态解释,直到第 287 步才去戳那个检查器、记下同一条隐藏机制。两个模型都能表达、也都能用这条规则;差别只在于「谁更快挑到那个让缺失线索现形的实验」。
AI 承认「我把这个方块的模型整个搞错了」,换成「方块随自机的携带状态变化」的规则那一刻,误预测从每关几十个塌缩到 4 个。此后第 5、8、9 关,它只用人类步数的 1/4 到 1/6,同一个模型一路复用,不再重新发现。
在第 2 到第 4 关,它把方块当成「能直接操纵的物体」,步数比人类还多。新观察不断和这个模型冲突,每次冲突都逼它去做更多真实实验。
三个案例落到同一句话上:一个通用的机制,并不意味着「从不改变」;它指的是那种「每次修改都保住了先前的解释框架、并且压低了新关卡的代价」的机制。搜索只在它所依据的世界模型之内才算完备:一旦缺的那个物体、状态变量或转变被表示出来,现成的验证器和规划器往往就够了;可要是观察分不清哪个才是对的表示,同一套机制也会去验证并穷举一个错的表示。
一个新的起点
ARC-AGI-3 是这个飞速演进的领域里一个重要的基准。3 月它上线时,领先的前沿 Agent 只有 0.51 分;到 7 月,最好的官方 Sol Max 在公开集到 13.33、半公开集 7.78,而自评结果一度爬到每局 RHAE 均值 58.12 分。
Schema 自评的 98.98 分,是这条轨迹的延续,不是断裂。原文自己把话说清楚了:这里每一个数字都只在 25 局公开游戏上测过。Sol max 提供了唯一一个跨评测集的官方校准点(公开 13.33 对半公开 7.78),但这不足以把一个接近满分的公开成绩往半公开集上做数值外推:公开的 98.98 到了半公开会变成多少,在测出来之前无人知道。可拿到的运行材料只记录了公开集,所以这篇发布没有做「固定外壳」或「留出集表现」的声明。另外,两个成绩都是自评、未经 ARC Prize 独立核验,图里的 Sol 曲线也是在完整评测材料发布前、从原始图表起出来的暂定值。
研究者把一个被刷到饱和的 ARC-3 读成一个新的起点:让「机制发现」成为一种通用能力:通过行动与感知的智能体循环,去把一个世界的因果结构接地,而这个世界,要比 64×64 的格子丰富得多。那是他们想去的方向。
关键的原料其实早就在冒头:能适应陌生环境的前沿模型、编程智能体外壳、以及程序化的世界模型。Schema,是把它们拢到一起的那套系统。 Impossible Research,Schema 发布博客
玩没有说明书的游戏,AI 换了个玩法:从「边玩边猜」→「先写成程序、验证过才动手」
Impossible Research 做了一层叫 Schema 的外壳,不碰模型、只改用法,就让同一个 AI 在公开 25 局上自评冲到 99 分,一页带图讲清它怎么做到。
↓ 一页读完 · 有一张会动的图
ARC-AGI-3 是一类专门为难 AI 的游戏(一个测 AI 会不会「自己摸规则」的测试):屏幕只给一块 64×64 的彩色格子和几个能按的键,不告诉你目标是什么、哪个方块是你、按下去会怎样,全靠边玩边猜。
它有多难?今年 3 月刚上线,最强的模型也只拿到 0.51 分;到 7 月,最好的成绩也才 13.33 分(满分 100,是一个第一次玩的人的水平)。
✘ 一碰上「不给规则」的游戏就几乎抓瞎
因为它们习惯直接上手,把猜到的规则含在脑子里,走错了也接着走,不回头逐帧核对,一条错规则一路带到底。
Schema 是一层「外壳」(harness,指不碰模型本身,只安排画面怎么喂进去、让它怎么想、决定怎么变成动作的那层机制)。它逼 AI 换个玩法:先把这一局的规则写成一段能真正跑起来的小程序,拿之前走过的每一步回放验证,全对上了,才在这段程序里搜下一步。
规则记在脑子里
→ 直接按键,错了接着走
42.83 分
step(格子, 按键) → 新格子
run_backtest 回放验证
run_bfs 免费搜最短路
commit_actions 才真出手
98.98 分
同一个 Opus 4.8 加 Fable 5,模型一个字节没改,只换掉外壳,分数就从 43 跳到 99。可为什么「写成程序」这一下差这么多?
AI 打游戏,一直是「边玩边猜、走错接着走」。Schema 逼它换成一个循环:先把规则写成程序,验证过了才动手。
这个 99 分不是「25 局解出了几局」,而是拿 AI 每关的步数去比人类第一次玩的步数,省得越多分越高,还带平方惩罚。换成「同一关要走多少步」最直观:
反复试错
认对规则后搜路
按了会咋样?
- × 没有物体清单
- × 没有目标说明
- × 没有奖励提示
写成程序。
模型一个字节没改
真的对吗?
每步对上,
才算数。
才真按键。
重来一圈
人类觉得最难的一关
vs 人类 500 步
硬猜到底。
换的是玩法,
先写成程序、验证过才动手。