
OpenAI 只打开两个 API 设置,GPT-5.6 Sol 在 ARC-AGI-3 的分数从 13.3% 涨到 38.3%
- OpenAI 复盘了一次自家模型「考砸」的经历:同一个 GPT-5.6 Sol、同一套评测题,只把两个 API 设置打开,ARC-AGI-3 公开题库的分数从 13.3% 涨到 38.3%。
- 问题出在跑模型的那套程序(业内叫 harness)上:每走完一步,模型写给自己看的私有思考被整段丢掉,下一步只能从零重新理解这个游戏。
- 第二个问题是上下文塞满就删掉最早的消息,连过去按了哪些键都在被挤出去,模型等于没有「过去」。
- 修法就两个开关:用 Responses API 把上一次响应的 ID 传回去,推理自动留住;再开 compaction,上下文到了阈值就压成一份浓缩摘要接着跑,不删开头。
- 省钱比涨分更夸张:最高档下每局输出 token 从 290 万降到 49 万;新程序在「高」档就拿到了旧程序拼到「最高」档的同样分数,token 差约 12 倍。
- ARC 自己 5 月那篇分析给的是另一套解释,三种「建不起世界模型」的失败模式;而经 ARC Prize 核验过的只有旧程序下的 13.33%(公开题库)和 7.78%(半私有题库)。
同一个模型,同一套题,分数差了近三倍
OpenAI 发了一篇极其具体的踩坑复盘:同一个 GPT-5.6 Sol、同一套评测题,只把两个 API 设置打开,分数从 13.3% 涨到 38.3%,每局烧掉的输出 token 还降到约六分之一。如果你在用 API 跑任何多步骤的任务,这两个开关的开关状态直接决定成绩和账单。
简单来说,过去看到一个模型跑分低,第一反应是「模型能力不行」;这次给出的答案是「跑模型的那套程序把模型的记忆掐掉了」。这套程序业内叫 harness。他们拿 ARC-AGI-3 这个不给说明书的解谜游戏评测做实验,五个推理强度档位各跑一遍。
之所以说「考砸」,是因为 Sol 在别的地方不是这个样子。它解决过图论里悬了几十年的循环双覆盖猜想,打通过宝可梦火红(Pokémon FireRed,纯看画面、不给任何游戏信息),在 Codex 里通关过杀戮尖塔(Slay the Spire),还打完了 Baba Is You 的前几关。沃顿商学院的 Ethan Mollick 放出的一段记录里,它在 Codex 里赢下了《杀戮尖塔 2》的每日随机挑战,而这款游戏在 Sol 的知识截止日之后才发售。

能打这些游戏,却在 25 局 2D 解谜小游戏上只拿一成多的分。下面这段左右对照的录像是同一款游戏(编号 cd82)、同一个 Sol:左边跑官方程序,右边跑 OpenAI 用 Responses API 重写的程序。这局游戏一共六关,在排行榜上没有任何前沿模型能过第一关;换了程序之后,六关全过。
这考试不给说明书,分数也不是「做对了几道题」
ARC-AGI-3 是 ARC Prize 做的评测,一共 135 个手工搭出来的小游戏环境,公开放出 25 个 demo,谁都能上 arcprize.org 自己玩。这个评测有一条设定贯穿始终:不给说明书。没有物件列表、没有规则说明、没有目标描述,也没有中间奖励分。
模型每走一步,收到的东西就下面这么点:一张 64×64 的格子图,每格是一个 0 到 15 的颜色编号;加一份能按的键,一共七个。
- RESET
- 重开一局
- ACTION1
- 上
- ACTION2
- 下
- ACTION3
- 左
- ACTION4
- 右
- ACTION5
- 确认 / 删除
- ACTION6
- 点某个坐标(x、y 各 0–63)
所以想通关只有一条路:边动手边猜规则,猜错了改。按下一个键,看画面哪里变了,推测这个键管什么,再拿下一步去验证。
那个百分比不是「做对了几道题」
ARC-AGI-3 的分数叫 RHAE(相对人类操作效率),它不数你做对几题,只比你和人走了多少步:拿模型通过每一关的步数,去比第一次玩这个游戏的人通过同一关的步数。而且惩罚是平方级的。
还有三条计分细节,不知道就读不懂那些分数:每一关的分数按关卡序号加权,越靠后的关越值钱,开头的教学关几乎不计分;单局最高分被「你打到第几关」卡住,最后一关不通,这局怎么高效也上不了 100%;人类基准取的是同一关多个首次玩家里步数居中偏上的那一位,所以一个普通人自己去考,也拿不到 100%,OpenAI 估出来的人类平均分是 48%。
不改变游戏画面的操作,一步都不计入步数 , 工具调用、思考过程、重试,全都不算。
也就是说,13.3% 涨到 38.3%,衡量的完全是「少走了多少步弯路」,跟「少想了多少」没有关系。输出 token 少烧五分之四,是另一笔账,两笔账各自独立。这次一口气赢了两样。
模型不笨,是它每走一步就被清一次记忆
既然分数只罚弯路,那 Sol 的弯路是怎么来的。OpenAI 去翻了几场对局记录,第一眼的观感和 ARC 一样:这模型看着不太聪明,每一步都琢磨很久,还老在原地打转。往下看才发现,模型本身没毛病,毛病出在这套程序上,两处。
第一处,模型每走完一步,它写给自己看的那段私有推理就被整段丢掉。于是要走下一步时,Sol 得从零重新理解这个游戏。它能看到自己按过哪些键、附带的简短备注,但那些键为什么按、当时已经想通了什么、下一步计划是什么,全没了。
第二处,这套程序用的是滚动截断(rolling truncation):上下文一超过阈值,就把最早的消息扔掉。所以不光过去的想法留不下,连过去按过哪些键的记录也在一点点被挤出窗口。
这就像让一个人玩解谜游戏,每按一次键就把他刚才的思考清空一次,只给他留一张「你按过右、右、上」的清单。清单上没写他当时已经想明白了什么。他能看见自己走过的路,却想不起来为什么这么走。于是每一步都得重新推理一遍,还很容易把已经排除过的路再走一次。
这两条在 ARC 的开源实现里能直接看到
ARC 把跑评测用的程序开源在 GitHub 上(ARC-AGI-3-Agents,最新提交 2026 年 5 月 28 日)。本站把它拉下来查了一遍,两点都有实物。
第一,全仓所有调用 OpenAI 的地方都走 chat.completions.create,一共 20 处;responses.create 和 previous_response_id 一处都没有。这一点比「设置没打开」更硬:旧的这套接口在结构上就没法把加密的推理内容带回下一轮。所以推理被丢掉这件事跟漏配某个选项无关:选了这套接口,结果就必然如此。
第二,消息栈确实是先进先出砍掉最早的:
agents/templates/llm_agents.pydef push_message(self, message):
"""Push a message onto stack, store up to MESSAGE_LIMIT with FIFO."""
self.messages.append(message)
if len(self.messages) > self.MESSAGE_LIMIT:
self.messages = self.messages[-self.MESSAGE_LIMIT :]
最后一行就是滚动截断:只留最近 MESSAGE_LIMIT 条,前面的直接不要了。公开模板里这个上限是消息条数(普通版 10 条、推理版 5 条)。
上下文满了不删最早的,改成压成一份摘要
既然病根是记不住,修法就是两件事:让它记得,以及别用删除来腾地方。
OpenAI 家的模型,训练时的形态本来就是「先写一段私有推理,再输出回复或者调用工具」,而这些推理消息是要留在对话历史里的;历史长到装不下,就压缩一下接着往下跑。ChatGPT 和 Codex 就是这么部署的。为了让实验对齐这套生产环境,他们用 Responses API 把 ARC-AGI-3 的程序重写了一遍。
开关一:保留推理,把上一次响应的 ID 传回去
这个开关叫保留推理(retained reasoning)。用 Responses API 时,把上一次响应的 ID(previous_response_id)带进下一次请求,推理就会跨工具调用、跨轮次自动留住。效果有两个:模型每一步琢磨的时间变短了,因为它不用再从头理解这个游戏;而且它明显更会「学」了,策略能连贯起来,不再每一步各想各的。
开关二:用 compaction 换掉滚动截断
compaction 就是上下文压缩。按 OpenAI 的接口文档,用法是在请求里设 context_management 的 compact_threshold:渲染后的 token 数一越过这个阈值,服务端就跑一次压缩,把之前的状态和推理打包成一个加密的压缩条目,接着往下跑。这个条目是不给人看的黑盒,但它把「继续这段对话需要的东西」带过去了。
两种做法的差别一句话说得清:滚动截断是内存满了就把最早的记录删掉,删了就再也拿不回来;压缩是内存满了就把这些记录写成一份浓缩件,腾空之后接着记。前者真的忘了,后者记成了缩写版。
OpenAI 自己画的这张图,是这套机制在真实一轮里的样子:
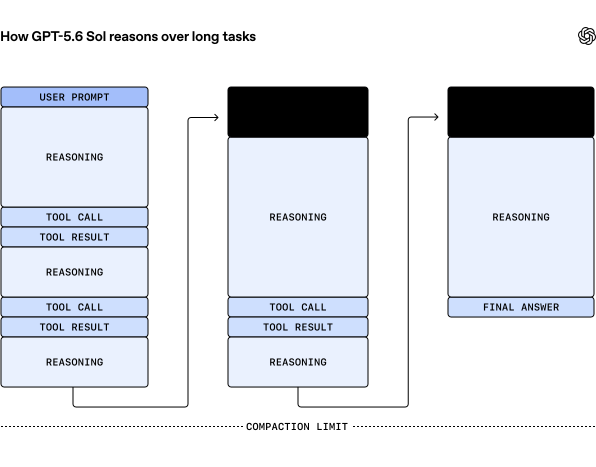
滚动截断还有一个次要的副作用:它让模型大部分时间都在一个接近装满的上下文窗口里干活,而窗口越满,模型表现会略有下降。压缩把窗口重新腾空,也顺带避开了这一点。
五档推理强度全线上移,同分时 token 差约 12 倍
下面这张图把两套程序的实测结果画在一起:横轴是每局烧掉多少输出 token,纵轴是分数,两条线各五个点,对应低、中、高、超高、最高五个推理强度档位。
两条线的形状差别一眼能看出来:官方程序那条一路往右爬,token 花到每局 290 万,分数才到 13.3%;新程序那条几乎贴着纵轴直上,最高档每局只花 49 万 token,分数 38.3%。
| 推理强度 | 官方程序 分数 | 官方 每局 token | 保留推理+压缩 分数 | 新程序 每局 token |
|---|---|---|---|---|
| 低 | 0.9% | 58,809 | 3.7% | 84,316 |
| 中 | 1.5% | 207,188 | 7.3% | 141,939 |
| 高 | 5.2% | 728,188 | 13.4% | 243,258 |
| 超高 | 7.2% | 1,285,393 | 25.7% | 428,540 |
| 最高 | 13.3% | 2,900,997 | 38.3% | 485,485 |
五个档位全线上移,这是第一层。OpenAI 自己总结的是:最高档下约 3 倍分数、约六分之一的输出 token。
回过头看前面那条计分规则,这两笔账就分得清了:RHAE 不把思考步数算进步数,所以分数从 13.3% 涨到 38.3%,说的全是模型少走了多少步弯路:记得住自己的判断,就不会把排除过的路再走一遍。而输出 token 降下来,说的是它不必每一步从头把游戏理解一次。一个改动,两处收益,互不重叠。
OpenAI 还做了一段 4 分 29 秒的动画,跟着 Sol 的 17.5 万上下文窗口走完一串关卡:
ARC 自己的分析给的是另一套解释
OpenAI 说这次细看是被 ARC 的一篇分析启发的。那篇发在 5 月 1 日,ARC 翻了 160 份对局回放和推理轨迹,得出的结论落在另一个地方:模型建不起对游戏的理解。同一批材料,两边看出来的东西并列在下面。
糊涂来自这套程序:私有推理每步被丢、老动作被截断挤出去,模型没有「过去」,于是学不会。
证据是换掉这两处之后,同一个模型分数近三倍、token 降到六分之一。
模型建不起对游戏的工作理解。三种失败模式:
- 局部效果看对了,全局规则没建起来 , 知道按 ACTION3 会让物件旋转,却没能推到「先把桶转到正确朝向,再蘸颜料」。
- 拿训练数据里的旧游戏硬套 , 把 cd82 当成沙子物理和 Flood-It,把 ls20 当成打砖块。
- 过了这一关,但没学会这个游戏 , 第一关靠一个错误的理解侥幸通过,到第二关这个错误理解就把它锁死了。
ARC 那篇的收尾是一句对照:Opus 4.7 压缩出了一个自信但错误的理论,GPT-5.5 则是根本压缩不起来。
它们不是因为没观察到东西才失败的,它们失败是因为没法把观察锚定进一个世界模型。
ARC Prize,《Analyzing GPT-5.5 and Opus 4.7 with ARC-AGI-3》,2026-05-01
两套解释并不互相排斥 , 记不住自己上一步的判断,本来就更难攒出一个连贯的世界模型。但它们确实指向两个不同的位置,一个在程序,一个在模型。
还有两条事实值得摆在一起看。第一,ARC 在那篇的注脚里自己写了:默认测试下 GPT-5.5 不返回推理轨迹,所以那篇的定性分析用的是另一套专门设定跑出来的结果,官方分数不来自那个模式。这从 ARC 一侧印证了推理拿不到这个现象确实存在。
第二,ARC 7 月给 GPT-5.6 系列的成绩页上,对 Sol 本身的评价相当正面:它是这一代里唯一能打的模型,能用游戏自己的语汇正确读懂陌生场景,假设被推翻时会重新规划而不是原地乱撞,而且是第一个真正赢下一整局 ARC-AGI-3 公开游戏的模型(编号 ft09,87%)。所以「这模型看着不太聪明」是 OpenAI 看回放时的观感,不是 ARC 对 Sol 的定论。
如果把这套程序换得更彻底,数字还能高得多。
换新接口、保留模型的思考、用压缩取代删除
落到自己手上,OpenAI 给 API 开发者的建议就三条,原话只有三行,没有展开。
对应到具体要写哪几个字段,是下面这几个。
previous_response_id
context_management.compact_threshold
store=false
POST /responses/compact
第一个是把上一次响应的 ID 传回去,推理跨工具调用和跨轮次自动保留。第二个是压缩阈值,渲染后的 token 数一越过它,服务端就自动压一次,不用另外调接口。第三个配上之后,服务端压缩也适用于不留存数据的场景。最后一个是独立的压缩端点,完全无状态,自己决定什么时候压:你把完整的上下文发过去,它返回一个压好的新上下文,原样传给下一次请求就行。
他们的收尾主张是:评测很少单独衡量模型,它同时衡量了一堆看不见的选择:API 设置、程序设计、提示词。而且这不是第一次了,以前也遇到过在公开评测上分数低得意外,一查发现评测方用的通用程序把推理消息丢了。
我们希望这些实验能提个醒:评测很少单独衡量模型,它同时衡量的是一整套不那么显眼的选择 , API 设置、程序设计和提示词。
Ilan Bigio、Ted Sanders,OpenAI,2026-07-29
顺着这条往下想一层:Sol 在这个评测上的成绩,从 ARC 核验的 13.33% 到 OpenAI 自测的 38.3%,再到 Schema 自报的 95.35%,模型权重一直没动过。人类基准是 48%。这几个数摆在一起,一个模型「能力有多强」这句话该怎么算,本身就还没有定论。
OpenAI 复盘一次自家模型考砸:跑模型的那层程序,每走一步就把它的思考丢掉
OpenAI 的 Ilan Bigio 和 Ted Sanders 把 ARC-AGI-3 的跑分程序换到新接口、打开两个设置,同一个 GPT-5.6 Sol 的成绩和账单一起变了,一页带图讲完。
↓ 一页读完 · 有一张会动的图
同一个 GPT-5.6 Sol、同一套评测题、同一个推理强度档位,只把两个 API 设置(调用模型时的接口选项)打开,ARC-AGI-3 公开题库的分数从 13.3% 涨到 38.3%。模型权重一个字节都没动。
38.3% 是 OpenAI 自己跑出来的成绩;经 ARC Prize 独立核验过的,只有官方程序下的 13.33%(公开题库)和 7.78%(半私有题库)。下面三个数都出自 OpenAI 2026-07-29 那篇复盘。
ARC-AGI-3 是 ARC Prize 做的一套解谜游戏评测,全程不给说明书:没有规则说明,没有目标描述,没有中间奖励分。模型每走一步只收到一张 64×64 的彩色格子图,加一份能按的键,一共七个。想过关只能边按边猜规则,猜错了改。
它的分数叫 RHAE(相对人类操作效率)。它比的是步数:拿模型通过每一关的步数,去比第一次玩这个游戏的人通过同一关的步数,多走的部分按平方扣分。那个百分比跟「做对了几道题」没有关系。
还有一条决定了后面的数怎么读:不改变游戏画面的操作,一步都不计入步数,思考、工具调用、重试,全都不算。所以分数涨说的是少走了多少弯路,省下来的输出量是另一笔账。
OpenAI 翻了几场对局记录,第一眼的观感是这模型不太聪明:每一步琢磨很久,还老在原地打转。往下看,毛病出在跑模型的那层程序上(业内叫 harness,就是把画面喂给模型、把它选的动作发回去、还决定给它看多少历史记录的那段外部代码)。
模型每走完一步,它写给自己看的那段私有推理就被整段丢掉;上下文一塞满,连过去按过哪些键的记录也从最早的一头开始删。下一步只能从零重新理解这个游戏。它手里剩下的东西是这些:
✔ 一句简短的备注
✘ 那些键当时为什么按
✘ 上一步已经想通了什么
✘ 下一步原本的计划
病根是记不住,修法就两件事:让它记得自己想过什么,以及别用删除来腾地方。
旧接口带不回模型的私有推理;下面那行就是滚动截断,只留最近若干条(公开模板里是 10 条、推理版 5 条),前面的直接不要。
第一行把上一次响应的 ID 传回去,推理跨工具调用、跨轮次自动留住;第二处是压缩阈值,越过它服务端就自动压一次,不用另外调接口。
五个推理强度档位全线上移。OpenAI 自己的总结是最高档下约 3 倍分数、约六分之一的输出 token(模型吐出来的内容,按量计费)。更实用的是同分那一格:
25 局解谜
小游戏
一帧帧倒回去。
走回头路?
- × 那些键当时为什么按
- × 上一步已经想通了什么
- × 下一步原本的计划
就被清空
刚才的思考。
删掉最早的,
删了拿不回来
前面学到的东西跟着留下
compact_threshold|到这个量就压一次
自己想过什么。
13.3% → 38.3%
↓
49 万