Databricks 公开 AI 编程省钱打法:换对模型一刀省一半
- AI 写代码确实管用,有的团队产出直接翻了十倍。可 token 账单也在指数级往上涨,几乎每家大规模用起来的公司都撞了这堵墙。
- 四招里最大的一刀是换模型。Stripe 实测新版 Opus 没变强还更贵,直接拒绝了内部上架。
- 最反直觉的一条:没有一家公司把硬性额度当日常工具用,断供这招留着,但只当最后手段。为什么,下面有两个很实在的理由。
效率涨上去了,账单涨得更快
Databricks 最近公开了一份极其实用的成本治理复盘:AI 写代码这件事,他们内部跟踪的每一项速度指标都测出了提升,有的团队产出直接翻了一个数量级。但账单也跟着指数级往上涨。
这条曲线撑不下去,放任不管,迟早会超过公司的营收。于是企业被卡在一个很拧巴的位置上:一边想尽可能推 AI 转型,把最好的工具塞到每个员工手里;一边又得面对一个总成本,而这个总成本正在吞掉、甚至反过来抵消 AI 带来的效率收益。
好在最早大规模铺开的那批公司已经摸出了一套办法,同时做到两件事:让所有人几乎没有阻力地用上 AI 工具,同时把人均成本锁在一个大致固定的范围内。这套办法的材料,来自 Databricks 自己的实践,外加和 Stripe、Coinbase、Uber、Ramp 几家公司的交流。
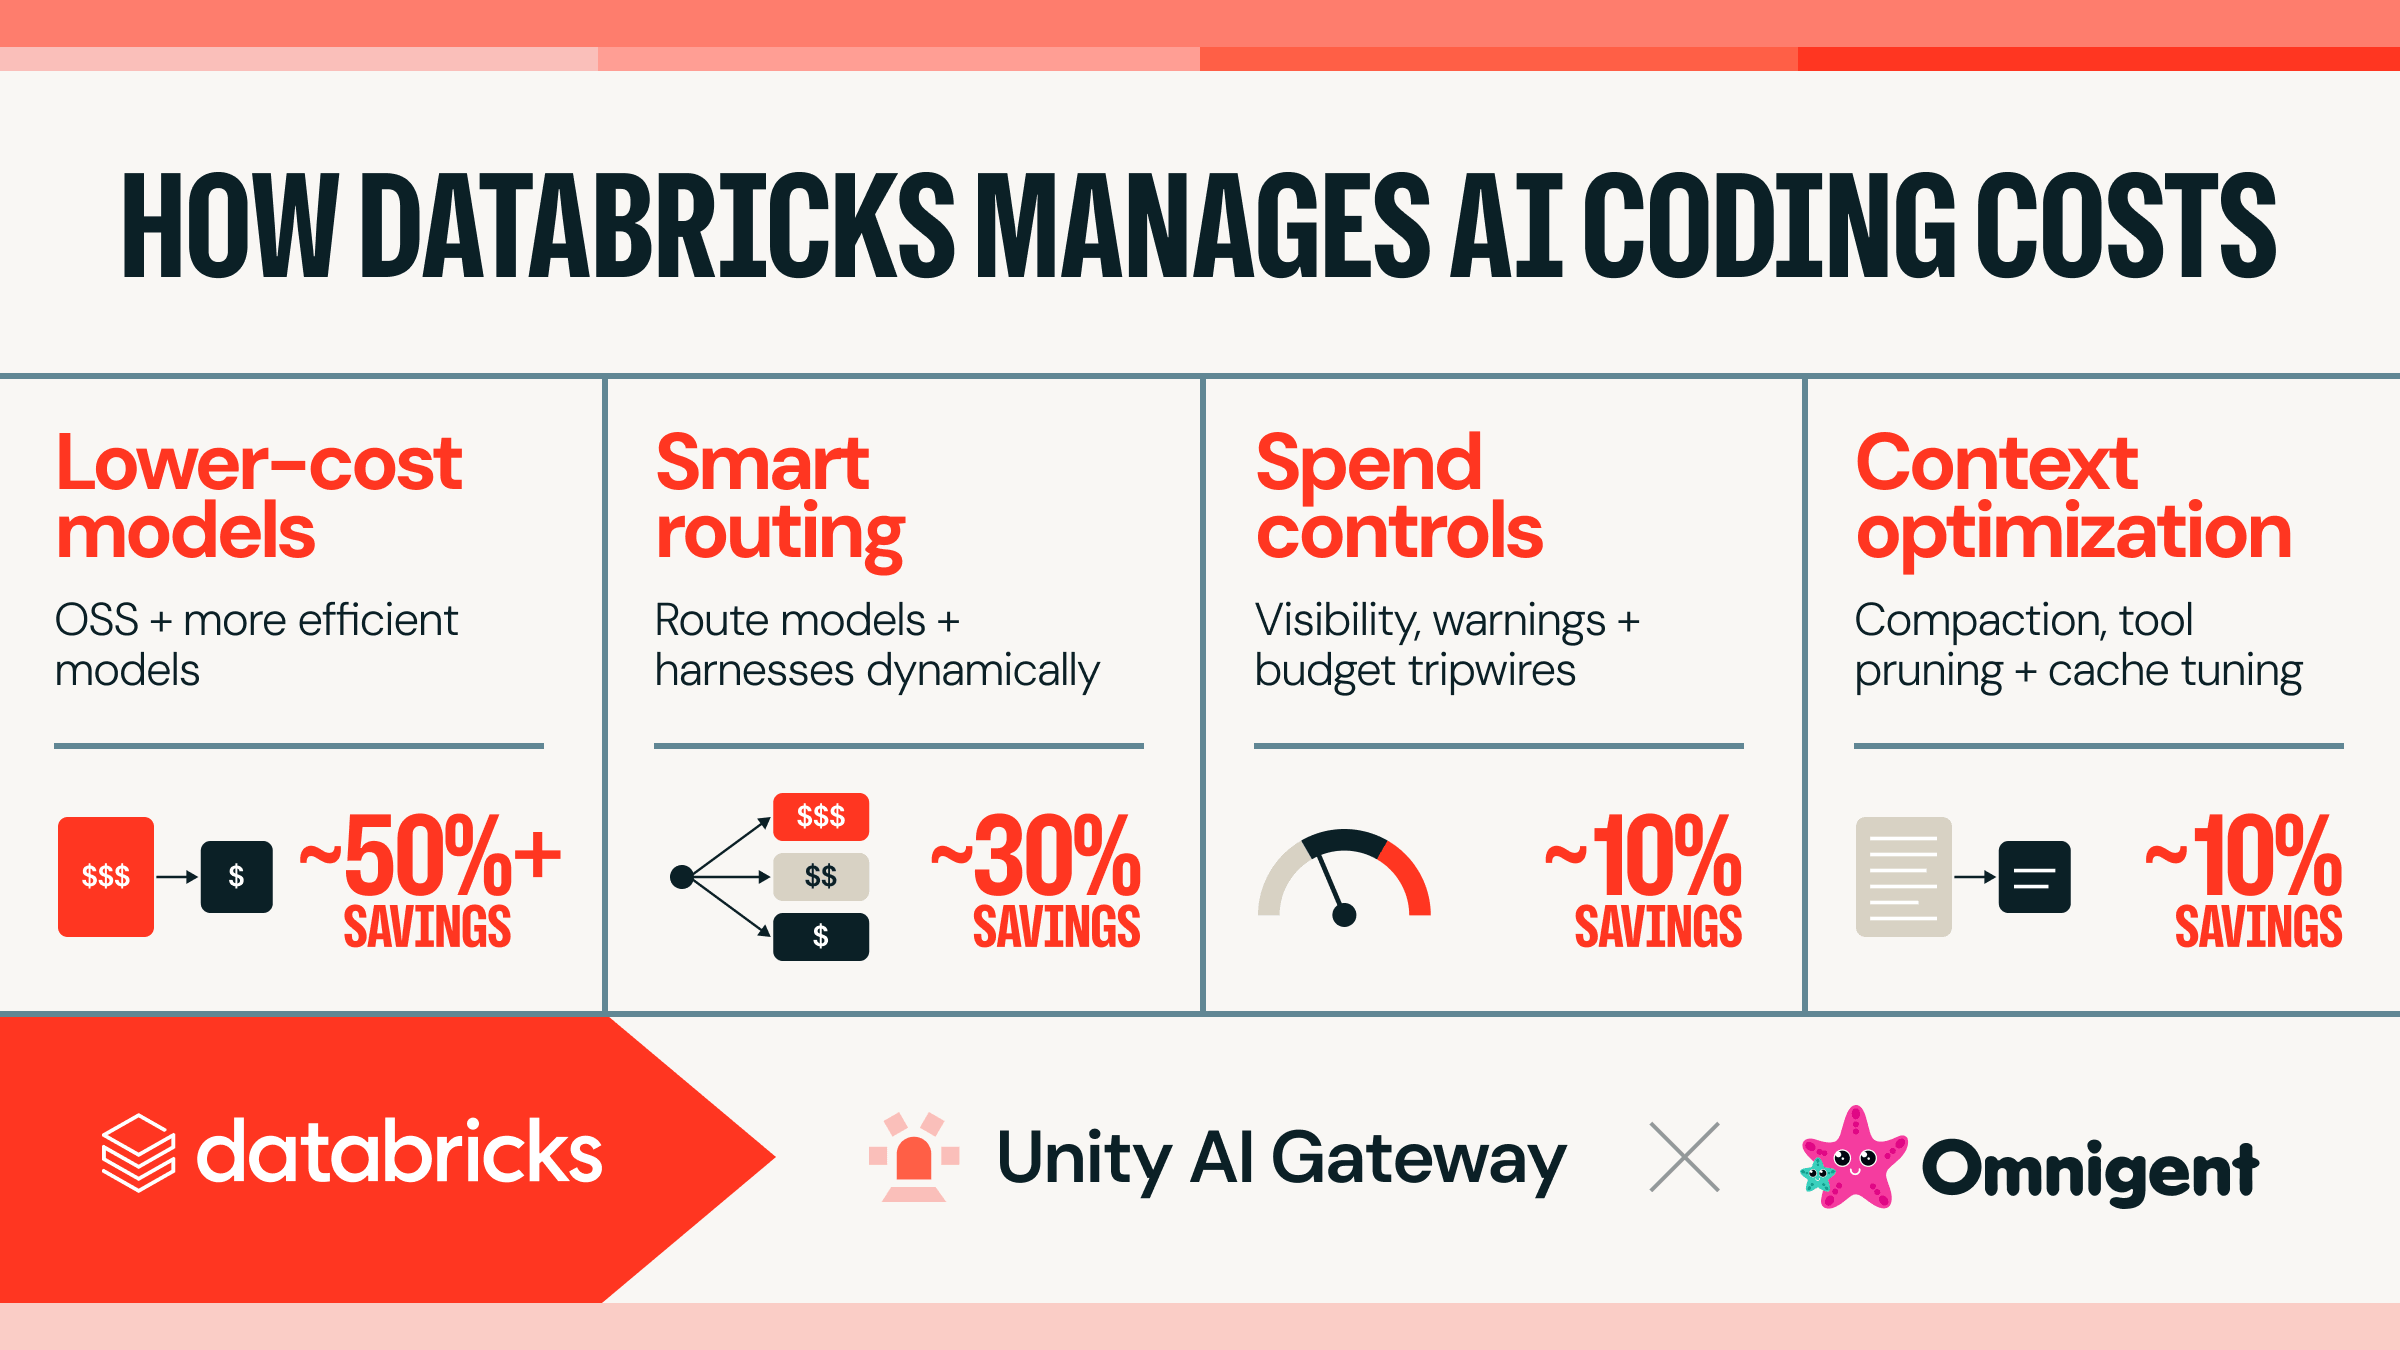
四个手段,各自能省多少:

| 手段 | 具体做什么 | 能省 |
|---|---|---|
| 换更低成本的模型 | 开源模型 + 更高效的新模型 | 50%+ |
| 智能路由 | 模型和工具动态调度 | ~30% |
| 支出管控 | 费用可见、超额警告、预算绊线 | ~10% |
| 上下文优化 | 压缩、砍工具冗余、调缓存 | ~10% |
有些手段用现成软件就能落地,另一些要动基础设施,尤其是那些要改开发者本地工具、要在多个模型之间搬运流量的。Databricks 把自己这套的两个关键部件都放出来了:给开发者用的统一入口 Omnigent,和管流量的 Unity AI Gateway,一个开源、一个免费。
日常写代码用不着最聪明的模型
大家平时说的「前沿模型」,指的是最聪明的那个;各大实验室卷的方向也是智能的天花板,现在的顶尖模型已经能解开数学难题,能发现新的安全问题。
但当 AI 铺到全公司几千个开发者手上,另一条前沿才是要紧的:效率前沿(efficiency frontier)。它指的是在同一个智能水平上,价格最便宜的那批模型。
解一道顶尖数学难题,你得请爱因斯坦;但把一个组件从 X 改名成 Y、把重复的样板代码补齐,请爱因斯坦来干就是纯烧钱。日常写代码的绝大部分工作属于后者,它们只要模型跨过工程质量的及格线就够用了,聪明的上限再高也吃不到。
所以真正决定公司账单的,是那些刚好够用的模型卖多少钱。而这条效率前沿,推进速度比智能前沿快得多:几乎每周都有新模型发布,同样一块钱能买到的智能比上一批更多。
换模型最省钱,但公共跑分不能信
四招里最大的一刀就在这儿:快速换到更新、更高效的模型上,省下来的比其他任何手段都多。但要吃到这个红利,公司先得知道,到底哪个新模型真的比手上这个强。
这件事比想象中难。公共基准跑分和真实编码任务的表现对不上号,分数高不代表在你的代码库里干得好。所以不少公司自己搭了自动化评测,用更接近内部开发实际构成的题目来测。Databricks 就是拿自家几百万行的代码库做的这套基准,测下来 GLM 系列的性价比明显突出,于是直接把 GLM 推给了内部开发者。
评测也常常跑出负面结果,比如下面这次:
Stripe 测下来,Opus 4.7 相比 4.6 没有带来实质的质量提升,成本却更高,于是他们决定不在内部提供 Opus 4.7。Databricks 拿 Opus 5.0 和 4.8 对比,也看到了类似的成本倒退。
大厂公开点名说「哪个新模型我们试过、决定不给员工用」,厂商很少公开谈自己否掉了哪个新版本。新版本不等于更划算,得自己测了才知道。
Databricks 把自己截至 2026 年 8 月 6 日的测算画成了一张图。横轴是每个任务平均花多少钱,纵轴是平均通过率,连成红线的那几个点就是效率前沿,同样的通过率下没有更便宜的了:

推荐名单最后只有三个:GLM 5.2、Opus 4.8、GPT-5.6 Sol。这三个都不是当下最强的模型,效率前沿要的从来就不是最聪明的那个。
想随时换模型,先别被工具绑住
道理讲通了,真要换的时候会发现挡路的往往是工具,模型反而好办。
开发者每天实际在敲的那个东西,Claude Code、Codex、Cursor 这类,行话叫 harness。模型负责思考,harness 负责让模型能读你的代码、改文件、跑命令。
模型是发动机,harness 是整台车:方向盘、变速箱、仪表盘都长在车上。现在的问题是,闭源的前沿模型越来越倾向于和特定的 harness 配套设计,某些车就是配某些发动机才顺。你想只换发动机、不换车,越来越难。
用惯了某个工具,等于被悄悄绑在了某一家的模型上。切换成本一旦高到某个程度,这个工具本身就成了事实上的锁定,公司想把开销挪到更便宜的模型上都挪不动。两条出路:
第一条,让开发者自己换工具。公司同时提供好几个 harness,需要迁移开销的时候,请大家换一个用。好处是平时可以用自己顺手的;坏处是对个人来说切换成本很实在,用惯了的人会觉得别扭。
第二条,在上面加一层统一驾驶舱(行话叫 meta-harness)。开发者看到的界面始终是同一个,底下该调哪个 harness、哪个模型,由它来分发,闭源和开源的都能挂进去。这样既保住了模型和工具的独立性,又不用让人反复适应新界面。Databricks 内部走的就是这条,默认入口是他们开源的 Omnigent;他们接触的一些公司则是自建了内部版本,接进自家的开发工具链。

难活给贵模型,杂活给便宜模型
上面那两节靠的都是人主动去换。那能不能让系统自己按任务的难易来分派?这就是第二招:路由。
像快递分拣:包裹进来先过一道分拣台,同城小件走一条便宜的线,跨国大件才上贵的那条。区别只在于,这里被分拣的是你派给 AI 的活。
原文把路由分成三类,颗粒度从细到粗:
一、按每条请求分
在你的工具和底层模型之间夹一个带状态的代理,逐条请求判断:这条最便宜能答上来的是谁,就发给谁。这里有个坑要绕:得把服务端缓存算进去。上下文一大,缓存没命中的那次代价极高,所以不能光看单价便宜就切过去。现成产品已经有一批:Cursor Router、OpenRouter 的 AutoRouter、Ramp 的 Router,以及 Databricks 自家 Unity AI Gateway 里的 Smart Routing。
二、按整个任务分
颗粒度粗一档:在你本地,把一整个任务整单派出去。「把这个组件从 X 改名成 Y」是简单任务,「探索一下有哪些设计能把延迟降下来」是复杂任务,判断完就把整件事从头到尾交给对应档位的模型。干这活的就是上一节说的统一驾驶舱,Omnigent 支持这种模式。
三、一贵一贱搭档
同一个工具里配两个模型,一个贵的高智能、一个便宜的干活模型。两个方向都有人在做:
- 便宜的主跑,遇到难题请教贵的,比如 Claude 的 Advisor 工具,便宜模型全程掌舵,遇到需要更强马力的任务才升上去问一句。
- 贵的主跑,把杂活外包给便宜的,比如 Cognition 的 Devin Fusion,主循环由高成本模型跑,挑一部分工作扔给便宜模型。
效果方面,Databricks 给的内部结果是:Smart Router 能把平均任务成本稳定压低 30% 以上,质量大致追平工作集里最贵的那个模型。他们接触的其他公司也看到了类似结果。

不设硬限额,改成一级级加摩擦
模型这一层能省的都省完了,接下来轮到人。这里有个很多人以为的答案:给每人发个月度额度,花完拉倒。
原文专门说明了为什么这不是答案,所有受访公司都把硬额度当最后手段,不当日常工具。两个理由都很实在:
- 撞线就断供,等于把生产力按停。开发者手上正干着活,AI 突然不能用了,公司和员工都不想要这个结果。
- 花得最多的人里,有一部分恰恰是产出最大的人。他们是靠 AI 撬出了惊人效率的那批,掐掉他们等于自残。
取而代之的是一套渐进方案:先让人看见自己花了多少,再随着花费上升一级级加摩擦。
第一级,把花费摆到台面上。受访的每家公司都做了近乎实时的花费反馈,不少还会顺手给建议,提示换成更便宜的模型能省多少。关键是这份账要能跨工具汇总看,开发者才好判断,自己的钱花在哪个工具上回报最高。Databricks 内部的开发者面板长这样:

第二级,加消费闸门。花费涨到某个阈值,弹出来让人做点什么。最轻的一种是自己点掉就能继续,只是提醒你速度上来了,Databricks 发现这种自清除的闸门特别能拦住无意识的花费。再往上的闸门就要走审批了,通常是找管理链批预算。
第三级,降档不停机。撞到闸门的人不会被断掉 token,只是被切到更便宜的模型上。由于最便宜的那批和顶级模型差价巨大,人照样能把活干下去,账单却不再往上飙。
第四级,才是停用。大多数系统确实保留了完全断掉的能力,但这通常是临时措施,而且更多是一次对话的开始,聊聊怎么把 AI 用得更划算。
账单大头是 AI 自己塞的上下文
前面三招管的是「用哪个模型、谁来批」,最后一招砍的是 token 本身。
你在编程 Agent 里打的可能只是一句「帮我查一下这个 bug 并修掉」。接下来发生的事情是:它去搜集大量相关上下文、调用一大堆工具、翻遍代码库,再加上公司给它配的技能和系统信息。等到真正开始那次昂贵的推理时,你打的那句话在喂进去的数据里只占极小一部分,账单的大头,是你根本没有明说的那些内容。
怎么把这条长条压短,办法还很新,原文列了几个正在试的方向:
- 让工具更频繁地把当前上下文压缩一遍。
- 换用「话少」的 harness,或者把手上这个调得更省 token。
- 把常用工具挨个审一遍,砍掉它们返回结果里的废话。
- 鼓励开发者把任务拆成更小的单元,每次要读的范围自然就小了。
上下文一大,prompt 缓存(prompt caching)的影响也开始变重。闭源和开源模型都提供了缓存开关和存放时长的设置:把内容写进缓存要花钱,但从缓存里读大幅便宜。这笔账划不划算取决于各家自己的工作方式,所以手动调一调默认的缓存设置、把命中率提上去,对总成本影响很大。
Databricks 说他们只是相对简单地调了调 harness 和缓存设置,生成的 token 数和对应成本就降了将近一半,开发者那边没有观察到质量下降。他们认为这块还有可观的优化空间。

省钱手段全靠一个 AI 网关落地
回头看这四招,每一招都隐含着一个技术前提。想随时换新模型,公司得有一个地方统一管着「模型菜单」,而且开发者手上的工具要支持混搭;想让人看见跨工具的花费,就得有一处统一的账;想管住上下文膨胀,就得能观察常用工具吐出来什么、并且强制压缩。
这些需求正在被同一类新的基础设施软件接住,它有个越来越通行的名字:AI 网关(AI Gateway),相当于公司的 AI 调度台,四件事都在这里发生:
| 它管什么 | 具体是什么意思 |
|---|---|
| 接入与容量 | 统一代理对底层模型的访问,闭源和开源都算 |
| 预算与执行 | 记账,并执行渐进摩擦、自动降档这类复杂策略 |
| 端上配置 | 给开发者的工具下发模型白名单、压缩设置这类本地生效的参数 |
| 会话留痕 | 记录编程会话的轨迹,供后续做效率分析和评测 |
Databricks 自己这四件事全部压在 Unity AI Gateway 上,加上给开发者的 Omnigent,两个部件都已经开源或免费放出。
AI 编程成本的指数级增长不是宿命,它是一个可以被解决的工程与治理问题。 , 原文结论
驯服了这条曲线的公司,用的是同一套打法:盯的是效率前沿、选能保住模型自由度的工具、把活路由到最便宜且干得动的模型、用可见性和渐进摩擦替代硬额度、砍掉真正吃钱的上下文开销。这些手段没有一个是以牺牲生产力为代价的,而生产力,恰恰是当初上 AI 的全部理由。
换成够用最便宜的模型,是压低 AI 编程账单的最大杠杆
Databricks 联合 Stripe、Coinbase、Uber、Ramp 拆出四招压账单,这页一次带图看完
↓ 一页读完 · 有一张会动的图
AI 写代码确实管用,Databricks 内部有团队产出直接翻了十倍。可 token 账单跟着指数级往上涨,放任不管,迟早会把这部分效率收益吃回去;一刀切断供,又会把正在干活的人按停。四个手段的省钱幅度,Databricks 标注为方向性估计,来自内部对开发团队的非正式调研:
各大实验室卷的是「最聪明的模型能有多强」,这叫智能前沿,能解数学难题的模型属于这一档。但日常写代码八成是改 bug、重命名、补样板代码,用不着这种脑子,真正决定账单的是「同等够用的智能里谁最便宜」,这条叫效率前沿,比智能前沿刷新得快得多,几乎每周换一个新王。
公共跑分测不出真实编码表现,几家公司都拿自己的代码库自建了评测。写代码工具(Claude Code、Codex 这类)跟模型配套设计得越来越紧,长期用惯一个工具会被悄悄绑死在它背后的模型上,Databricks 干脆加了一层统一入口,换模型时不用连工具一起换。三个真实判断:
Databricks 自测
Stripe 自测,直接拒绝内部上架
Databricks 自测
当前推荐名单只剩三个:GLM 5.2、Opus 4.8、GPT-5.6 Sol,都不是当下最聪明的模型。
简单任务和复杂任务不该用一个价的模型跑。路由做的就是这件事:请求级挑最便宜能答上来的模型,任务级按整单复杂度分派,或者一贵一贱搭伙,便宜的主跑遇难题请教贵的,或贵的主跑把杂活外包给便宜的。Databricks 的 Smart Router 实测下来,比单独跑 Opus 5 还便宜三成多,解决率反而更高:
模型和路由之外还有两招收尾。一招是砍上下文,你打的那句话在真正推理时只占很小一块,账单大头是 AI 自己翻代码、调工具撑起来的部分,Databricks 调了调压缩和缓存设置,生成 token 就从每次会话 1200 万砍到 550 万。另一招是管人花钱,但没有一家受访公司把硬额度当日常工具:断供会把正在干活的人按停,花得最多的人里常有产出最大的那批。
撞线直接断供,活被迫停下来。
看得见花了多少 → 先弹能自己点掉的提醒、再升级到审批 → 撞线不断供、自动切到便宜模型 → 停用是极限手段,通常是暂时的,更像一次「怎么把 AI 用得更划算」对话的开场。
这几招最后都靠同一层基建接住,统一管模型菜单、跨工具记账、给开发者下发配置、留会话日志,Databricks 把这套(Unity AI Gateway + Omnigent)开源或免费放出来了。
- × Opus 4.7
没提升 却更贵 - × Opus 5.0
比 4.8 成本倒退
Opus 4.8
GPT-5.6 Sol
常是产出最大的人