Harvey 开源了一个超过 1 亿 Token 的合成律师事务所 拥有 46 个客户、近 1 万份内部工作产品文件
- Harvey 凭空造了一家律师事务所,266 个案子的全部档案放上 GitHub,让 AI 进去找答案。
- 两个顶尖模型单条评分点都能答对七八成,但要求「一条不漏」时,只剩 24.4% 和 36.0%。
- 标准答案超过 16 条的题,全对率直接归零,而它们在难题上并没有变笨。
这家律所是假的,规模是真的
法律 AI 公司 Harvey 开源了一整间律所的档案:266 个案子、9288 份 Word 文档、1.08 亿 token 全部放上 GitHub,配 250 道题让 AI 进去找答案。档案、题目、评分标准、跑分结果全部公开可查。
为什么要建这个数据集?在真正的律师事务所里,律师查资料非常痛苦:文件浩如烟海,而且很多关键信息没有固定的关键词可以拿去搜。过去的法律考题都是「给你一份合同,回答一个问题」,材料喂到嘴边,测不出这件事。这份数据集是 Harvey 的法律 Agent 测试集 LAB 的新扩展包。
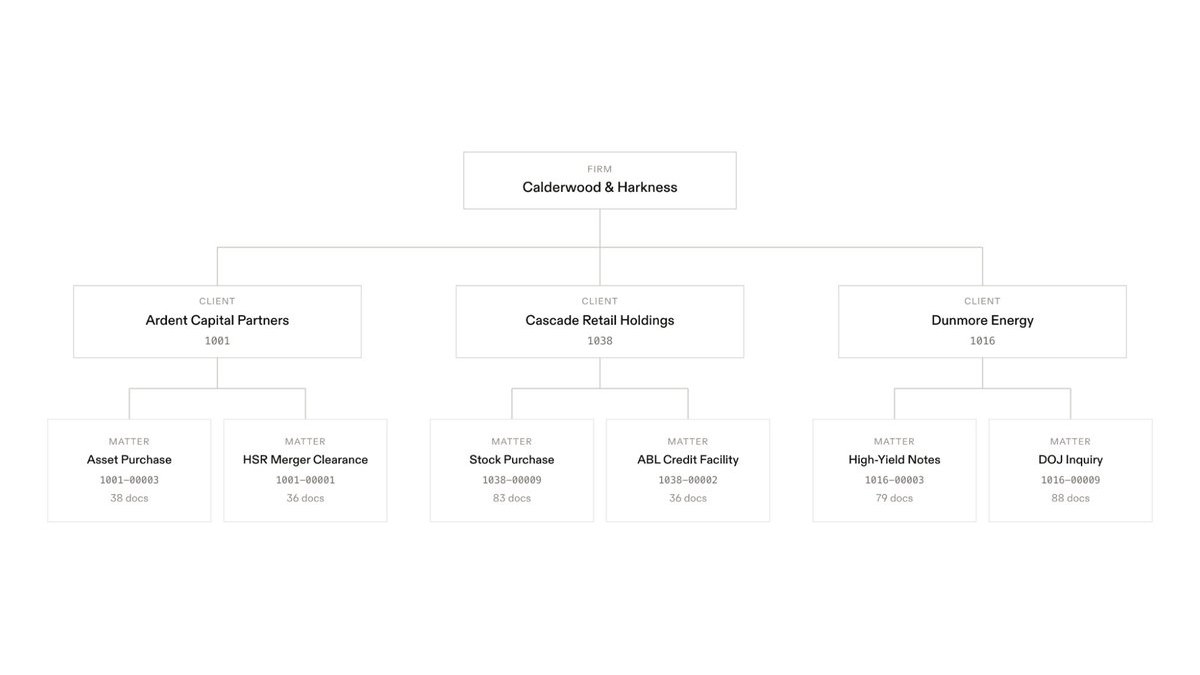
先得搞明白律所是怎么组织工作的,因为整份数据就是照这个搭的。律所的工作只靠两个关系串起来:客户(给谁干活)和 matter(给这个客户干的具体一件事)。46 个客户横跨 15 个业务领域,一个客户可以有很多个 matter,一个 matter 可能要拉好几个领域的律师一起上。
这 46 个客户里公司和个人都有,而且是故意挑得五花八门的:一家 PE 基金要的法律服务,和一家工业制造商要的完全是两回事,客户越杂,能覆盖的业务种类才越多。266 个案子有的已经结了,有的还在进行中。
律所给某一个客户干的一件具体的活,从签合同到结案的所有文件都归在它名下。它像项目管理软件里的一个「项目」文件夹,只不过在律所里,它同时还是账单单位和档案柜的一格。文件夹编号就是「客户号-序号」,1003-00001 是 1003 号客户的第一个案子。

一个案子里的文件覆盖它的完整生命周期:怎么接下这单活(委托)、分几个阶段怎么推进、中间做过哪些重大决定、最后是什么结果。案子内部按文件夹分类,但故意不做统一标准,每个案子的文件夹长得都不一样,取决于案子类型、合伙人习惯、以及这案子实际是怎么打下来的。真实律所就是这个乱法,谁也没规定过档案该怎么码。
每份文件都从 1000 字剧本长出来
这么大一堆档案不可能一份份手写。Harvey 的办法是:每个案子先写一份约 1000 token 的「剧本」,交代两件事,给哪个客户、这项目大概什么形状。然后往剧本里塞具体事实:可能很细,比如「这份协议里托管金是 10%」「竞业禁止期两年」;也可能是结构性的,比如「这个诉讼被驳回了」或者「和解了」。
巧思在于最后那一步:定标准答案只需要看那份 1000 字的剧本,不用去读渲染出来的海量文件。否则这 1.08 亿 token 谁来审?
这些埋进去的事实点还有第二个身份,它们就是判卷用的标准答案。而 AI 答题的时候一个都看不到:它面前只有那堆 Word 文档,得靠搜索加推理,把散落在各处的线索一条条挖回来,再拼成答案。

合成的能有多真?我下载了一份来看,second-request-strategy-memo.docx,66KB,344 个段落,是一份完整的律师备忘录:抬头写着「保密·律师工作成果」,正文引 15 U.S.C. § 18a 的法条,写明 2024 年的申报门槛是 1.195 亿美元、申报费 16 万美元,从 6 月 4 日签购买协议、6 月 18 日申报、7 月 8 日监管来要材料、7 月 16 日发出正式问询,时间线一天不差,人名公司名前后完全对得上。
The initial 30-day statutory waiting period under the HSR Act was set to expire on July 18, 2024. However, on July 8, 2024, the FTC's Bureau of Competition, Mergers IV Division issued a voluntary access letter … We produced 23 supplemental documents on July 10, 2024, in response to that voluntary access letter.
250 道题都是律师日常真会问的
档案有了,题目出成什么样?这 250 道题模拟的是律所平时向自家文档管理系统提的要求,所以全是大白话,一句话就说完,跟合伙人早上路过工位随口交代一件事一模一样。

我从仓库里读了真实的题目文件。第 1 题的原话是:「我在整理我们反垄断组里引起监管审查的交易,把所有收到 HSR 第二次问询的案子都拉出来,连带问询往来函件。」
美国的并购到了一定规模要向监管机构申报,监管觉得可能影响竞争,就再发一份正式文件要更多材料,交易得停在原地等它审完。像签证材料交上去被要求「补件」,不是拒签,但你的行程从这一刻起没有确定的日期了。
这题的标准答案有 11 条,长这样:
注意最后那条:连出题人自己都得专门写一段,说明哪些案子算、哪些不算。
但档案里没有目录,AI 只能一份份读
还有一件事得先说清楚:每一道题,AI 面对的都是整个文件系统,266 个案子全摊在那儿,没有人事先告诉它该去哪几个案子里翻。
Agent 手上有六样工具:跑命令、读文件、写文件、改文件、按文件名找、按内容搜。grep 是给了的,问题是没词可搜。
我核对了这个文件系统:dms/matters/ 下面就是 266 个纯数字目录,没有索引、没有客户名单、没有业务领域对照表、没有任何一份元数据文件。你想知道 1003 号客户叫什么名字、属于哪个业务领域、这案子最后成没成,只能一份份打开 Word 去读正文。
「我们反垄断组的哪些案子收到过第二次问询」这种题,你搜「second request」会命中一大片,但「这个案子算不算反垄断组归口的」这件事,档案里没有任何一个字段写着。得把文件读完才判得出来。上一节那条「另有三个案子报不报都不扣分」的说明,正是因为这个边界连人都得费口舌才说得清。
而且规则是:漏一条就算零分
每道题的标准答案被拆成一条条只有过和不过的判分点,由一个 AI 裁判逐条判(用的是 claude-sonnet-4-6,温度调到 0,只看意思对不对,不做关键词匹配)。全部通过才得 1 分,漏一条就是 0 分,没有部分分,这套规则官方叫 all-pass(全对制)。
为什么定得这么严?理由是:
在法律的实际交付场景里,平均分是误导性的。一份尽职调查备忘录抓到了 95% 的问题、漏掉一个实质性的,它不是「95% 有用」,它是错的。 Harvey LAB 评测方法文档
那个漏掉的问题可能改变交易价格,可能逼你在交割前推倒重做,也可能在交割之后炸出来。
像飞机起飞前的检查单:99 项都查了、漏了一项没查,这架飞机不能算「99% 可以飞」,它就是不能飞。
结果两个最强的模型都没及格
规则说完了,看分数。Harvey 用 LAB 的标准执行框架跑了两个模型:
| 指标 | opus-4.8-high | gpt-5.6-sol-high |
|---|---|---|
| 单条判分点通过率 | 71.7% | 79.1% |
| 全对率 | 24.4% | 36.0% |
| 每题中位耗时 | 475 秒 | 406 秒 |
| 每题中位成本 | $1.26 | $1.66 |

单条判分点能答对七八成,看着还行;但换成「这道题一条都没漏」的口径,就只剩两三成了。475 秒是差不多八分钟,一道题。按中位成本估算,把 250 道题跑完一轮大概三百多美元。两个模型能解开的简单题基本重合,各自又能啃下一些对方啃不动的难题。
模型会答的照样会答,一条不漏就崩
光看总分还不够。把这 250 道题按「标准答案有几条」分成四档再看,两条曲线的走向完全相反。
另一个模型 gpt-5.6-sol 撑得久一点,全对率从约 51% 降到 27%、再到 20% 左右,但到了「26 条以上」那一档,同样是 0%。
直觉上算一下就明白了:单条通过率 71.7%,要 26 条条条都中,是 0.717 连乘 26 次,约等于万分之二。模型在难题上并没有变笨,真正惩罚它的是「全对」这个要求本身:清单越长,全中的机会掉得越快。(这笔账只为给读者一个直觉,判分点之间并不完全独立,找到一个案子往往一次就满足好几条,实际概率不能这么直接算。)

病根是 AI 不知道自己搜完没有
那到底是哪儿出了问题?Harvey 复盘了 Agent 干活的全过程,结论和直觉相反:
模型对它找到的东西,推理基本是对的;错在没能把每一条相关的信息都找齐。而且这不是搜索策略的问题,它稳定地能找到核心信息、满足其中一部分标准。它缺的是「我还该不该继续找」的判断力。
这个毛病在「给我列一大串」的题上尤其致命,上面那张图里断崖最陡的部分,正是这类题。
Harvey 由此推出的根因是:Agent 没有在脑子里建立起一个关于「这个档案库里到底有些什么」的模型,所以它没有依据判断自己搜得够不够彻底。
它像一个刚入职第一天的助理:每一份文件递到手上都能读懂、都能分析对,但他不知道档案室里总共有多少东西,也就永远不知道自己翻完了没有。你问他「都找齐了吗」,他只能说「我找到的都在这儿了」。
Harvey 的出路:先把档案读成索引
法律这行干活,本质上要判断手头的问题跟过去做过的事是什么关系:哪一条先例对这个客户适用、市场上的通行做法是什么样。而今天的 Agent 是每接一个任务,就从头把这些知识推导一遍,这套打法在企业级的知识规模下又贵又弱。
他们看好的方向就是这个:让 Agent 先把档案读成一份自己的索引,再去答题。因为这个环境是持久的,同一堆档案要被问 250 次,一次性的「读懂成本」摊下来能回本。这方面还会有更多东西放出来,而合作方 Engram 正是做 AI 记忆层的公司,今年 6 月刚带着 9800 万美元融资出关。
Harvey 自己也说清了这份数据集的边界:目前只覆盖了律所工作的一部分,250 道题也只是律师会问的问题的一个子集,以后还会继续加。另外从运行记录看,成本和耗时都会随着档案规模继续往上走,而真正的企业级档案库,能比这家假律所大好几个数量级。
两个顶尖 AI 翻遍一整间假律所的档案,还是拼不出一条不漏的答案
Harvey 造了一间 9,288 份文档的假律所考 AI,这页图讲完两个顶尖模型输在哪
↓ 一页读完 · 有一张会动的图
Harvey 凭空造了一家不存在的律师事务所,把它的全部档案原封不动放上 GitHub,配 250 道题,让 AI 进去找答案。
一个客户可能有好几个案子,一个案子常常要拉好几个业务组的人一起处理,这套结构照真实律所的乱法搭的,文件夹故意不统一。
出题人给了 AI 搜索工具,问题是没有词可搜。目录下面就是 266 个纯数字文件夹,没有索引、没有客户名单、没有任何说明,案子是谁的、算不算某个业务组的活,只能打开文档一份份读正文才知道。
连出题人自己都要在标准答案里专门写一段,说明这道题里哪些案子算、哪些不算。
标准答案被拆成一条条判断点,由 AI 裁判逐条打分:全部通过才算这题对,漏一条就是零分,没有中间分。
Harvey 拿两个最强的模型跑了一遍:opus-4.8-high 和 gpt-5.6-sol-high。单条判断点它们都能答对七八成,可要求一条不漏,就只剩两三成。
以上跑分数字来自 Harvey 自测的 LAB 评测框架,尚无第三方复现;一道题中位要花 400 多秒、一两美元。
Harvey 复盘了 AI 的操作记录:它找到的东西,推理基本是对的,错在没能把每一条相关信息都找齐。根子是它心里没有「这个档案库里到底有多少东西」的谱,所以判断不出自己搜得够不够。
出路是让 AI 先花一次力气把档案读成索引、摘要、记忆,再去答题,同一堆档案要被反复问 250 次,这笔前期成本摊得开。
- × 客户名单
- × 业务领域表
- × 任何说明