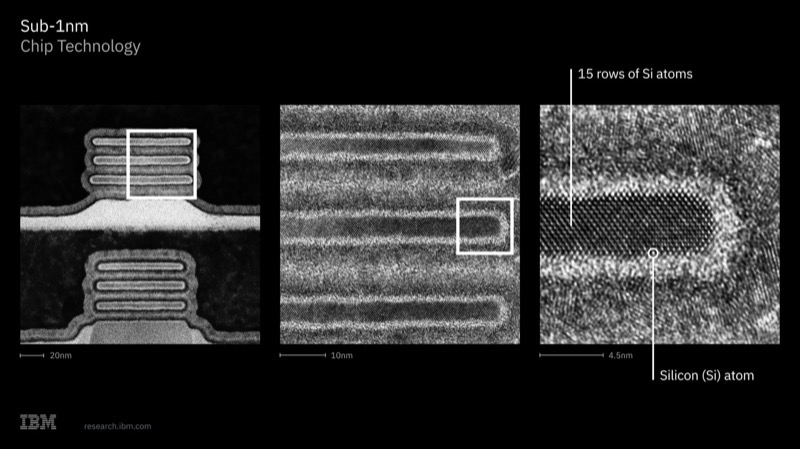
IBM 发布全球首个 0.7 纳米芯片,指甲盖塞进近千亿晶体管
全球首个 sub-1 纳米逻辑芯片
40 多年来,芯片靠把晶体管越做越小往前走,如今尺寸已逼近单个原子。这是第一次跨到 1 纳米以下,而 IBM 用的办法不是继续缩小,是把晶体管竖着叠起来。
- IBM 发布全球首个 sub-1nm 芯片技术,节点命名 0.7 纳米(7 埃),指甲盖大小集成近千亿晶体管,密度约为 2021 年 2nm 芯片的两倍。
- 核心创新是新晶体管架构 nanostack:不再靠缩小平面尺寸,而是把晶体管 3D 垂直堆叠、错位排布,业界第一个三维 nanosheet 架构。
- 三个关键手段:往上叠+错位、3D 顺序集成、每层用不同材料独立优化。
- 已通过功能性 CMOS 反相器等实验验证可制造;性能 +50% 或能效 +70% 是相对 2nm 的预测值、且二选一。
- 瞄准生成式 AI、云基础设施和下一代终端设备;IBM 称最快 5 年量产,路线图看至少十年微缩。
要懂它的创新,先看这道坎有多难
跨过 1 纳米之所以是里程碑,是因为老路真的快走不下去了。几十年来,芯片提升性能的办法一直很直接:把晶体管做得更小,同一块芯片上就能塞下更多,算力和能效跟着往上走。问题是,晶体管尺寸如今已经逼近单个原子的量级,平面上继续缩小越来越接近物理极限,这条「再缩小」的老路快走到头了。
IBM 这次没有沿老路硬挤,而是换了一个维度:不在平面上挤,往垂直方向叠。下面这张图,点四步看它怎么把同样面积的晶体管数量翻上去。
老办法:晶体管在同一个平面上铺开,要更多就只能各自缩得更小。可现在已经撞到「原子墙」,没多少空间再缩了。
nanostack 的第一招:往上叠,还错开排。在原来那层之上再叠一层晶体管,并让上下层错位(IBM 叫 staggered,错位沟道),占地不变就多塞一倍。
第二招:每层换不同材料。上层这批晶体管可以用和下层不一样的材料,各挑最适合自己的,独立优化性能和功耗,互不迁就,这是平面架构给不了的。
结果:同样指甲盖大小,塞进近千亿个晶体管,密度约为 2021 年 2nm 芯片的两倍。
就像一块地皮上的平房改成错层叠放的多层楼:占地(芯片面积)不变,靠往上叠容纳更多住户(晶体管),而且每层还能按需装修成不同户型(不同材料)。
那 IBM 是怎么做到的:nanostack 三招
把晶体管竖着叠起来、还错开排
传统架构里,晶体管全挤在一个平面上,要更多就只能缩小尺寸。nanostack 把晶体管沿垂直方向 3D 堆叠,并且上下层staggered错位排布。同样的占地面积,靠往上叠就能放下更多,这是业界已知第一个三维、基于 nanosheet(纳米片)的晶体管架构。
错位排布不是随便叠:错开能让上下层的连接、散热和信号路径排得更合理,VLSI 2026 上 IBM 那篇专门讲的就是「错位沟道」的 SRAM 单元设计。
不是把两片粘起来,是一层层往上「集成」
叠芯片这件事,难的从来不是「叠」,是「怎么叠得准、叠得能用」。nanostack 用的是 3D sequential integration(3D 顺序集成):在已经做好的下层之上,分步把上层晶体管直接集成上去,而不是分别做好两片再对位粘合,上下层因此天然对齐。
这套已经用超薄介质键合(ultra-thin dielectric bonding)在实验里把完整的 CMOS 集成跑通了,做出的不是设计图,是能正常开关的功能性电路。这一步是「能不能造出来」的命门。
每个堆叠层,用各自最优的材料
平面架构上,所有晶体管被迫共用同一套材料和工艺,互相将就。叠成多层之后,每一层可以用不同的材料组合,上层管和下层管各自挑最适合自己的材料,各自独立优化性能和功耗,互不拖累。
这是「往上叠」额外解锁的自由度,也是 IBM 把它定义为「结构 + 材料双重创新」的原因:不只是空间堆出来的密度,还有材料分层带来的性能和能效空间。

已经在实验室造出来跑通了
三项实验各自说明了一件事:
| 验证项 | 说明白了什么 |
|---|---|
| 超薄介质键合的 CMOS 集成 | 层与层之间能用极薄介质连成完整 CMOS,堆叠结构真能做出来 |
| 双沟道工程能力 | 能在堆叠结构里同时控制上下两层沟道,多层一起工作可行 |
| 功能性 CMOS 反相器 | 最基本的逻辑单元能正常开关,且开关性能符合预期,不只是能通电 |
另外在 VLSI 2026 上,IBM 展示了 nanostack 让 SRAM(芯片上的高速缓存)微缩 40%。SRAM 越密,同样面积能放下越多缓存,正好对上先进 AI 负载「要海量数据、要高带宽」的胃口,这一条直接指向 AI 芯片。
这对谁有用:0.7nm 能换来什么
这颗芯片瞄准的是生成式 AI、云基础设施,到下一代电子设备的算力需求。相对 2nm,它的性能和能效是「二选一」的关系,看你怎么用,不能同时拿满,点下面切换感受这个取舍。
同样功耗下,算得更快。对应到 AI,就是同样一台机器,训练和推理的吞吐更高、跑大模型更快。
同样性能下,更省电。AI 数据中心今天最硬的瓶颈之一就是电和散热,能效提升直接打在这个痛点上。
密度和能效的提升,对两类场景意味着:
密度约两倍,意味着同样面积能塞下接近两倍的算力;或者反过来,同样算力大幅降功耗。AI 训练推理的成本和散热如今主要卡在功耗上,能效这一头的提升最值钱。
同样的电池和体积下,手机、PC、边缘设备能跑得动更强的本地 AI 模型,或者把续航做得更长。
关键数据
以下为厂商预测或路线图,非实测:
| 数字 | 含义 |
|---|---|
| +50% | 性能提升(相对 2nm,预测,与能效二选一) |
| +70% | 能效提升(相对 2nm,预测,与性能二选一) |
| 最快 5 年 | IBM 给出的量产时间(路线图) |
| 至少 10 年 | 制程路线图可继续微缩的时间 |

IBM 的制程历程
研发在纽约 Albany 半导体研究中心进行,即将引入 ASML 的 High NA EUV 光刻设备,合作方包括 Lam Research、东京电子、SCREEN。

我们不只是在做更小的晶体管,我们在重新发明芯片的建造方式。 Jay Gambetta,IBM 研究院总监(IBM 新闻稿,2026-06-25)
芯片变强靠越做越小 → 这次 IBM 改成往上叠
IBM 发布全球首个 0.7 纳米芯片,靠把晶体管垂直堆叠,让指甲盖大小塞进近千亿个,这一页带图讲清它是什么、怎么做到、有啥用、哪些数字先别全信。
↓ 一页读完 · 有一张会动的图
先说芯片是怎么变强的。这几十年就一个套路:把芯片上负责通断电的最小开关,晶体管,做得越来越小,同一块芯片就能塞下越多,算力和省电一起往上走。可这条路,如今快走到头了。
IBM 这次没在老路上接着硬挤,而是换了个方向,平面上塞不下,那就往上叠。这套新造法叫 nanostack(把晶体管一层层竖着堆起来的新架构),是业界第一个真正做成三维的晶体管结构。
↑ 撞上原子墙,缩无可缩
↓ 占地不变,数量翻倍
可芯片叠起来向来最难:怎么叠得准、叠完还能正常通断电?下面一张图看它怎么做到。
nanostack 的关键,不是把晶体管做得更小,而是重新设计芯片「怎么造」。招数其实就三个,一张图串起来看。
IBM 给的官方口径是「性能最高 +50%」「能效最高 +70%」,可百分比没人有体感。把它换成同一个 AI 计算任务、新旧芯片各要用多少电,差距就看得见了,
越塞越多
一起往上涨
单个原子了
新招叫 nanostack
把晶体管竖着堆
三维结构
还能通电吗?
约 2nm 两倍