视频生成快过播放:fal 对 MiniMax H3 后训练后 让其能实时生成视频
fal 在开放权重 MiniMax H3 上继续后训练,并让模型与自有推理栈共同优化:5 秒视频约 3 秒返回,15 秒内容可以在播放结束前生成下一段。
- H3 Max 把 5 秒 768p 视频压到约 3 秒返回,使生成速度在部分请求上快过内容播放。
- fal 在开放权重 MiniMax H3 上继续后训练,并让模型与自有推理栈共同优化。
- H3 Max 在带音频图生视频榜单领先,并支持文字、图片、首尾帧和参考素材驱动的视频生成。
- 常规 768p 价格为每输出秒 0.08 美元;实时系统要靠缓冲、缓存、失败回退和成本控制才能长期运行。
独立开发者 Pieter Levels 转发了一段 Twitch 直播:屏幕里的动画不是预先排好的播放列表,而是由视频模型一段接一段生成。演示者 Rehan Sheikh 把 fal 的 MiniMax H3 Max 接进直播管线,让观众看到一档可以继续生成的“跨维度电视”。
Levels 把它称作 AI 视频生成的一个历史时刻,也给出了一个脑洞大开的思路:过去生成 15 秒视频常要等 2—5 分钟,这套系统可以在 9 秒内返回 15 秒内容。下一段视频可以在当前一段播完前准备好,直播也就不必依赖提前做完的节目单。观众的投票、聊天和选择都可以进入下一轮生成;同一个角色可以走进不同世界,每个人甚至可以拥有一条只为自己继续生长的频道。视频由“做完再看”的文件变成一边观看一边运行的内容系统,可玩性和想象空间随之大幅打开。
这套直播调用的是 fal 推出的 H3 Max。它建立在开放权重 MiniMax H3 上:H3 能把文字、图片、视频和音频放进同一上下文,并直接生成带同步声音的视频;fal 在这个基础上继续后训练,再让模型与自家的推理系统共同优化。
H3 Max 的速度来自 H3 已有的多模态能力。统一输入、2K 生成、原生音频和开放权重决定了 fal 可以继续训练什么,也决定了 H3 Max 与标准 H3 各自适合的任务。
当生成时间短于播放时间
一个 15 秒片段若要生成两分钟,产品只能让用户等待,或者提前批量生产。生成只用 9 秒时,系统可以在播放片段 A 的同时生成片段 B;片段 A 结束前,片段 B 已进入缓冲区。这个循环继续运行,生成模型就从交付单个视频文件的工具,变成持续供给画面的实时组件。
这里的“实时”不要求每一帧都像游戏引擎那样即时渲染。它要求生产速度长期追上消费速度。片段时长是 15 秒,端到端生成低于 15 秒,系统便有正的时间余量;再加一个或两个片段的缓冲,就能吸收部分延迟波动。
长期运行还需要保持人物、画风和情节衔接;请求失败时播放备用片;把聊天输入转成下一段提示;持续控制内容与成本。峰值并发和全天候可靠性也要由整套直播系统承担。
H3 Max 是怎样来的
fal Research 从开放权重 MiniMax H3 出发,加入新数据做后训练,重点强化提示词遵循、画面审美和视听质量;fal 的推理团队同时围绕自家推理引擎调整模型和服务路径。
统一多模态 + 原生音频
提示遵循与美学
吞吐与延迟
托管端点
后训练决定模型更倾向生成什么。fal 在训练中加入真实生成工作负载、人类偏好和可验证的强化学习任务,并把整体偏好、提示理解和美学分别评估。推理优化则让同一个请求更快完成,涉及模型执行、采样过程和底层系统。
两支团队在模型定型前共同调整质量与速度:研究团队把延迟目标带进后训练,推理团队围绕最终权重做专用优化。fal 的目标是在保持内部质量评测领先的同时提高吞吐,而不是简单削减采样步骤。
基座 H3 的统一多模态上下文和原生立体声音频也被保留下来。输入可以同时描述画面、镜头与声音,输出直接带同步音频,短视频生产因此少了单独生成配音、环境声和对齐音轨的步骤。
fal 用一段 15 秒“1984”视频展示文字、构图和连续运动的组合控制:画面里的排版、印章和字符随着镜头连续变形。
fal 随后用六段视频分别展示低机位追踪运镜、首尾帧过渡、同一角色跨六个场景、原生同步音频、跨镜头风格保持,以及按顺序完成复杂提示词。
fal 还展示了六组“一条提示词、一次生成、没有后期”的成片:连续灾难长镜头、旧式像素跑酷、对镜台词与口型、黏土动画、蜂鸟慢镜头和咖啡产品特写,覆盖电影镜头、游戏画面、人物表演、风格化动画、自然摄影和商业产品六种用途。
把这些能力写进提示词,可以按“主体与素材、镜头与运动、声音与节拍”三层组织,让模型同时知道拍什么、怎样拍,以及声音怎样跟着画面推进。
2.5 秒、3 秒、9 秒和 35 倍分别指什么
fal 的 5 秒、768p 文字生视频请求在示例中记录了 timings.inference = 2.5286 秒,图生视频为 2.7652 秒;常规规格是 wall time 少于 3 秒。timings.inference 记录后端去噪推理,端到端体验还会叠加排队、网络传输、输入上传和提示词扩写。
Levels 展示的是 15 秒视频在 9 秒返回;fal 对 15 秒生成给出约 15 秒的一般预期。两个数字可能来自不同请求、提示复杂度、系统负载和记录方式。交互产品可以把 9 秒视为已经出现过的演示结果,把 15 秒作为更稳妥的初始预期,再用自己的请求日志校准。
fal 测得 H3 Max 的吞吐约为 MiniMax 官方 H3 端点的 35 倍,并且平均比质量相近的模型快 15 倍。实际产品还要记录每次响应的 timings.inference,以及端到端 P50、P95、失败率和排队时间。
提示词扩写也会改变体感速度。fal 建议使用 768p、5—10 秒和 balanced 模式;fast 扩写约一秒,quality 模式的改写本身可能用到 30 秒。交互应用需要分别记录提示处理、排队、推理、传输和首帧播放。
H3 Max 在两份图生视频榜单领先
fal 把 H3 Max 与 12 个视频模型做成对比较,分别评估整体偏好、提示遵循和画面美学,再用 Bayesian Elo 和 95% 置信区间汇总。H3 Max 在三项中都排第一,并且对每个参测模型都赢得多数一对一选择。
Design Arena 当时将 H3 Max 排在图生视频榜首,1341 Elo。Artificial Analysis 当时以 H3 Turbo 768p 这一名称记录它,1201 Elo、±11、2177 个样本。
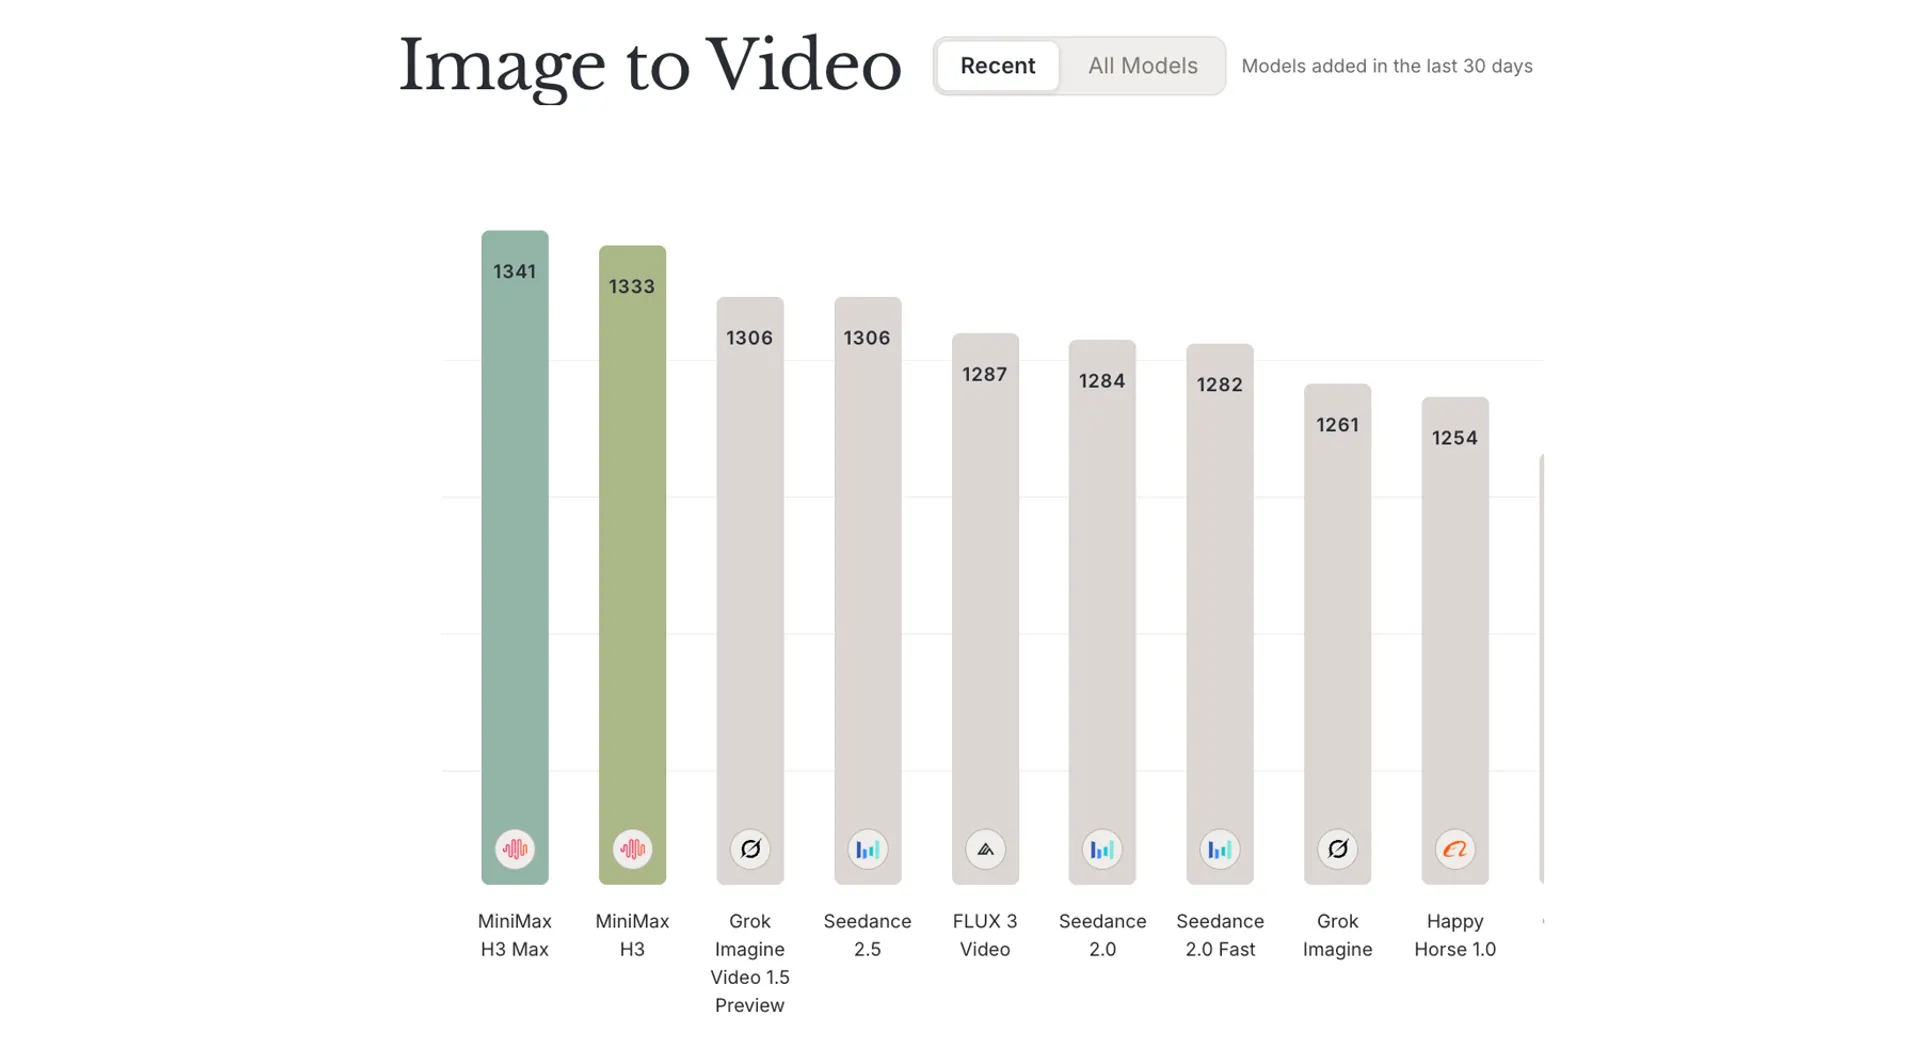
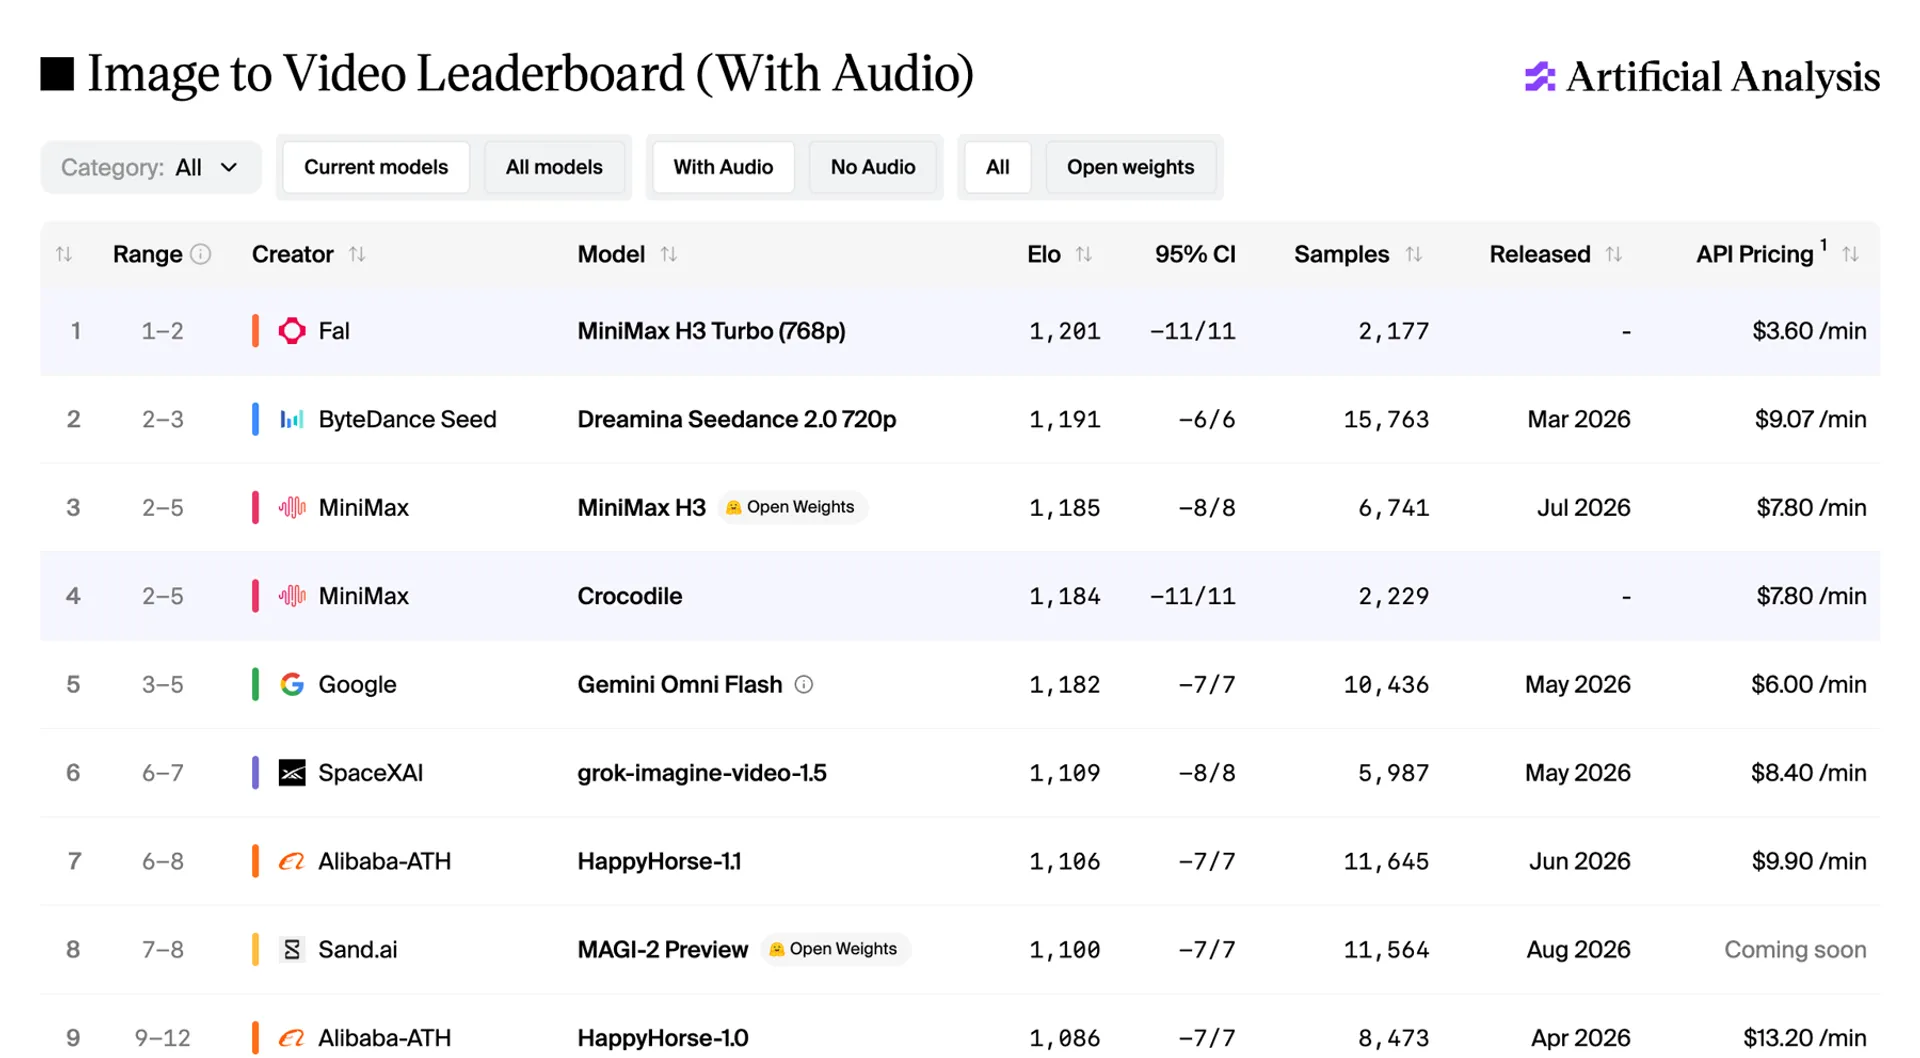
到 2026 年 9 月 1 日,Artificial Analysis 的“带音频图生视频”榜单中,H3 Max 以 1203 Elo、95% 置信区间 ±9 和 5400 个样本位列第一。第二名 Dreamina Seedance 2.0 为 1190,标准 MiniMax H3 为 1185,Gemini Omni Flash 为 1179。榜单会随着新投票继续更新。
对比 12 个模型整体偏好 / 提示理解 / 美学
5400 样本2026-09-01 带音频图生视频榜首
Artificial Analysis 评测的是带音频图生视频。文字生视频、视频编辑、15 秒长镜头和角色跨片段一致性属于其他任务,需要分别测试。
H3 Max 和标准 H3 怎么选
H3 Max 主要运行在 480p 与 768p,768p 是调优重点。16:9 输出为 1344×768、24fps,单次 5—15 秒,原生同步音频。fal 已提供文字生视频、图生视频、首尾帧控制和参考生视频端点。
标准 MiniMax H3 支持 2K、最长 15 秒,并有更完整的多模态参考与视频编辑能力。它的基座权重已经开放,适合需要自托管、研究或定制训练的团队。H3 Max 使用同一开放基座,目前通过 fal API 使用。
| 需求 | 更合适的选择 | 原因 |
|---|---|---|
| 快速预览、交互叙事、直播片段 | H3 Max | 5 秒片段约 3 秒,提示遵循和 768p 输出优先 |
| 2K 成片 | 标准 H3 | H3 Max 上限为 768p |
| 自托管、研究、自己微调 | 标准 H3 | 标准 H3 开放基座权重;H3 Max 提供托管 API |
| 精细视频编辑 | 标准 H3 | 标准 H3 提供更完整的编辑端点 |
| 参考图、视频、音频快速生成 | H3 Max reference-to-video | 当前端点已上线,参考输入另行计费 |
互动原型优先低延迟、足够清楚和稳定响应;广告片、电影镜头和后期制作更看重分辨率、可编辑性与跨镜头控制。团队可以先用 H3 Max 快速探索,再把少数确定镜头交给标准 H3 或后续制作流程。
价格决定它能跑多久
fal 的 768p 常规价格是每个输出秒 0.08 美元:5 秒 0.40 美元,15 秒 1.20 美元。9 月 1 日,端点仍显示首发五折,每秒 0.04 美元,并注明折扣当天结束。免费额度会随登录状态和输出分辨率变化,使用时以账户界面为准。
按常规价持续生成,一小时输出 3600 秒视频,模型费用约 288 美元;全天不间断约 6912 美元,还要加上失败重试、参考输入、编排服务和推流。参考生视频会按参考输入 tokens 计费,参考视频可能让输入成本超过输出成本。
持续直播可以加入用户触发、分支预生成、热门片段缓存、低活跃时降频和失败回退,让算力投入与实际观看或交互相匹配。
搭建原型可以从五个动作开始:
- 用 5 秒、768p 和
balanced模式建立稳定基线。 - 在提示词中同时写清主体、动作、镜头、时间节拍和声音。
- 保存
expanded_prompt,确认扩写没有改变原意。 - 同时记录端到端延迟与
timings.inference,连续运行几十次后查看 P95。 - 为连续生成预留至少一个片段缓冲,并准备超时或失败时可播放的备用内容。
视频模型开始进入“运行时”
过去的视频模型主要缩短制作周期:几分钟后交付一条广告、一个镜头或一版概念。H3 Max 把另一种时间尺度带进产品设计:模型可以在用户观看、选择或输入时继续生产下一段内容。
持续直播只是最直观的例子。互动故事可以根据观众投票生成下一幕;游戏可以在玩家阅读选项时并行预生成三个分支;电商和广告工具可以让创作者连续试镜头而不用离开当前工作流;教育内容可以按学习者的回答即时改写下一段演示。
一套持续运行的视频系统还要维护世界状态,决定哪些信息进入提示词,检查输出,拼接声音与画面,控制预算,并在延迟突增时继续播放。H3 Max 提供了其中最稀缺的一项条件:高质量短视频的生产速度接近、并在部分请求上超过它的消费速度。
当这个不等式稳定成立,AI 视频的单位就不再局限于生成好的文件。它可以成为软件运行时持续调用的一种媒介。