Spotify 刚公开了一套 Claude Code 分流方案:大文件读取上下文减少约 90%
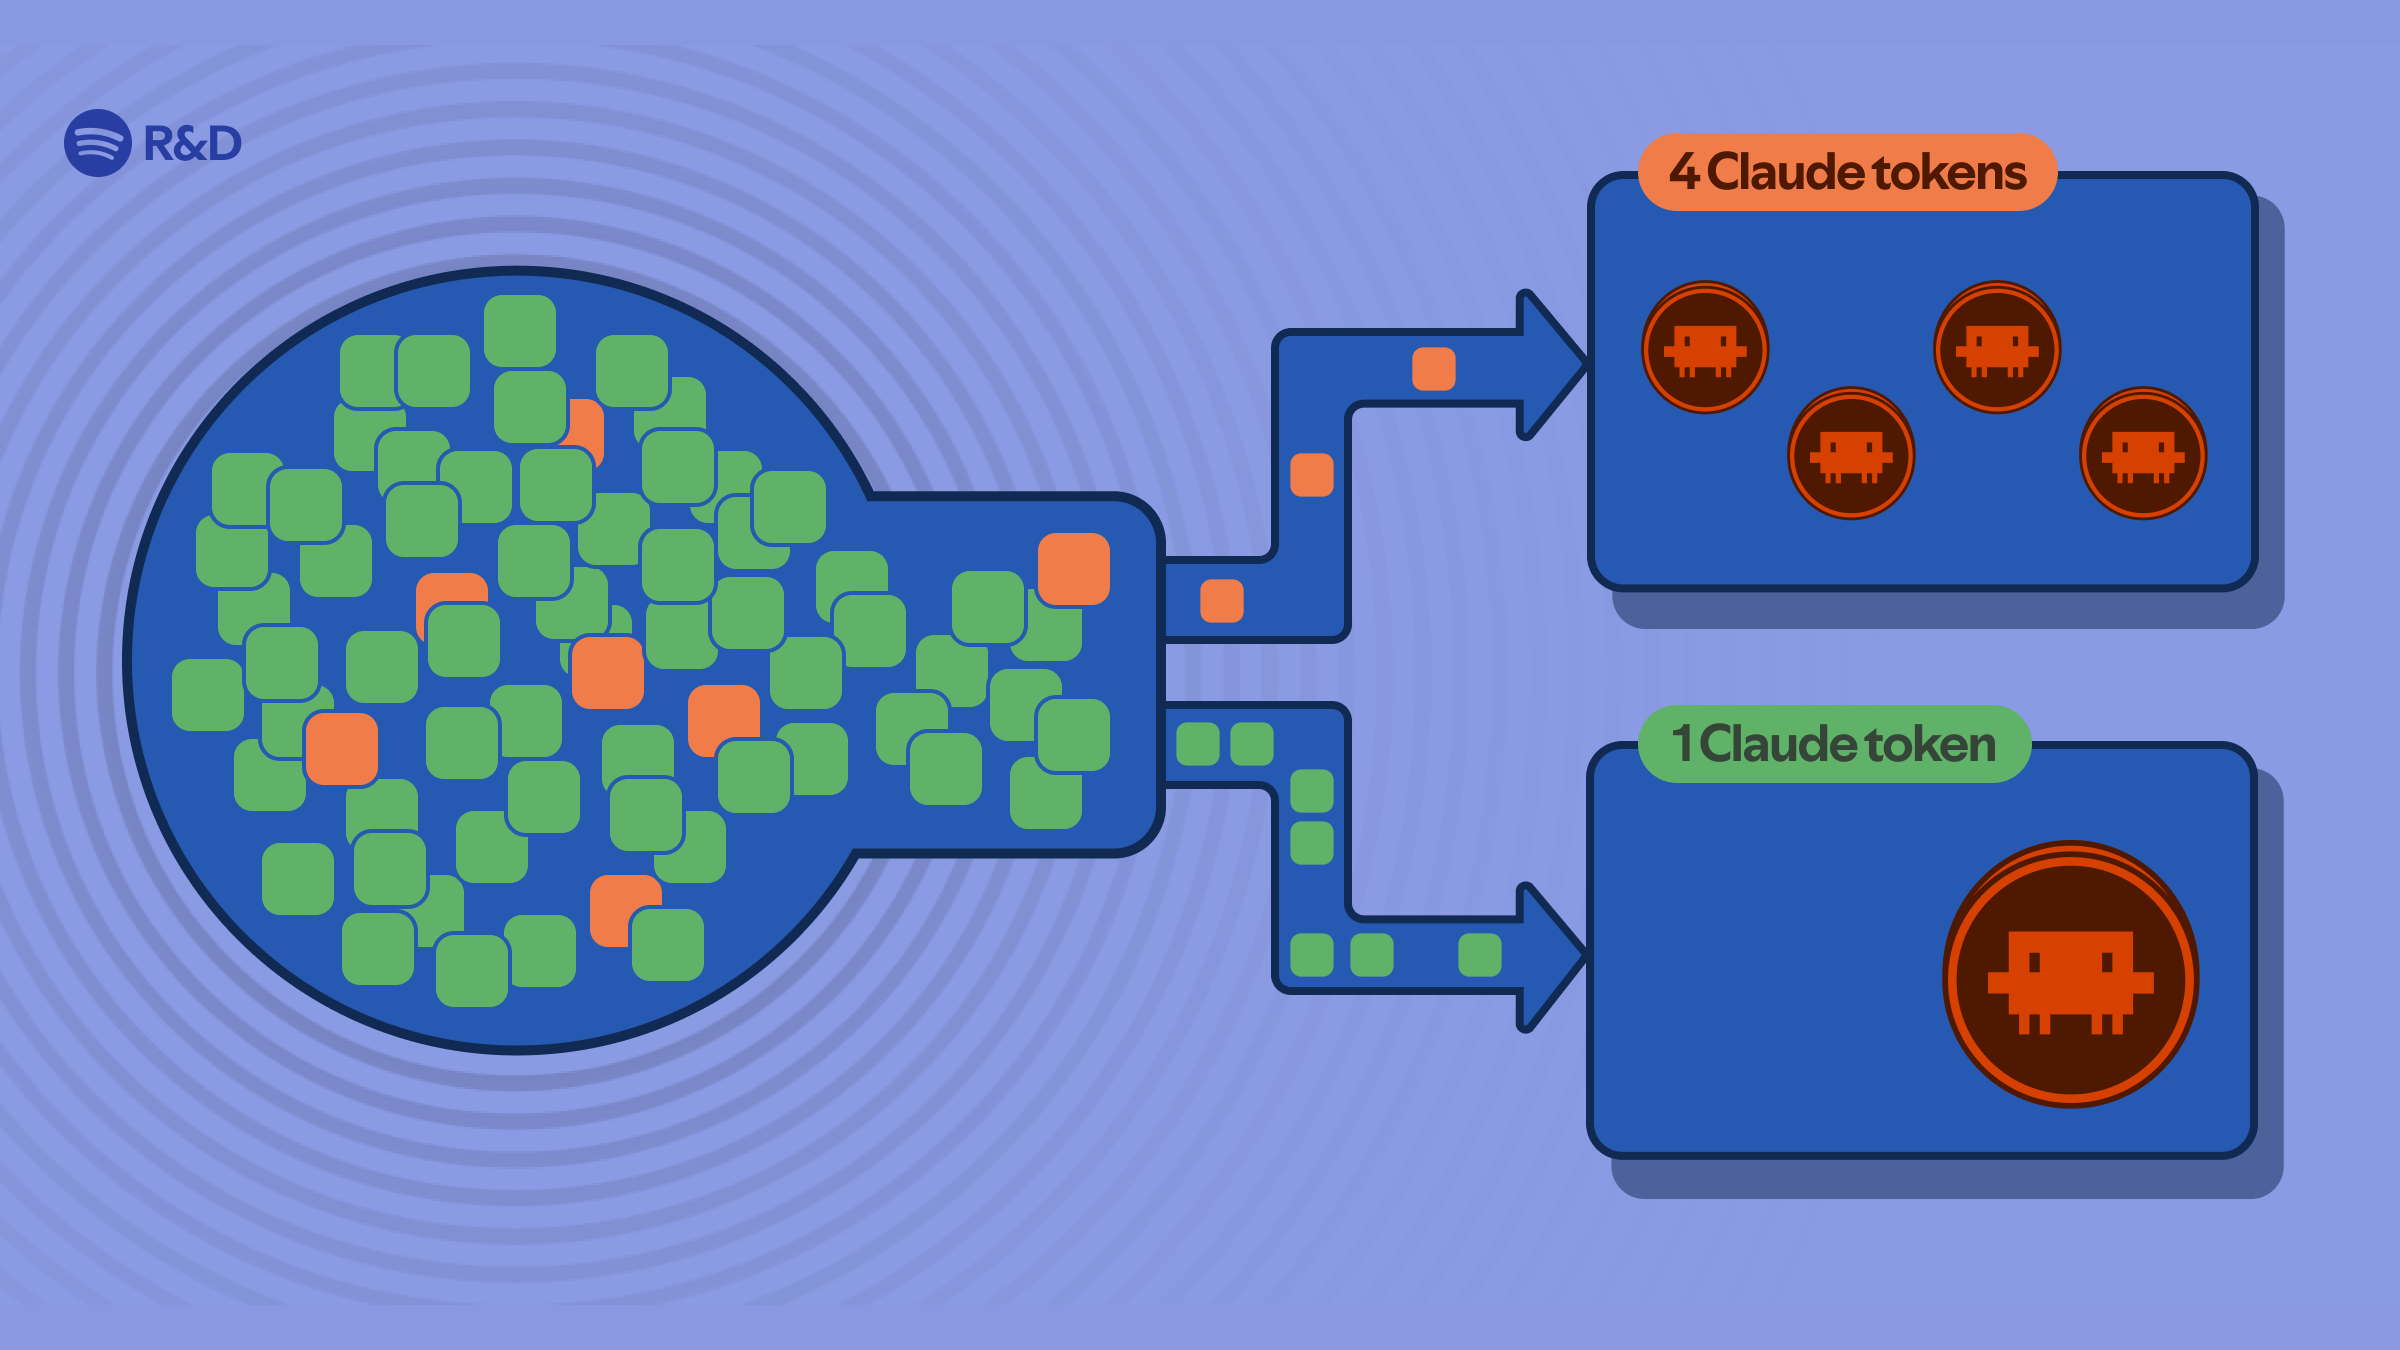
很多人以为 Token 都花在思考上,实际大量消耗在长文件搬运上。Spotify 首席产品经理 Dimitri Mazmanov 开源了分流插件 shunt,通过让辅助模型承担大文件通读与样板生成,在测试中让进入 Claude 主模型的大文件读取上下文减少约 90%,把上下文留给核心推理。
- 消耗根源:Claude 为定位少量代码可能先读入数千行大文件;长文本进入上下文后不仅占用窗口,还可能推高后续轮次的输入成本。
- 模式分工:通过云端无状态模式分担体力活。大文件读取只向主模型返回提炼后的定位要点;样板生成则结合需求与参考文件,支持将代码直接写入本地磁盘。
- 协同机制:默认对超过 350 行且未指定范围的单文件全读发起 Hook 拦截,引导主模型按 Skill 说明调用本地 Script 派发;样板生成无强制拦截,依赖主动规划。
- 收益与边界:进入主模型的读取上下文在测试中平均减少约 90%,但辅助模型调用与后续审查仍有开销;精密修改与并发隐患仍需主模型定向查阅源码。
钱花在哪了:Claude 为找几行代码,先读了几千行
Spotify 刚公开了一套给 Claude Code 分流的办法。在一个 16.2 万行代码的 Java 项目测试中,它让大文件读取时进入 Claude 主模型的上下文内容平均减少了约 90%。很多人以为,付费的 Token 都花在 AI 思考上。Token 是模型处理文字时使用的计量单位,也常用来计算调用费用。实际上,不少 Token 耗费在读长文件、找调用位置、照着已有代码生成样板等搬运工作上。
想象一个具体场景:你只想查“付款成功后,短信通知在哪里触发”,本以为它会快速翻到那两三行给出答案,它却为了理清来龙去脉,可能先把几个动辄数千行的大文件从头读完。这里的 Claude Code,是一款能在项目文件里查找、修改代码的 AI 编程助手。可当它把几千行代码读进会话上下文(即模型本次回答能参考的对话和材料)后,不仅占据了上下文空间,长文本还可能继续增加后续交谈的输入开销。
用主模型做这些机械读取,往往会带来不必要的开销。原文援引的行业数据称,四分之一的工程领导者面临每名开发者每月 200–500 美元的 Token 支出,有的甚至超过 2,000 美元。需要明确的是,这项方案所达成的“约 90% 降幅”,严格限定在三项大文件读取测试中进入主模型上下文的内容减少约 90%,并不等同于开发全流程或月度总账单直接下降 90%。
通读长代码查找一个名字,或者照着旧代码依样生成样板,本质上是耗费上下文的基础读取工作。面对这种消耗,Spotify 首席产品经理 Dimitri Mazmanov 给出的解法是建立分工:主助手把查资料或照样子写文件交给其他辅助模型,自己只保留关键要点来做判断。
先把两类体力活分出去:读文件和写样板
在 Spotify 的开发者门户产品 Portal 中,有一项名为 AiKA 模式(Modes)的能力。用户可以为特定任务配置专门的辅助模式,指定清晰的任务指令,并绑定相应的辅助模型(例如 Gemini 2.5 Flash 或其他轻量模型)。这些模式按次调用、即用即退,不保留跨轮会话记忆。
直接读取(未分流)
接收代码全文(挤占上下文)
委托辅助模型(分流)
接收摘要与调用信息/状态
分流不代表全文消失。代码全文被发给云端辅助模型处理,摘要由辅助模型生成,本地脚本只负责转交摘要;辅助模型按其费率计费,分流仅减少涌入 Claude 主模型上下文的文字量。
把文件交给辅助模型,并不代表长文本凭空消失。核心差异在于工作如何流转:代码文件保存在本地电脑上,本地运行的脚本读取文件后,通过网络发给云端的辅助模型。辅助模型通读全文后,把提炼出的关键事实交还给本地脚本,再由脚本转交给 Claude 主助手。主模型上下文接收的是调用相关信息与精简后的要点,长文本的阅读工作被转移了出去,费用也按两边模型各自的费率分别计算。
针对最占上下文的两类工作,方案分别设置了对应的辅助模式:
大文件阅读模式(bulk-reader)
该模式专门用于通读长代码并提取事实。它的提示词明确要求禁止寒暄与长篇大论的总结,每条要点必须直接以类名、方法名或行号开头。这里的方法,通俗来说就是完成某项操作的一段代码。提示词虽然要求简明扼要,但并不能保证每次返回的内容绝对精简、读全每一行或完全正确。主助手拿到这份摘要后,可以先回答当前的初步定位问题;若涉及精确条件判断或动手修改代码,仍需回看相关原文。
以定位付款短信为例(以下为假设教学示意,非实际运行结果或项目源码):
- 输入:本地脚本将
PaymentService.java(约 3,200 行)与NotificationService.java(约 1,800 行)全文发给云端模式,并附带问题:“付款成功后,短信通知在哪个方法中触发?请指出相关类名与方法名。” - 辅助模式返回要点:
PaymentService.java:processPayment()方法在处理交易时调用了NotificationService.sendPaymentReceiptSms()NotificationService.java:sendPaymentReceiptSms()方法负责组装并发送付款凭证短信
- 主助手处理:主助手接收到这一简要事实,不必先把五千行代码读入上下文,就能理清调用关系并向用户指出线索;如果后续需要确认具体的触发条件,再针对相关代码做进一步查阅。
样板代码生成模式(code-writer)
该模式用于生成单元测试等结构重复的样板代码。调用时需要同时提供“需求说明(Spec)”与“参考文件(Reference)”。需求负责规定目标行为,例如编写一段自动检查程序,输入“付款失败”,验证系统是否没有发送付款凭证短信;参考文件则提供项目中现成的一份成熟用例,展示项目习惯用什么测试框架、如何命名以及如何组织代码结构。
由于本地脚本不会在项目里额外搜索其他源码,仅告诉它应该做什么还不够,还需要提供真实的功能名称与调用方式;参考文件与需求说明合起来提供目标接口、行为与风格,模型才能对照生成匹配的代码。但这依然不能保证生成的代码必然合格,后续必须进行人工与测试检验。
指定目标(--target)
未指定目标
生成成本依然存在,样板代码需经审查与测试验证;指定 target 写入文件后正文不上屏,后续需要时可再回读。
在结果交付上,云端辅助模型生成的代码会先返回给本地脚本。随后脚本提供两条交付路径:若指定了目标文件路径(--target),本地脚本会将生成的代码直接保存至本地磁盘文件,不再把代码正文转交给 Claude,但调用参数与写入状态提示仍会进入主助手上下文,后续审查时可定向补读;若未指定目标路径,代码才会输出到终端并进入主助手上下文。辅助模型生成代码依然会产生相应的输入输出费用,主助手发起调用和接收状态也会占用少量上下文。
有了便宜模型还不够:怎么阻止 Claude 自己硬读
准备好这两个辅助模式,并不代表 Claude 在遇到大文件时会自动调用。
最初,Dimitri 尝试在项目的说明文件 CLAUDE.md 中写明规则,建议 Claude“遇到大文件请使用辅助模式”。但这类说明属于软性建议,Claude 在执行任务时可以忽略,实际是否遵循取决于模型的主动选择;而且每个项目都需要单独维护一份说明。
要让分流机制稳定生效,不能仅寄希望于模型自觉,而是在它发起全量读取操作时能够触发前置拦截。这也正是分流插件 shunt 的设计核心。
shunt 如何完成一次分流:拦截、指路、交付
当 Claude 尝试读取一个大文件时,分流机制通过拦截、指路与交付三个环节完成协作:
- 01
拦截(Hook 前置检查)
工具执行前拦截超过行数门槛的单文件全量读取,阻止大文件涌入主模型上下文。
拦截(检查规则 Hook):阻止未受约束的全量读取 当 Claude 调用读取工具时,前置检查规则(Hook)会在底层工具把文件读入上下文之前进行评估。默认拦截条件为:针对单文件、行数严格大于 350 行、且未指定读取范围(即未设置起始位置 offset 或行数上限 limit)。只要设置了起始位置或行数上限任一参数,规则即视为定向读取并予以放行。Hook 的价值在于满足条件时将全读阻止在工具执行前,让规则的执行不再仅依赖模型自身的主动遵守。 - 02
指路(Skill 路线说明)
拦截提示指向Skill;Claude按Skill中的参数说明调用脚本。
指路(调用说明 Skill):给出明确的替代路径 拦截发生后,工具会向 Claude 返回错误信息与引导提示,告知文件过大已被拦截,建议改用大文件阅读方式。Claude 随后查阅插件附带的调用说明(Skill),说明中详细给出了调用脚本的参数格式与使用示例。Skill 的作用是提供清晰的路线指引,避免模型在被拦截后反复试探或无法继续推进任务。 - 03
交付(Script 本地通信)
本地脚本将代码发给辅助模型处理,再将生成的摘要与状态交还 Claude 继续工作。
交付(本地脚本 Script):封装打包与调用通信 Claude 按照说明在本地调用脚本(bulk-read)。脚本负责读取本地文件,用明确的 XML 标签(<file path="...">)标记文件边界,打包后发送给云端辅助模式。辅助模型按照提示词提炼出结构化事实,脚本将结果交还给 Claude,Claude 据此继续开展分析。脚本把文件打包、边界标记与网络请求封装起来,主助手只需传参调用即可。(需要说明的是,bulk-read脚本并不对模型的回答进行文本清洗或摘要过滤,输出的精简度由辅助模式的提示词约定;而在代码生成脚本code-write中,则包含了清除 Markdown 代码围栏的处理。)
机制差异提醒:在这套机制中,只有读取大文件配置了 Hook 强制拦截,样板代码生成目前并没有前置拦截规则。Claude 是否使用生成脚本直接写盘,依赖于它在理解任务后主动选择调用该技能。
大文件读取拦截规则演示(check-file-size)
调节文件总行数、门槛行数或切换读取范围参数,可实时查看 Hook 拦截与放行判定结果。
仅演示本地已存在且可正常读取文件的 Read 规则,不执行真实读取,不模拟 Bash,门槛设为 0 合法。
单文件读取规则:指定 offset 或 limit 任一范围直接放行;未指定范围且行数不超过门槛(默认 350 行)直接放行;未指定范围且行数超门槛则拦截并引导改用 bulk-reader;参数须为非负整数。
① 多个小文件合并读取不累计行数;② 放行不等于任务适合分流;③ 仅读取配置了拦截 Hook,代码生成无前置拦截;④ 拦截提示不保证 Claude 必然采用分流。
90% 从哪里省出来:读取上下文少了约 90%,账单还要另算
当大文件由辅助模型通读、仅向主模型返回提炼要点后,进入主模型的上下文到底减少了多少?
Dimitri 在一个包含 16.2 万行代码的 Java 项目中测试了 4 种典型开发场景:
展示 3 项典型代码读取场景中,分流前后进入 Claude 主助手上下文的 Token 数量变化(全组共享 0~75,990 统一尺度)。
单大文件分析
源码与测试文件对
跨服务多文件分析
图中数据代表进入主模型上下文的 Token 数量,来源报告给出的降幅分别为 82%、94%、94%。全文发给辅助模型处理同样产生计费,不等于总账单减少 90%;样板代码生成写盘的 833 行代码非读取 Token,不计入本图。
| 测试场景 | 涉及代码量 | 未分流时主助手接收的 Token | 分流后主助手接收的 Token | 主助手接收代码降幅(来源报告口径) |
|---|---|---|---|---|
| 单大文件分析 | 4,014 行 | 33,684 tokens | 5,737 tokens | 82% |
| 源码与测试文件对 | 7,408 行 | 75,990 tokens | 4,148 tokens | 94% |
| 跨服务多文件分析 | 1,281 行 | 16,221 tokens | 821 tokens | 94% |
| 样板代码生成 | 3,667 行参考代码 | 40,614 tokens + 生成代码开销 | 833 行代码直接写入磁盘 | — (未提供直接百分比) |
以第一行“单大文件分析”为例:
- 未分流时:Claude 调起内置读取工具,4,014 行代码全文读入对话,占用 33,684 个 Token。
- 分流之后:辅助模型在云端读取全文,向主助手返回提炼后的摘要要点,主助手本次接收了 5,737 tokens,来源报告记录涌入主模型的上下文内容降幅为 82%(按两项 Token 数直接计算约 82.97%)。在测试文件对和跨服务分析场景中,报告的降幅为 94%。
测试报告显示三项读取场景的降幅平均约 90%。但必须厘清:这里的“减少约 90%”,严格指大文件读取时进入主助手上下文的内容降幅,不等于实际开发中的月度总账单减少 90%。
整个流程的真实账单应当综合计算:
- 主模型输入开销降低:大文件通读被分流,进入主模型上下文的文字量显著减少。长文件内容一旦进入对话,可能继续占用后续输入的上下文空间,而实际费用还受模型缓存、上下文压缩机制及平台计费规则的影响。
- 大段生成成本转移:生成样板代码时直接写入磁盘,减少了主模型生成大段样板的输出开销。
- 辅助模型产生调用费用:云端辅助模型阅读数千行文本及生成代码,同样会按其对应费率产生账单。
- 网络传输与处理耗时:根据作者在文中的观察,一次委派通常需要 10 到 30 秒(涵盖网络传输与辅助模型处理)。
- 后续核对与深度分析仍需主模型:复杂的逻辑排查、关键代码补读以及后续修改,依然会消耗主模型的费用。
至于默认设置的 350 行门槛,它是一条便于工程配置的经验阈值,而非衡量代码复杂度的绝对标准,开发者可以通过环境变量(SHUNT_MIN_LINES)自行调整。
为什么不能全部外包:修改和调试还得 Claude 自己看
既然辅助模型处理长文本能有效分担上下文,为什么不把任务全部外包?接回前面的付款短信示例,就能看清辅助模式的局限所在:
辅助模型返回的要点能帮助快速定位到相关方法,但如果你接下来的任务是修改代码或排查严密逻辑——例如确认是否只有在扣款完全成功后才会触发短信发送、网络波动重试时是否会产生重复短信——这类涉及业务时序与边界条件的细节,简略的摘要无法提供完整证据。
因此稳妥的做法是:先由辅助模型进行初步排查指出线索,主助手再针对关键片段发起定向读取(例如仅读取相关方法附近的约二十行代码),将真实代码读入上下文后再做评估。如果确认逻辑或重试机制分布在其他方法中,再顺着线索继续定向补读。由于带了读取范围,检查规则直接放行;主助手既核对了真实逻辑,又不必将 3,200 行文件完整读入。
在实际使用中,有三种情况不宜直接依赖辅助模式:
- 动手修改代码与确认严密条件:辅助模式只提供定位线索;涉及代码微调、条件验证与实际修改时,必须由主助手阅读真实源码。
- 排查隐蔽缺陷与复杂架构:在作者的实际测试中,辅助模型曾漏报过一个隐蔽的线程安全缺陷,而 Claude 在获得正确上下文后几秒钟内便发现了该问题。所谓线程安全,通俗来说是指多个任务同时访问共享数据时,系统依然能够保证运行结果正确且状态一致(缺少这种保证时,例如并发交易场景下同时读写未经同步保护的共享账户余额导致金额错乱,这属于一般的通俗解释例子,原作者在测试中并未公开其具体业务代码)。这种深层逻辑与并发交互推演,在当前分工中依然需要交给主模型来处理。
- 行数较少的小文件:一次远程调用通常需要 10 到 30 秒。对于一两百行的小文件,直接读取占用的上下文较少,特意发起远程调用可能不值得额外等待。
怎么把它用起来:三步接入,先用一个小任务验证
在使用这套方案前,需要了解其运行特征与前提条件:
- 按次无状态与追问机制:AiKA 模式是按次无状态调用的(ephemeral),云端不维护跨轮次的会话上下文。如果开发者追问“这些文件里还有哪些方法操作了数据库”,脚本必须把文件与新问题重新发送给辅助模型,辅助模型仍按其费率进行处理。在样板生成中,若想基于刚生成的用例继续编写补充测试,只需在下一轮命令中把新生成的文件作为参考参数(
--reference)传入即可。 - 平台前提:这套方案以团队接入 Spotify Portal 平台且启用 AiKA 功能为前提。本地安装客户端插件不会自动提供云端运行环境或模型账户。
接入流程分为三步,每一步都有明确的检验标志:
- 第一步:环境准备与插件认证:本地安装 JSON 解析工具
jq,并在 Claude Code 中安装portal插件与shunt插件。在开启的全新会话中执行/portal:setup完成身份认证。检验标志:终端提示登录认证成功,本地具备向 Portal 平台发送指令的基础通道。 - 第二步:确认或创建云端辅助模式:检查云端是否存在
bulk-reader与code-writer两个模式。若平台未预置,可依据规范创建并绑定相应的模型。检验标志:通过命令行能够成功检索并列出这两个注册好的模式名称。 - 第三步:最小任务验证与安全检查:为了验证拦截是否生效,可明确尝试对一个超过当前配置门槛(默认 350 行)的文件发起未指定范围的全量读取。检验标志:读取请求被 Hook 拦截并显示引导提示,Claude 随后调用
bulk-read脚本并返回由类名与方法名构成的要点,且摘要内容能与原代码中的关键事实对齐。在生成样板代码时,指定目标路径后,应先检查文件是否实际写入磁盘,并通过版本控制对比(Git Diff)和单元测试对生成代码进行审查。
真正可复制的办法:把“何时分流”和“谁来执行”拆开
这套方案的借鉴意义在于提供了一种清晰的工程分工:把“何时分流”与“谁来执行”解耦。
- 本地客户端插件负责“何时分流”与流程调度:负责把守本地大门,在识别到超过阈值的单文件全读时进行拦截并引导;同时负责组织输入、发起通信、交回结果,并在代码生成时将结果写入本地磁盘。
- 云端模式负责“如何执行”:配置任务提示词与绑定模型,在接收到长文本后专注完成事实提炼或代码生成。
这种职责划分使得本地调用方式与后端具体模型相互独立:当后端更换模型时,本地脚本依然通过标准命令与指定模式通信,无需调整调用逻辑。该架构在工程上具备良好的可扩展性:
- 跨项目与跨工具复用: 云端的阅读与生成模式属于通用能力,不仅适用于 Java 项目,团队内部其他语言的项目也能直接调用。任何支持命令行或 API 调用的开发工具均可复用这套后端模式;若希望在其他工具中也实现自动拦截,只需结合该工具的扩展机制适配相应的前置检查层。
- 更换模型与配置优先级: 团队在云端为模式调整绑定的模型后,使用该模式的调用者即可享受更新,无需每个开发者修改本地脚本代码。模式名称解析遵循优先级规则,个人创建的同名模式会优先于公共模式生效。但需要保证模式名称与输入输出约定保持兼容,且更换模型后其输出质量仍需抽样检验。
- 更广阔的模式扩展设想:
作者在文章最后提出,这种模式分流思路可以延伸到更多长文本场景。例如:用于编写文档的文档模式(
doc-writer)、生成代码审查摘要的评审模式(reviewer),以及负责国际化多语言翻译(即生成不同语言版本)的翻译模式(translator)。(这些属于作者博客中提出的拓展设想,并非当前插件已内置的功能。)
在开发流程中,让辅助模型分担繁重的长文本阅读与样板编写,主模型专注于核心逻辑推演与关键决策,并将质量检查与成本评估贯穿在分流后的完整链路中,能够更合理地平衡开发效率与 Token 开销。
开发者附录:完整安装与调用命令
(非开发人员可跳过本节内容)
1. 安装与认证
确保本地已安装命令行 JSON 解析工具 jq(macOS 可通过 brew install jq 安装)。
在终端中添加官方源并安装插件:
# 添加官方插件市场源
claude plugin marketplace add spotify/portal-ai-plugins

# 安装 Portal 连接工具与 shunt 分流插件
claude plugin install portal@portal
claude plugin install shunt@portal
安装完成后,开启新的 Claude Code 会话,再运行认证命令完成登录:
/portal:setup
2. 检查与创建辅助模式
运行以下命令检查当前环境是否已配置对应模式。需要说明的是,list-modes 命令仅用于检查模式是否存在;实际绑定的底层模型需前往当前实例支持的配置入口核对:
portal-cli actions aika:list-modes --json --input '{"search": "bulk-reader"}'
portal-cli actions aika:list-modes --json --input '{"search": "code-writer"}'
若未预先配置,可通过命令创建:
# 创建大文件阅读模式
portal-cli actions aika:create-mode --input '{
  "name": "bulk-reader",
  "description": "Bulk file reader for code analysis",
  "instructions": "You are a precise code analyst. Read the provided files and answer the question concisely. Output structured bullets only. No greetings, no prose, no preambles, no summaries. Lead every bullet with the exact name, type, or line number. Use nested bullets for details. Skip anything the caller did not ask for.",
  "tags": ["coding", "delegation"],
  "resource_limits": { "temperature": 0.2 }
}'

# 创建样板代码生成模式
portal-cli actions aika:create-mode --input '{
  "name": "code-writer",
  "description": "Boilerplate code generator",
  "instructions": "You generate code files based on a spec and reference files. Match the existing patterns, conventions, naming, and style exactly. Output only the code — no explanations, no markdown fences unless asked. If the spec is ambiguous, make reasonable choices that match the patterns in the reference code.",
  "tags": ["coding", "delegation"],
  "resource_limits": { "temperature": 0.2 }
}'
3. 脚本调用与真实填空模板
日常交互中,插件并非全自动调度:Hook 会自动检查并拦截符合条件的读取,提示 Claude 按技能调用脚本;代码生成(code-writer)则依赖 Claude 识别任务,不保证自动执行。若在终端中手动调用,请将 /path/to/shunt 替换为您本地插件的实际安装路径。
场景一:大文件分析
/path/to/shunt/scripts/bulk-read --question "这两个类分别承担什么职责,如何交互?" --paths src/Client.java src/RetryPolicy.java
场景二:样板代码生成(真实填空模板)
以下是填空模板,不可原样运行;替换插件路径、参考文件路径、目标文件路径及 spec 中的全部占位内容,保留路径两侧引号。脚本只发送 spec 与 reference,不会自动读取目标类源码;两者合起来必须给足目标接口、行为与样式。
/path/to/shunt/scripts/code-write \
  --spec "【目标语言与测试框架】:<例如:Java / JUnit 5>
【待测对象与依赖替身】:<填写待测类名;若需创建替身,说明测试替身命名与类型,具体构造或注入方式按本项目架构填入>
【待测方法与预期逻辑】:<填写待测方法签名、入参示例及核心预期结果>
【异常分支与特殊边界】:<填写触发异常的输入条件及预期的异常类型>
【断言与验证标准】:<填写关键断言方式与依赖替身的调用验证规则>" \
  --reference "/path/to/ReferenceTest.java" \
  --target "/path/to/GeneratedTest.java"
4. 开发注意事项与边界细节
- 无提示覆盖风险:使用
code-write指定--target时,若目标文件已存在,将没有任何二次确认直接覆盖写入。请务必指定全新的目标文件名;若未指定--target,生成的代码将输出至标准输出并进入主模型上下文。 - 生成后检查流程:代码生成后切勿直接运行。建议遵循以下检查步骤:1. 在编辑器中打开新生成的文件检查逻辑;2. 运行
git status --short确认新增文件路径;3. 运行git diff --no-index /dev/null "/path/to/GeneratedTest.java"(将路径换成实际新文件路径)审查代码细节;4. 执行本地编译与单元测试(如mvn test或npm test)。 - 命令行参数长度限制:命令行参数通过 argv 传递,脚本内置
SHUNT_MAX_PAYLOAD_BYTES保护(macOS 400,000 字节,Linux 120,000 字节),以避免触发操作系统的E2BIG(ARG_MAX) 错误。若需要分析大量文件,请分批传入。 - 超时区分与处理:博客称 Portal 单次调用上限为 30 秒;当前客户端默认等待 180 秒(
SHUNT_TIMEOUT_SECONDS)且可配置。两者不是同一限制,不能用调大客户端时间推断服务端上限改变。确认是客户端超时后可根据需要调整,或将任务拆小。 - 命令行读取检查规则局限:
check-bash-read针对cat/head/tail/less/more等命令进行检查;只要命令中包含管道符|或重定向符>即放行,并不检验管道后的实际输出量。这属于基于命令特征的引导规则,而非不可绕过的安全沙箱。 - 个人模式优先原则:Portal 遵循个人模式优先原则(个人模式 > 团队模式 > 实例公开模式)。若个人创建了同名模式,系统将优先调用个人版本,不会自动同步团队或全局公开版本的更新。
- 复测资产与计费日志区别:开源仓库里的 TypeScript 复测用字符数除以 4 粗估 Token,不是 Java 原始计费日志。
参考资料与开源项目:
- 原文博客:Portal by Spotify cut my Claude Code token usage by 90%
- 官方开源插件仓库:GitHub - spotify/portal-ai-plugins (shunt 目录)
- Spotify Portal 官方文档:AiKA Modes 核心特性与插件配置指南
Claude Code 上下文分流落地带走工具包
包含两份工程落地辅助工具:一份用于在项目中对比直读与分流前后的主模型上下文、Worker 消耗、延迟与代码质量的空白评估表;一份包含委派前核对清单与规范调用语法的可编辑模板。
下载完整工具包实操带走包
滚动查看原始 Markdown,复制后可按团队实际系统与政策修改。
正在载入 Markdown…
Portal by Spotify cut my Claude Code token usage by 90% | Spotify Engineering
Most of what an AI coding agent does for me isn't thinking. It's I/O.
Reading five files to answer a question about one method. Generating a test file that follows the exact same pattern as the twenty test files next to it. Updating docs after a meeting. Thousands of tokens gone and almost zero reasoning. The seat license isn't what hurts, it's the tokens. And you're feeding all of it to a frontier model that's wildly overqualified. What if you could route the grunt work to something cheaper that handles it just as well, and save the expensive model for the problems that actually need it?
It’s hardly just my problem. By 2028, AI coding costs are expected to blow past the average developer's salary. A quarter of engineering leaders already burn $200–$500 per developer per month on tokens. Some are well past $2,000. The tooling pays for itself but only if you stop burning frontier tokens on work that doesn't need them.
Turns out, the fix didn't require a platform team or a new subscription. Just two modes.
Two modes, zero code
This is exactly the kind of use case AiKA Modes in Portal by Spotify were built for. A mode is a declarative agent that runs on an ephemeral runtime - think AWS Lambda, but for agents. You define the instructions, pick a model, set parameters like temperature, and attach MCP tools. Portal handles the rest. No infra to manage, no API keys, no long-running servers. Modes are callable from the Portal CLI or API. They can be public (shared with the whole company) or private.
For this router to work I created two modes. Both use Gemini 2.5 Flash as the worker model in the examples below, but the model field accepts any model you have configured in your Portal instance. Pick whichever works for you.
Mode 1: bulk-reader
For when Claude would otherwise read multiple large files just to answer one question.
name: bulk-reader description: Bulk file reader for code analysis - delegates I/O from Claude Code instructions: You are a precise code analyst. Read the provided files and answer the question concisely. Output structured bullets only. No greetings, no prose, no preambles. Lead every bullet with the exact name, type, or line number. Use nested bullets for details. Skip anything the caller did not ask for. visibility: public model: gemini-2.5-flash resourceLimits: temperature: 0.2 tags: - coding - delegation
Mode 2: code-writer
For tests, config scaffolding, type stubs or anything where the output is predictable from existing patterns.
name: code-writer

description: Boilerplate code generator - delegates output-heavy work from Claude Code

instructions: You generate code files based on a spec and reference files. Match the existing patterns, conventions, naming, and style exactly. Output only the code — no explanations, no markdown fences unless asked. If the spec is ambiguous, make reasonable choices that match the reference code's patterns.

visibility: public

model: gemini-2.5-flash

resourceLimits:
  temperature: 0.2

tags:
  - coding
  - delegation
That "output only the code" instruction matters. Without it, the model wraps everything in markdown fences and explanatory prose that Claude then has to parse through.
Routing
The first version of this was a block of routing rules in CLAUDE.md. It sort of worked: Claude would read the instructions and self-route to Portal. But it had problems. The rules were advisory, not enforced. Claude could ignore them. And every project needed its own copy of the instructions.
The current version is a Claude Code plugin called shunt. Delegation goes through the Portal CLI actions registry so the plugin works against any Portal instance with AiKA plugin enabled.
Layer 1: Hooks
Claude Code hooks fire before every tool call. Shunt registers two PreToolUse hooks:
check-file-size fires on every Read call. If the file exceeds a configurable line threshold (default: 350), the hook blocks the read and tells Claude to use the /bulk-reader skill instead. Targeted reads pass through - Claude already knows what section it needs.
check-bash-read catches cat, head, tail, less, and more on large files. Piped commands (cat file | grep) pass through since those are targeted reads.
The threshold is configurable via the SHUNT_MIN_LINES environment variable. Set it in your shell profile or in .claude/settings.json:
{ "env": { "SHUNT_MIN_LINES": "500" } }
Layer 2: Scripts
I have two bash scripts that wrap the Portal CLI calls. Claude calls a script with named arguments. The scripts handle everything internally: building the request, invoking the actions, unwrapping errors, and reporting token usage to stderr.
Modes are addressed by name and resolved by Portal: case-insensitively, preferring your own mode, then your team's, then public ones. Fork the public bulk-reader into a customized version and yours automatically takes precedence - no configuration needed.
bulk-read wraps each file in XML tags for clear boundaries and sends them to the bulk-reader mode along with the question.
bulk-read --question "What does this service do?" --paths src/Service.java src/Handler.java

# Follow-up: ask again with the same paths

bulk-read --question "Which methods call the database?" --paths src/Service.java src/Handler.java
Every delegation is one shot. The invocation is ephemeral (nothing is stored server-side) and re-sending the files on a follow-up is free where it matters, because the corpus goes to the worker model and never enters Claude's context.
code-write sends a spec and a reference file to the code-writer mode, strips markdown fences from the output, and can write directly to disk. Claude never sees the generated code. The reference is required: without a file to match patterns against, the worker would generate context-free code that fits nothing in your project.
code-write --spec "Write tests for UserService" --reference tests/OrderTest.java --target tests/UserTest.java

# Output to stdout

code-write --spec "Generate a config stub" --reference config/existing.yaml
Layer 3: Skills
Two skill files tell Claude when and how to call the scripts. Skills are markdown files with a description and usage examples. When the hook blocks a read, the block message points Claude to the /bulk-reader skill, which shows the exact invocation syntax.
This layering means the system degrades gracefully. Even if Claude doesn't read the skill description, the hook still blocks the expensive read. The skill just makes the redirect smoother.
The benchmarks
Tested against a Java monorepo across four scenarios, measuring tokens Claude would consume reading files directly vs. consuming the bulk-reader's summary or writing code via the code-writer. Mean bulk-read savings were around a whopping 90%.
The code-write scenario is harder to measure in tokens because without shunt, Claude both reads the reference files and generates the output as expensive output tokens. With shunt, the code goes straight to disk, Claude never sees it.
What doesn't work
You can't delegate editing. The worker model's summaries don't include reliable line numbers. If Claude needs to make edits based on the analysis, it still has to read the specific section directly. The hooks allow targeted reads (with offset/limit) for exactly this reason, so delegation saves tokens on understanding.
You can't delegate reasoning. The worker model found surface-level patterns but missed a subtle thread-safety bug in my testing. Claude spotted it in seconds once given the right context. The routing explicitly excludes debugging, architectural decisions, and safety-critical code.
Latency adds up. Each delegation is a network round-trip: Claude Code to the Portal backend to the worker model and back. Responses typically take 10–30 seconds, and Portal caps a single invocation at 30 seconds, so very large generations need to be split into smaller calls. This is acceptable for large reads, but counterproductive for small ones. The line threshold exists for this reason, below it the overhead of delegation exceeds the savings.
Token savings are just the starting point
The plugin is a Claude Code artifact, but the idea underneath is model routing powered by AiKA modes. The modes are the load-bearing piece:
- They're reusable. The same bulk-reader and code-writer modes work across every project and every tool that can shell out to the Portal CLI.
- They're shareable. Both modes are public in AiKA. Anyone can use them today without creating their own.
- They're composable. You could create a doc-writer mode for documentation, a reviewer mode for code review summaries, a translator mode for i18n. Each one is a few clicks away.
- They decouple the routing decision from the worker. The plugin decides when to delegate. The mode decides how to respond. Swap Gemini Flash for a cheaper model, change the system prompt, add MCP tools - the plugin doesn't change.
This is the real power of AiKA modes: they turn model routing from a systems engineering problem into a configuration problem. You don't build infrastructure. You describe what you want and name it.
Try it yourself
- Install both plugins from the spotify/portal-ai-plugins marketplace: claude plugin marketplace add spotify/portal-ai-pluginsclaude plugin install portal@portal claude plugin install shunt@portal.
The portal plugin provides the Portal CLI that shunt delegates through.
- In a new Claude Code session, run /portal:setup to set up and authenticate the Portal CLI against your Portal instance.
- You’re good to go, just ask a question that spans multiple files.
The bulk-reader and code-writer modes are already public, so there is nothing to create. If you want to customize them - different worker model, different instructions - fork them in Portal and your version takes precedence automatically.
The modes are reusable across projects and shareable with your team. The plugin enforces the routing so you don't have to think about it. Learn more about modes.