Google Research 发布时间序列基础模型 TimesFM-3 可以预测未来
它预测的不是抽象事件,而是由多条时间曲线和未来已知计划共同决定的数值:销量、客流、负载、价格,以及这些变化的不确定性。
- TimesFM-3 用 3.3 亿参数和超过 1 万亿个训练时间点,原生支持多个目标、历史协变量和未来已知协变量。
- 模型把时间和变量组织成二维网格,交替沿两个方向交换信息,再用一次前向计算生成整个预测区间和 9 个分位数。
- 官方报告它在 GIFT-Eval、FEV-Bench、TIME 的点预测和概率预测平均排名上都居首,但平均榜单不能替代业务回测。
- 代码已开放,3.0 默认预训练权重当前仅限非商业、非生产用途。
Google Research 发布时间序列基础模型 TimesFM-3。这是 TimesFM 系列第一次原生面向多变量预测的版本:模型可以同时预测多条相互影响的时间序列,还能把客流、天气、促销、节假日等外部信息一起纳入判断。
理论上讲,这意味着它可以预测未来。这里的“未来”指销量、客流、设备负载、价格等随时间变化的数值,不是预测任何开放事件。当结果取决于多条共同变化的曲线和已经知道的未来计划时,能否用一个无需任务专门微调的通用模型直接完成预测?TimesFM-3 给出的答案是,把时间和变量组织成一张二维网格,在网格的两个方向上轮流交换信息。
1. 突破单变量限制,走向真实多变量预测
之前的痛点: TimesFM-2.5 的基础模型主要根据单条目标序列的历史数据预测未来。现实预测却很少只取决于一条曲线。预测下个月的冰淇淋销量,不仅要看过去的销量,还要结合甜筒和糖浆销量、历史客流、天气预报、促销排期和节假日。
TimesFM-2.5 后来可以通过 XReg 接入协变量,但这和 TimesFM-3 的原生多变量能力不同:前者是在单变量基础模型之外加入外部回归,后者从预训练阶段就学习多条目标序列和协变量怎样共同变化。
现在的能力: TimesFM-3 拥有 3.3 亿参数,使用超过 1 万亿个真实与合成时间点预训练。它支持零样本预测,不需要针对当前任务专门微调,就能直接接收三类数据:
- 多个目标: 同时预测多条相互影响的时间序列,例如不同品牌、门店或品类的销量。
- 历史协变量: 只在过去已知的信息,例如历史客流量和设备状态。
- 未来已知协变量: 从历史延伸到预测期的信息,例如已经排定的促销、节假日和当下可获得的天气预报。
“未来已知”不等于预知。节假日和促销排期可以提前确定,天气预报本身却带有误差;模型得到的是做出预测时已经可用的信息。零样本也只表示不用为当前门店、设备或业务序列重新训练模型,数据清洗、变量选择、时间对齐和回测依然要做。
2. 把时间和变量组织成一张二维网格
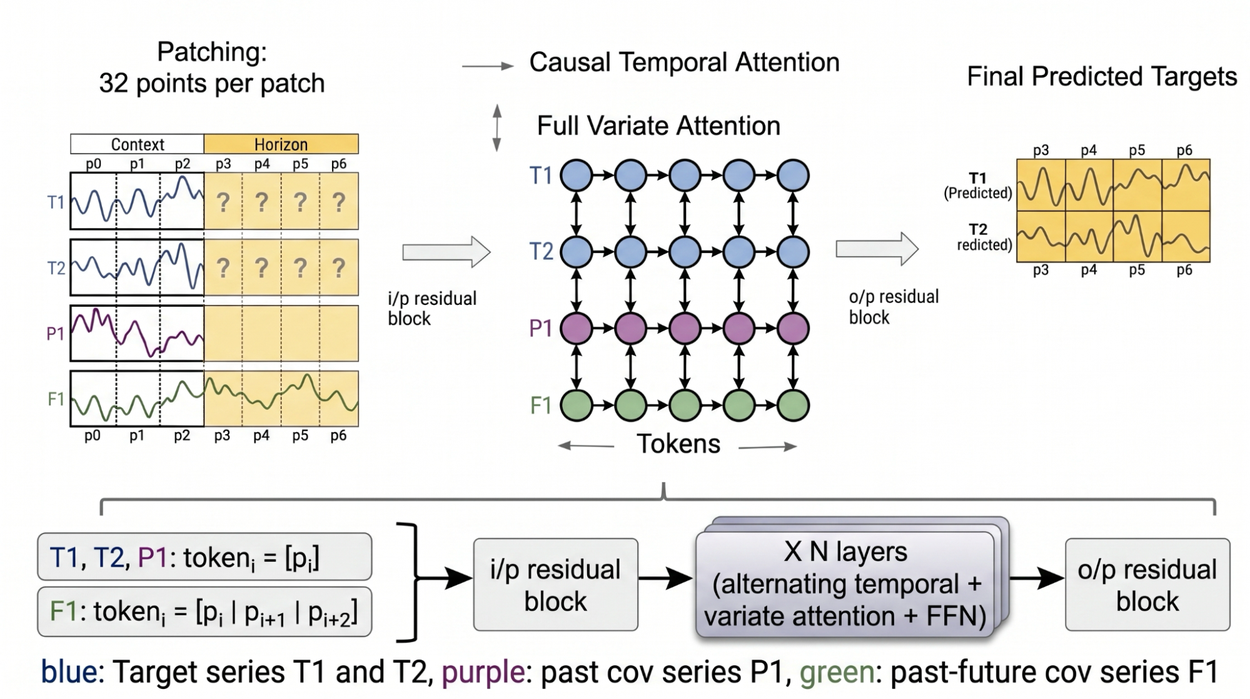
多变量不是把几列数据简单拼在一起。直接把每一个时间点都送进 Transformer,序列一长,计算量会迅速上升。TimesFM-3 沿用 TimesFM 的做法,把连续 32 个时间点打成一个 patch,再把每个 patch 编码成 token。不同量纲的序列还会分别归一化,避免几百元的销量和 0 到 1 的开关变量仅因数值范围不同而失衡。
目标序列和只知过去的协变量,每个 token 对应一个普通 patch。未来也已知的协变量多了一步“向前看”:它把当前 patch 和后面的未来 patch 拼在一起。这样,当模型处理某个时间位置时,已经能看到预测期内排定的促销或节假日。

进入主干后,注意力在两个方向上交替进行。
- 沿时间轴,每条序列只看自己的过去。这是因果注意力,用来学习趋势、周期和此前发生的变化,同时阻止目标序列偷看到未来真实值。
- 沿变量轴,同一个时间位置可以查看其他序列。冰淇淋销量可以参考甜筒销量,门店销量可以参考客流,目标序列也能读取促销和天气等协变量。
横向负责“这条曲线过去怎样演化”,纵向负责“同一时刻其他曲线发生了什么”。多层交替之后,模型得到的已经不再是几条各自独立的曲线,而是一组随时间共同变化的关系。
这也解释了多变量模式为什么可能比单变量模式更准:提升来自额外信息和跨序列关系。若几条序列没有稳定关联,或未来协变量本身不可靠,多变量输入不会自动带来收益。
3. 一次前向计算,直接生成整个预测区间
以前的 TimesFM 会先预测一个 patch,再把结果接回输入继续预测下一个 patch。预测期越长,循环次数越多,延迟和计算成本随之增加,前面产生的误差也可能进入后续预测。
TimesFM-3 借用了连续 patch 遮蔽的思路,把整个预测区间一开始就放进模型:
- 未来目标值和只知过去的协变量都换成遮蔽占位符,因为它们的未来值未知。
- 节假日、促销计划等未来已知协变量保持可见。
- 时间注意力和变量注意力在同一张网格上处理历史区和预测区。
- 模型一次填出全部目标序列在整个预测区间的结果。
官方 PyTorch 实现会把用户请求的预测长度补齐到输出 patch 的整数倍,再调用一次 model.decode(),最后裁掉多余位置。这个“一次”说的是模型前向过程,不代表计算量与预测长度无关;预测区间越长,送进同一次计算的 token 仍然越多。
输出也不只是一条看似确定的线。TimesFM-3 为每个目标、每个未来时点给出从第 10 百分位到第 90 百分位的 9 个分位数。中位数可以作为点预测,较低和较高分位数构成一组不确定性区间。预测期越远或信号越不稳定,区间通常会更宽。
4. 把已经知道的未来计划带进预测
Google 用一个合成的冰淇淋销量案例演示这套机制。红线代表只看历史销量的单变量预测,它主要延续每周起伏。蓝线额外读取了未来促销日,因此在排定促销的日期主动抬高销量预测。
切换输入条件,观察同一段预测期里的曲线响应。
机制演示:曲线使用标准化示意值,不调用 TimesFM-3,也不生成真实业务预测。

说明性合成案例:约 20% 是示例中的关系,不是现实促销的通用增幅。
示例在历史数据中设置了促销带来约 20% 销量提升的关系。多变量模式从历史促销日与销量的共同变化中学到这个关系,再把它应用到未来已经排定的促销日。整个月累积起来,蓝线比忽略促销计划的红线更接近这个案例的收入变化逻辑。
这张图证明模型能利用未来协变量恢复一个已存在于上下文中的关系。它没有证明现实中的促销普遍带来 20% 增长,也没有解决促销是否引起销量增长的因果识别问题。真实业务还要处理折扣力度、库存、竞争活动和促销对象变化。
5. 三套基准验证多变量能力确实有效
Google 在 GIFT-Eval、FEV-Bench 和 TIME 上比较了 TimesFM-3、TimesFM-2.5、Chronos-2、Toto 2.0、TiRex 等时间序列基础模型。图的横轴是点预测任务的平均名次,纵轴是概率预测任务的平均名次;两个数字都越低越好,因此越靠左下表示综合排名越高。
横轴=点预测平均名次;纵轴=概率预测平均名次;越靠左下越好。


平均排名反映纳入任务和模型集合的总体位置,不代表每个数据集或每个业务指标都获胜。
三张图出现了同一个结果:TimesFM-3 的多变量模式都位于最左下方。把变量间信息和协变量全部关掉,只用它做单变量预测时,它的平均名次仍然优于或接近图中其他可复现的基础模型;开启多变量模式后,排名继续改善。
这组结果有两层价值。第一,模型并没有用多变量能力换掉单变量能力:没有协变量时仍能作为通用预测模型使用。第二,额外变量在多套任务上带来了稳定的平均收益,不只在促销示例中成立。
平均排名也会隐藏差异。它告诉我们模型跨任务的总体位置,不能说明每个数据集都赢,也没有覆盖每家公司的损失函数、库存约束和错误成本。图中比较的是发布时纳入的模型集合;经过业务数据训练的专用模型、经典统计模型或此后出现的新模型,仍需在同一回测窗口中重新比较。
6. 能预测未来,不等于可以直接上线
TimesFM-3 已提供 GitHub 代码 和 Hugging Face 权重。官方接口接收形如“变量数 × 历史长度”的目标数组;未来已知协变量要覆盖“历史长度 + 预测长度”。输出包括每条目标序列的点预测和 9 个分位数。
实际试用前要确认四件事:
- 数据是否在同一时间频率上对齐,缺失值、异常值和未来协变量的生成时间是否清楚。
- 协变量在做出预测的那个时刻是否真的可用,不能把事后才知道的数据伪装成未来已知信息。
- 业务关心的误差、库存成本或风险指标,是否在滚动回测中优于当前基线。
- 输入规模是否适合当前实现。官方代码的最大历史长度是 15,360 个时间点;基准评测器一次前向最多容纳 32 个变量,更多目标会分块,协变量过多时还可能被抽样。
许可是更硬的边界。仓库代码采用 Apache-2.0,但 TimesFM 3.0 默认预训练权重当前采用单独的非商业许可,只允许非商业、非生产用途。下载权重做研究验证没有问题,把它直接接入收费产品或生产预测系统则不在许可范围内。
Google 表示 TimesFM-3 的 BigQuery 集成将在随后几周推出;发布当日可直接试用的 AI.FORECAST 仍是 TimesFM-2.5 的单变量能力。因而 TimesFM-3 目前最合适的状态是本地研究和业务回测,不能把“代码和权重已经公开”写成“企业已经可以无条件上线”。
TimesFM-3 把多变量预测从“为每项业务单独搭模型”推进到“先用一个通用模型直接回测”的阶段。它降低了尝试门槛,也把新的责任交给使用者:哪些变量在预测时真的可用,跨序列关系能否持续,平均榜单收益是否能转化为自己的业务收益。模型把更多现实信息带进了预测,最后一道判断仍要在真实数据上完成。
TimesFM-3: A zero-shot foundation model for multivariate forecasting
We introduce TimesFM-3, a state-of-the-art time series foundation model that enables highly accurate multivariate time series forecasting in a single forward pass, significantly outperforming other forecasting models across major benchmarks.
Since the debut of TimesFM in 2024, we’ve seen the adoption of time-series foundation models for real-world time-series forecasting tasks across multiple domains, such as retail, finance, observability, manufacturing, healthcare and natural sciences.
Up until TimesFM-2.5 (released in September 2025), our models were strictly limited to univariate forecasting: forecasting using only the history of a single time series. Yet, most real-world forecasting problems are inherently multivariate: where multiple time series and auxiliary external features jointly impact the future forecast of a time series. Consider forecasting ice cream sales for a retail chain. Past sales alone rarely tell the full story. A good forecast should also draw on sales of related products (e.g., ice cream cones, syrups), historical foot traffic, and known future events like weather forecasts, promotions, and holidays.
Today we introduce TimesFM-3, the next generation of our time-series foundation model that is natively pre-trained for multivariate forecasting. TimesFM-3 has 330 million parameters and is pre-trained on a real-world and synthetic time-series corpus comprising more than 1 trillion time points. Building on the efficiency and zero-shot generalization of its predecessors, TimesFM-3 adds robust support for complex multivariate scenarios in a zero-shot manner. It can jointly predict multiple coevolving time series, capturing dependencies that improve overall accuracy without requiring task-specific fine-tuning. The model natively supports:
- Multiple targets: Forecast multiple related time series simultaneously (e.g., jointly forecasting different brands of ice cream). The model supports both point and quantile forecasts for all targets.
- Past covariates: Incorporate features that are only known historically (e.g., past foot traffic).
- Past-future (dynamic) covariates: Leverage known future events to guide the forecast (e.g., planned promotional campaigns or weather forecasts).
Under the hood: Architecture & inference
TimesFM-3 builds on the proven decoder-only transformer architecture of its predecessors. As in previous versions, we process time series efficiently by grouping contiguous data points into patches of 32 time steps. We then apply normalization per time-series similar to that of TimesFM-2.5 in order to account for time series with vastly different scales.
Multivariate token construction
For target and past-covariate series, a token is constructed directly from a single patch. However, for past-future covariates, TimesFM-3 employs a clever "lookahead" strategy: each token concatenates the current patch with future patches, allowing the model to peek at upcoming known signals.
Alternating attention architecture
Once the patches are tokenized, they pass through an input residual block and enter the main transformer stack, which operates as a 2D grid:
- Causal temporal attention: Tokens attend horizontally across time. To prevent data leakage, this attention is strictly causal — a token can only look at past tokens within its own specific time series.
- Full variate attention: Tokens attend vertically across series. At any given time step, a token can look at all other time series in the dataset, allowing the model to learn complex cross-series correlations (e.g., how a promotion in one series affects sales in another).
These two attention mechanisms alternate for several layers, seamlessly blending temporal patterns with cross-series relationships.
Non-autoregressive decode: Forecasting in a single pass
Previous versions of TimesFM generated forecasts one patch at a time, introducing latency, compounding error accumulation, and computational cost. TimesFM-3 uses the strategy of Contiguous Patch Masking to generate the entire forecasting horizon in a single forward pass. The model appends masked placeholder tokens for the future horizon alongside the observed context. Target and past-covariate series are masked in the horizon (since their future values are unknown), while past–future covariates remain visible, providing the model with known future signals like holidays or scheduled events. Through the alternating attention layers, the model fills in all masked horizon patches simultaneously, with no iterative loop required. The model predicts 9 quantiles (from the 10th to the 90th percentile) for each target time series at every horizon step, providing a full probabilistic view of the forecast uncertainty.
Illustrative example for multivariate forecasting
Let’s revisit the ice cream sales example. Imagine you are working on next month’s promotion schedule and want to forecast the sales to anticipate. A standard univariate model (the red line, below) looks at the historical sales and projects a weekly pattern forward — but it has no idea about planned promotions on specific days. TimesFM-3's multivariate mode (the blue line, below) takes a different approach: by passing in the planned promotion schedule as a past-future covariate, the model learns the relationship between promotions and sales lift from the historical context, then applies that knowledge to future days with planned promotions. The result is a forecast that anticipates a ~20% sales bump on each promotion day. In the chart below, the amber blocks in the promotion covariates highlight which days have promotions — and the blue forecast visibly responds to each one, while the red forecast does not. Over the full month, this adds up to a more accurate forecast for projected revenue.
Evaluation and benchmarks
We evaluated TimesFM-3 on three comprehensive public forecasting benchmarks: Gift-Eval, FEV-Bench, and Time. On all three benchmarks, TimesFM-3 is the top-ranked model in terms of both point and probabilistic forecasting metrics among all pre-trained foundation models. The plots below show average rank across tasks for both point forecast accuracy and probabilistic forecast quality (lower is better) for the three benchmarks. We compare against recent foundation models including multivariate-capable models, such as Chronos-2 and the Toto 2.0 family, as well as our previous model TimesFM-2.5.
Each plot includes two entries for TimesFM-3. The "univariate mode" point shows performance when the model is evaluated without any covariate or cross-series information, treating each target series independently, just like a traditional univariate model. Even in this univariate mode, TimesFM-3 already matches or outperforms other competing models. When we switch to the full multivariate mode, TimesFM-3 takes another leap, achieving the best average rank in both point and probabilistic forecasting across the board.
Conclusion
We introduce TimesFM-3, the latest generation of our TimesFM family of zero-shot time series foundation models, that obtains state-of-the-art multivariate and univariate forecasting performance on multiple public benchmarks. TimesFM-3 is now available on GitHub and Hugging Face, and is directly integrated into BigQuery. You can try TimesFM 3.0 immediately on both your multivariate and univariate tasks using theAI.FORECAST command in BigQuery — no ML expertise required.
Acknowledgements
This project is joint work with Yichen Zhou, Petros Mol, Abhimanyu Das and Samet Oymak.