Databricks の実測 — 数百万行の巨大コードベースで、どのモデルとハーネスが一番コスパよく、一番使いやすいのか
- Databricks が主要な AI コーディングアシスタントを自社の数百万行のコードで一斉テスト。問題はエンジニアがマージ済みの PR から作ったもので、ネット上には存在せず、モデルも暗記していない
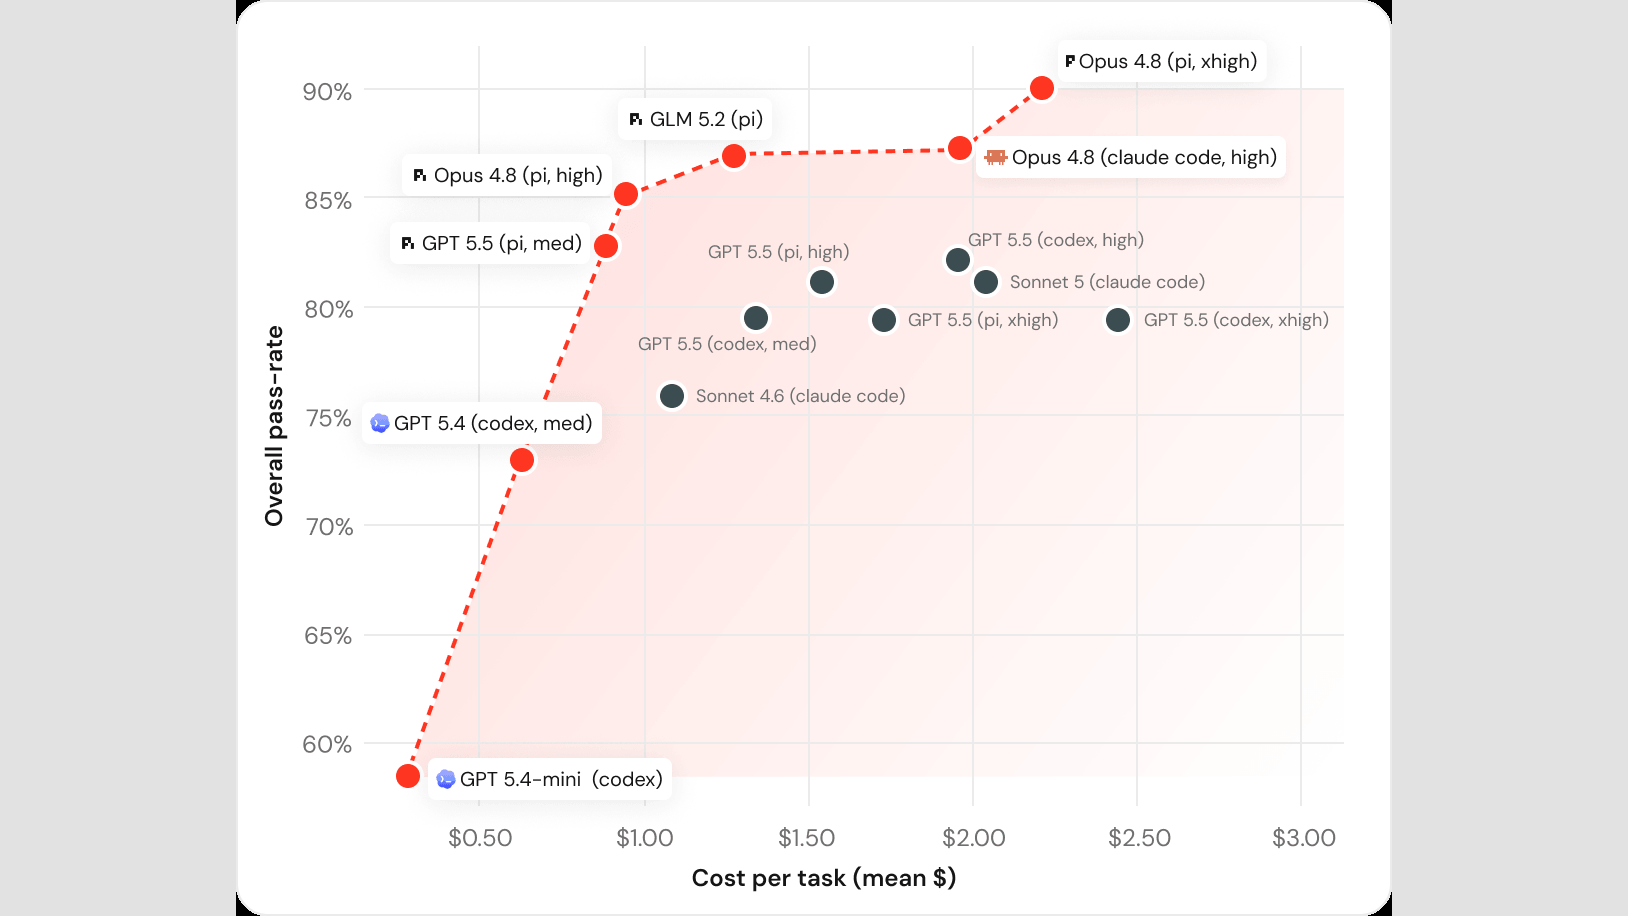
- いちばん直感に反する結論 — トークン単価でモデルを選ぶと間違えます。Sonnet 5 は Opus 4.8 よりトークン単価が1.7倍安いのに、1問解き終えると逆に高くつき($2.09 対 $1.94)、スコアも6ポイント低い
- コストを左右するのはモデルより外側(ハーネス)。同じモデル、同じ思考レベル(thinking effort)でも、外側を替えるだけでコストは2倍以上変わります。差は毎ターンどれだけの文脈をモデルに流し込むか — Opus は claude code 経由で1問あたり累計742kトークン、pi なら236kで済みます
- オープンソースが第一グループ入り — GLM 5.2 の品質は Opus 4.8 と互角(ともに87%)、1問あたり $1.28 対 $1.94
- 思考レベルは高いほどよいわけではありません。Opus 4.8 を max まで上げると1問 $3.6 でスコアは82点。high の $0.93・85点より、高くて悪い結果です
Databricks が公式に出した社内実測のまとめです。答えたい問いはひとつ — 数百万行の巨大コードベースで、どの AI コーディング Agent(モデル + 実行フレームワークの組み合わせ)が一番コスパよく、一番使いやすいのか。7月8日公開、5人の著者には CTO であり Spark の作者でもある Matei Zaharia が含まれます。
まず Databricks とは
データと AI のプラットフォームを手がける企業で、2013年に Apache Spark のオリジナルメンバーが創業しました。Spark はビッグデータ処理でもっとも広く使われるオープンソースエンジンのひとつで、世界中の企業がデータパイプラインや機械学習の実行に使っています。同社は現在1万2000社以上にデータ基盤を提供し、2026年2月に L ラウンドを完了、評価額1340億ドル、年換算収入54億ドルです。
著者の顔ぶれ。署名した5人のうち2人が Databricks の共同創業者です。Matei Zaharia は Spark の作者で現 CTO、Patrick Wendell も共同創業者。
コードベースが十分に複雑。Scala、Go、Rust、Java、Python、TypeScript、Bazel、Protobuf を使い、エンジニアは毎日1000回以上のコード変更をマージします。この複雑さは公開ベンチマークでは再現できません。
動機は自分たちのコスト削減。自社のエンジニアリング組織が AI をより安く使えるようにするための社内健康診断で、終えたあとに手法とデータをまとめて公開したもの。外向けの製品評価ではありません。
やり方自体は複雑ではありません。自社エンジニアが日々書いている実コードを問題に作り替え、主要なモデルとフレームワークの組み合わせを走らせて、正解率とコストを見る。得られた結論のいくつかは、いま多くの人がやっている選び方と真逆です。

以下、6つの結論。最後の節がそのまま真似できるパートです。
モデルは「3つのグループ」に分かれる、常に最高価格帯を使う必要はない
彼らは順位を追いませんでした。数ポイントの差は実タスクではならされてしまうからです。役に立つのはグルーピングのほう — モデルと外側のすべての組み合わせが、はっきり3つの能力帯に落ちました。
| グループ | 正解率 | 顔ぶれ |
|---|---|---|
| 第1グループ | 82–90% | Opus 4.8、GLM 5.2、GPT 5.5 の高設定 |
| 第2グループ | 71–82% | Sonnet 5、Sonnet 4.6、GPT 5.5 中設定、GPT 5.4 |
| 第3グループ | 51–60% | GPT-5.4-mini、Haiku 4.5 |
日常の小さな作業に最高設定は不要。フラグの切り替えや設定の更新といった作業なら、中〜下位のモデルで十分足りますし、はるかに安く済みます。それでも彼らのデフォルト設定は、ずっと最高価格帯のままでした。
アップグレードより役割分担のほうが得。データを見た結果、より多くのタスクを Haiku や GPT 5.4 Mini の帯に回し、複雑なアーキテクチャ探索や深いデバッグのときだけ最も賢いモデルを呼ぶことにしました。

どの作業を下ろすかは、まずログで測る
着手前に、彼らはまず AI コーディングセッションのログを全部引き出し、エンジニアが実際に AI に何をさせているかを調べました。

およそ4分の1が低複雑度の作業、6割が中難度で、本当に深い設計探索が要るのは12.1%だけ。それなのにデフォルト設定ではずっと最高価格帯のモデルが使われていた — この間の無駄は目に見えています。
オープンソースの台頭、日常の「主力機」として十分使える
第1グループにはオープンソースのモデルが1つ座っています。智譜(Zhipu)の GLM 5.2 です。
品質は Opus 4.8 と互角。正解率はどちらも87%で、統計的に差がつきません。
1問あたり約3割安い。GLM 5.2 は1問 $1.28、Opus 4.8 は $1.94。
主力の座に上げつつある。すでに社内の開発者が日常業務で試用しており、今回のスコアはその人たちの感触と一致しました。これを根拠に、日常の主力として広げてよいと判断しています。
「トークン単価が安い」は「最終的に安い」ではない
モデルを選ぶとき、ほぼ全員が同じ数字を見ています。100万トークンいくらか。この数字では、最後にいくら払うかを予測できません。
見るべきは1つ片づけるのにいくらかかるか。トークン単価との間には変数が1つ挟まります。モデルがそれをやり終えるまでに、どれだけ読み、どれだけ考えるか。
直感に反する例が Sonnet 5。トークン単価は Opus 4.8 より約1.7倍安いのに、1問あたり $2.09。Opus 4.8 は $1.94 です。単価が安いほうが、総額では高い。
余分な出費は回り道に消えている。Sonnet 5 はより多くのファイルを読み、より長く考え、往復も増え、1.9倍のトークンを食います。それでいて正解率は6ポイント低い(81% 対 87%)。
実行フレームワーク(ハーネス)がコストに与える影響は絶大
同じモデル、同じ思考レベルで、外側を替えるだけ。1問あたりコストは2倍以上変わり、品質はほぼ動きません。多くの人は、外側を「選べるもの」だと思っていません。
同じ料理人でも厨房が違えば提供の速さもコストも倍変わる。その厨房が外側です。
コストは2倍差、品質はほぼ動かない。pi はすべての対照組で安く、倍率は1.20から2.08。6組中5組で正解率の差は3ポイント以内です。
差は全部コンテキスト管理にある。1問解き終えるまでに累計でモデルに送り込まれた量は、Opus 4.8 を claude code で走らせると742kトークン、pi なら236kで済みます。


| モデル · 思考レベル | pi が安い | 正解率(pi / 純正) |
|---|---|---|
| Opus 4.8 · high | 2.08× | 85% / 87%(−2) |
| Opus 4.8 · xhigh | 1.46× | 90% / 88%(+2) |
| Opus 4.8 · max | 1.20× | 82% / 89%(−7) |
| GPT-5.5 · medium | 1.54× | 83% / 80%(+3) |
| GPT-5.5 · high | 1.22× | 81% / 83%(−2) |
| GPT-5.5 · xhigh | 1.44× | 78% / 80%(−1) |
pi — 道具箱に4つしか入っていないコーディングアシスタント
pi は Claude Code や Codex と同じ種類のもの。自分のマシンに入れてターミナルで動かし、やってほしいことを一言で伝えると、自分でコードを漁り、ファイルを直し、テストを走らせ、終わったら報告してくれます。
道具箱の中身は4つだけ。ファイルを読む、書く、直す、コマンドを実行する。それ以外の機能は、本当に必要になった時点で読み込みます。
常駐する説明書は1000トークン未満。日本語にして数百字程度の量です。
作者。Armin Ronacher と Mario Zechner。前者は Python 界隈で著名で、十数年使われている Flask と Jinja2 はどちらも彼の作です。プロジェクトはオープンソースで無料、GitHub のスターは約5.4万、どこのモデルでも挿せます。
薄いこと。それが安さの理由のすべてです。毎ターン、外側はひとかたまりの情報をモデルに再投入します。常駐の説明書、全ツールの使い方、それまでの会話、今回見せるコード。ツールが多く、説明書が長く、履歴を全部残すほど、このかたまりは膨らみます。そして毎ターン、その分の料金を払い直すことになります。
送らなかった情報が消えるわけではありません。モデルが本当に必要になったら、自分で「ファイルを読む」を呼んで取りに行きます。この設計が成り立つ前提は、モデルが自分から取りに行き、ちゃんと取ってこられることです。
思考レベルを振り切ると、高くて悪い
モデルの思考レベルを最大にしても、精度が上がるとは限りません。ただし料金は確実に上がります。
| 組み合わせ | 1問あたりコスト | 正解率 |
|---|---|---|
| Opus 4.8 · pi · high | 約 $0.93 | 85% |
| Opus 4.8 · pi · xhigh | 約 $2.20 | 90% |
| Opus 4.8 · pi · max | 約 $3.60 | 82% |
| GPT 5.5 · codex · med | 約 $1.33 | 79.5% |
| GPT 5.5 · codex · xhigh | 約 $2.42 | 79.5% |
レベルとスコアは単調な関係ではない。Opus 4.8 を pi で走らせると、high は1問1ドル未満で85点、max は3ドル60セントかけて82点に落ちます。この組み合わせの頂点は中間の xhigh で90点。
余計に払った分がまるごと無駄になることもある。GPT 5.5 を codex で走らせると、med と xhigh の正解率はまったく同じ79.5%。後者は倍近く高いだけです。
レベル名はモデルをまたいで比較できない。high、xhigh、max は各社が独自に定義した名前です。ベンダーが違えば同名でも別物と考えてください。
なぜ定番の SWE-Bench などを使わないのか
ここまでの結論を信じられるかどうかは、問題の作り方にかかっています。公開ベンチマークでは、彼らの問いに答えられません。
答えが漏れる。問題も解法も公開されているので、時間が経てばモデルの学習データに入り込みます。そうなると測っているのはもう能力ではありません。
実環境に合わない。彼らのコードベースは十数言語にまたがり、Scala、Go、Rust、Java、Python、Bazel、Protobuf があり、大量のマイクロサービスもあります。汎用ベンチマークではこの複雑さを反映できません。
そこで自社エンジニアが毎日マージしているコードを問題に作り替えました。レビューを通った PR は、それ自体が良い素材です。開発者が一歩ずつ直したコミット履歴があり、人によるレビューがあり、その変更が正しいか検証するテストもあります。
まず絞り、それから作り替える
| 選別条件 | 理由 |
|---|---|
| 十分に新しい | 最近の記録を使ってこそ、現在のフレームワーク・書き方・規約が反映される |
| 人が書いたもの | ボットのコミット、サービスアカウント、AI 生成・自動生成の変更はすべて除外 |
| 質の高いテスト付き | テストがなければ採点基準がない |
| 変更が集中している | 少数のモジュールだけを触るもの。コードベースの半分にまたがる大改修は対象外 |
| 全レイヤーをカバー | Scala のバックエンド、Rust のシステムコード、React と TypeScript のフロントエンド、protobuf と gRPC のインターフェース、Bazel の設定まで揃える |
課題文に書き直すとき解法を削る。PR の説明には、そのバグをなぜこう直すべきかがたいてい書かれています。それは答えを問題文に書いてしまうのと同じ。残すのは「何を達成するか」と「どんな制約があるか」だけです。
テストは別に取り出して隠す。彼らのビルドシステムは、変更されたファイルに依存するテストをもともと算出できます。そのテスト一式をそのまま走らせて採点基準にしました。
全問を人が見る。スクリプトと AI は候補を出すためだけに使用。元のテストを書き直す必要がある問題もあります。実装方法を1つに限定しすぎているものは緩め、緩すぎるものは締める。この書き直しに AI は使わず、すべて手作業です。

AI に採点させないのは、それが「正しそうに聞こえる答え」を評価してしまうから
採点の流れはこうです。モデルが「終わった」と言ったら、その時点のコードを保存し、隠しておいたテストを戻して走らせ、全部通ればその問題は正解。評価の全過程で大規模言語モデルを審査員に使っていません。理由はこうです。
We did not use an LLM judge to evaluate correctness, since we've found that this rewards sounding right over being right. 正しさの評価に LLM の審査員は使いませんでした。それは「正しいこと」より「正しそうに聞こえること」を評価してしまうと分かっているからです · Databricks
テストが通るか通らないかは二値で、解釈の余地がありません。だからこそ「質の高いテストが必須」という条件は外せないのです。採点基準の信頼性は、このテスト群にすべて賭けられています。
Databricks はどうやってカンニングを防ぎ、テストを組んだか
初期の実験では、いくつかのモデルのスコアが不自然に良すぎました。実行の全トレースを引き出して人の目で追うと、原因は環境にありました。どの問題もマージ済みのコミットから作られており、しかも完全な git 履歴が作業ディレクトリにそのまま置かれていたのです。シェルコマンドを実行できる Agent なら、git 履歴をたどって当時の「模範解答」をそのまま掘り出せてしまいます。
対処は単純明快。実行のたびに、作業コピーとリポジトリを丸ごと切り離し、git 履歴を取れなくしました。

すべてのコーディング Agent の外側とモデルは、それぞれ標準の初期設定のまま使用。Databricks のエンジニアが普段使える一般的なツールを添えただけで、テスト向けの特別なチューニングはしていません。
まとめと示唆
これは Databricks の規模がなければできない話ではありません。マージ済みの PR が一定量あるチームなら、モデルが学習していないベンチマークはすでに手元にあります。採点基準は、自分たちが書いたテストそのものです。
混ぜて使う、単一モデルに賭けない。能力のフロンティアには OpenAI も Anthropic もオープンソースも同時にいます。今日、すべての帯を1社が独占している状況ではありません。
難度でタスクを振り分ける。6割は中難度、簡単なものは安いモデルへ、複雑な設計のときだけ最上位を呼ぶ。彼らの次の一手は、この振り分けの自動化です。
まず外側というレイヤーを測る。外側を選び直すほうがモデルを替えるより安くなることもあるのに、このレイヤーはほとんどのチームが測ったことすらありません。
コストは1つ片づけるごとで数える。トークン単価では総額を予測できず、思考レベルも高いほどよいわけではありません。
彼らは今後も問題を追加していく方針で、とくに難しい問題を増やし、新しい Agent や外側が出るたびにこのテストを通すとしています。
Databricks が自社の数百万行で一斉テスト — トークン単価でモデルを選ぶと、間違える
Databricks がエンジニアのマージ済みコードから問題を作り、7モデル × 3フレームワーク × 4思考レベルを走らせた結果を、図つきで1ページに。
↓ 1ページで読了 · 動く図が1枚
公開ベンチマーク(SWE-Bench など)は問題も答えもネット上にあり、時間が経てばモデルの学習データに入り込みます。測っているのはもう能力ではありません。Databricks は別の手を採りました。自社エンジニアが先週マージしたばかりのコードを問題に作り替えたのです。数字はすべて Databricks 自身が計測・採点したもので、第三者による再現はまだありません。
同じ問題群、同じ採点基準で、7モデル × 3フレームワーク × 4思考レベルを走らせると、結果は3つの帯に落ちました。第1グループにはオープンソースが1つ。智譜(Zhipu)の GLM 5.2 が87%で Opus 4.8 と互角、1問 $1.28 対 $1.94 です。
モデルを選ぶとき、ほぼ全員が100万トークンいくらかを見ています。その数字と最後に払う金額の間には、変数が1つ挟まります。モデルがそれをやり終えるまでに、どれだけ読み、どれだけ考えるか。
外側(harness)は、モデルの出力を実際の操作に変えるレイヤーのソフトウェアです。毎ターンどれだけのコードをモデルに見せるか、どのツールを呼べるか、失敗したらどう再試行するかを決めます。Claude Code、Codex、pi はどれも外側で、下にどこのモデルを挿しても動きます。同じモデル、同じ思考レベルで外側を替えるだけで、1問あたりコストは2倍以上変わります。
同じ Opus 4.8、同じ問題群で、1問解き終えるまでに累計投入された量は3.2倍の差。送らなかった情報は消えておらず、モデルは必要になったら自分で「ファイルを読む」を呼びます。pi は Armin Ronacher(Flask、Jinja2 の作者)と Mario Zechner のオープンソースプロジェクトで、GitHub のスターは約5.4万。この背景は原文に記載がありません。この勝負を制したのはサードパーティのオープンソースで、Databricks 自社の Omnigent は、モデルも外側もいつでも差し替えられるようにする製品です。
安い
トークン単価
話は!
なぜ倍違う?
↓
236k
token、claude code
から pi へ
答える前に
長く考えさせるつまみ
- × 数字はすべて Databricks の自社計測・自社採点、第三者の再現はまだない
- × 「外側を替えても品質は不変」は6組中5組で成立、max の組は7ポイント差
- × レベル名 high / xhigh / max は各社独自定義、モデルをまたいで比較不可
消した。