Uber エンジニアリングチームが超大規模でのソフトウェアファクトリー実装を解説:6つの基盤、Agentic SDLC、コスト管理
Uberのソフトウェアファクトリーを徹底解説:モデルとツールのゲートウェイ、マネージドDevPod、スキルマーケット、コンテキストグラフ、エンドツーエンドのAgentic SDLC、メンテナンスのクローズドループ、コストエンジニアリング。
- Uberのソフトウェアファクトリーは、Model Gateway、MCP Gateway、マネージドDevPod、スキルマーケットプレイス、コンテキストグラフ、そしてSlack・CLI・WebをカバーするCortanaの6つの基盤で構成されています。
- 機能開発は、ビジネス調査、要件定義、FigmaデザインをMinionに渡すところから始まります。まずインナーループでビジュアルとフロントエンド・バックエンドの検証を行い、その後CI、詳細レビュー、手動承認へ進みます。リリース後は、管理されたメンテナンスループに入ります。コード生成が拡大すると、CI、実験容量、製品判断が新たなシステムのボトルネックになります。
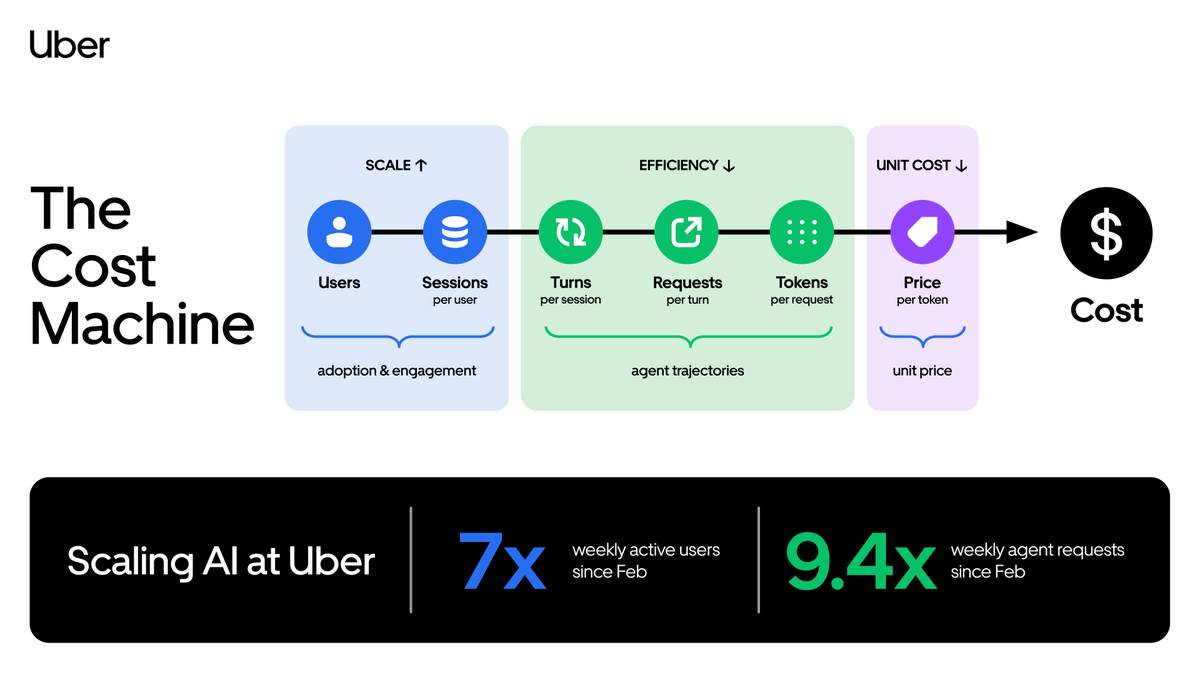
- 2026年2月から8月中旬にかけて、Uberのエージェントの週間アクティブユーザー数は7倍、リクエスト数は9.4倍に増加しました。総支出は4月以降に安定し、固定モデル後のセッションあたりのコストはピーク時から52%削減されました。
- Uberは、実タスク評価、モデルグレーディング、コンテキスト圧縮、動的ツール、コードモード、コンテキストグラフ、セッション診断を使用して無効なトークンを排除し、実行結果をモデルルーティングとスキルに継続的にフィードバックしています。
Uberのエンジニアリングチームは、超大規模なビジネス環境で「ソフトウェアファクトリー」をどのように実装したかを共有しました。モデル、ツール、コード、組織知識、実行環境を統一プラットフォームに統合し、エージェントが個人のコーディング支援から、完全かつ検証可能な開発タスクの実行へと移行できるようにしています。
2026年2月から8月中旬にかけて、Uberの全従業員が使用するエージェント製品の週間アクティブユーザー数は7倍に、週間リクエスト数は9.4倍に増加しました。リクエスト数は約10倍に増加しましたが、AI関連の総支出は4月以降ほぼ横ばいで推移しています。同じモデルに固定して観察すると、モデルリクエスト1,000回あたりのコストはピーク時から約34%減少し、セッション1回あたりのコストは6月のピーク時から52%減少しました。
同時に、プルリクエストの70%以上がローカルまたはクラウド上のエージェントによるものとされています。エンジニアはソフトウェア開発ライフサイクル全体をカバーする3,600以上のエージェントスキルを構築し、毎日30,000回以上実行しています。コードレビュー、CIの自己修復、ビジュアル検証を伴うエンドツーエンドのPR、アラートのトリアージ、バグのデバッグ、コードメンテナンスなどは、管理されたエージェントが自動的に開始し、その後、人間がレビューしたり、異常時には介入したりするケースが増えています。
これらの成果の背景には、完全なエンジニアリングシステムがあります。Uberは、統一モデルゲートウェイでID、プライバシー、予算、監査を制御しています。MCPゲートウェイは内部APIをエージェントに公開します。事前起動されたDevPodは、分離された再現可能なクロスリポジトリ開発環境を提供します。スキルマーケットプレイスは再利用可能なプロセスを管理します。コンテキストグラフは、サービス、チーム、データ、インシデントのコンテキストを提供します。そして、CortanaやMinionなどの製品を通じて、これらの機能をビジネスリサーチ、要件定義、設計、コーディング、検証、CI、レビュー、長期的なメンテナンスに至るパイプラインに編成しています。
コスト最適化は、このファクトリーの枠組みの外にある財務的なアクションではありません。Uberは総請求額を6つの測定可能な乗数に分解し、各層で無効なラウンド、無効なリクエスト、無効なコンテキストを削減しています。強力なモデルは強力な推論が必要な作業にのみ使用し、ツールはオンデマンドで読み込み、ポーリングやバッチ処理はスクリプトに残し、エージェントはコードを検索する前に組織の知識を照会します。コストと障害の軌跡は、最終的にモデルルーティング、スキル、プラットフォームのデフォルト設定に反映されます。
以下は、UberチームによるAI Engineer World's Fair 2026での完全なプレゼンテーションです。中国語が上、英語が下のバイリンガル字幕が追加されています。ビデオの長さは18分25秒で、字幕は確認済みのC2フォーマットを使用し、PPT表示領域の中央に配置されています。
登壇者:Uday Kiran Medisetty、Adam Huda(Uber)。字幕は中国語が上、英語が下です。
主要な背景:AIはすでに開発業務の大部分に浸透
Uberのスケールデータは、「導入範囲」「スループット」「自動化範囲」「単位経済」の4つの層で理解する必要があります。
- 導入範囲: 2026年2月から8月中旬にかけて、エージェントの週間アクティブユーザー数は7倍、リクエスト数は9.4倍に増加しました。利用者はエンジニアと非エンジニアの従業員をカバーしており、小規模なAIパイロットの段階を超えています。
- 開発浸透: プルリクエストの70%以上がローカルまたはクラウド上のエージェントによるものとされています。これはエージェントが多数の実際のコード変更に携わっていることを示していますが、Uberは属性の具体的な計算方法を公開していないため、「コードの70%がAIによって完全に無人で生成された」と解釈することはできません。
- プロセス資産: 8月の時点で、Uberには3,600以上のエージェントスキルがあり、毎日30,000回以上実行されています。エージェントの能力は個人の会話の中に留まるだけでなく、組織で再利用可能なワークフローとして徐々に蓄積されています。
- 管理されたタスク: 人間が即時に入力するプロンプトによって開始されないセッションが増えています。コードレビュー、CI修正、アラート処理、バグデバッグ、コードメンテナンスは、イベントやスケジュールによってトリガーできます。人間の主な役割は、目標の設定、承認、異常時のエスカレーションです。
6月のAI Engineer向けプレゼンテーションでは、さらに2つのスループットデータが示されました。Uberによると、エンジニア1人あたりのコード行数は前年比で約2倍になり、250以上の自動移行で累計約900万行のコードが処理されました。自動移行は「より多くの新しいコードを生成すること」よりも、エージェントの組織的価値を示しています。大規模な依存関係のアップグレード、APIの置き換え、設定の移行、機械的なリファクタリングは、以前は多くのチームが段階的にスケジュールする必要がありましたが、現在は統一されたプロセスで一括実行できます。
コード行数は生産量を示すものであり、品質、ビジネス成果、エンジニアリング価値を代替するものではありません。質の低いコードが大量にあれば、行数も増加します。Uberは引き続き、ロールバック率、F1、MTTR、PRがマージされたかどうかなどの指標を使用して、エージェントが許容可能な結果を提供したかどうかを判断しています。

リクエスト数は9.4倍に増加しましたが、総支出は同じ傾きで増加しておらず、単位あたりのコストが減少していることを示しています。ただし、「総コストが安定している」ことは「総コストが継続的に減少している」ことを意味するわけではありません。モデルのバージョン、タスクタイプ、利用率は常に変化しているため、月次の請求額を直接比較すると、複数の要因が混在することになります。
そこでUberは、同じモデルに固定して単位経済を観察しました。その結果、リクエスト1,000回あたりのコストはピーク時から約34%減少し、セッション1回あたりのコストは6月のピーク時から52%減少しました。後者の指標は5月末から記録が開始されました。

これらの結果は突然現れたものではありません。Uberは、過去6年間にわたるmonorepoとBazelへの移行がソフトウェアファクトリーの基盤を築いたと明言しています。統一されたコード構成、再現可能なビルド、依存関係グラフ、リモート実行、標準化されたテストにより、エージェントはコードを確実に特定し、リポジトリをまたいで変更し、繰り返し検証することができます。コードベースが断片化されたままで、ビルドプロセスが個人のコンピューターに依存している場合、管理されたエージェントが安定した環境を取得することは困難であり、並行性を安全に拡張することはさらに困難です。
ソフトウェアファクトリーの構造:4層の作業モデルと6つのインフラストラクチャ
Uberは、ソフトウェアファクトリーを2つの補完的な視点で説明しています。
最初の視点は作業がどのように開始されるかです。人間が直接汎用エージェントを操作することから、システムが明確に境界のあるタスクを自動的に割り当てることまでを含みます。2番目の視点は、すべてのエージェントが共通して依存するものです。モデル、ツール、実行環境、スキル、組織知識、統合された製品エントリポイントが含まれます。
4層の作業モデル:プラットフォームが不確実性を段階的に引き受ける

第1層は生のインタラクティブセッションです。エンジニアはローカルでClaude Code、Codex、OpenCodeなどのツールを使用し、プロンプト、コンテキスト、プロセス指示を自身で提供します。タスクの境界は会話に応じて変化するため、プラットフォームが1回のセッションで最終的に何が納品されるかを事前に判断することは困難です。
第2層はスキル付きのインタラクティブセッションです。エンジニアは依然として自ら作業を開始しますが、反復的なタスクには共有された手順、ツール、承認方法があります。個人の経験が組織の資産になり始めます。
第3層は汎用管理エージェントです。エージェントは統一されたクラウド環境で実行され、複数のスキルを呼び出すことができます。インストール、認証、権限、計算リソース、コード環境は個人のマシンに依存しなくなり、プラットフォームは各タスクのコスト、レイテンシー、結果を監視できます。
第4層は専用管理エージェントです。各エージェントは安定した成果物に対応しています。MinionはPRを生成し、uReviewはコードレビューを実行し、Conan AIはアラートの根本原因を分析し、Fawkesは定期的なコードメンテナンスを実行します。コストは「PRのマージごと」「レビューごと」「アラートごと」「クリーンアップごと」に計算でき、F1、ロールバック率、MTTRと合わせて評価できます。
第4層に近づくほど、プラットフォームは入力を固定し、ツールを制限し、モデルを選択し、背景情報を提供し、ベンチマークを実行し、結果を検証し、失敗時に人間にエスカレーションできます。オープンエンドのチャットではエンジニアが不確実性を吸収しますが、管理されたエージェントでは、プラットフォームが不確実性を構成可能で観察可能なエンジニアリング問題に変換する必要があります。
6つのインフラストラクチャ:管理されたエージェントを実際に実行可能にする
| インフラストラクチャ | 役割 | 解決するスケール問題 |
|---|---|---|
| Model Gateway | モデルアクセス、ID、プライバシー、ポリシー、メータリング、監査 | 各製品が個別にベンダーに接続し、コストを計算することを防ぐ |
| MCP Gateway | 内部APIとSaaSツールをエージェントに統一的に公開 | 各チームが認証、インストール、ツールプロトコルを繰り返し処理することを防ぐ |
| DevPod | 分離された、事前起動された、再現可能な完全な開発環境を提供 | 長時間のタスクが個人のコンピューターに依存するのを防ぎ、コールドスタートと環境のドリフトを回避 |
| Skill Marketplace | 再利用可能なワークフローの発見、品質、バージョンを管理 | スキルの重複構築、インストールの困難さ、品質の低下を防ぐ |
| Context Graph | サービス、コード、チーム、データ、インシデント、設計の関係を集約 | エージェントが数十のシステムで背景情報を盲目的に検索することを防ぐ |
| Cortana | モデル、ツール、スキル、知識をSlack、CLI、Webにもたらす | 基盤となる機能をプラットフォームの専門家だけが使用できるコンポーネントにしない |
1. Model Gateway:すべてのモデルトラフィックが最初に通過するコントロールプレーン
Uberは、内部アプリケーション、コーディングハーネス、外部ユースケースを、OpenAIおよびAnthropicと互換性のある単一のエントリポイントに統合しました。エンジニアは通常のクライアントを使用し、プロジェクトIDを提供するだけで、プラットフォームが残りの処理を実行します。
このゲートウェイには3つの重要な目標があります。デフォルトでPIIがUberの境界外に出ないようにすること。新しいセキュリティコントロールを追加する際のレイテンシーには厳格な上限があること。すべてのリクエストが特定のユーザー、プロジェクト、チームに帰属できることです。
このために、リクエストはまずSPIREベースのID認証を通過し、次にデータ匿名化レイヤーが20以上のカテゴリのPIIをクレンジングし、その後、5つの専用モデルがセキュリティとポリシーのチェックを実行します。Uberによると、一連のコントロールのレイテンシーは100ミリ秒以内に維持されています。
ゲートウェイは監査ログとセッショントレースも記録し、それらをデータレイク、ベンチマーク、継続的改善プロセスに送り込みます。予算の階層化、モデルコスト分析、セッション診断がツール間で統一的に実行できるのは、根本的に、モデル呼び出しがここで統一されたIDとプロジェクト属性を取得するためです。
プレゼンテーション時点で、このエントリポイントは800以上の内部プロジェクトにサービスを提供し、毎日1億回以上のモデルリクエストを処理していました。この数値には、コーディングと非コーディングのユースケース、最先端モデルとオープンソースモデルが含まれており、内部ホスト型とベンダーホスト型のモデルの両方を含みます。記事内のエージェントの週間リクエスト数と直接合算することはできません。
2. MCP Gateway:統一されたツールアクセス、そしてツールディレクトリのトークン税を排除
Uberには元々何千もの内部APIがありましたが、それらは自動的にエージェントが呼び出し可能なツールになるわけではありませんでした。また、Google、Slack、JiraなどのSaaSにはそれぞれ異なる認証プロセスとインストールプロセスがありました。
MCP Gatewayは、自動クローラーを使用して内部APIをMCPサーバーとして投影し、サードパーティのSaaS MCPも統一的にホストして、トークン交換、認証、ポリシーを処理します。エンジニアは、単一のエントリポイントと単一のインストール方法のみを扱います。
しかし、直接的なMCPモードではすぐに新しいスケール問題が明らかになりました。ツールが増えるほど、モデルに送信されるスキーマも増えるのです。UberはまずOmni MCPを導入し、1つのMCPがゲートウェイ内の他のツールの発見と呼び出しを担当するようにしました。次に、ツールをCLIとして投影し、ツール定義と大量の応答がコンテキストに長く留まる必要がないようにしました。さらに、code-modeスキルを自動的にインストールし、Pythonスクリプトがサブプロセスでループと集計を実行できるようにしました。
プレゼンテーションで示された全体的な結果として、この一連のMCP最適化により、全社で40%以上の削減が達成されました。8月の記事では、スキーマのオーバーヘッドとSQLの比較がさらに公開されており、その具体的なメカニズムについては後述します。
3. DevPod:エージェントに秒単位で起動し、分離され、リポジトリをまたぐワークベンチを提供
長時間実行される管理エージェントには、ローカルターミナルよりも安定した環境が必要です。起動が速く、タスク間で分離され、多数のインスタンスを同時に作成でき、Uberのグローバルなテクノロジーサイトをカバーする必要があります。
Uberは、既存のクラウドベースのリモート開発環境であるDevPodを、エージェント実行の基盤として再構築しました。Kubernetesのバルーンポッドは事前に作成され、コードリポジトリのスナップショットと検索インデックスも事前に準備されます。エージェントはタスクを受け取ると、既存の環境を直接引き継ぎ、数秒で作業を開始できます。
元のDevPodは、Go、Java、Androidなどのテクノロジースタックによって区別されていました。エージェントの出現により、タスクとエンジニアの役割はリポジトリの境界を越え始めました。そこでUberはmega-DevPodを構築し、複数のコードリポジトリを単一の統一環境に配置して、自律的なコーディングエージェントがフロントエンド、バックエンド、共有依存関係を同時に変更できるようにしました。
ここでの「管理」の意味は具体的です。エージェントのコード、依存関係、ビルドツール、検索インデックス、権限、ライフサイクルはすべてプラットフォームによって準備されます。各エンジニアが「AIを実行できる」マシンを一時的に組み立てる必要はありません。
4. Skill Marketplace:ワークフローをガバナンスが必要なソフトウェア製品として扱う
Uberは初期段階で、多くのエンジニアが異なるリポジトリで同じスキルを重複して開発しているのを目にしました。発見、インストール、設定が難しく、一部のスキルの品質も不安定でした。
このようにして、プラットフォームはSkillの完全なライフサイクルを確立しています。コアSkillと領域Skillは統一されたマーケットプレイスに並び、lintと自動レビューを経て基本的な品質基準を満たしたものだけが配布されます。エンジニアは1つのコマンドでプラグインを発見・インストールでき、プラットフォームはエンジニアの役割に応じてデフォルトのSkillを自動設定するため、エージェントは適切なプロセスを直接選択できます。
Skillのリリースは終着点ではありません。Uberは実行トレース、ユーザーレビュー、継続的な評価を収集し、失敗や手戻り、使用時の摩擦をSkillの作者にフィードバックします。これにより、Skillの改善は作者が偶発的に苦情を聞くことに依存せず、実際の実行データに基づいて行われるようになります。
6月の講演では2,500のSkillと毎日20,000回以上の実行が報告されましたが、8月の公式記事では3,600以上と毎日30,000回以上に増加しています。本文では新しい数字を使用しています。初期の数字は、このマーケットプレイスがまだ急速に拡大していることを示すものです。
5. Context Graph:多数のシステムに散在する組織の背景情報を結びつける
大規模なモノレポにおいて、エージェントはコードを書く能力を持っていても、サービスの場所、担当者、依存関係、エンジニアリングパターンといった背景情報を欠いていることがよくあります。これらの答えは、コードディレクトリ、サービスカタログ、設計ドキュメント、Jira、インシデントシステム、データカタログ、過去のクエリに散在しています。各システムに独立したSkillとMCPが必要な場合、エージェントは背景を組み立てるために大量のトークンを消費することになります。
Uberはこれらの関係をContext Graphという1つのグラフに接続しました。これは、モバイル、バックエンド、データレイク、設計ドキュメント、インシデント、バグ、チーム、サービス関係を網羅し、オンコールの根本原因分析、計画立案、データ分析、セキュリティスキャンに統一されたコンテキストを提供します。
6月の講演では「4,000万エントリ、150種類のノードとエッジ」という規模が報告されましたが、8月の記事では「2,400万ノード、8,000万エッジ、86種類のノード、117種類のエッジ」に更新されています。エントリとノード、エッジは同じ単位ではないため、これらの数値を直接比較することはできません。この記事では、正確な規模に言及する場合、より新しい8月のデータを使用します。
6. Cortana:インフラストラクチャを全員が使える入り口に変換する
モデル、ツール、環境、Skill、知識グラフが内部プラットフォームAPI経由でのみ利用可能であれば、ソフトウェアファクトリーは依然としてインフラストラクチャ層に留まります。
UberはCortanaを使用して、これらの機能をSlack、CLI、Webにもたらしました。従業員はチームのSlackチャンネルで質問でき、CortanaはContext Graphをクエリし、Skillを呼び出し、任意のコードベースを検査して、回答を元のコラボレーションコンテキストに戻します。チームはカスタムSkillとプロンプトを追加して、そのチームの背景を理解したペルソナを形成することもできます。
講演の1か月前、Uberでは300のチームペルソナが作成され、毎日20,000回以上のCortanaセッションが発生していました。この数字は、統一された入り口がコード作成だけでなく、ビジネスリサーチ、データクエリ、計画立案、複数人でのコラボレーションにも役立っていることを示しています。
これら6つの基盤は、単なる並列的な調達リストではありません。Model Gatewayはモデル呼び出しの制御方法を決定し、MCP Gatewayはツールの制御方法を決定します。DevPodは実行の制御方法を、Skill Marketplaceはプロセスの制御方法を決定します。Context Graphは背景情報の制御方法を決定し、Cortanaはこれらの機能が実際の作業にどのように組み込まれるかを決定します。
1つの機能がソフトウェアファクトリー全体を通過する方法
6つの基盤が組み合わさって初めて、ソフトウェアファクトリーが出現します。Uberは講演で、ワールドカップに関連する機能を例に、その完全な経路を示しました。それは、大規模なスタジアムの散場時に、混雑したエリアから離れやすい乗車地点を乗客に推薦するというものです。
この例は、タスクがどのように引き継がれるかを示しています。異なるエージェントが同じライフサイクルに沿って、上流の成果物を消費し、専用環境を呼び出し、検証可能なオブジェクトを下流に引き渡します。
ステップ1:実行する価値があるかどうかを最初に判断する
チームはSlackでアイデアについて議論し、その後Cortanaを招待します。CortanaはContext Graphを利用して、過去の大規模イベント、適切なスタジアム、ビジネスチャンスを調査します。
このステップは、「1つの要件に基づいてコードを書く」という範囲を超えています。エージェントはまず、チームが問題を理解し、社内データを探し、意思決定のための資料を作成するのを支援します。講演の最後に強調された新しいボトルネックもここに現れます。コードの生成がますます容易になるにつれて、チームは「構築すべきかどうか」をより早く問う必要があります。
ステップ2:アイデアを要件と実験に絞り込む
チームはまず北米での試験を決定し、CortanaにFigmaでのデザイン案の作成を支援させます。インターフェースには2つのボタン文言バージョンが用意され、A/Bテストでパフォーマンスを比較します。
要件、リリース範囲、実験変数、設計仕様は、後続のエージェントにとって明確な入力となります。これらの制約がなければ、コーディングエージェントは製品の振る舞いを推測するしかありません。制約があれば、システムは生成結果が期待通りかどうかを判断できます。
ステップ3:製品コンテキストをコーディングエージェントに引き継ぐ
Cortanaは、既存のアプリで再利用可能なページ、バックエンド機能、予想されるコード変更を分析し、タスクをUberのクラウドベースのコーディングエージェントであるMinionに引き渡します。
Minionは対話的に実行することも、自律的に実行することもできます。これは完全なmega-DevPodを取得し、同じ環境内でフロントエンドとバックエンドのコードを変更します。引き継がれる内容には、要件、設計、コードの背景、ツール、実行可能な環境が含まれており、孤立したプロンプトよりもはるかに多岐にわたります。
ステップ4:ドラフトPRのみを生成し、当面はCIに送らない
Minionはコードを完成させるとドラフトPRで停止し、変更をすぐにCIにプッシュしません。
この設計は、見落とされがちなスケールの問題に対処しています。エージェントがコードのスループットを向上させると、未検証の変更も大幅に増加します。自動生成されたすべてのdiffが完全なCIを直接占有する場合、ソフトウェアファクトリーは単にボトルネックをエンジニアの時間からビルドキューとテストリソースに移すだけです。
そのため、Uberはまずエージェントに対し、より安価でコードに近いインナーループで自己検証を完了することを要求します。
ステップ5:より多くの検証をインナーループに移す
インナーループには、従来の静的チェックに加えて、これまでCIや手動レビューを待たなければ発見できなかった問題のチェックも含まれます。
- モバイルシミュレータを起動する。
- Skillを呼び出してページのスクリーンショットを撮る。
- スクリーンショットをFigmaの仕様と比較する。
- バックエンドのステージングサービスを起動する。
- フロントエンドとバックエンドが実際に接続できることを検証する。
- 問題を発見したら直接修正し、チェックを再実行する。
視覚的な検証では、ページが実行可能であることを確認するだけでなく、A/Bバージョンのボタン文言、レイアウト、インタラクションが設計入力と一致しているかを確認する必要があります。フロントエンドのスクリーンショットが正しくても、バックエンドのAPIが機能しない場合は、次の段階に進むことはできません。
ステップ6:インナーループでの検証後にCIと詳細なレビューへ
インナーループが完了すると、PRはアウターループに入ります。CIでエラーが発生する可能性は依然としてあり、UberはセルフヒーリングCIを使用して、失敗の一部を自動的に診断および修復します。
コードレビューも階層化して実行されます。インナーループでは、より小型で高速なモデルを使用して即時チェックを行い、アウターループでは、より高性能なモデルと専用のSkillを使用して詳細なレビューを実施します。この階層化は、コスト、フィードバックの速度、問題の難易度に同時に対応します。ローカルの小さな問題は迅速な反復が必要であり、マージ前のリスク判断にはより強力な推論が必要です。
ステップ7:コードだけでなく、検証証拠を人間に渡す
自動生成されたdiffに関してレビュアーが最も不安に感じるのは、エージェントが最初のバージョンを生成した後に他に何をしたのか分からないことです。そこでUberは、実行された静的チェック、シミュレータ検証、フロントエンドとバックエンドの統合、CI、コードレビューをリスト化したチェックリストをPRに添付し、スクリーンショットも含めています。
人間はもはや「エージェントがこれらのコードを生成した」という事実だけを見るのではなく、「この変更がどのようなステップを経て、どのチェックに合格し、どこに人間の判断がまだ必要か」を確認できます。人間によるレビューはなくなりません。それはより完全な証拠を得て、要件、リスク、異常に注意を集中させることができます。
このパイプラインは、ソフトウェアファクトリーの中核的な変化を明らかにしています。開発の対象はもはやコードファイルだけではなく、要件、設計、実装、検証証拠を含み、機械が読み取って処理を継続できるタスクパッケージです。
コストの内訳:6つの乗数がソフトウェアファクトリーにどのように影響するか
Uberは乗法式を使用してエージェントの総支出を分解しています。
総支出 = ユーザー数 × 1人あたりのセッション数 × セッションあたりのターン数 × ターンあたりのリクエスト数 × リクエストあたりのトークン数 × トークンあたりの価格

これら6つの項目は、それぞれ管理目標が異なります。
| コスト項目 | 望ましい変化 | ソフトウェアファクトリーでの対策 |
|---|---|---|
| ユーザー数 | 増加 | Cortana、複数のエントリポイント、統一認証により利用障壁を下げる |
| 1人あたりのセッション数 | 増加 | エージェントが、より価値が高く検証可能なタスクを引き受けるようにする |
| セッションあたりのターン数 | 減少または効率化 | 要件の明確化、Skill、インナーループ検証、誤ったパスの早期停止 |
| ターンあたりのリクエスト数 | 減少 | Context Graph、適切なツール、非効率なサブエージェントの排除 |
| リクエストあたりのトークン数 | 減少 | 圧縮、キャッシュ、オンデマンドツール、code-mode |
| トークンあたりの価格 | タスクに応じて削減 | ベンチマーク駆動のモデルルーティング |
最初の2つの項目は、利用拡大とエンゲージメントを表します。ソフトウェアファクトリーが成功すれば、これらは成長し続けるはずです。Uberが主に圧縮するのは、中間の3つの項目です。これらは、エージェントがユーザーの目標を達成するために行う検索、ポーリング、再試行、冗長なコンテキストの保持といった余分な作業を表します。最後の項目は、モデルの選択によって制御されます。
4つの乗数を調整して、成長と最適化がどのように連携して相対的な総支出を変えるかを観察します。
基準:すべての乗数が1.00倍です。
乗法関係は、小さな非効率性を拡大します。使用されないツールのスキーマがすべてのリクエストに含まれると、その影響はターン数、セッション数、ユーザー規模によって繰り返し増幅されます。また、背景情報が不足しているタスクで10ターン検索し、毎ターン増え続ける履歴を保持する場合、リクエスト数とトークン数の両方が悪化します。
そのため、Uberは5つのレベルのメトリクスを同時に監視しています。それは、会社全体の帰属コスト、ツールごとのユニットエコノミクス、モデルごとのリクエストとコストのシェア、コスト変化のドライバー分解、そしてマネージドエージェントの結果コストと品質です。
本当に最適化すべきは結果の単位です。つまり、質の高いレビューの完了、PRのマージ、アラートの処理、技術負債の解消にどれだけのコストがかかり、品質が維持されているかです。「100万トークンあたりのコストがどれだけ安いか」だけでは、この問いに答えることはできません。
コスト対策1:実際のタスクに基づいてモデルを役割分担する
モデルベンダーがトークンの価格を決定し、Uberはどのタスクにどのモデルを使用するかを決定します。Uberは汎用リーダーボードに依存せず、マネージドエージェントのタイプごとに実際のビジネスベンチマークを構築しました。
uReviewを例にとると、Uberは既知のバグを含む実際のPRから評価セットを構築し、easy、medium、hardの難易度に分類しました。各モデル構成は同じハーネスで実行され、以下の指標が記録されます。
- precision、recall、F1。
- レビュー1回あたりの実際のコスト。
- 遅延、タイムアウト、出力ノイズ。
- タスクを安定して完了できるかどうか。
その後、「コスト対品質」のパレートフロンティア上にある構成のみが選択されます。パレート最適とは、品質を低下させずにコストを削減できる、またはコストを増やさずに品質を向上できる、他の構成が存在しないことを意味します。モデルの能力は常に変化するため、このフロンティアは数週間ごとに移動する可能性があり、モデルルーティングは継続的な評価作業です。

対話型エージェントでは、メインエージェントとサブエージェントに階層化されています。メインエージェントは目標を理解し、タスクを分解し、作業を割り当て、結果を検証する役割を担い、デフォルトでより高性能なモデルを使用します。サブエージェントは、範囲がより限定され、入力がより明確なタスクを受け取り、デフォルトでより安価なモデルを使用しますが、手動によるオーバーライドのオプションも残されています。
完全なSDLCは、さらに別の階層化を示しています。インナーループのレビューは低遅延である必要があるため、小型モデルを使用できます。一方、アウターループのレビューはマージ前の深いリスク判断を担当するため、より強力なモデルと専用のSkillを使用します。
安価なモデルが本当に便利なのは、タスクの境界が明確で、結果を検証できる場合だけです。メインエージェントのタスク分解を誤ったり、ツールが不完全だったり、システムが完了状態を判断できない場合、低価格での呼び出しによって発生する手戻りコストが、モデルの価格差を上回る可能性があります。
一般的なチームであれば、まずコードレビュー、依存関係のアップグレード、テスト生成、Feature Flag のクリーンアップなどから、小規模なベンチマークを構築するとよいでしょう。評価の対象は「合格できる結果」であるべきで、モデルの出力がどれだけ賢く見えるかではありません。
コスト削減の方法2:リクエスト、ツール呼び出し、探索の圧縮
エージェントは、ラウンドのたびに通常、会話履歴、プロジェクトの説明、ツール定義、ツールの実行結果を再送信します。不要な情報がコンテキストに残っている限り、後続のリクエストでその分の費用が発生し続けます。Uber は、デフォルトパラメータ、キャッシュ、ツールプロトコル、実行方法、組織知識という5つの領域でペイロードを削減しました。
1. 長大なコンテキストになる前に、能動的に圧縮する
モデルが100万トークンのコンテキストをサポートしていても、Uber の対話ハーネスは40万トークンで自動圧縮を起動します。コンテキストの最大容量は、経済的に利用できる容量を意味するわけではありません。履歴が長くなるほど、毎回の入力コストが増加し、キャッシュが無効になった後のプレフィックス再構築にもコストがかかります。
推論強度のデフォルトは Medium に設定されています。出力トークンと内部推論トークンは通常、入力トークンよりも高価です。日常的なタスクの多くは Medium を使用することで、品質とコストのバランスを取ることができます。困難なタスクでは推論レベルを上げることも可能ですが、高レベルがすべてのセッションのデフォルトになることはなくなりました。
2. キャッシュ TTL は実際のセッション間隔に合わせて設定する
プロンプトキャッシュは、送信済みのコンテキストプレフィックスを再利用できます。資料に示された価格関係は次のとおりです。キャッシュ読み取りは通常の入力価格の約0.1倍、5分間のキャッシュ書き込みは約1.25倍、1時間のキャッシュ書き込みは約2倍です。
長い TTL の書き込みは高価ですが、エンジニアがターミナルを離れてドキュメントを調べたり、ビルドを待ったり、会議に参加したりする場合があります。5分間のキャッシュが頻繁に期限切れになると、次のラウンドでは全額を支払ってプレフィックスを再構築する必要があります。

Uber は、人間が操作するメインスレッドを5分から1時間に調整しました。短いタスクのみを実行するサブエージェントは、引き続き5分を使用します。正しいアプローチは、実際のターン間隔を統計的に測定してから TTL を決定することであり、すべてのワークフローに同じキャッシュ時間を使用することではありません。
3. MCP ツールはオンデマンドで読み込み、ツールディレクトリの初期コストをなくす
標準的な MCP は、セッション開始時にインストール済みツールの全スキーマをコンテキストに詰め込みます。Uber の測定によると、100以上のツールをインストールすると、初期プロンプトに約50K〜70Kトークンが追加され、その後のターンでも繰り返し送信されます。大規模な SaaS MCP が複数重なると、ツールの説明が編集対象のファイルよりも長くなることさえあります。

Uber は2つの方法でこの固定コストを排除しています。CLI は呼び出し時にターゲットツールを動的に解析するため、1,000以上のツールを事前にコンテキストに入れる必要がありません。ツール検索はまずディレクトリを検索し、現在のタスクに本当に必要なスキーマのみを読み込みます。
統合ゲートウェイは、認証、ポリシー、監査、メータリングを引き続き担当します。変わったのは、モデルがツール定義をいつ見るか、そしてツールの生の応答を履歴に残す必要があるかどうかです。
4. code-mode でポーリング、ループ、大きな結果をサンドボックス内に留める
非同期 SQL クエリでは通常、タスクの送信、run id の取得、ステータスのポーリング(2〜5回)、結果の読み取りという手順が必要です。標準的なツール呼び出しではモデルが各ステップに関与するため、すべての中間状態がコンテキストに入ります。
code-mode では、モデルが Python スクリプトを生成し、サブプロセスが送信、ポーリング、フィルタリング、要約を実行して、最終的なサマリーのみをモデルに返します。これにより、対話のラウンド数は3〜7回から、スクリプト実行1回に短縮されます。

| クエリ | 標準ツール呼び出しトークン | code-mode トークン | 削減率 |
|---|---|---|---|
SELECT 1、1行 |
903 | 402 | 55% |
COUNT(*)、1行 |
954 | 403 | 58% |
GROUP BY LIMIT 20、20行 |
1,600 | 457 | 71% |
SHOW COLUMNS、175行 |
2,200 | 900 | 59% |
ワイドテーブル SELECT *、50行 |
1,431,594 | 900 | 約 100% |

小さな結果セットでも半分以上を削減できることから、その利点はワイドテーブルのフィルタリングだけに起因するものではないことがわかります。スキーマの初期化、複数回のポーリング、繰り返されるステータス、段階的な推論は、すべてモデルのコンテキストから除外されます。バッチワークフローでは、N回のモデルターンを1回のスクリプト実行に変えることで、90%以上の削減が可能です。Uber はすでに、一般的な MCP サービス向けに25以上の既製 code-mode スキルをデプロイしています。
5. Context Graph で正しい入り口を提供してから、エージェントに行動させる
組織の背景情報がないエージェントは、往々にして時間をかけて失敗します。サービスの所有者、データテーブル、過去のPR、インシデント記録などを見つけられないと、リポジトリの検索、ドキュメントの閲覧、サブエージェントの起動、ツールの再試行を続けます。エラーの分岐ごとにリクエストが増え、次のラウンドで持ち越す履歴も長くなります。
Uber の AI Context Graph は30以上の内部システムを接続し、2,400万のノード、8,000万のエッジ、86種類のノード、117種類のエッジタイプを含み、サービス、チーム、インシデント、PR、アーキテクチャドキュメント、デプロイ、データセット、過去のテーブル使用記録をカバーしています。
同じ内部の質問、同じモデルでの比較では、Context Graph を持つエージェントは4回ツールを呼び出し、38秒で50人以上のアナリストが使用する正しいデータテーブルを見つけました。一方、Graph がないエージェントは20分9秒かかり、2つのサブエージェントを起動し、3回のエラーが発生した後、最終的にデータをクエリできないと誤って判断しました。

これは単一の問題に関する内部事例であり、すべてのタスクで同様の倍率の高速化が得られることを示すものではありません。しかし、そこで明らかになったメカニズムは安定しています。高品質な背景情報は、検索リクエスト、エラーブランチ、待ち時間、手戻りを同時に削減するということです。
小規模なチームは、数千万ノードのグラフをすぐに再現する必要はありません。サービスディレクトリ、コード所有者、過去のPR、インシデント記録、頻繁に使用されるデータテーブル、アラート、デプロイ記録など、最も一般的な検索の失敗から始めることができます。目標は、エージェントが盲目的な検索を始める前に、正しい入り口を提供することです。
リアルタイムコストから運用保守へ:フィードバックをシステムに戻す
ソフトウェアファクトリーには2つのフィードバックループがあります。1つ目は1回のセッションでいかに無駄を減らすかを扱い、2つ目は1つの自動化を長期的な運用でいかに改善するかを扱います。
セッションフィードバック:無駄が発生したらエンジニアがすぐに気付けるようにする
Uber はターミナルのステータスバーに、トークン数、コンテキスト使用量、現在のセッションコスト、推論強度を常時表示しています。すべての対話ハーネスは共通の予算階層を共有し、管理されたエージェントは独立した階層を使用します。予想支出の50%、80%、100%に達すると Slack で通知され、階層を超えるにはマネージャーの承認が必要です。
ステータスバーにより、エンジニアは月末に集計された請求書を見るのではなく、セッションの進行中に、モデルの変更、コンテキストの圧縮、タスクの分割、誤った検索の中止などを判断できます。
セッション分析ダッシュボードは、ローカルおよびクラウドサンドボックスのトレースをさらに読み取り、16種類の無駄なアンチパターンを特定します。
- 単純な複数ターンのタスクに過剰に重いモデルを使用している。
- 40KB の MCP 応答が履歴に残り、後続のリクエストで繰り返し課金される。
- 長い時間を置いて古いセッションを再開したため、キャッシュが期限切れになっている。
- ユーザーがまだタスクを入力していないのに、100,000トークンのシステム説明とツール定義を事前に読み込んでいる。

診断は個人を教育するだけではありません。同じ問題が繰り返し発生する場合、プラットフォームチームはデフォルトのモデル、TTL、スキル、ツールゲートウェイ、コンテキスト供給を変更し、次のセッションバッチがより良いデフォルト値から開始できるようにします。
保守フィードバック:自動化ループには統一スケジューリングと結果ラベルが必要
機能がマージされた後も、ソフトウェアファクトリーは Feature Flag のクリーンアップ、依存関係のアップグレード、定期的なメンテナンスを処理する必要があります。Uber はサービスが保守スキルに参加することを許可していますが、各チームが随意に恒久的なエージェントループを起動することを許可していません。
定期的なタスクは統合された管理ループに入ります。プラットフォームは、CI 容量が空いている日曜日にメンテナンスをスケジュールし、月曜日の朝にエンジニア宛に送信される自動 PR の数を制限できます。これにより、バックグラウンドエージェントがビルドリソースを際限なく奪い合ったり、大量の低優先度 diff でエンジニアを圧倒したりするという、2つの現実的な問題が解決されます。
保守スキルによって生成された diff は、コメントを受け取ったり、マージされたり、拒否されたりします。これらの結果は、スキルの評価と改善にフィードバックされる実際のラベルデータとなります。Uber はまた、インシデントレビューから繰り返し可能な修正パターンを毎月程度抽出し、それらを新しい保守スキルに変換して、さらに多くのサービスに適用することを計画しています。
これにより、インシデントがパターンを顕在化させ、チームがそのパターンをスキルとしてコード化し、管理ループがスキルを実行し、PR 結果がラベルを生成し、ラベルがスキルを改善する、という閉じたループが形成されます。自動化は一度の完璧なプロンプトに依存するのではなく、管理された運用の中で組織の経験を蓄積していきます。
目標と例外は人間のレビューで対応する
完全管理下でも、明確な人間の責任が必要です。人間は、タスクに価値があるかどうか、要件が妥当かどうか、リスクが許容できるかどうかを決定し、エージェントが確実に判断できない例外を処理します。
プラットフォームは、反復実行、環境準備、証拠収集、一般的な修正を担当し、人間は段階的な操作から、目標、受け入れ基準、境界へと注意を移します。PR チェックリスト、スクリーンショット、コストトレース、スキル実行記録はすべて、この責任分担に必要な証拠となります。
新たなボトルネックと導入ガイド:より速く書くことからシステム全体のスループットへ
エージェントがより多くのコードを生成すると、既存のエンジニアリングシステムは新たなプレッシャーにさらされます。
1つ目は CI 容量です。自動 diff が増加すると、ビルド、テスト、シミュレータのリソースが最初に枯渇する可能性があります。そのため Uber は検証を前倒しし、容量に応じてメンテナンスタスクをスケジュールしています。
2つ目は 実験容量です。製品はより迅速に多くの選択肢を生成できますが、ユーザートラフィック、実験期間、統計リソースには限りがあり、チームが無限の A/B テストを同時に実行することはできません。
3つ目は 意思決定能力です。実装コストが下がると、組織は「できるか」という問いに答えやすくなりますが、「すべきか」という判断は依然として必要です。ビジネス価値、リスク、ユーザーエクスペリエンス、戦略的優先順位は、コード生成が高速化されたからといって自動的に解決されるわけではありません。
Uber の実践は、段階的な構築ロードマップとして整理できます。
ステップ1:まず再現可能なエンジニアリング基盤を構築する
コードの構成、ビルド、テスト、依存関係、リモート開発環境を統一します。エージェントがエンジニアのビルドプロセスを安定して再現できない場合、その後の自律運用は環境問題を増幅するだけです。
ステップ2:モデルとツールの入り口を集約する
すべてのモデル呼び出しは統合ゲートウェイを通過し、ID、プロジェクト、チーム、コスト属性を取得します。内部 API と SaaS は MCP ゲートウェイを通じて認証とポリシーを統一します。コントロールプレーンがない場合、予算、監査、モデルルーティングは断片化されます。
ステップ3:測定可能な結果から始める
コードレビュー、依存関係のアップグレード、テスト生成、フィーチャーフラグの整理、アラートのトリアージなど、境界が明確な作業を選びましょう。成果の単位と品質ラインを定義します。レビュー1回ごと、マージしたPRごと、アラート1件ごとに、F1、ロールバック率、MTTR、または人手による受け入れを紐づけます。
ステップ4:まずスキル化し、その後にマネージド化する
タスクの入力、手順、ツール、受け入れ方法をスキルとして固定化し、マーケットプレイスで品質とバージョンを管理します。繰り返し発生し、境界が安定し、結果を受け入れ可能なプロセスだけが、自動トリガー型の専用エージェントへの格上げに適しています。
ステップ5:エージェント向けに環境とコンテキストを準備する
分離された環境を事前に起動し、コードスナップショット、検索インデックス、リポジトリ横断的な機能を用意します。また、サービス担当者、過去のPR、障害情報、データカタログを接続しておきます。エージェントはタスクを受け取った際、まず正しい入り口を獲得できるようにすべきであり、組織構造を推測するために何十回もやり取りする必要はありません。
ステップ6:検証を前倒しし、証拠を提出する
完全なCIを占有する前に、静的チェック、シミュレーター、ビジュアル比較、フロントエンドとバックエンドの統合テストを実行します。PRにはコードだけでなく、チェックリスト、スクリーンショット、実行済みの手順も含め、人間が効率的に受け入れられるようにします。
ステップ7:6つのコスト項目の計算式を定義する
ユーザー、セッション、ターン数、リクエスト、トークン、モデル単価を分けて集計します。履歴、システムプロンプト、ツールスキーマ、ポーリング応答、大きな結果を確認しましょう。必要なときに読み込めるものは事前に読み込まず、スクリプト内でループできるものは、モデルにポーリングをさせるべきではありません。
ステップ8:実タスクでモデルを継続的に選定する
既知の回答と失敗パターンを持つベンチマークを構築し、品質、レイテンシ、タイムアウト、ノイズ、実際のコストを記録します。メインエージェント、サブエージェント、インナーループレビュー、アウターループレビューでは異なるモデルを採用できますが、どのルーティングも結果品質を前提とします。
ステップ9:長期的なループを集中管理する
定期的なメンテナンスは、予算、CI容量、タスク頻度、PR数によって制限されなければなりません。コメント、マージ、却下、障害の振り返りを、スキル改善のためのデータにしましょう。各チームが監視不能な定期実行エージェントを個別に持つ必要はありません。
ステップ10:組織のボトルネックを再管理する
CIキュー、実験容量、レビュー負荷を継続的に観察します。コード生成の速度が向上した後は、投資の重点を検証インフラ、プロダクト決定、優先順位管理に移す必要があります。
Uberがエージェントのスループット拡大と単位コストの低減を同時に実現できたのは、ソフトウェア開発を測定可能な生産システムへと変えたからです。モデル、ツール、環境、スキル、知識、プロダクトの入り口がすべて統一的に管理され、タスクは要件から保守まで明確な引き継ぎを持ち、各エージェントには成果指標と評価セットがあり、無駄や失敗は最終的にプラットフォームのデフォルト値とスキルの改善へと還元されます。
リクエストが9.4倍に増加しても総支出が比較的安定していたことは、このシステムを運用した後の財務的な結果です。より深い変化は、エンジニアがすべての機械的なステップを自ら実行する必要がなくなった一方で、組織は「何に価値があるか」「何をもって完了とするか」「どのリスクは人間が判断すべきか」をより明確に定義しなければならなくなった点です。
Uberソフトウェア工場:Agentの処理量とコスト
6つの基盤がAgentic SDLCを支え、6要素のコスト式が無駄な検索、ツール読込、ポーリング、コンテキストを削減します。
リクエスト9.4倍増加でも単価は低下
週間アクティブユーザー7倍、週間リクエスト9.4倍。
PRの70%以上、3,600以上のスキル、1日あたり30,000以上の実行。
固定モデル:1,000リクエストあたり-34%、セッションあたり-52%。
Uber社の報告によると、PRの70%にエージェントが関与していますが、コードの70%が人間なしで生成されているわけではありません。
6つの基盤でモデル呼び出しを管理可能なタスク実行に変換
ID管理、プライバシー、ポリシー、メータリング、監査を担当。
内部APIとSaaSツールのオンデマンド検出。
プリウォーム、分離、リポジトリ横断の実行環境。
プロセスの発見、インストール、評価、バージョン管理。
サービス、チーム、データ、インシデント、PRを関連付け。
Slack、CLI、Webの統合エントリーポイント。
成果物はコードだけでなく「コード+検証証跡」
履歴、範囲、実験、受け入れ条件を事前に整備。
FigmaとコードコンテキストをMinionに提供。
スクリーンショット、ビジュアル、静的解析、結合テストを先行してCIを保護。
CIと詳細レビューの後、コードと証跡を人間に引き渡し。
検証を前倒しすることで、CIと人間の注意力はより成熟した候補に集中できます。
総コスト=ユーザー数×セッション数×ターン数×リクエスト数×トークン数×単価
実タスクで評価。メインエージェントには高性能、サブタスクには低コスト。
中程度。400K圧縮。メインスレッドTTL 1時間。
ツールはオンデマンドでロード。スクリプトでポーリングと大規模結果を処理。
4回の呼び出し、38秒で解決。グラフなしでは20:09かかり誤判定も発生。
トークン単価だけでなく、良好な成果あたりのコストを最適化します。
再現可能な基盤を構築してから、エージェントの自律範囲を拡大
コード、ビルド、テスト、リモート環境を統一。
モデル、ツール、ID、予算、監査を集中管理。
境界が明確で、ロールバック可能、測定可能なタスクを選択。
まずプロセスと受け入れ条件を固定し、その後管理されたエージェントに移行。
結果を評価にフィードバック。CI、実験、レビュー負荷を監視。
Agent リクエストが9.4倍に増加、なぜ請求書は暴騰しなかったのか
林舟トラフィックが10倍近い。モデル価格の低下を待っていては請求書が持ちこたえません。
規模の拡大自体が目標です。削るべきは、タスク完了に不要な往復、リクエスト、コンテキストです。
林舟まず共通機能をプラットフォーム化する。そうすればAgentを管理下に置けます。
統合された制御面により、各リクエストは帰属、計測、監査が可能になり、再現可能な環境で実行されます。
林舟単価だけ見てもダメ。無駄なリクエストは履歴を毎回持ち出しますから。
Uberはまずターン数、リクエスト数、リクエストごとのトークン数を最適化し、実際のタスク評価でモデルルーティングを決定します。
緑のAgentカー正しい入口をくれれば、推測しながらトークンを燃やさずに済みます。
同じ内部問題で、グラフ付きAgentは4回の呼び出しと38秒で正しいテーブルに到達。グラフなしは20分9秒かかり誤判定しました。
林舟人間が全ステップを再現する必要はない。ただし、何を検証したかは見える必要があります。
検証の前倒しにより、未熟な差分がCIを占有する時間が減ります。人間は引き続き要件、リスク、異常の判断を担当します。
林舟ソフトウェア工場は一度きりのデプロイではなく、結果から改善し続けるシステムです。
Uberは実行トレース、コスト、品質、人間の判断をモデル、スキル、スケジューリングの既定値に書き戻し、次のタスクをより良い設定から始めます。