GoogleがNano Banana 2.1を発表:より自然な描写と、より一貫した画像編集を実現
Flash級の効率性を維持しつつ、画質、テキストレイアウト、被写体の一貫性、部分編集を改善。複数画像、検索、動画の参照にも対応。
Googleは高効率な画像生成・対話型編集モデル「Nano Banana 2.1」(APIモデル名は gemini-nano-banana-2.1)を発表しました。Nano Banana 2のアップグレード版としてGemini 3.6 Flashアーキテクチャをベースに構築されており、Flashクラスの応答速度とコスト効率を維持しながら、主に以下の機能と特徴をもたらしています:
- 自然な描写と微細な質感:透光素材、雪原の朝光、毛髪や織物、油絵の筆跡などの微細なテクスチャを改善し、さまざまな解像度における画像のリアリティとディテール表現を向上;
- テキストレイアウトとデザイン配置:文字レンダリングの鮮明さ、余白の制御、幾何学的なレイアウト配置を強化し、整った視覚的ヒエラルキーを備えたポスター、図表、Webページのデザインカンプを直接生成しやすくしています;
- 複数の参照対象と連続編集:1回のリクエストで最大14枚の参照画像の入力に対応(公式スペックでは最大4人のキャラクターの顔の一貫性と、10個のオブジェクトのディテール再現性をサポート)。対話ターンを引き継いだ連続的な微調整も可能;
- マスクおよび落書きによる再描画:クリエイターは落書きで画像内の被写体を囲み、元の輪郭や位置を維持したまま、周囲の背景や雰囲気をピンポイントで置き換え可能;
- 極端な縦長・横長アスペクト比への対応:1:1から1:8、8:1までを含む15種類のアスペクト比をサポートし、2Kおよび4K出力時におけるパノラマ・長尺画像のタイリング継ぎ目アーティファクトを修正;
- 検索による補完と思考(Thinking)推論:Googleのウェブ検索や画像検索と連携して事実情報や視覚的な参照を補完できるほか、設定可能なThinking思考プロセスを通じて生成品質とレイテンシのバランスを調整可能。
画質の質感がより自然に、光と影や微細なマテリアルを捉える
Nano Banana 2.1において「画像がより自然になった」という点は、単に画素数が増えただけでなく、物体の質感、光と影のグラデーション、芸術的な筆跡などに表れています。Googleが公開した以下の生成サンプルから、これらの変化をより分かりやすく確認できます:

ドライフラワーの花びらの半透明感と網目状の葉脈が、背景のボケ味とともにマクロ撮影のような立体感を生み出しています。

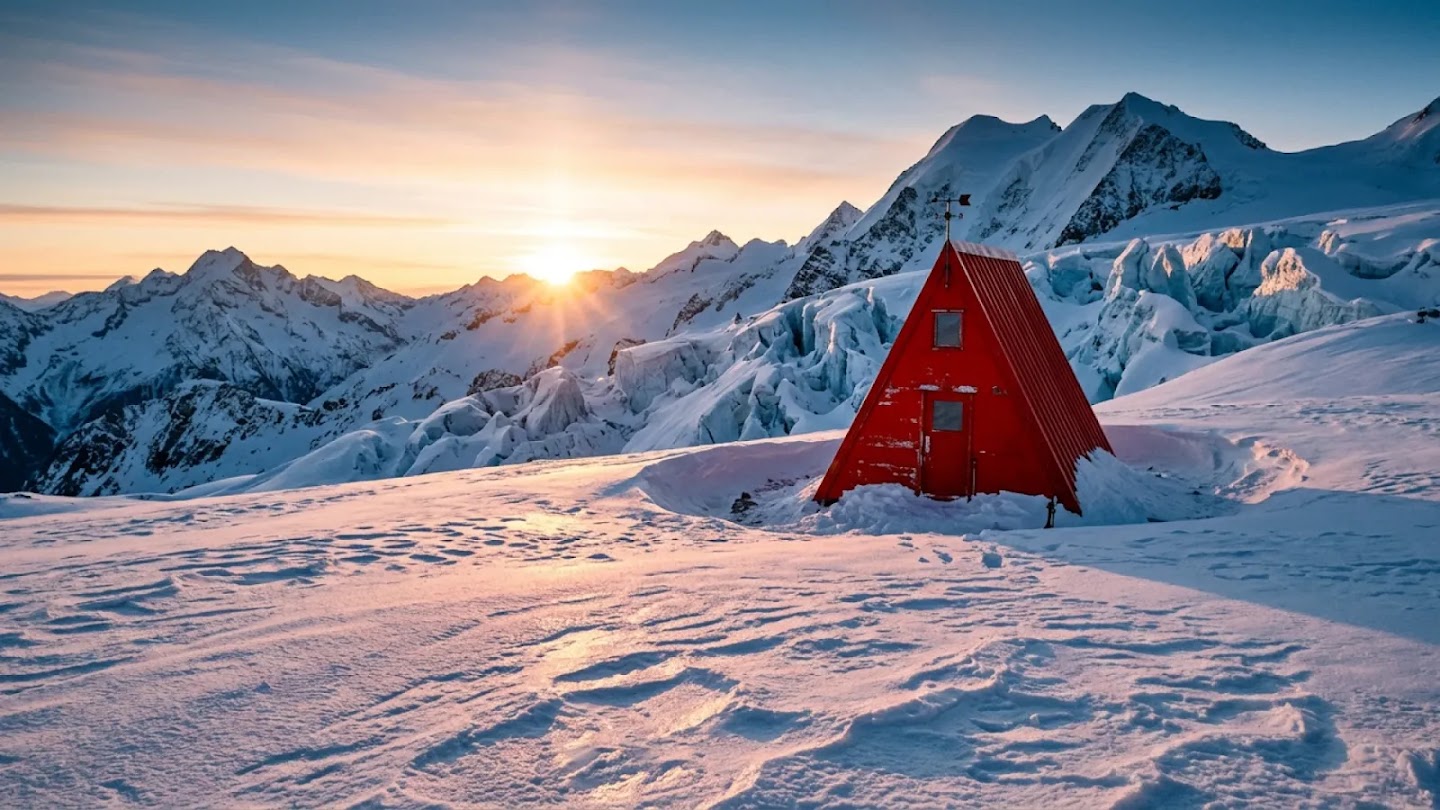
自然風景では、低角度の日光が生み出す暖色系の反射光と氷河の影の寒色トーンが明確なコントラストを描き出し、雪面や建物に当たる光の寒暖差をより自然に見せています。

人物と動物が共存するシーンでも、重厚な衣類、皮膚の質感、動物の長い毛並みといった異なるマテリアルが、それぞれの質感の違いをしっかりと維持しています。

写真以外の芸術的スタイルにおいても、モデルはプロンプトの指示に従って絵の具を厚く重ねたような筆跡のテクスチャを再現し、激しくうねる波のダイナミズムを伝えています。これらのサンプルは、プロンプトによって光、質感、スタイルをどのようにコントロールできるかも示しています。
パノラマや長尺画像:不自然な継ぎ目をまず解消
長尺画像、パノラマバナー、超ワイドポスターを作成する際、旧版のNano Banana 2では一部のアスペクト比において2Kや4Kで出力すると「タイリング偽像」(不自然な繰り返し模様やグリッド状の継ぎ目)が発生することがありました。
Nano Banana 2.1では、これらの出力課題に対して以下の更新が行われました:
- 標準から極端な比率まで幅広くカバー:一般的な1:1、3:4、16:9から、極端な縦長スライスやパノラマ画角まで(1:4、4:1、1:8、8:1など計15種類の比率を含む)をサポート。
- 特定の長尺画角におけるタイリング偽像を修正:2Kおよび4K設定でパノラマや極端に細長い構図を出力する際、モデルは画面全体の連続性を維持できるようになり、長尺画角の継ぎ目に見られた不自然な模様やスライス感を効果的に解消。
- 段階的な出力解像度:デフォルトの出力は1K解像度ですが、クリエイターや開発者は利用シーンに応じて2Kまたは4K画像を自由に指定でき、SNSでの即時プレビューから高精度な出力まで多様なニーズに対応。
テキストとレイアウトが画面とより調和
AI画像をポスター、EC向け広告、UIプロトタイプなどにそのまま活用する際、最大の課題となるのは画面内の文字が潰れたり文字化けしたりして判読できない点でした。Nano Banana 2.1ではテキストレイアウトの整列と文字描画の能力が強化され、プロンプトに従って視覚的ヒエラルキー、余白、フォントスタイルをより的確に組み立てられるようになっています。

単枚のアートポスターだけでなく、一連のプロモーション素材や連続するビジュアルカンプを制作する際にも、Nano Banana 2.1公式ギャラリーで示されている「テキストレンダリング」「被写体の保持」「部分編集」の3つの能力がそれぞれ役割を果たします:
- テキストレイアウト:デザインカンプのサンプルが示す通り、モデルはプロンプトの指示に沿ってフォントサイズ、余白、幾何学的グリッドを構成でき、ポスターやWebページのビジュアルカンプに明確なテキストの階層構造を持たせ、後工程での再レイアウトの手間やズレを軽減します;
- 被写体の保持:公式のプロダクトギャラリーにあるように、モデルはサンプル内で中心となるアイテムの輪郭やゴールドの金具を維持したまま異なる光影シーンへ配置しており、一連のプロモーション画像における主力商品の変形や崩れを抑えるのに役立ちます;
- 部分編集:公式の落書き再描画のサンプルのように、被写体を落書きで囲むことで、元の被写体が持つ微細な質感や形状を維持したまま周囲の環境を素早く差し替えることができ、同一のフォーカスを中心に異なる雰囲気や構図を迅速に模索できます。
Nano Banana 2.1はGoogleのウェブ検索および画像検索(Search Grounding:生成時に検索結果を参照して補完する機能)にも対応しており、インフォグラフィックのテキストやレイアウトの表現力も向上しています。ただし、画面内の知識や事実関係が正しいかどうかは、視覚デザインの完成度とは別に判断する必要があります。
デフォルトの1K解像度では、小さな文字は依然として不鮮明になりやすく、長文やページ全体のテキスト描画も依然として苦手な分野です。 テキストレイアウトは改善されたものの、仕上がりを完成させる上では一文字ずつの目視確認(校正)が依然として欠かせません。
シーンが変わっても、商品やキャラクターの同一性を維持
映画の絵コンテ、絵本制作、ブランドマーケティングにおいて、キャラクターの一貫性や商品の特徴を維持することは極めて重要なハードルです。Nano Banana 2.1では、複数画像の参照・融合能力がさらに明確に仕様化されました:
- 1回のリクエストで最大14枚の参照画像入力に対応:クリエイターは1つのプロンプト内に複数の素材画像を入力し、モデルに統合的に理解させることができます。
- 参照対象の一致性の適用範囲:複数画像の融合シーンにおいて、公式API仕様では最大4人のキャラクターの顔と特徴の一貫性、および最大10個のオブジェクトのディテール再現をサポートすると明記されています。これはサポートされる参照の範囲を示したものであり、範囲内であってもキャラクターの特徴に変化が生じる可能性はあります。

商品のビジュアル展開において、クリエイターは白バックの商品画像を1枚用意するだけで、プロンプトを使って商品を多様なコマーシャルフォトスタジオ、大自然の風景、あるいはアート展示台へと配置転換でき、同時に金具やシルエットといった商品の核となる特徴をより確実に維持できます。
単一商品のシーン移行にとどまらず、公式ギャラリーでは複数人・複数参照画像を用いた合成事例も紹介されています:

単に「カラフルな建物の前で複数のモデルが集合写真を撮る」と指示するのと比べ、複数アングルの人物や衣装の参照画像を与えることで、より具体的な容姿、配色、スタイリングの要件が明確になり、モデルはそれらの素材をひとつのシーンにまとめ上げます。
画像に示された複数組の参照と大人数の集合写真は、素材の融合を示したものです。APIドキュメントに記載された参照の適用範囲はあくまで「最大4人のキャラクター、10個のオブジェクト」であり、画面内により多くの人物が登場したとしても、全員の同一性が安定して維持されることを意味するわけではありません。
被写体を囲んで、背景の変更をより明確に
より精密な画像修正を必要とするクリエイター向けに、Nano Banana 2.1では落書きやマスク指定(Mask/Ink-based Editing)に基づく環境の再描画機能が提供されています。クリエイターは元画像上で選択範囲を指定するか、落書きのように被写体をなぞって囲み、「被写体の輪郭と位置を保持し、背景を変更する」といったプロンプトを入力するだけで、スタイルの再構築が可能です。

生成結果を修正する際には、以下の2つの既知の挙動にも留意する必要があります:
- ポーズの固定化(ポーズロック):人物や動きのあるオブジェクトを編集する際、モデルが入力画像の骨格構造を過度に頑なに維持してしまい、「顔の向きを変える」「手のジェスチャーを変える」と指示しても元のポーズからうまく抜け出せないことがあります。
- マークの残留:マスクや落書きによる編集が指示の一部しか実行されなかったり、画像上に描いたマーキングがそのまま出力結果に残ってしまったりすることがあります。
連続編集とさらなる入力の活用
単発の画像生成にとどまらず、現在の公式APIドキュメントでは画像を反復的に改善していく推奨方法としてマルチターンの対話形式を挙げています。クリエイターは既存の生成結果をもとに継続して修正を加えることができます:


公式から提供されている図解サンプルでは、ユーザーがまず英語版の光合成インフォグラフィックを生成し、続くリクエストで previous_interaction_id(前回のインタラクション識別子)を引き継ぎながら、画像内の文字のみをスペイン語に変更するよう指示しています。このような対話型編集では、画像の主要な構図や視覚的なフレームワークを継承できますが、太陽の外見など一部のディテールにはわずかな再描画が生じ、画像全体のピクセルが完全に不変のまま保たれるわけではありません。また公式は、テキストを含む図解を生成する場合、まず対話の中でテキスト内容を確定させてから、それを画像にレンダリングするようモデルに指示することを推奨しています。公式が推奨する高精度レンダリング言語には、簡体字中国語(zh-CN)、英語、スペイン語などが含まれます。マルチターン対話自体は本シリーズの既存の機能ですが、2.1では連続編集の一貫性がさらに改善されました。
通常のテキストや画像に加え、モデルはさらに多彩なマルチモーダル入力や外部入力にも対応しています:
- Google検索グラウンディング(Grounding):モデルはGoogleのウェブ検索および画像検索との連携をサポートしています。ウェブ検索は天気予報や最近のトレンドといった事実ベースの図表に対して最新の外部事実による裏付けを提供し、画像検索はウェブ上の画像を取り込んで構図やスタイルの視覚的な参考として活用できます。これらは個別に有効化することも、併せて呼び出すことも可能です。なお、現時点の画像検索では、画像生成の参考としてウェブ上の実在人物の写真を検索することは明確にサポートされていない点に注意が必要です。
- 動画から画像への生成(Video-to-Image):クリエイターは公開されているYouTubeリンクを直接渡すか、ローカルの動画ファイルをアップロードできます。モデルは動画フレーム内の視覚的テーマや主要なイベントを分析し、テキストプロンプトと組み合わせて動画のサムネイル、プロモーションポスター、あるいはストーリー要約画像を生成します。ここでの出力は、動画内容を参照して生成された静止画です。旧版のNano Banana 2および2 Liteも動画入力に対応しています。
Thinking(思考)を有効にすると、どのタスクで改善が顕著になるか
Nano Banana 2.1は設定可能な思考レベル(Thinking Levels:minimal、medium、highを含む)に対応しており、これは生成品質と推論レイテンシのバランスをとるためのトレードオフ機構で、デフォルト設定はmediumです。複雑な構図や複数の被写体を含むプロンプトに対し、モデルは思考プロセスの中で構図の試行や論理推論を行うため最大2枚の中間画像を生成し、最後の1枚が最終成果物として出力されます。留意すべき点として、現在のGemini APIにおいて思考プロセスはデフォルトで有効化されており、無効化(オフ)にすることはできず、呼び出し時には自動的に思考トークンとして計上されます。公式モデルカードに記載されている「No Thinking」はあくまでベンチマーク評価用の測定条件であり、現在のAPIでは思考レベルの調整は可能であるものの、オフにするスイッチは用意されていません。
Googleの公式モデルカードで公表された並列人間評価(SxS human eval)の結果によると、各タスクにおける人間の選好Eloレーティングスコアは以下の通りです:
| 評価項目(SxS 人間選好 Elo) | 2.1 Thinking | 2.1 No Thinking | 2 Thinking | Pro |
|---|---|---|---|---|
| 全体的な選好 | 1050 ± 14 | 1015 ± 13 | 990 ± 7 | 935 ± 8 |
| インフォグラフィックデザイン | 1048 ± 17 | 1001 ± 17 | 961 ± 12 | 912 ± 12 |
| 複数キャラクター | 1106 ± 14 | 1068 ± 14 | 978 ± 10 | 1011 ± 10 |
| マスク/落書き | 1049 ± 15 | 1042 ± 16 | 965 ± 12 | 927 ± 12 |
| 商品の一貫性 | 1024 ± 18 | 981 ± 18 | 955 ± 22 | 965 ± 14 |
| スタイル変換 | 1062 ± 20 | 1036 ± 17 | 991 ± 12 | 990 ± 12 |
| 複数参照による編集 | 1066 ± 22 | 1041 ± 20 | 988 ± 13 | 989 ± 12 |
事実性の評価軸において、公式は片側自動評価(Single sided AutoRater)を採用しています。これは人間の選好Eloとは評価基準が全く異なるため、以下のように個別に記載します:
| 評価項目(片側 AutoRater 事実性スコア) | 2.1 Thinking | 2.1 No Thinking | 2 Thinking | Pro |
|---|---|---|---|---|
| インフォグラフィックの事実性 | 0.521 | 0.328 | 0.179 | 0.265 |
実際の活用シーンから見ると、「見栄えの良い画像を1枚だけ生成する」ことと、「同一の被写体を変更する/複数人を合成する」ことの間には明確なタスクの違いが存在します:
- 「見栄えの良い画像を1枚だけ生成する」:1回のテキストからの画像生成(Text-to-Image)や全体的な選好に対応し、モデルはプロンプトに従って美しく構図の整った単一の画面を自由に生成すればよく、厳密に比較される連続的な参照対象が存在しないため、許容範囲が広くなります;
- 「同一の被写体を変更する/複数人を合成する」:複数キャラクターや商品の一貫性といったタスクに対応し、複数画像の入力や部分的な再描画において、特定の被写体の輪郭、質感、特徴を維持することが求められます。さらに同一の画面内で異なる複数の実体の個別の容姿を同時に保つ必要があり、明らかな崩れや異なるキャラクターの特徴の混同が生じると、一貫性が損なわれます。
Googleによる今回の一連の評価において、2.1で思考を有効にした場合の各スコアは、旧版の2およびProをいずれも上回っています。また思考を無効にした測定条件の2.1であっても、マスク/落書きと複数キャラクターの2項目ではそれらを上回っています。クリエイターはこの結果を参考に、複数人を扱うタスクや狙いを定めた編集タスクを優先的に試すことができます。なお、Eloは評価における相対的な選好スコアであり、スコア差を性能向上のパーセンテージに換算することはできません。同様にAutoRaterの0.521という数値も、すべてのインフォグラフィックが52.1%の正解率を持つことを意味するものではありません。
導入時に確認すべき新しいモデル名とプラットフォームの制限
開発者向けAPIに加え、Nano Banana 2.1はGeminiアプリ、Google AI Studio、Google Flow、SearchのAIモード、Google広告など、日常的な利用経路にも幅広く展開されています。
モデル体系全体の中で、クリエイターや開発者はタスクの要件に応じて適切なモデルを選択できます:
- Nano Banana 2.1:日常的な画像生成や継続的な画像編集に適しており、応答速度とコスト効率を両立させながら、視覚的品質、テキストレンダリング、複数参照による編集をバランスよくカバー;
- Nano Banana 2 Lite:圧倒的なスループットと極限の低コストを追求しており、速度や費用に極めてシビアな大規模バッチ処理タスクに適しているものの、複数参照画像の融合やマルチターン連続編集向けの個別最適化は施されていません;
- Nano Banana Pro:世界の一般常識、厳格なブランド一貫性、精密なクリエイティブ制御が極めて高度に要求される最難関のビジュアルタスク向け。
Gemini APIやGoogle Cloudプラットフォーム経由で直接呼び出しを行う場合、以下のエンジニアリング上の制限事項とパラメータ設定が極めて重要になります:
- コンテキストウィンドウの差異:
- 公式モデルカードでは、Nano Banana 2.1に対して最大100万(1M)トークンのマルチモーダル処理能力が記載されています。
- 現在のGemini APIおよびGoogle Cloudのエンドポイントで開放されている入力上限は131,072トークン(約128K)、最大出力は32,768トークンです。導入時は利用するインターフェースの上限に合わせて素材を構成する必要があり、モデルカードの1Mを現在のAPIの入力上限と誤認しないよう注意してください。
- パラメータサポートの制限(Google Cloud公式ドキュメント基準):
- Google Cloudの公式ドキュメント基準によると、Nano Banana 2.1は
seed(ランダムシード)、temperature(サンプリング温度)、topP、topK、およびlogprobsパラメータをサポートしていません。同プラットフォームのリクエストにこれらのパラメータを含めると、APIは即座にエラーを返します。
- Google Cloudの公式ドキュメント基準によると、Nano Banana 2.1は
- 旧版モデルの提供終了(廃止)予告:
- 公式インターフェースにおいて廃止のアナウンスが正式に告知されています:旧版の
gemini-3.1-flash-image(すなわちNano Banana 2)は今月末をもって提供終了となります。この旧モデルを使用しているパイプラインや自動化プロジェクトは、速やかにgemini-nano-banana-2.1への移行を進める必要があります。
- 公式インターフェースにおいて廃止のアナウンスが正式に告知されています:旧版の