a16z 图表解读:预测市场有偏见吗?AI 的钱和岗位正在流向哪里
从选举合约、软件经营分数,到硬件盈利预期与客服招聘,看四组图表里哪些变化值得关注。
a16z 的这期图表周报讨论了四个议题:选举预测、软件估值、硬件建设与客服就业。其中两个反差尤其值得留意:软件经营分数提高,估值倍数却下降;其他办公室岗位仍在增长,客服业却开始减少招聘。
带着政治立场下注,会不会把价格推偏?
预测市场的参与者并不是选民的随机抽样。研究引用的调查显示,他们往往更年轻、男性更多、受教育程度更高。若有人因为喜欢某位候选人,就愿意给他的合约出更高价,价格确实可能被推偏。问题在于,其他交易者会不会把它纠正回来。
在巴西大选首轮投票中,弗拉维奥·博索纳罗获得约 47.0% 的选票,领先于卢拉的 45.2%,但因两人得票均未过半而双双进入第二轮决选。最终胜选者仍有待决选产生,合约的最终赢家尚未揭晓。在 Kalshi 预测市场上,博索纳罗胜选合约在选前约三周成为更被看好的选项,并在首轮领先确认后继续上升。

选举信息也会影响股票市场的预期。a16z 对照了追踪巴西股票的 EWZ 基金,称它在首轮结果明朗后上涨约 15%,而在此前合约价格发生转向时,基金也已开始上行。这个例子说明政治判断还会进入资产定价;但两类价格的先后走势,本身不足以证明谁先获得了信息。
预测市场通常由二元合约构成:若指定事件发生则按 1 美元结算,否则按 0 美元结算。在交易中,一份价格为 60 美分的合约,常被通俗解读为该事件约有 60% 的发生概率。但这种价格并不等同于选民得票率,更不是已确定的事实,市场流动性、交易费用与资金占用等交易条件都会影响概率解读。
研究者检验市场是否存在偏见,是在大量历史合约中考察长期结算偏差:假设市场系统性低估了某一特定特征的候选人,那么持续买入该类合约,真实结算值减去买入价格就会留下正向的平均定价残差(以百分点计的到期收益)。这是许多次结果积累出来的平均差异;其中一次仍可能输掉,也不能据此承诺无风险收益。
达特茅斯学院埃里克·齐茨维茨(Eric Zitzewitz)在 NBER 发布的一项初步工作论文,汇总了跨越逾百年的数据,涵盖 IEM、Intrade、PredictIt、Betfair 与 Kalshi 等平台的预测市场数据。全市场样本包含 9,642 条合约观测与 216 个选举日(该工作论文尚未经同行评审,且样本尚未纳入 Polymarket 数据;观测大部分来自近年商业市场,按国家看美国约占 60%、英国 16%、澳大利亚 13%)。
在全样本回归中,自变量按左翼(-1)、中间派(0)和右翼(+1)赋值,因变量为合约结算值减去买入价格的百分点残差(反映价格与结果的偏差,而非本金投资收益率)。实证结果显示:
-
全市场党派倾向系数接近于零:右倾指标的回归系数为 +0.03 个百分点,标准误为 2.66。95% 置信区间为 [-5.18, +5.24],虽然横跨零轴且未见明显偏向,但该区间依然能容纳数个百分点的小幅偏差,不能推断为绝对无偏的充分证明。由于同一选举日内的多项合约往往相关,模型按选举日进行聚类处理(若不按选举日聚类,标准误会被低估约 2.75 倍)。
-
非美市场点估计为负但未达统计显著:在非美国选举样本中,回归点估计为 -1.42(标准误 1.30,95% 置信区间 [-3.97, +1.13]),同样跨越零轴。
-
人口学偏好整体未见显著证据:在仅覆盖美国明确命名候选人的合约样本中,女性(-0.95)、非白人(-0.85)及年龄每增加 10 岁(+1.17)的到期回报差异均不具备统计显著性。(在多项 Logit 控制冷门偏差的模型中,仅女性一项在 18 个回归系数中出现 1 次显著,作者提示不宜过度解读)
接近零,还是确实为零?
点是估计值,横线是 95% 置信区间。选中一行看它能回答什么。
全市场估计值 +0.03 很接近零,但区间为 −5.18 到 +5.24。没有检出显著党派偏差,仍不能排除更小的偏差。
(来源:Zitzewitz,NBER w35846 表 3–6。不同人群行和民调行来自不同子样本;民调行系数为正,对应偏左倾的结果相对定价较高。区间跨零不等于已证明没有偏差。)市场并非不存在任何定价扭曲。多数历史预测市场存在“冷门高估、热门低估”(Favorite-Longshot Bias)的现象,即交易者往往给低概率事件支付过高价格(这主要基于历史商业市场数据,现有平台中 Kalshi 样本尚小,暂无法确认是否存在该偏差)。
此外,该论文在 PredictIt 平台约 6.2 万条按日记录的观测中(同一合约在其存续期内每天记录一次,合约通常持续约 7 天),检测到偏左翼的短期民调均值结果平均被高估约 1.4 个百分点(p < 0.01)。这里检验的是短期民调均值走势,与长期大选“谁最终当选”是分别检验的两种不同合约;研究并未识别偏差具体由哪种交易动机造成。由于选举样本量有限、统计精度不足,若选举市场同样存在类似 1 到 2 个百分点的小幅偏差,现有数据也无法有效检出,因此不能断言真实选举已被套利彻底抹平。理论机制与过往文献表明,当价格明显偏离时,信息交易者有动力进行逆向交易以抑制偏见,但这属于市场制衡机制,而非抹平所有微小偏差的确定性保证。
总分提高了,软件公司为何没变得更贵?
过去软件投资领域常使用“40 法则”(Rule of 40 / Rule of X)作为评估业务健康度的参考指标。它的初衷是建立一个统一指标,用来横向比较处于不同生命周期的企业:早期企业通常处于高增长、高亏损阶段,而成熟企业则预期增速放缓但利润率更高。指标将“收入同比增速”与“净利润率”直接相加(本组图表采用包含股权激励费用 SBC 的净利润率),认为总和达到 40% 即为良好表现。例如增速 100% 伴随利润率 -60%,或者增速 10% 伴随利润率 30%,两者相加得分均为 40;相反,若增速达到 150% 但利润率为 -150%,得分只有 0,增长更快也不代表总分更好。这一指标通常被用作快速筛选资产的粗略参考,而非证明不同业务享有相同估值的定价定理。
然而,近年来公开市场软件公司却出现了指标与估值的明显背离:软件公司的 Rule of X 中位数持续走高,估值倍数却震荡下行。

根据公开市场数据,近三年来美股软件公司的 Rule of X 中位数从约 17% 提升至 23% 左右;但企业价值相对年化收入的倍数(EV/年化收入)却从 5–6 倍降至 3.5 倍左右。企业价值(EV)反映了市场整体收购一家公司所需支付的总价值(包含股权与净负债),收入倍数表示市场愿意为每一元年化收入支付多少企业价值。如果计算两者的八个季度滚动相关系数,曲线从此前接近 +0.95 的强正相关快速下滑至负值区间。
为什么指标改善没有带来估值扩张?核心原因在于 40 法则在求和时掩盖了不同业务路径的本质差异:
- 增长与利润在估值中的不同分量:40 法则将增速与利润率直接相加,本质上是一种粗略衡量经营表现的经验权衡,而非经过严谨定价推导的估值模型。它的主要局限在于直接用来预测估值倍数时容易失真:利润与控制亏损依然至关重要,企业不能盲目追求无序扩张;但二级市场对收入扩张空间通常给予更高的溢价。a16z 的解释指出,近年来软件公司 Rule of X 的上升主要由利润率改善推动,收入增速则相对放缓。即便总分被利润率推高,缺乏高增长的支撑,估值倍数依然受到压制。这是当前公开市场样本中观察到的分化现象,并不意味着提高经营分数本身会导致估值下降。
- 算式拆解下的业务差异:以两家同为 40 分的假设公司为例,公司 A 收入增速 45%、净利润率 -5%(45 + (-5) = 40);公司 B 收入增速 10%、净利润率 30%(10 + 30 = 40)。两家公司在算式上得分相同,但公司 A 展现的是规模快速扩张潜力,公司 B 展现的则是稳健的利润生成能力。估值倍数取决于市场对其成长空间与持续盈利能力的综合评估,单靠一个经营总分无法直接决定公司的市场价值。

在按 Rule of X 分组的四个分桶(0–<20、20–<30、30–<40、40+)中,每个分桶横轴均为未来 12 个月收入增速,纵轴均为 EV/未来收入倍数(注意四张分图的坐标轴尺度各不相同)。图中网络安全与可观测性的一些公司获得了较高倍数,但同样高分也有低倍数公司。在 20 到 40 的区间内,多数软件公司的估值倍数集中在 5–10 倍;而在 40+ 的高分组中,组内未来收入增速对未来收入倍数的二次拟合 R² 仅为 0.02。这表明即使在得分最高的分组内部,收入增速本身与估值倍数的这条二次拟合关系也很弱,不能据此推导出一套机械的定价公式。
同样 40 分,两种经营组合
下面是教学假设。调节左边,右边保留一家公司作参照;只计算总分,不预测估值。
45% + (-5%) = 40%
与公司 B 同为 40 分。A 的收入增速更高,净利润率更低;单看总分看不出这种组合差异。
10% + 30% = 40%
两家公司达标的方式不同。总分把收入扩张与盈利能力加在一起,不能据此判断它们应有相同价格。
硬件建设还在扩张,软件预期有没有跟上?
在当前 AI 商业化讨论中,“原子”(Atoms)常被用来代指芯片、服务器、电力与网络等硬件与实体基础设施,“比特”(Bits)则指构建其上的软件与应用服务。
标普 500 的盈利预期修订广度近期从高位回落,仍处于正值区间。它反映预期改善扩散得有多广,不是利润实际增长了多少。结合行业明细看,较大的上调集中在硬件与能源。
FactSet 汇总的行业盈利预测修正显示,分析师对实体硬件与能源的预期调整显著更为积极:
- 硬件与能源预期调整幅度靠前:在当季盈利预测修正中,上调幅度较高的行业包括能源(+19.3%)、半导体(+9.8%)、硬件设备(+7.6%)与金融(+1.9%),而软件与服务仅有微幅上调(+0.7%)。对于次年的盈利展望,半导体上调 27.3%,能源上调 13.3%,硬件设备上调 9.8%,而软件与服务预期上调仅为 0.4%。
这些百分比反映的是分析师对企业利润预期的修正幅度,而非资本流入的实际金额或企业利润的绝对同比增速。例如能源行业上调 19.3%,是指分析师调高了对该板块的利润预测约两成,且不能把能源等传统板块的盈利上调全都归因于 AI 驱动。软件行业的修订幅度较小,仅代表分析师对其预期调整较为平缓,并不意味着软件企业本身停止增长。
实体制造的订单也在扩张。ISM 数据中,报告积压订单增加的行业占比,按三个月平均计算已接近 60%。这意味着订单积压不只发生在少数行业。不过它统计一般工业订单,没有把 AI 项目单独分出来,不能把所有积压都归到 AI 建设。
凯雷投资集团(Carlyle)披露的被投企业数据显示出不同环节的扩张节奏:其生态内 AI 硬件出货指数自基期以来呈现陡峭上升,而广义 IT 服务支出的同比增速则在 30% 附近盘整。

这里有个容易读错的地方:左图是硬件出货的指数水平,右图是 IT 服务支出的同比增速。这组关于实际直接支出与出货的微观证据来自凯雷的被投企业样本,并非全球 IT 支出的普查。右图中该样本的 IT 服务支出增速走平在约 30% 附近,意味着支出规模依然在较快增长,只是扩张速度没有像硬件那样进一步加速,不能简单解读为采购规模停滞。
因此,这些图表重点展现的是产业链不同环节的节奏差异:凯雷样本中的 AI 硬件出货快速增加,而该样本中的 IT 服务支出保持平稳增长但未见进一步加速。同时需要注意,分析师此前曾多次上调盈利预测,市场共识并非一成不变,它会随着企业后续的实际经营表现而动态调整。硬件与软件之间的预期分化只是当前阶段的预期切片,并非已注定的终局。
谁的盈利预期被调高?
同屏比较分析师修订幅度。百分比表示“修改了多少”,不表示企业利润实际增长了多少。
本年预期在第三季度的修订:能源 +19.3%,半导体 +9.8%,硬件 +7.6%,软件与服务 +0.7%。金融也上调了 1.9%,并非只有这三类上调。
(来源:a16z 所载 FactSet 图。次年一列对应半导体 +27.3%、能源 +13.3%、硬件 +9.8%、软件 +0.4%。两种观察口径分别展示,不相减计算“加速”。其他行业也有小幅上调。)客服岗位减少先是少招人,初级白领入口正在缩小
在技术变革对就业影响的讨论中,呼叫中心(Call Centers)往往被视作最直接受到生成式 AI 冲击的领域。呼叫中心的工作主要包括解答常见业务疑问、处理标准退换货、依脚本进行电话确认等高频、重复的案头任务。由于这些工作高度依赖标准化文本与既定流程,因而成为大型语言模型与自动化问答代理适合辅助或替代部分任务的场景。
职场大数据机构 Revelio Labs 追踪的数据显示,在经历了长达十余年的平稳增长后,全球呼叫中心就业岗位同比增速跌破零轴,最新降至约 -4% 左右。

从地域演变来看,收缩趋势最早出现在高收入国家,随后逐步传导至承担大量离岸外包的中等收入经济体。18 国样本的分组图显示,高收入、中高收入和中低收入三组,在末端都对合计就业增长作出了负贡献。它说明收缩已经扩散到成本更低的承接地,但分组贡献是百分点,并不是各组自身的就业增速;个别国家仍可能增长。
为了检验这是否仅是广义白领行业整体疲软的表现,机构对比了 12 个中等收入国家中呼叫中心与本国其他白领服务业的走势(以 ChatGPT 公开发布时为基准点 100)。在菲律宾(呼叫中心 90 vs 其他白领 112)、墨西哥(94 vs 112)与巴西(98 vs 114),呼叫中心规模缩水与其他白领岗位扩张形成了明显分化。中国呼叫中心指数(约 107)与本国白领走势相近,但并非唯一保持增长的国家;例如印度呼叫中心指数依然高于 100(约 106),尼日利亚也仍在增长。这种同一国家内部的行业走势分叉,提升了 AI 替代假说的可信度,但仍不能完全排除呼叫中心特有的行业景气或周期调整因素。

更深入的机制数据显示,呼叫中心规模缩水并非源于离职潮激增,而是由于招聘大幅放缓。在追踪的 12 个中等收入国家中,呼叫中心每百名员工的进入率从 25.1 降至 17.2,退出率也从 22.3 降至 18.5。由于进入率下降幅度更快且跌破退出率,新增招聘不足以弥补离开的人员,进而导致岗位总量净缩水,而无需发生离职率暴增。
招聘减少还影响尚未入行的求职者。Revelio 的报告指出,呼叫中心曾是中低收入国家进入正式办公室工作的一条较可靠的路径;它援引的国际劳工组织研究也提醒,这类入门岗位对年轻人和女性尤其重要。现在入口正在缩小,可能让新求职者更难获得第一份办公室工作。办公室经济和高薪岗位仍在增长,却不保证这些新人能直接进入那些岗位。
对于已经离开岗位的员工,微观转岗追踪进一步揭示了流向的分化:在观察到的转岗样本中,49.7% 转向其他客服、销售或行政与人力等平级岗位,仅有 10.8% 进入薪酬更高、处于扩张的技术支持、客户成功或软件与数据岗位。这表明客服人员跨入高薪增长型岗位的门槛依然较高,不少人的下一份工作仍在原有岗位类型附近(该微观转岗样本覆盖 12 个中等收入国家且不含美国,不能据此推断其余未分类人员均处于失业状态)。
在宏观层面,美国整体失业率即使保持平稳,也不能直接证明离开客服岗位的人都找到了待遇相当的职位;而上述转岗数据更揭示了非美市场的现实摩擦。AI 很可能参与了这一轮收缩,但具体替代份额无法从现有统计中直接剥离。呼叫中心增速放缓略早于 ChatGPT 发布,期间也伴随全球加息与企业降本周期;机构并未逐家观测哪些企业用 AI 助手替代了人工。同国其他白领岗位的稳健反衬出客服的特殊性,呼叫中心自身的需求变化仍可能影响这条走势。
分清不同数据正在回答什么问题
这几组图表分别展示了价格、经营表现、盈利预期与招聘变化。市场可以重新估计一场选举,也可以重新给软件公司定价;企业是否真正增加了收入,以及求职者能否找到下一份工作,还要看对应的数据。
理解这些现象的关键,在于分清不同数字到底在回答什么问题:合约价格回答的是事件发生的概率预期,而非最终确定的事实;盈利修订与估值倍数回答的是分析师预期的调整方向与市场对增长的定价,而非企业的终局;而岗位的流入流出与招聘数据,回答的才是真实世界中人们如何进入或离开工作。把这些对象和层级区分清楚,才能准确评估变化正在哪里发生。
a16z 图表解读:预测市场有偏见吗?AI 的钱和岗位正在流向哪里
预测市场的参与者从来不是全体选民的随机抽样。调查显示,他们往往更年轻、男性占比更高、受教育程度更高。如果大批买家出于对特定候选人的偏爱而不计代价出高价,合约价格会不会被整体带偏?
预测市场通常采用二元合约:胜选按 1 美元结算,败选归零。60 美分的买价常被解读为约 60% 的胜率,但还受流动性、费用与资金占用影响;它不是选民得票率,更不是确定结果。达特茅斯学院埃里克·齐茨维茨在 NBER 汇总了逾百年历史、跨越五大交易平台的 9,642 条选举合约观测,检验“长期结算残差”(真实结算结果减去买入价格)是否存在系统性偏向。
未检出显著偏差,仍不能证明绝对无偏
如果偏好把价格推得过高,信息交易者就有动力逆向交易以抑制偏离。这是理论机制与过往文献支持的制衡动力,不能保证价格贴合真实概率,也不意味着单次交易没有风险。
选举样本中,右倾指标的回归系数为 +0.03 个百分点。95% 置信区间为 [-5.18, +5.24]:跨越零,却仍能容纳数个百分点的偏差。
边界:这是尚未经同行评审的工作论文,尚未纳入 Polymarket;样本约 60% 来自美国、16% 英国、13% 澳大利亚。PredictIt 另有约 6.2 万条按日观测,短期民调偏左结果平均被高估约 1.4 个百分点。民调走势与最终当选是不同合约,不能合并为同一结论。
总分提高了,软件公司为何没变得更贵?
“40 法则”将收入同比增速 + 净利润率相加,达到 40% 被视为良好表现。本组采用包含股权激励费用的净利润率。它原本用于比较不同生命周期公司的经营健康度:早期高增长、高亏损;成熟期增速低、利润率高。近三年软件公司的中位数由约 17% 升至 23%,但企业价值 / 年化收入的估值倍数由 5–6 倍降至约 3.5 倍。
相同总分包含不同的增长与利润组合,不能直接推出相同估值。a16z 认为,近期总分改善主要由利润率推动,收入增长则放缓。利润仍然重要,但经营总分不是定价公式;分数提高本身也不导致估值下降。
不能机械定价:在 40+ 分组中,未来收入增速与估值倍数的二次拟合 R² 仅为 0.02,关系很弱。单靠增速或经营总分都不能决定估值。
硬件建设还在扩张,软件预期有没有跟上?
AI 建设涉及芯片、服务器与电力等实体基础设施。FactSet 数据显示,分析师当季盈利预测的上调幅度在硬件与能源更大,软件与服务调整较小。
这些是盈利预测的修正幅度,不是企业利润实际增长率,也不是资金流入金额。能源上调不能全部归因于 AI;软件预期修订较少,也不等于软件企业停止增长。
另一组实际业务证据:凯雷被投企业样本中,AI 硬件出货指数快速上升,IT 服务支出同比增速则保持约 30%。一个是指数水平,一个是增速;30% 仍是较快增长,只是没有进一步加速。该样本并非全球 IT 普查,分析师预期也会继续变化。
客服岗位减少先是少招人,初级白领入口正在收窄
Revelio 追踪的全球呼叫中心就业同比增速降至约 −4%。菲律宾、墨西哥与巴西的客服业收缩,其他办公室岗位却在增长。进一步观察 12 个中等收入国家发现,变化首先出现在少招人。
进入率和退出率都下降,进入率下降更快且低于退出率,新增人数不足以补上离开者,岗位便会净缩水;无需发生离职潮激增。
入口收窄影响谁?这些入门岗位是年轻人和女性进入正式办公室工作的重要路径。少招人可能让新人更难获得第一份工作;其他高薪岗位增长,不保证他们能直接进入。观察到的转岗样本中,49.7% 转向客服、销售或行政等平级岗位,10.8% 进入技术支持、客户成功或软件数据等高薪岗位。此样本不含美国,也不能把其余人员都视为失业。
AI 因果仍有边界:现有数据没有剥离 AI 的具体替代份额;客服自身的需求、加息与降本周期也可能影响走势。行业分化支持进一步研究,不能据此认定全部收缩由 AI 造成。
分清图表里变化的对象
理解宏观与科技图表的反差,关键在于厘清数据所处的信息层级,不把局部的分化武断归结为终局结论:
价格:概率预期,不是选民得票率或确定结果。
经营分数与估值:增长和利润的组合,不是通用定价公式。
盈利修订:分析师改变预测,不是已经实现的利润。
岗位流动:人员进入与离开,不单独证明技术替代的因果。
This Week in Charts: Are Prediction Markets Politically Biased?
Rule of 40 Ain’t What It Used To Be; Atoms keep winning, but what about everyone else?; AI Has Come For Call Centers, After All?
We’re excited to announce that a16z is leading an investment in TypeSafe AI, the creators of Jev. Read more about why we invested in our blog post and hear from the team in our a16z Show episode.

Earlier this week, Flávio Bolsonaro secured a surprise first-round victory in the Brazilian presidential election. Or maybe it wasn’t a surprise. Charts knows next to nothing about Brazilian politics, so we really couldn’t say.
If you take a gander at the prediction markets, however, it appears as though Bolsonaro’s win was at least somewhat surprising, but not too surprising:
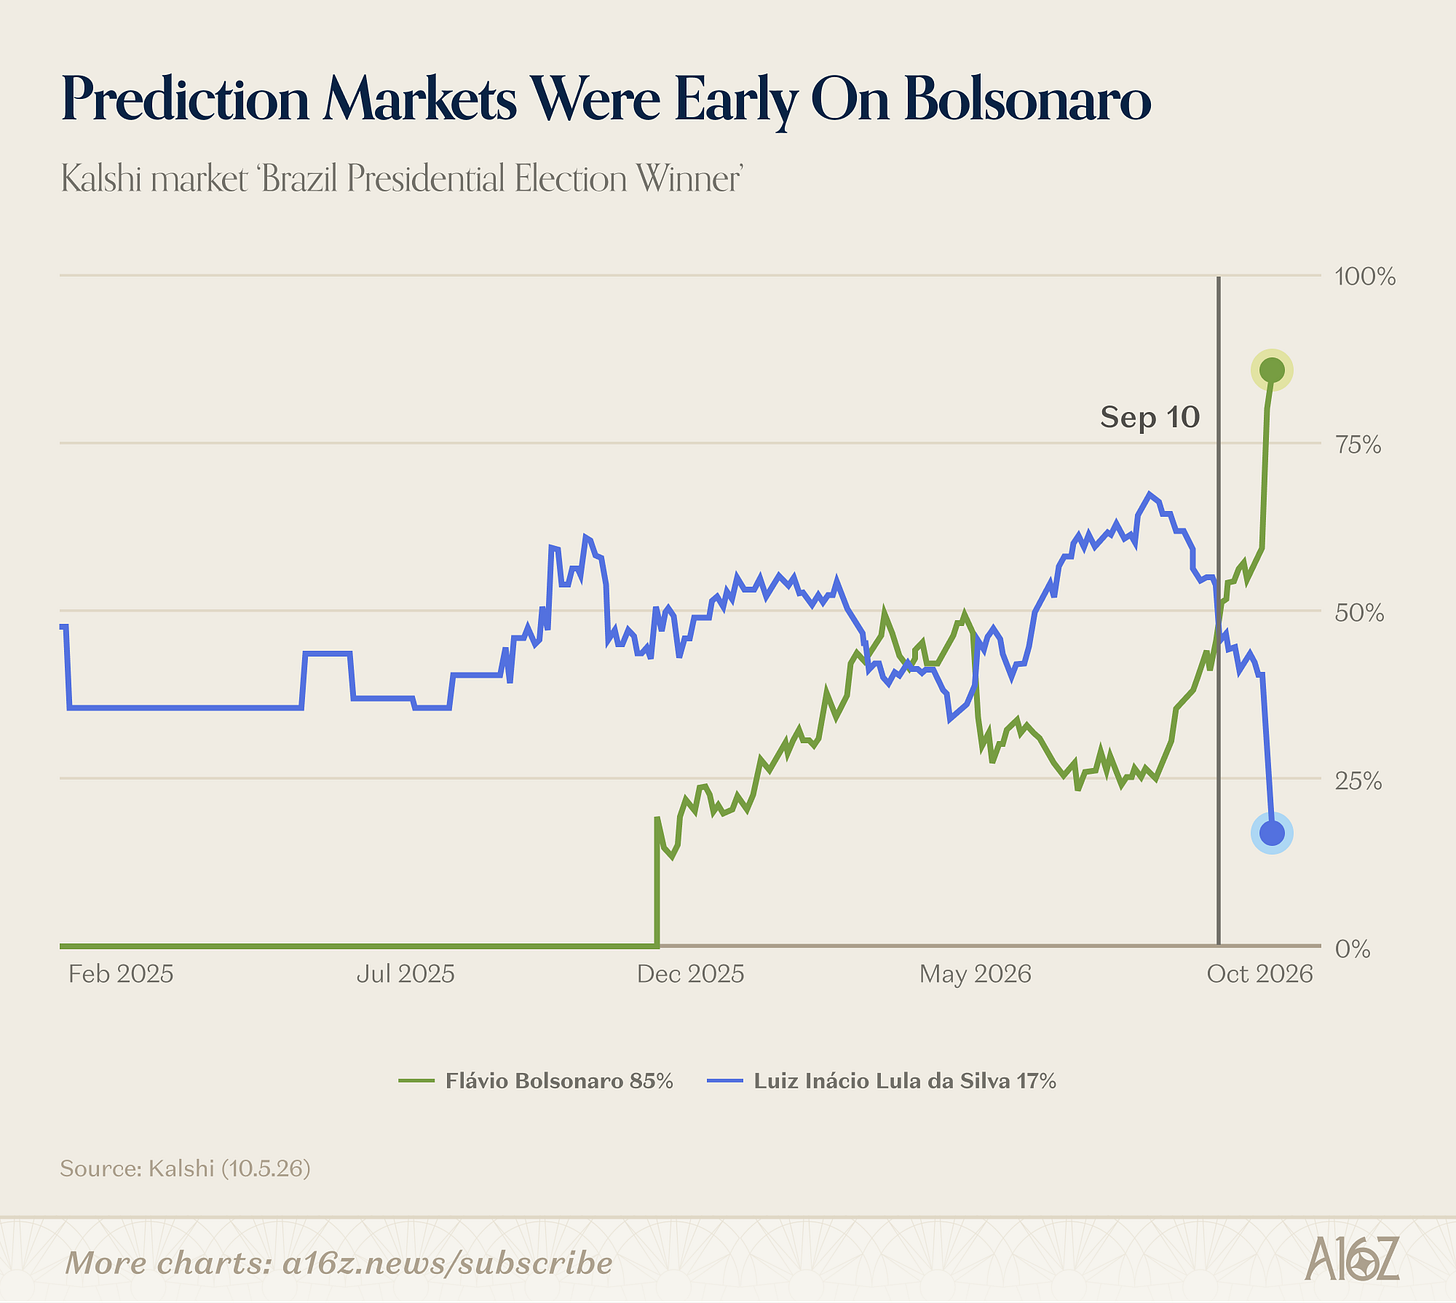
After pacing as a long shot for most of the year, odds began to turn in Bolsonaro’s favor in August, and by the second week of September, he was already the favorite. Unsurprisingly, Bolsonaro’s odds for winning the presidency have since skyrocketed, after the recent first-round win.
Whatever the surprise, prediction markets were early and right on this one by ~3 weeks. The outcome of the election is apparently consequential for financial markets too, judging by MSCI’s Brazil ETF, which jumped ~15% after the news of Bolsonaro’s first-round win. To be fair, the ETF also started climbing back in August (when Bolsonaro’s Kalshi odds began to turn), but not nearly as steeply or as uniformly. In other words, it seems fair to conclude that prediction markets had this one first.
All of this was a somewhat longwinded segue to some recent research that purports to show that prediction markets are actually pretty good at elections, or at least, they don’t demonstrate much partisan bias.
Prof. Zitzewitz published some preliminary findings in an NBER working paper that aggregated over 100 years’ worth of prediction markets (albeit with most of the sample coming recently) looking for evidence of over-pricing along various dimensions, including demographics and political affiliation. The premise of the study is that any bias would show up as outsized returns (either positive or negative) for whichever attribute(s) prediction markets systematically over- or underrated. That makes sense: if, e.g., prediction markets consistently underrate female candidates, then taking the “over” on female candidates would be a winning strategy (reflected by a positive coefficient).
As it turns out, the evidence of bias is pretty much non-existent:
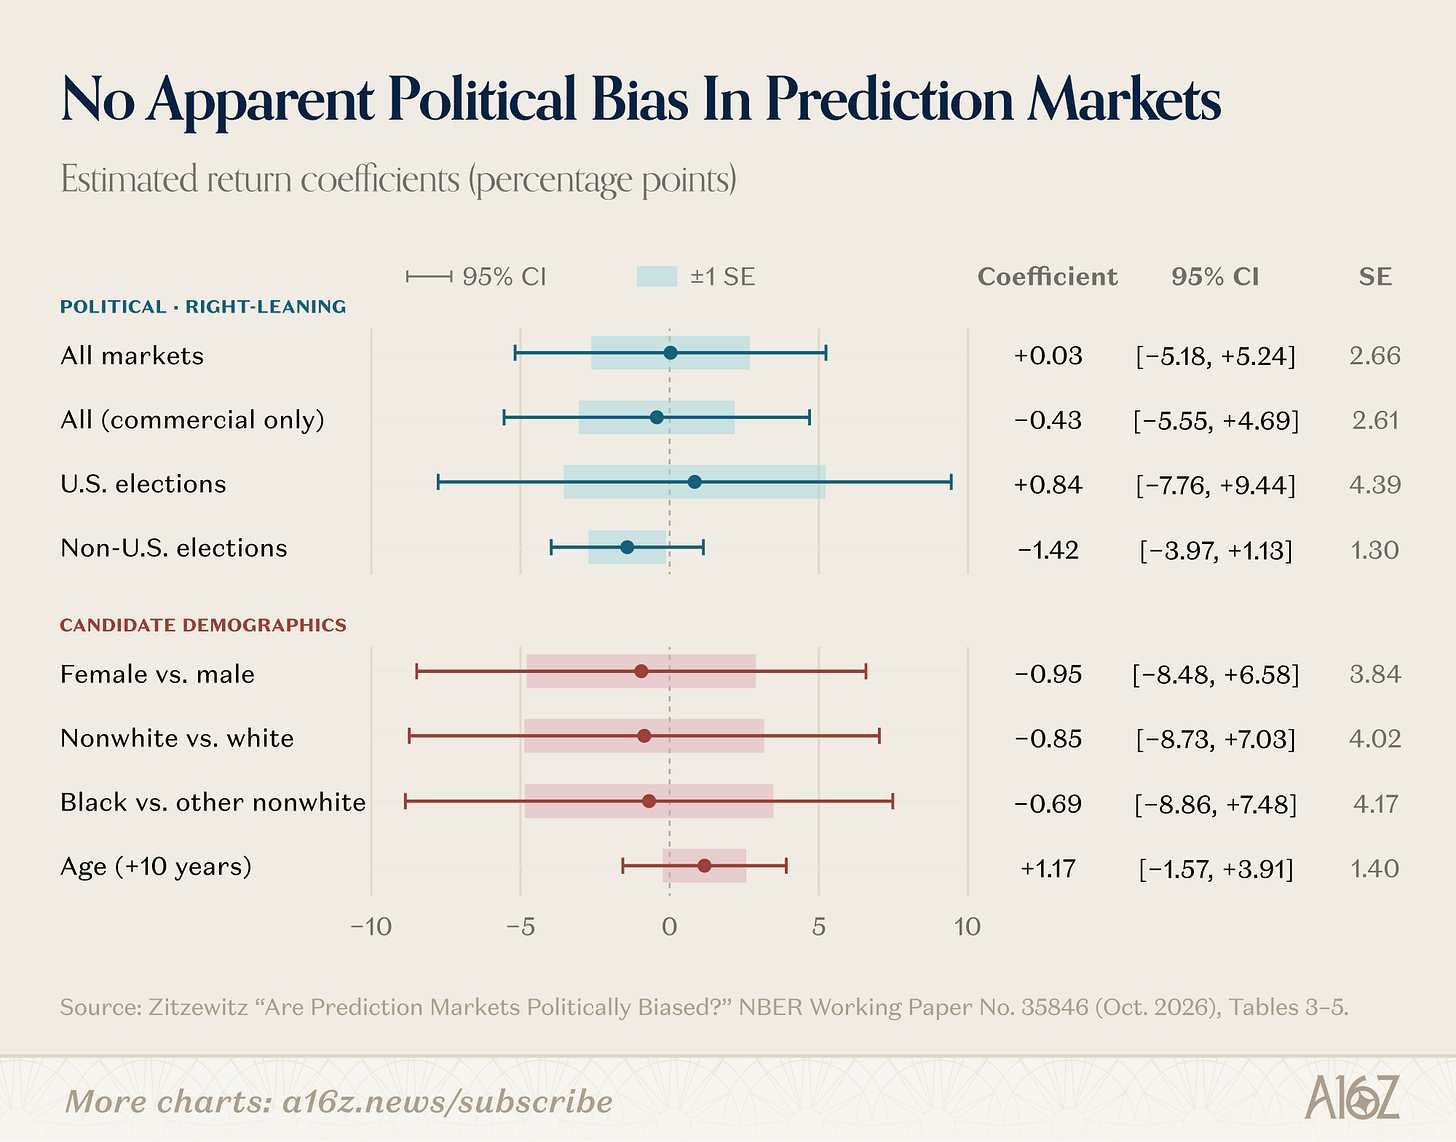
This chart summarizes a subset of the results, and among political affiliation, gender, color, or age, there is not a single dimension where the return coefficient was above or below zero by an amount that exceeded the standard error—the only exception is for non-US elections, where prediction markets appear to reflect some bias in favor of right-leaning candidates (i.e. the coefficient is negative because markets overrate their chances), albeit over a much smaller sample. Even there, however, the 95% confidence interval indicates that the bias is not statistically significant.
Elsewhere, the results suggest a small (statistically insignificant) bias in favor of women and non-white candidates, and against older candidates, but when it comes to partisanship, the coefficient is a bare 0.03.
Take that for what you will, but the results imply that when it comes to elections, prediction markets are pretty good at leaving their biases at the door.
For years, the Rule of 40 was considered a lodestar for techco performance. The idea was to create a single metric that would enable comparisons across fast-growing companies at various stages of their lifecycle, where very rapid, and very unprofitable, growth was expected early, and less rapid, but more profitable, growth was expected as companies mature.
The Rule of [X] part is determined by summing revenue growth with profit margins, and if the number was 40 or higher, you were in good shape. So a company with 100% revenue growth, and -60% margins, was still winning because 100 + (-60) = 40, i.e. Rule of 40 on the nose . . . whereas 150% growth with -150% margins, clocking in at Rule of 0, would be less impressive (despite the faster growth).
Given that Rule of 40 is supposed to be a good thing, it’s odd to see these two things happening at once: public software cos are raising their Rule of X, while multiples are in steady decline:
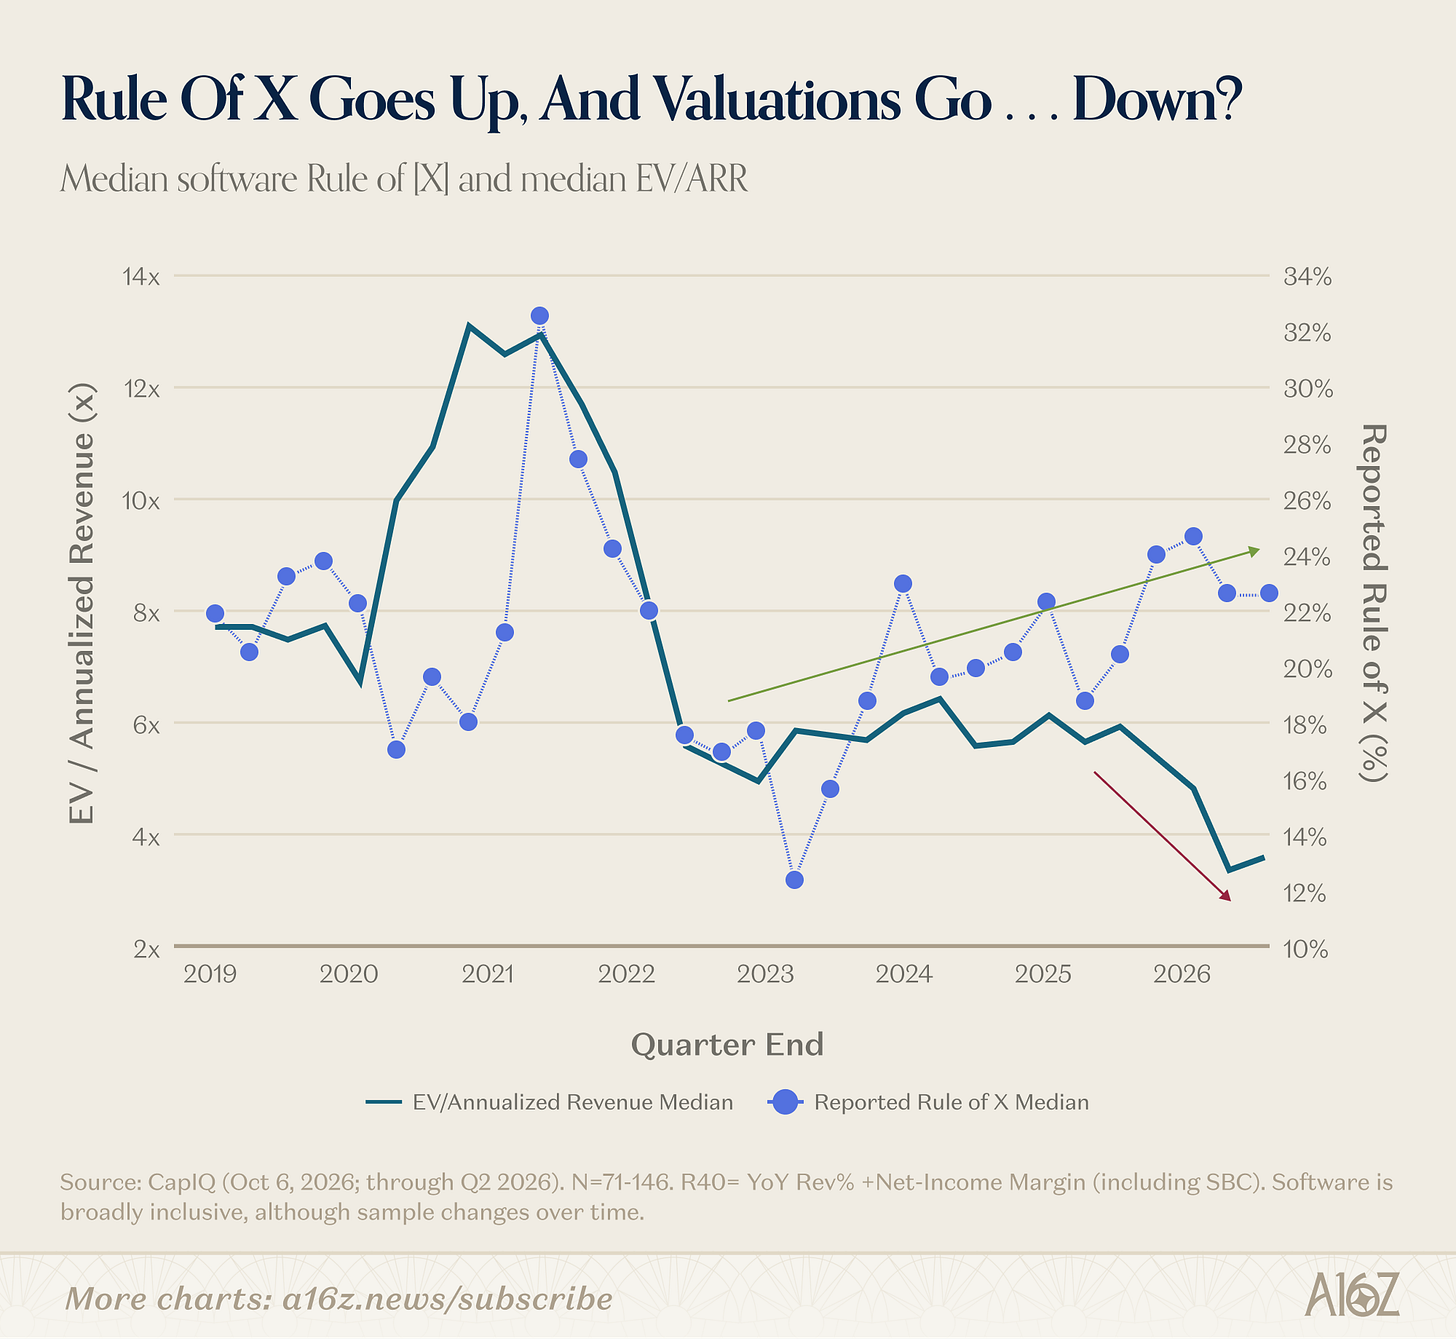
With some fits and starts, the median Rule of X for public software has risen from ~17% to ~23% over the past ~3 years, with the steepest upward inflection beginning early 2025 . . . just when revenue multiples began their precipitous decline.
Here’s another way of looking at it: the correlation between Rule of X and multiples (on a rolling basis) turned sharply south and eventually negative:
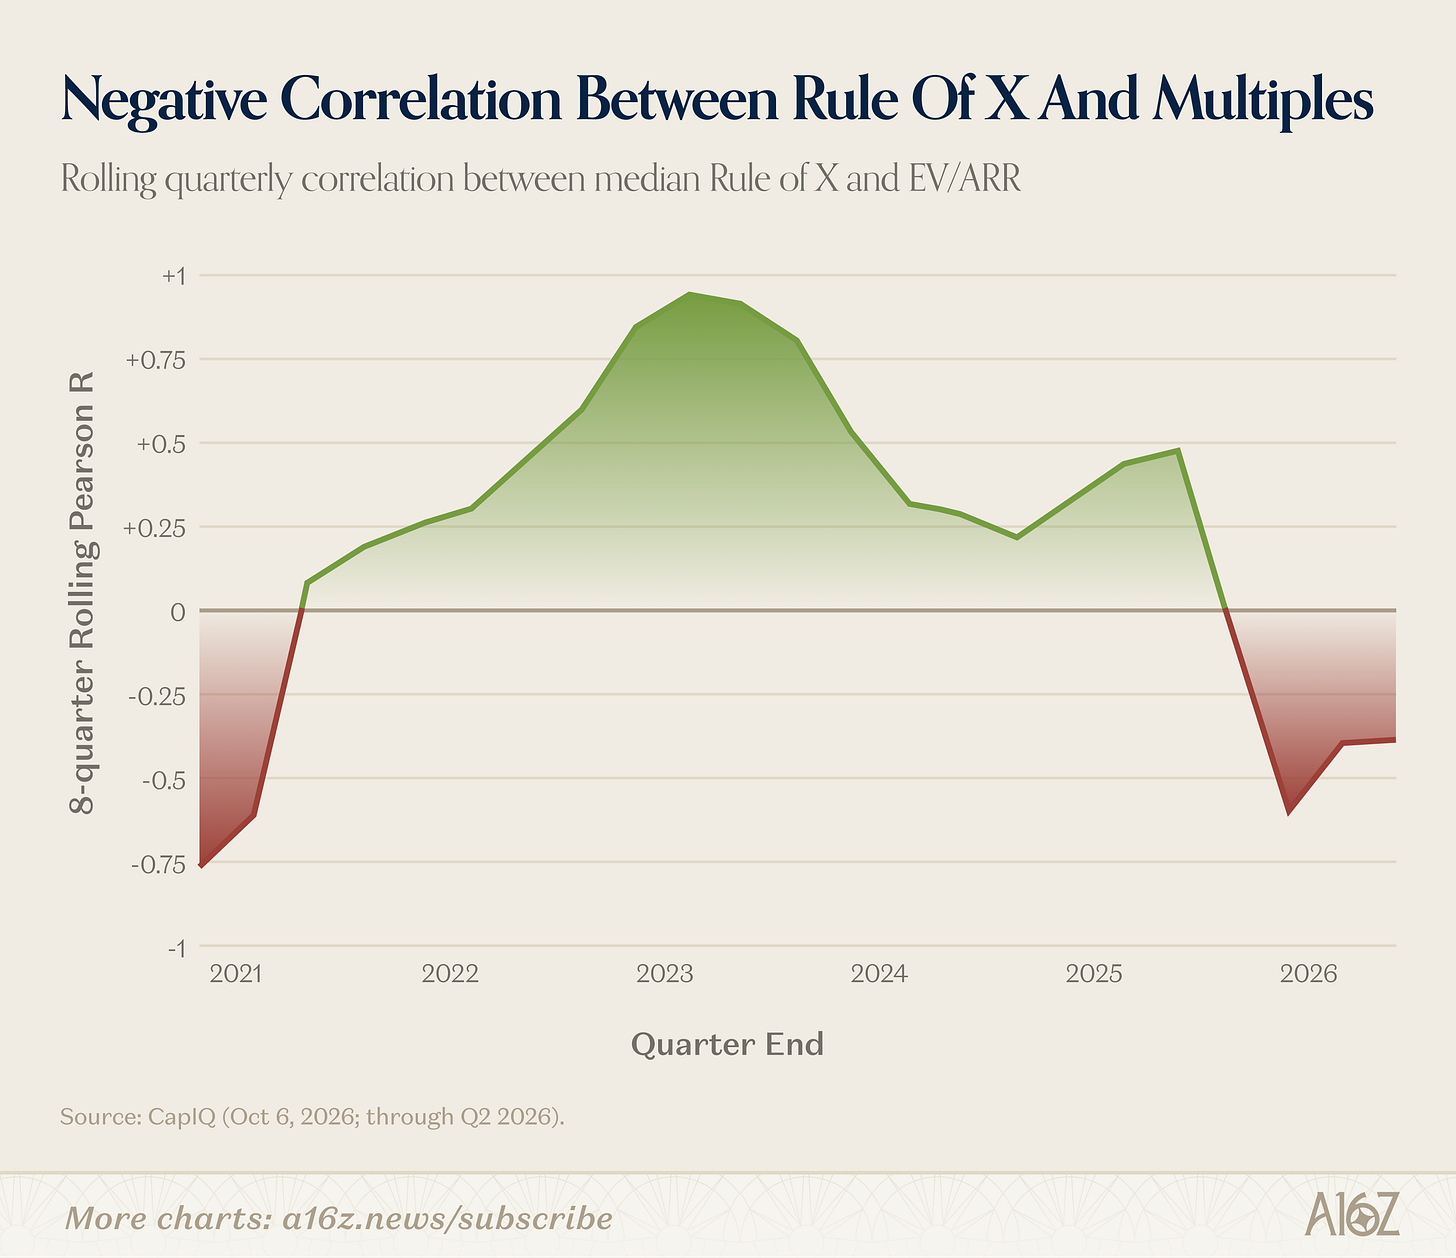
Again, it’s a weird thing. If Rule of X is a good thing, then an improving Rule of X should correspond to better multiples, and not the other way around.
So, what’s going on? The most likely explanation for why Rule of X is weakening as a signal has to do with the component parts: growth and profitability. As laid out in State of Markets, public (and private) techcos responded to post-ZIRP regime change by trading growth for profitability. What that means is that Rule of X is rising, but increased margins are doing most of the work, while growth makes a relatively smaller contribution.
But when it comes to multiples, investors put more of a premium on the latter than the former, so even if the Rule of X number is high, if growth has slowed substantially, multiples compress accordingly.
If you break techcos into their Rule of X buckets, you can see that revenue growth is just a much stronger factor than the combined Rule of X score:
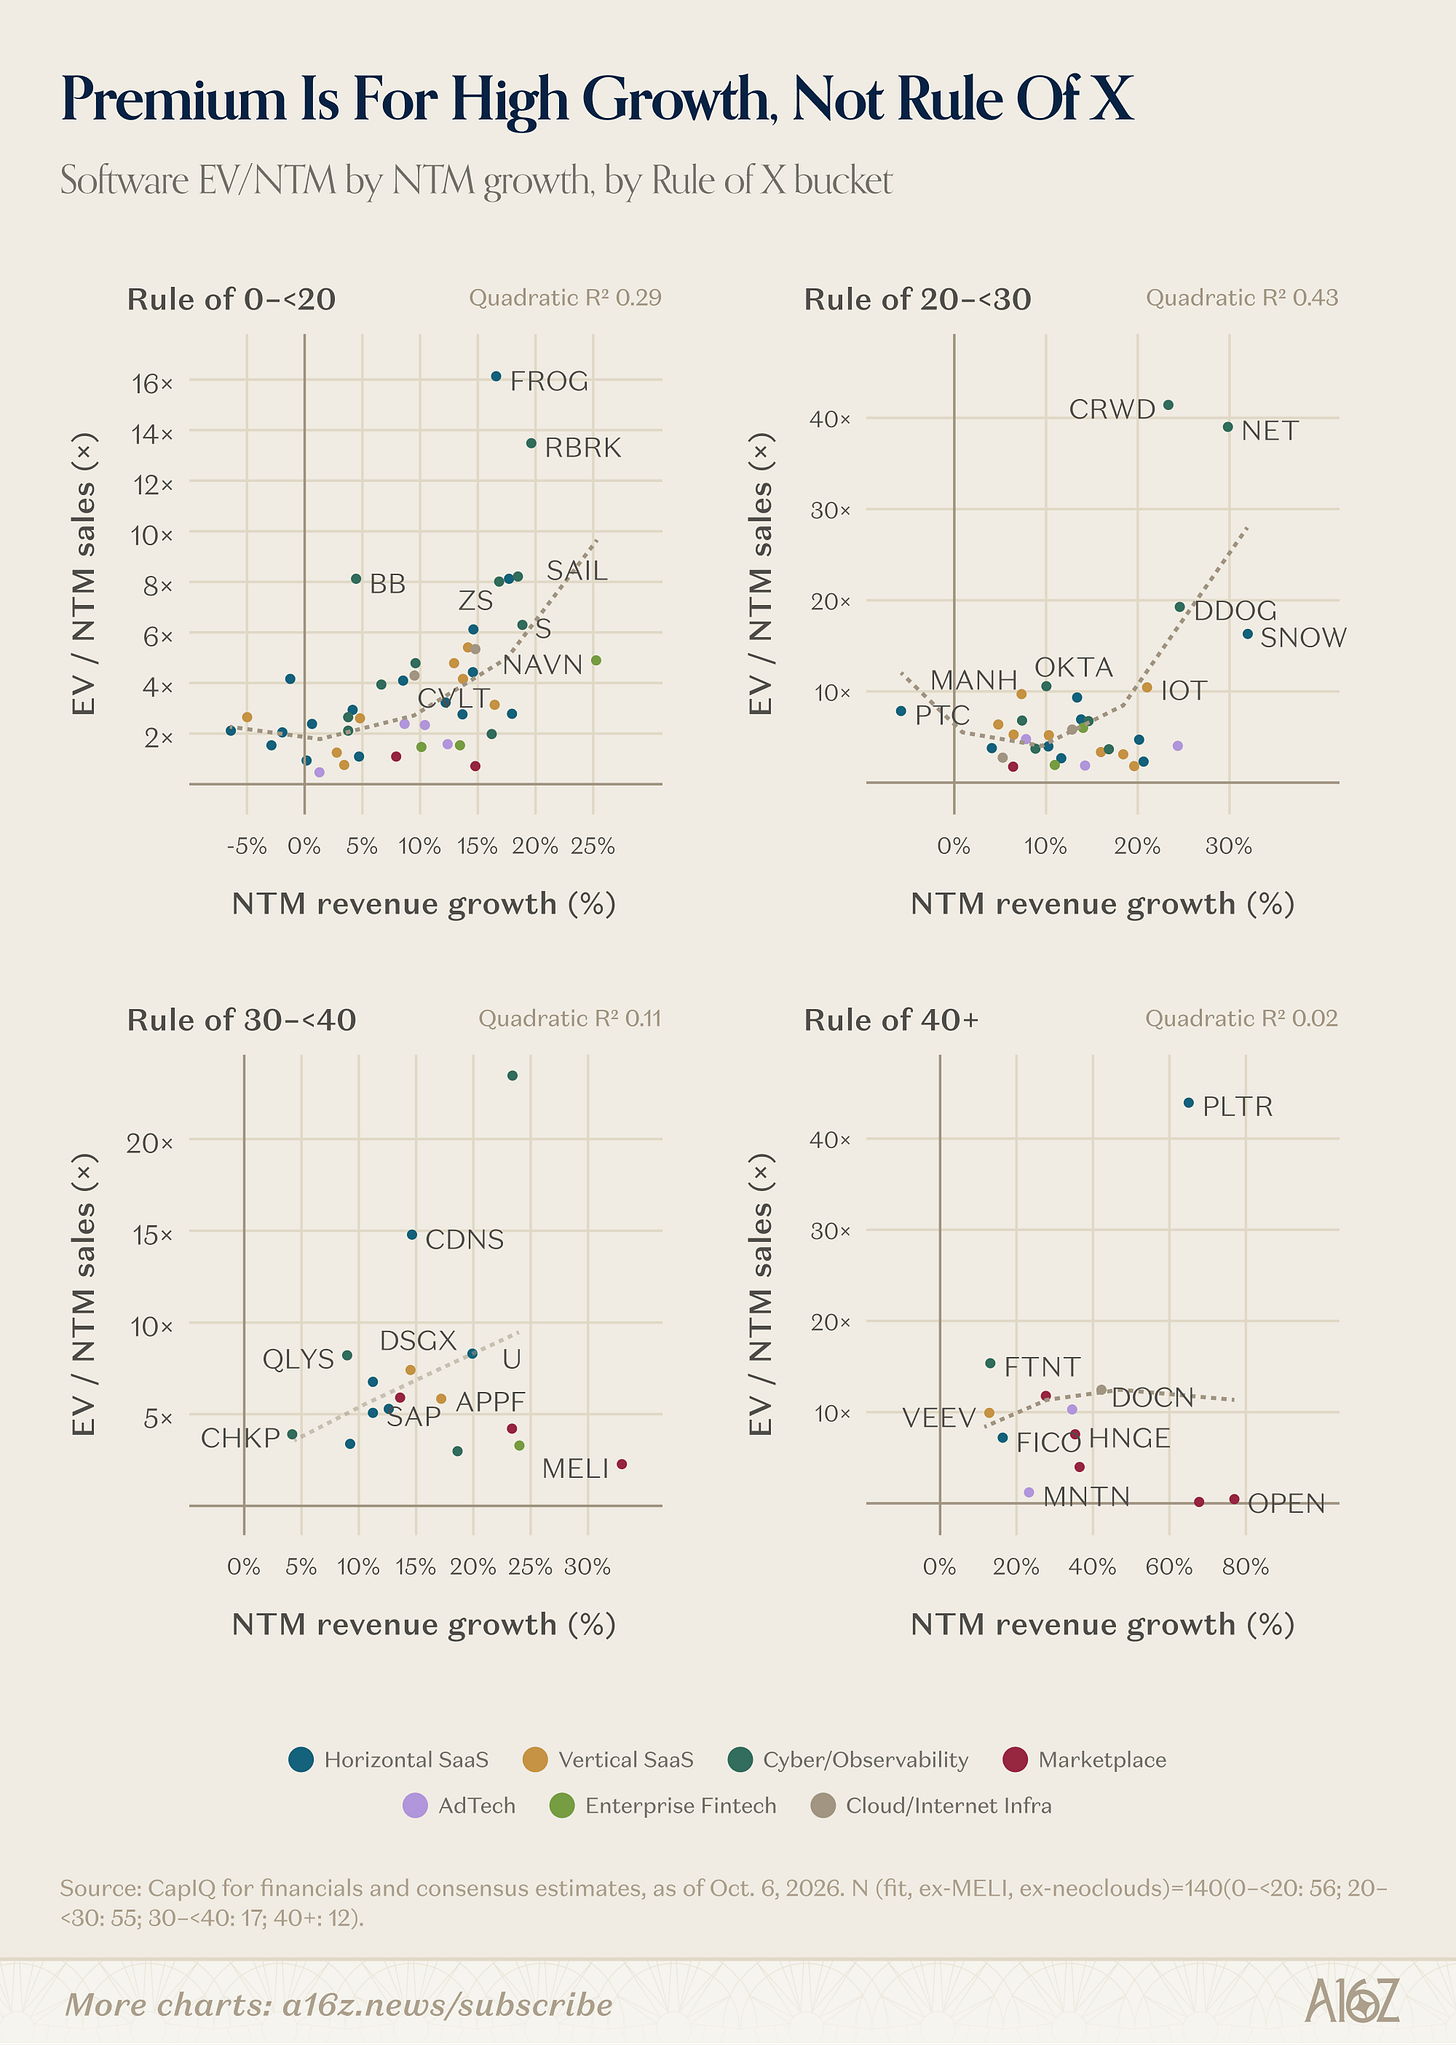
Mind the different scaling on both axes, but the general idea is pretty clear: higher growth companies tend to have higher multiples than lower growth companies with an equivalent Rule of X.
In fact, for Rule of 20 all the way to Rule of 40, most companies are clustering in the same range between 5-10x EV/NTM sales—and it’s only the fastest growers (and really the ones with perceived tailwinds at their back, i.e. cyber and observability) that fetch a premium multiple.
The point here is pretty straightforward: in this brave new world for techcos, Rule of 40 just isn’t as useful anymore as a performance benchmark. The SaaS-Prove-It regime is okay with profitability, but it really likes growth, and if you’ve got a lot of the former, but not much of the latter, then the market isn’t very impressed, Rule of X be damned. If you’ve got both, then that’s all the better, but there aren’t too many of those.
Speaking of performance metrics where the headline picture may be obscuring some parts of what lies below, consider the recent downturn in the breadth of positive earnings revisions:
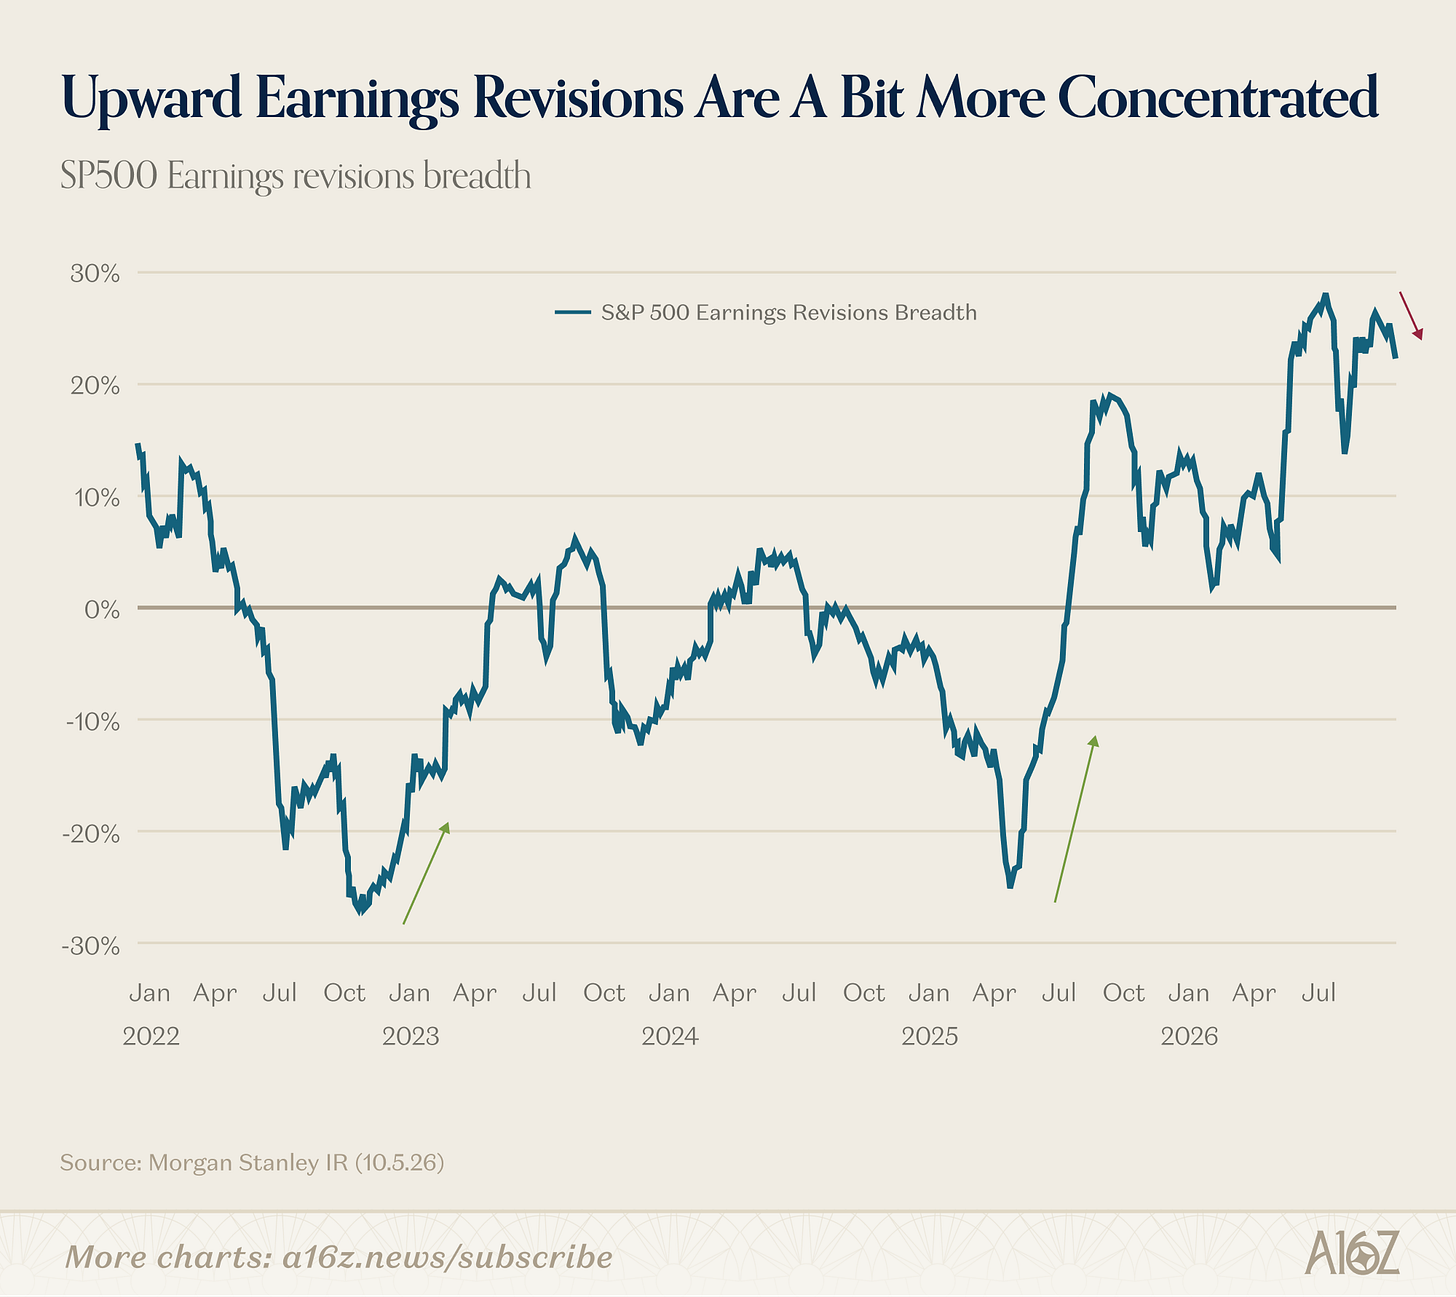
When breadth is positive (as it’s been since July of ‘25), that means earnings revisions are relatively broad-based . . . and when it’s negative, it means the good news is limited to a narrower subset of companies.
While revisions breadth is still positive, things have narrowed recently, with the implication that analyst optimism is training its fire, more so than before.
And where, might you ask, does even-more-optimism still abound? It’s really only in two sectors: energy and tech, but more specifically hardware, not software:
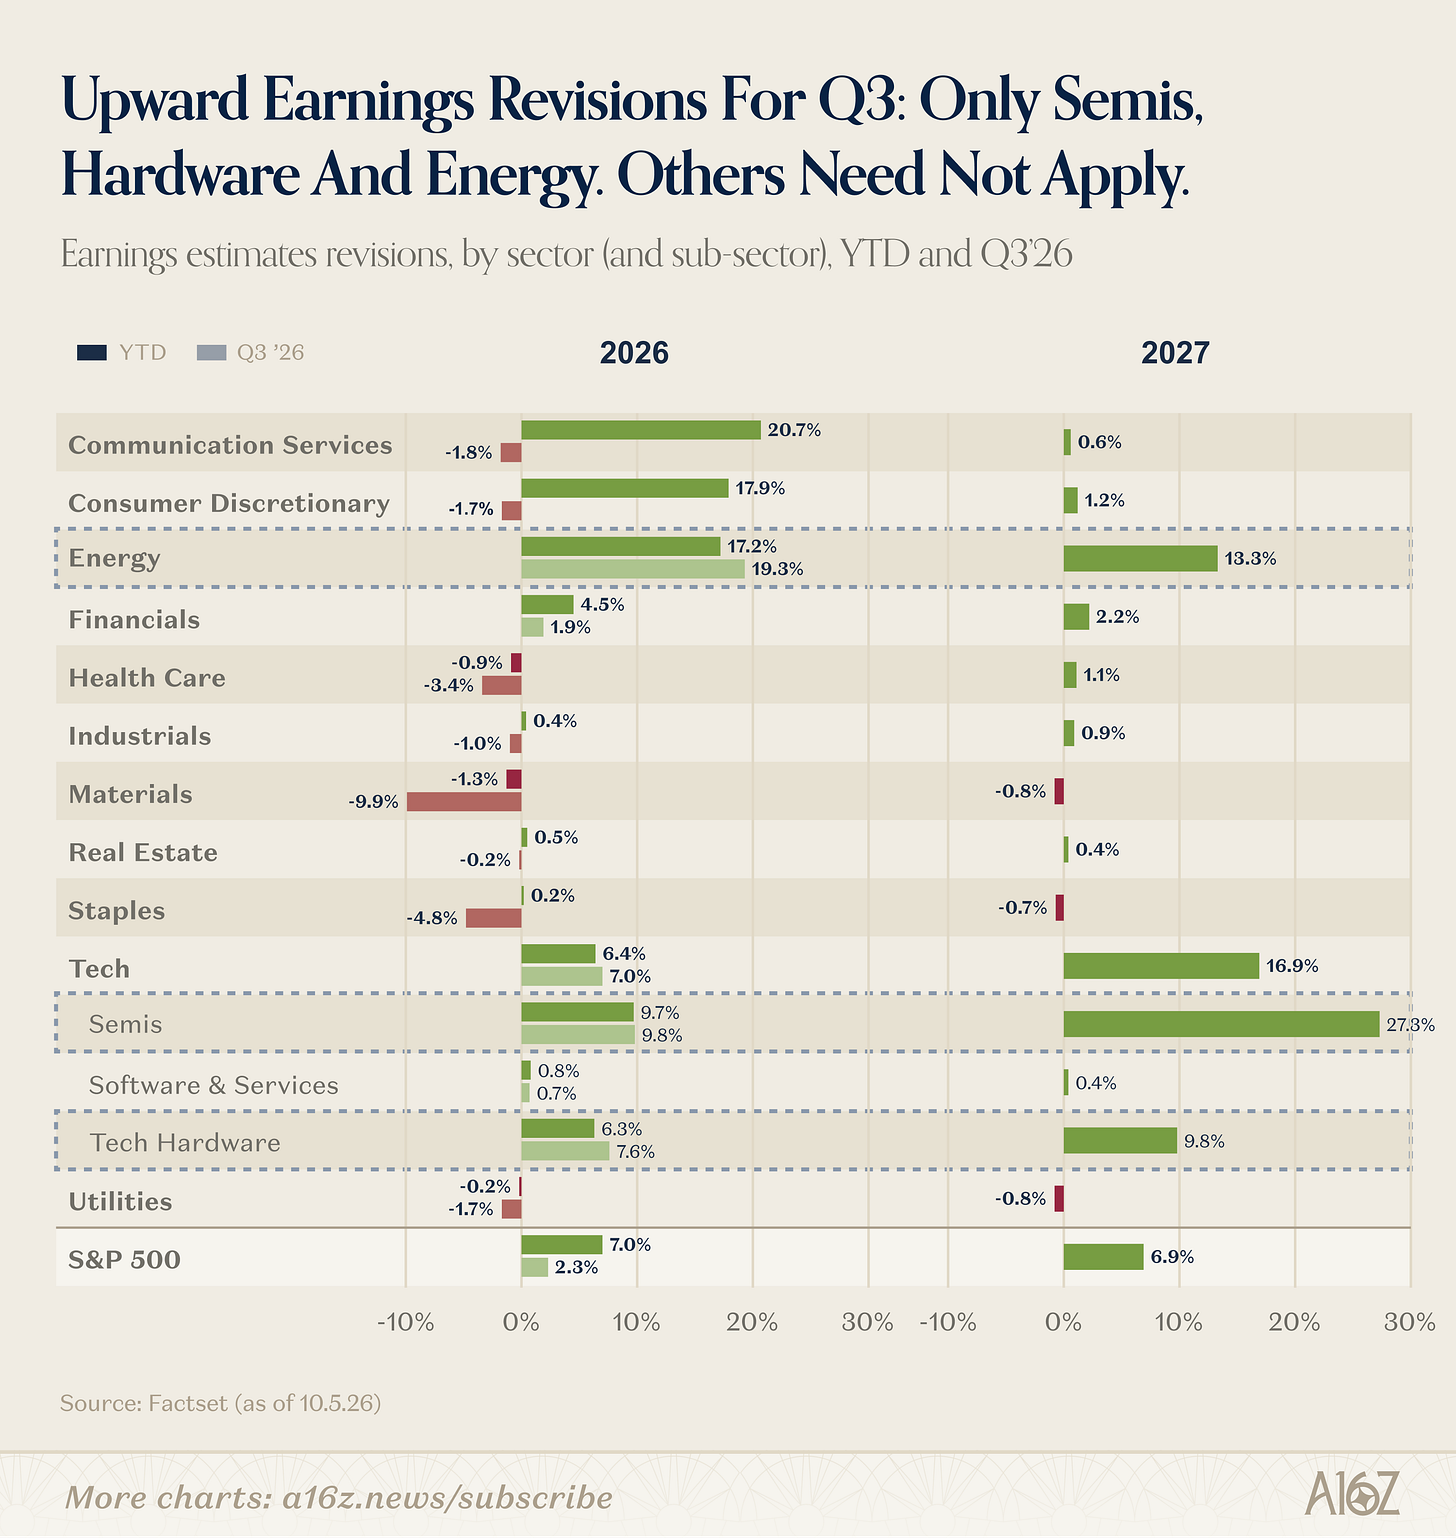
For the year, earnings revisions have been positive across the board (outside of utilities), but for Q3, the story is different: Energy improved, Tech improved—driven almost entirely by semis and hardware, with only the slightest uptick for software—and Financials improved modestly, as well, but every other sector experienced a downward revision from analysts. 2027 is a similar story: Energy, Hardware and Semis are the clear analyst winners, while the rest of the market, not so much.
In other words, expectations are that profits will continue to flow to Atoms, substantially more so than Bits.
AI capex shows no signs of slowing—if anything, the industrial backlog is increasingly broad-based:
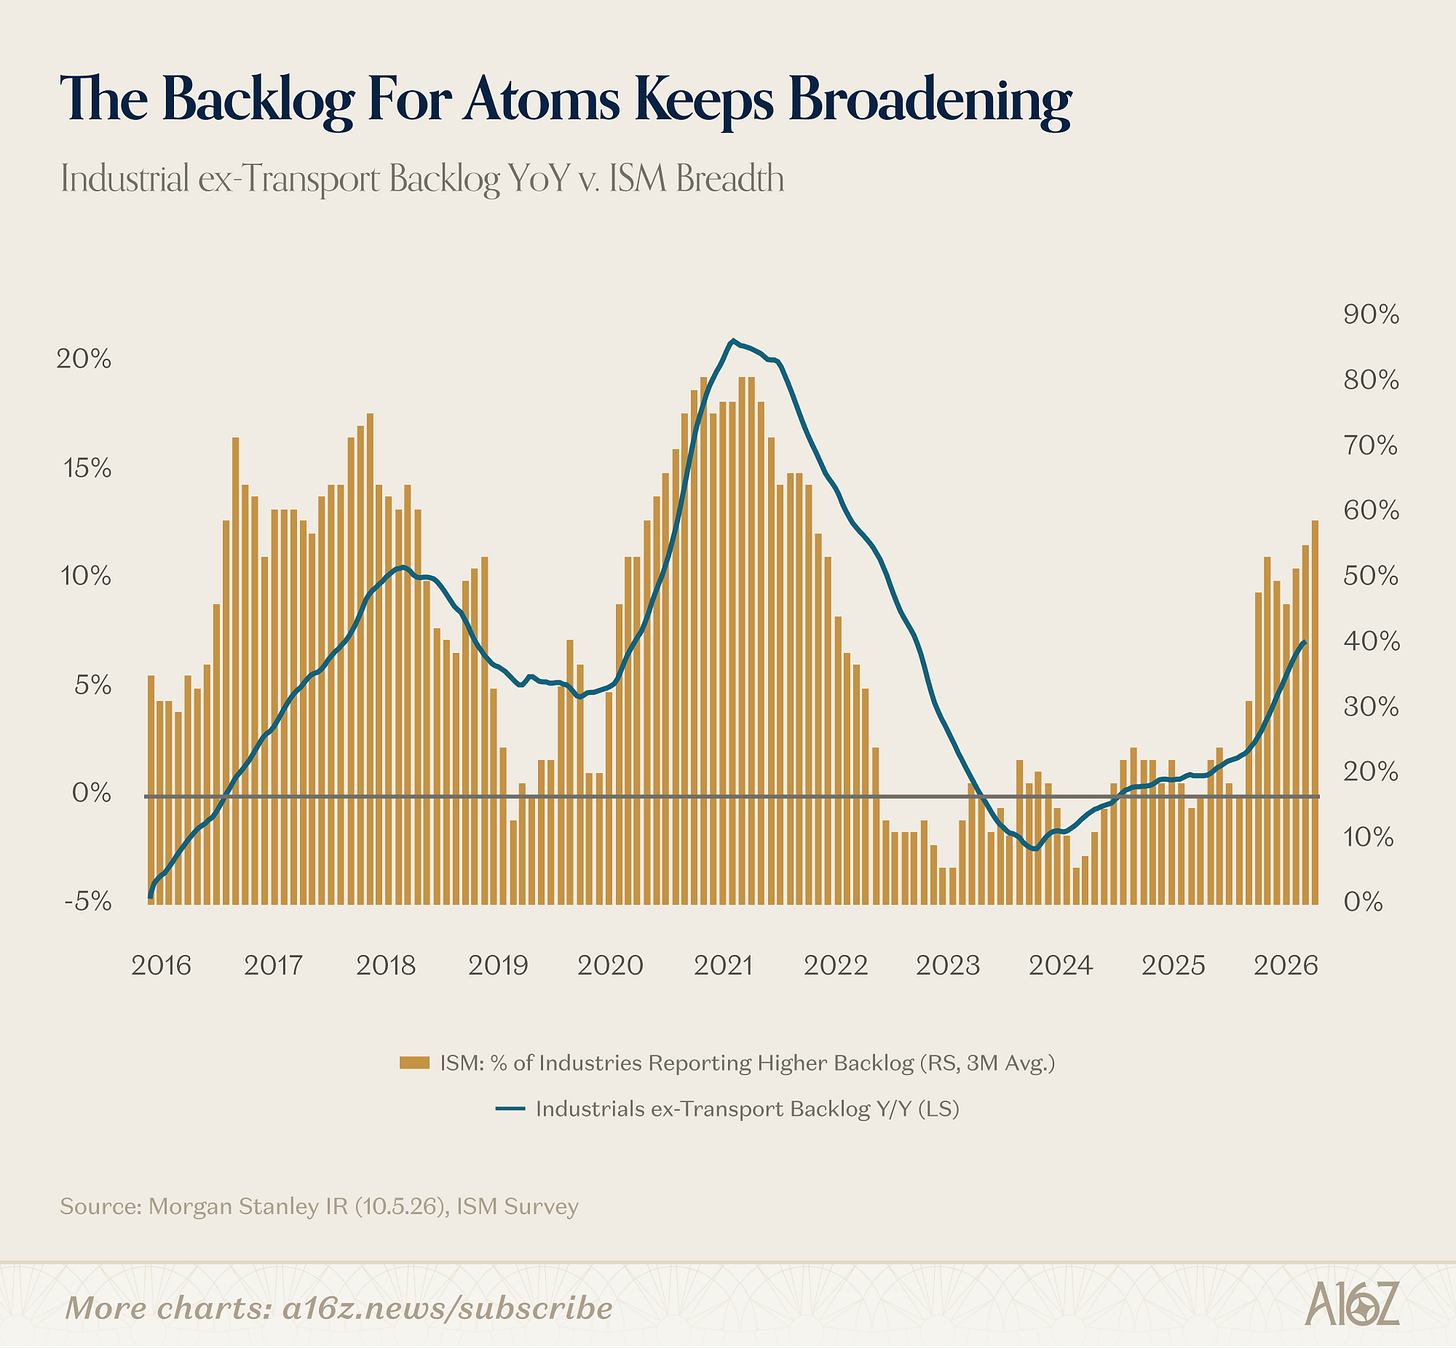
As per the ISM, the share of industrial industries reporting a higher order backlog is now ~60%, which is the highest it’s been since pandemania.
At the same time as spending on the infra layer keeps piling up, there is some evidence that spending on everything else—while still high—is beginning to taper:
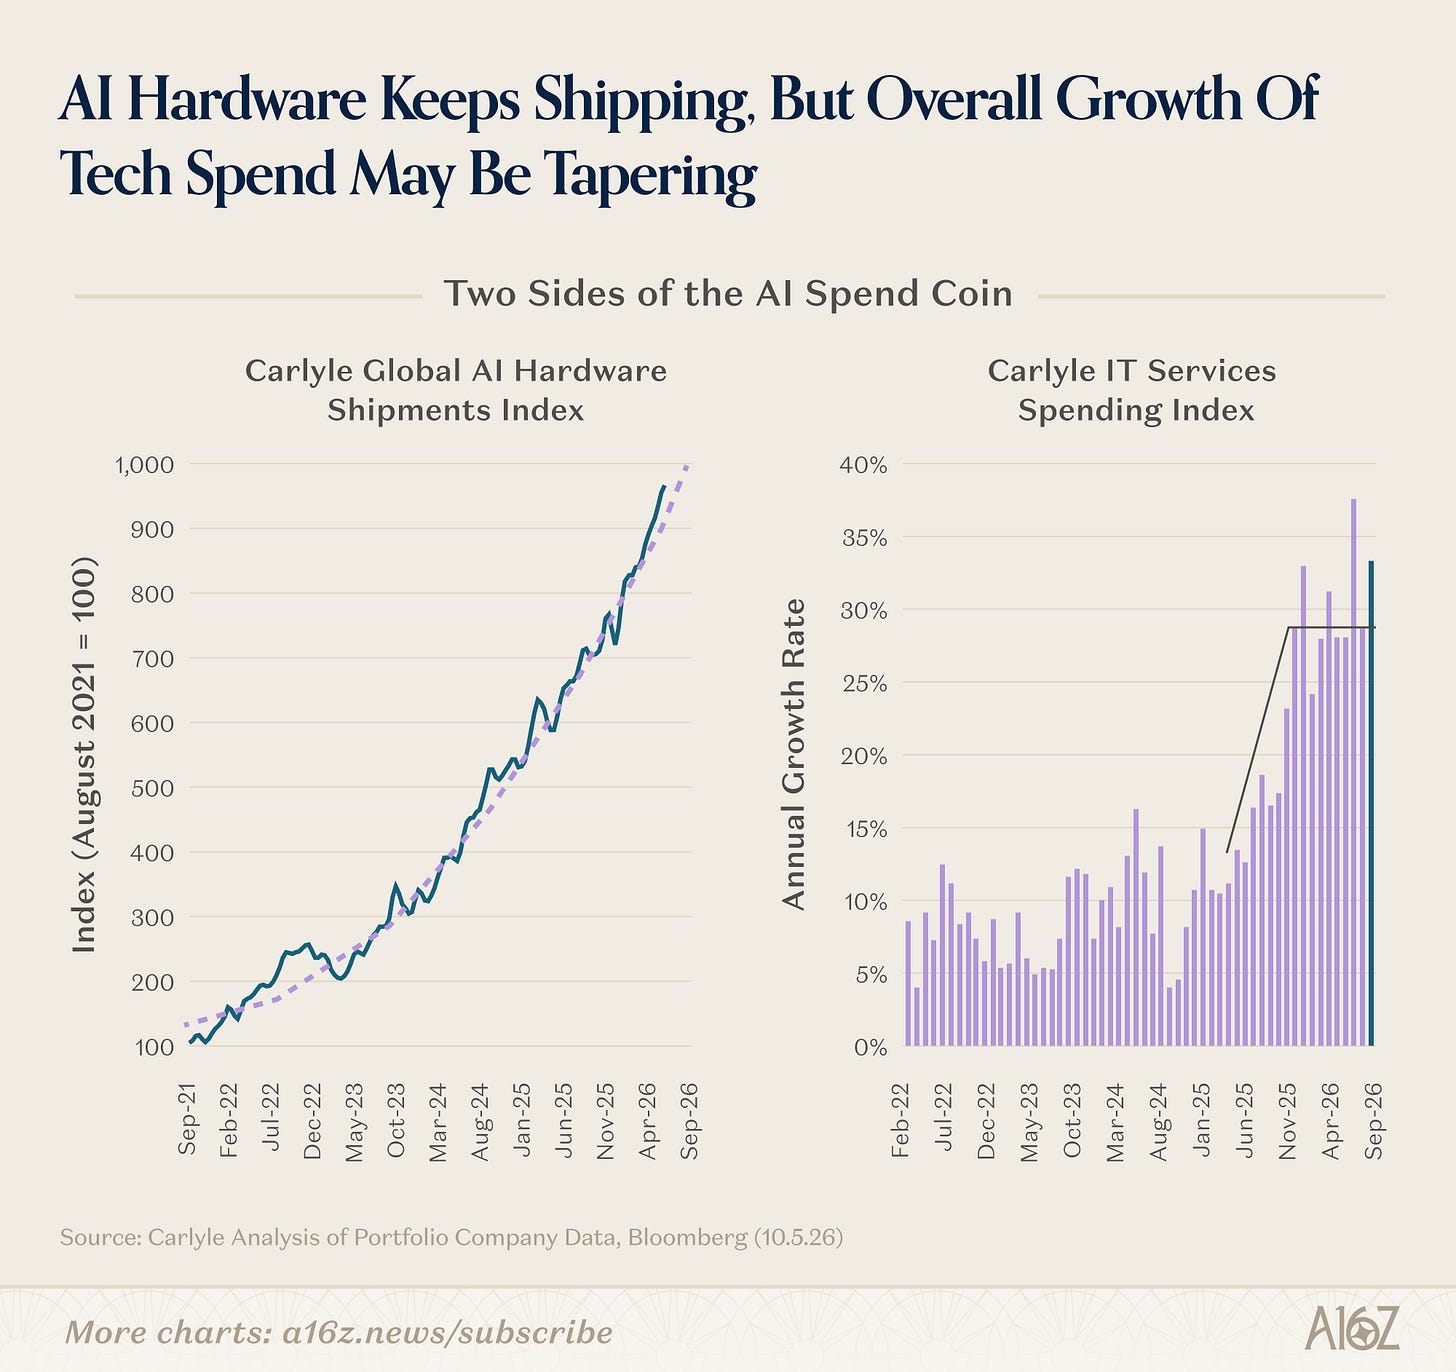
According to Carlyle’s private portfolio company data, shipments of AI hardware are still climbing at their exponential pace, while the “other side of the AI spend coin,” i.e. growth of the broader category of tech-spend, has leveled off at ~30%.
30% growth is pretty high—and much higher than before—but growth does not appear to be accelerating any longer, which is again, not the case when it comes to hardware. The implication is that after a year of better than expected results for pretty much everyone, that upside surprise may be narrowing.
Put another way, while the AI buildout keeps embiggering, that hasn’t changed expectations for how those benefits may flow through to the rest of the ecosystem—the epic run on atoms is picking up speed, even as it runs ahead of the field. Those unchanged-to-downwardly-revised forward estimates for everyone outside of AI infra are backed up by some hard data, as well, insofar as broader IT spending, while still growing, does not appear to be accelerating.
Of course, the fact that analysts have made upward revisions to their estimates for most of the year means that they’ve gotten this “wrong” before, but for now, consensus is signaling that the AI buildout will stay in the driver’s seat, even more so than before.
While the broader evidence of the AI Jobs Apocalypse remains weak to non-existent—and indeed, there’s evidence that AI has increased demand for technical and hard-hat roles—there is some data that shows at least one “AI exposed” category is taking it on the chin: call centers.
According to data from Revelio, global call-center employment has gone sharply negative, after more than a decade of fairly consistent growth:
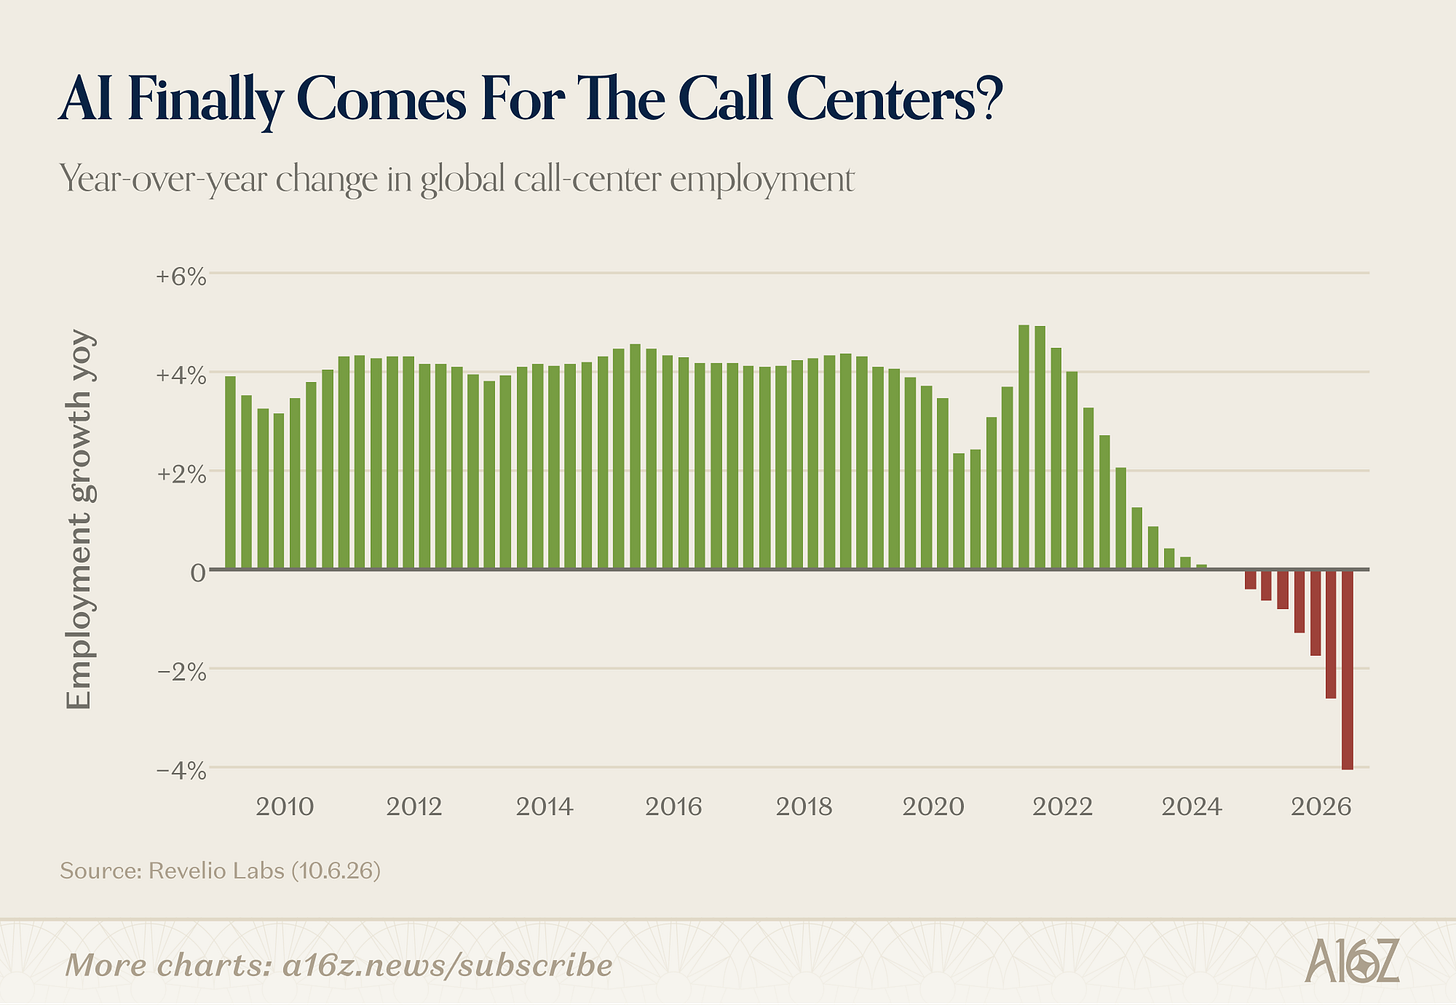
To be fair, growth began slowing when interest rates went up, which is slightly before GPT was released into the wild . . . but the downtrend has steepened substantially since then, and has accelerated of late.
Indeed, while lower-middle-income countries were relatively insulated from the downturn through most of 2024, even there growth has gone negative:
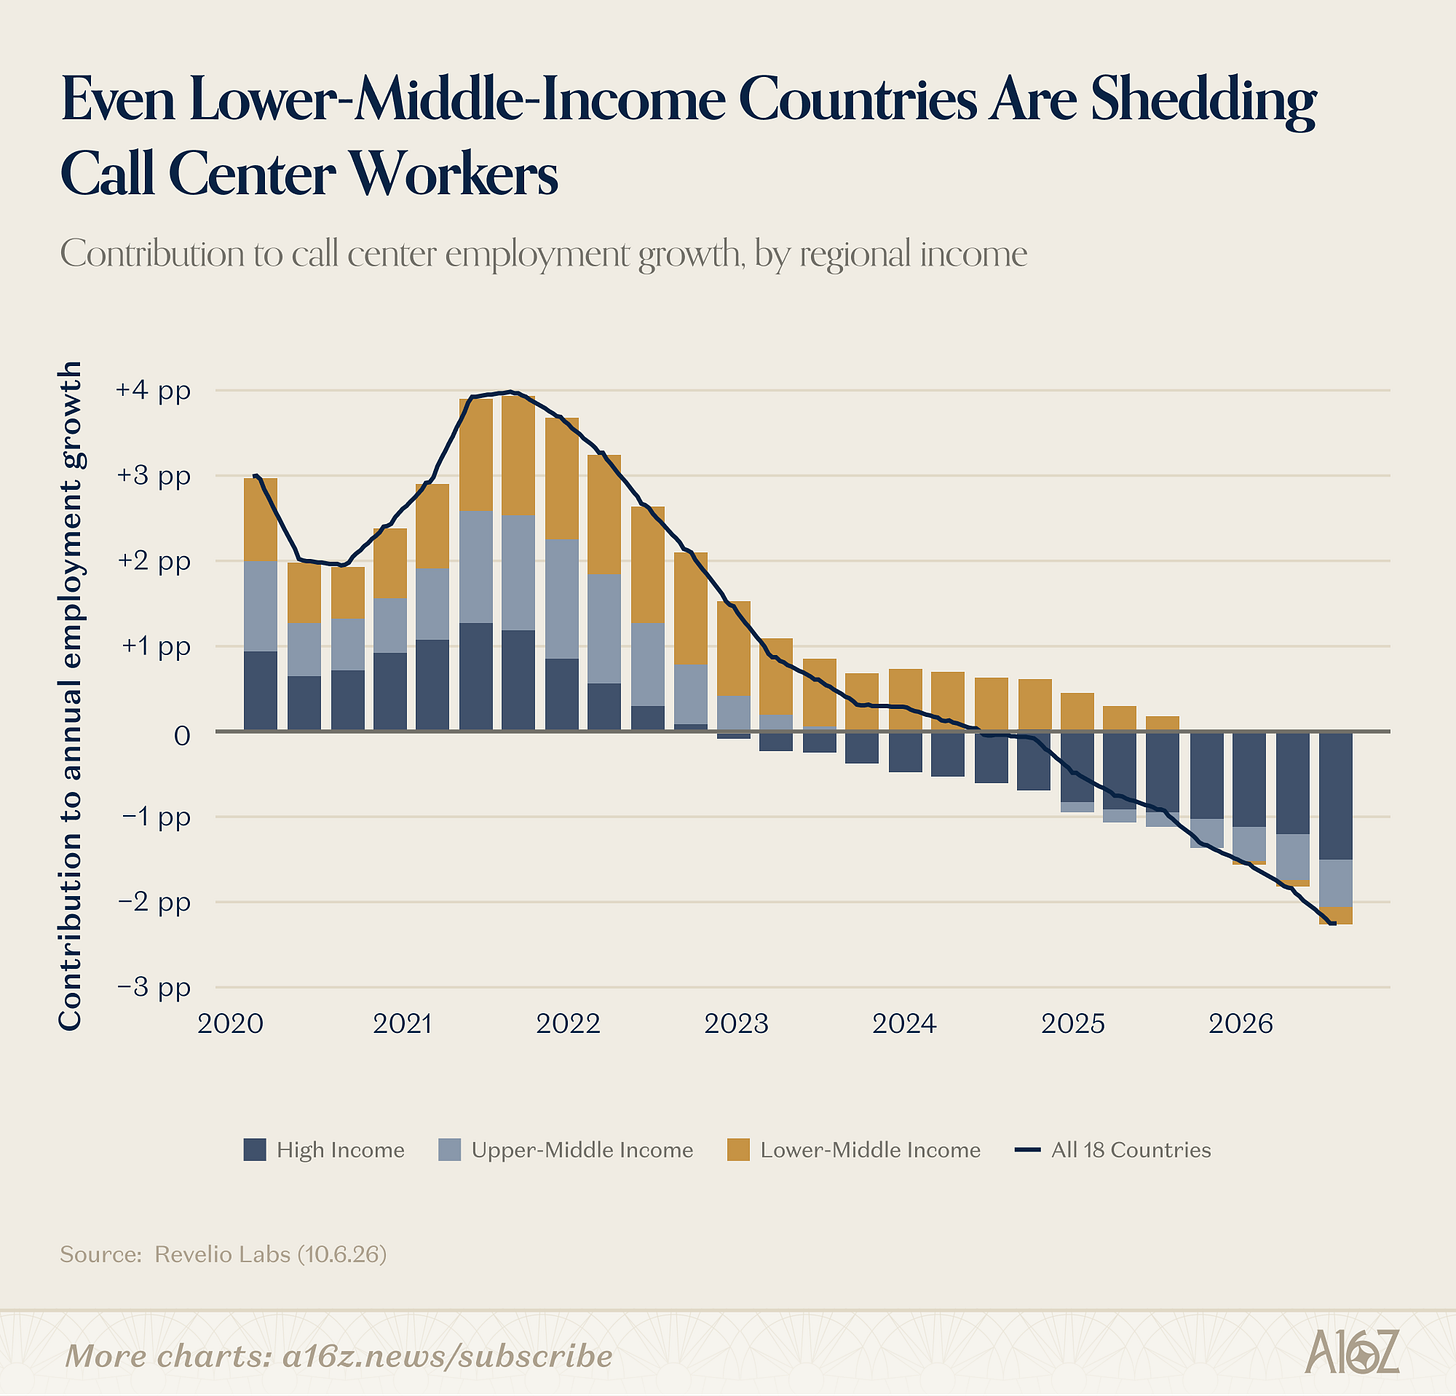
While higher-income countries went negative in 2022, lower-middle income countries stayed positive for another ~2 years. But, as of Q4’25, call center employment growth has gone negative everywhere, even in the poorest countries.
And lest one think that the downturn isn’t AI-driven (or specific to call centers), that too does not appear to be the case:
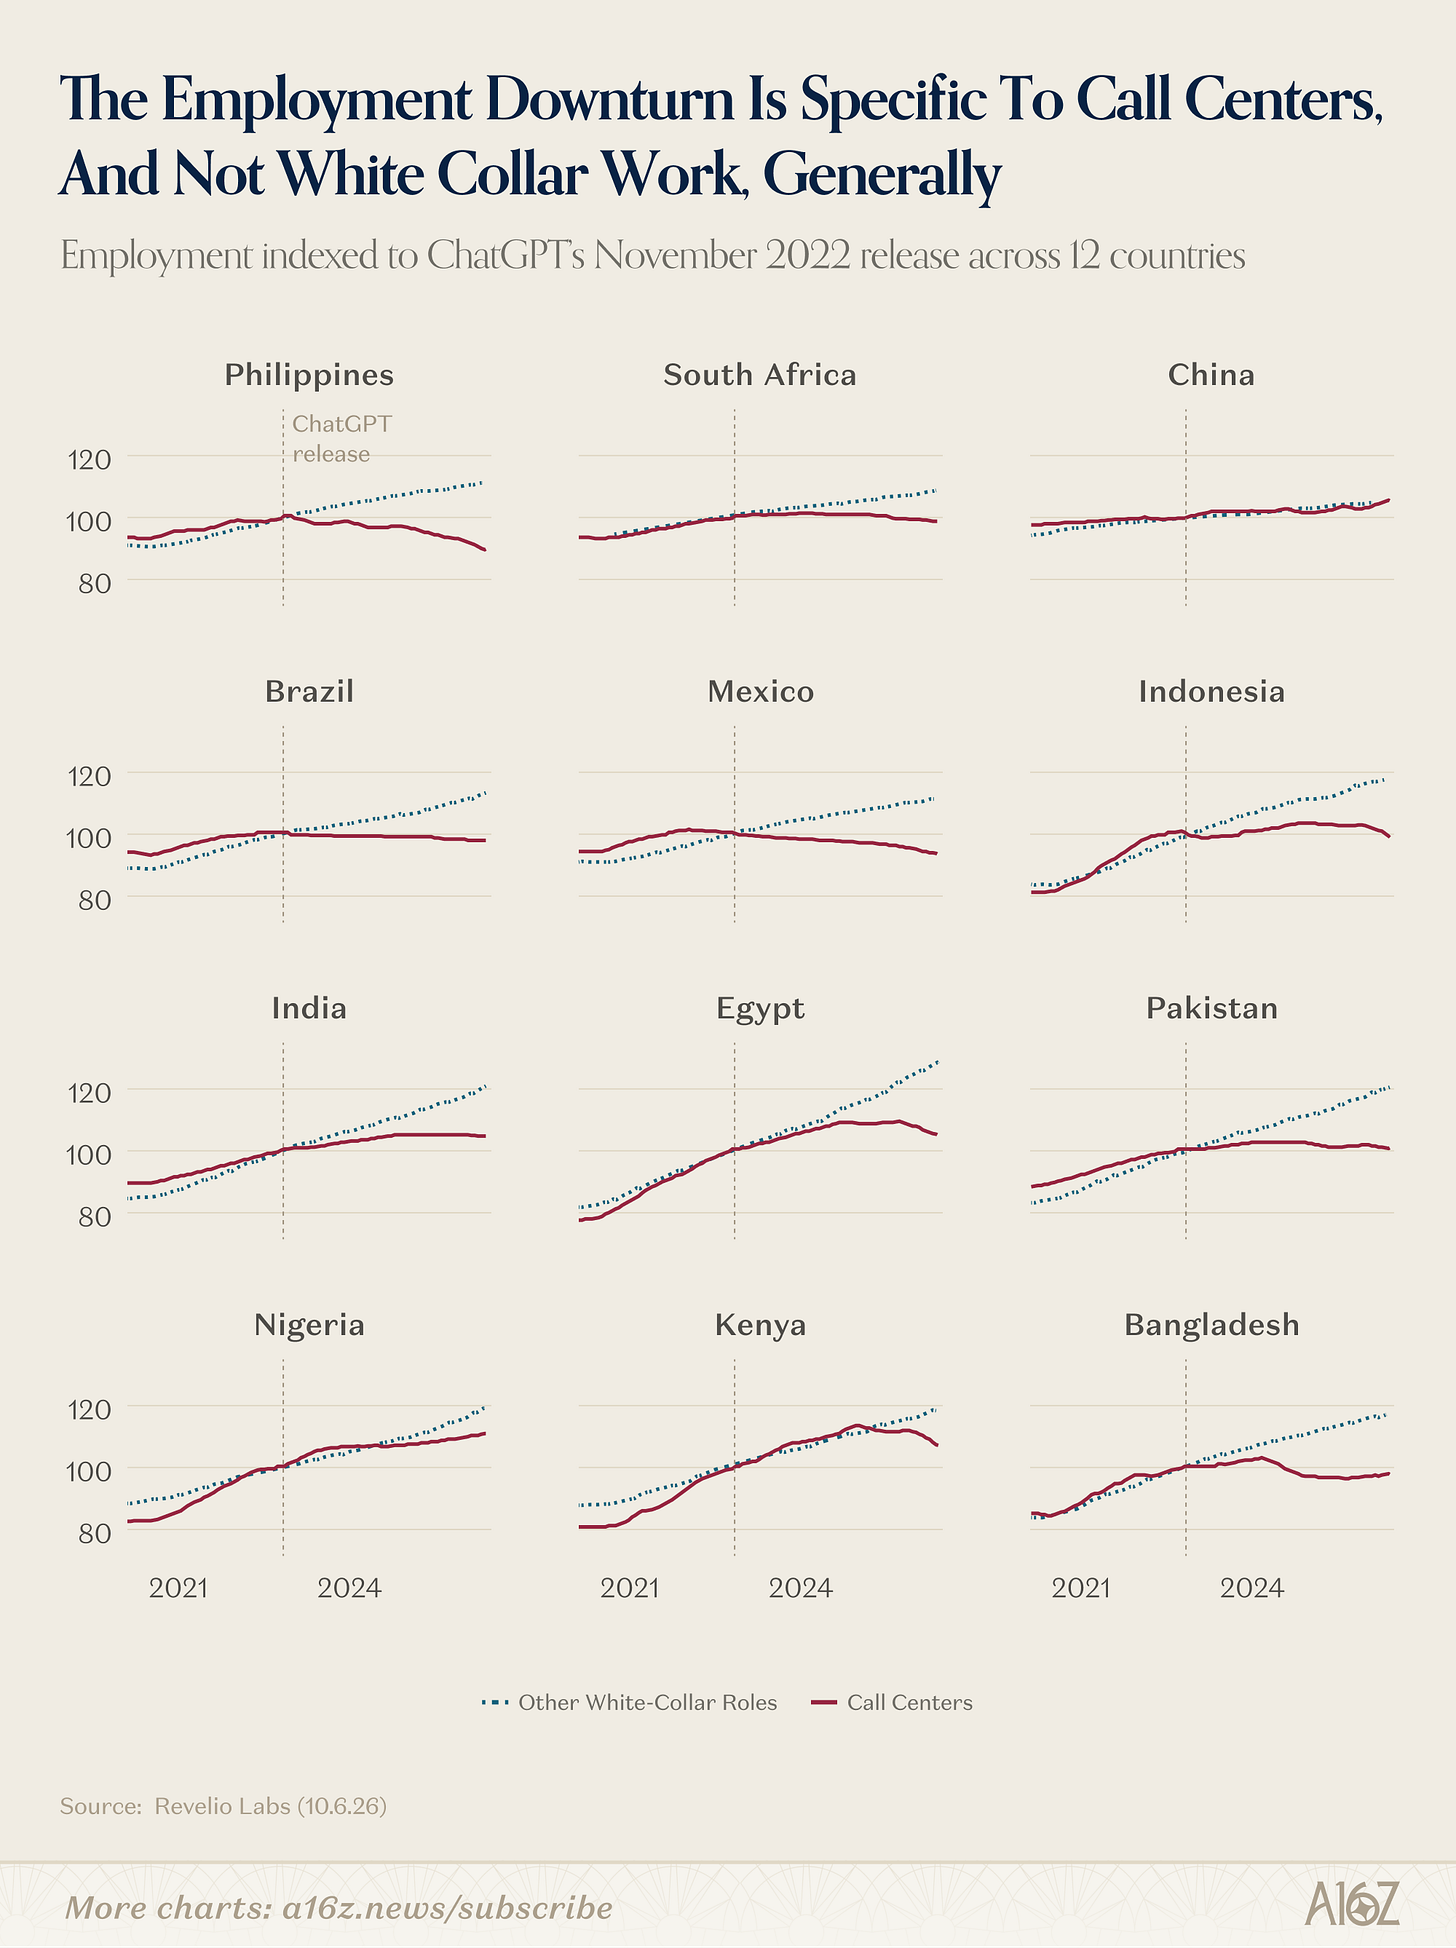
Outside of China, interestingly enough, call center employment has lagged the broader category of white-collar service work in every major non-US market for call centers.
Could there be other reasons for below-trend call center employment, besides AI? Probably, but call centers were always expected to be a likely target of substitution, so it seems reasonable to conclude that AI is the driver here. In the US, at least, the good news is that unemployment has been relatively stable, suggesting that the people who used to work in call centers appear to have found employment elsewhere . . . but changes are definitely underway, and one would expect more to come.

This newsletter is provided for informational purposes only, and should not be relied upon as legal, business, investment, or tax advice. Furthermore, this content is not investment advice, nor is it intended for use by any investors or prospective investors in any a16z funds. This newsletter may link to other websites or contain other information obtained from third-party sources - a16z has not independently verified nor makes any representations about the current or enduring accuracy of such information. If this content includes third-party advertisements, a16z has not reviewed such advertisements and does not endorse any advertising content or related companies contained therein. Any investments or portfolio companies mentioned, referred to, or described are not representative of all investments in vehicles managed by a16z; visit https://a16z.com/investment-list/ for a full list of investments. Other important information can be found at a16z.com/disclosures. You’re receiving this newsletter since you opted in earlier; if you would like to opt out of future newsletters you may unsubscribe immediately.
No posts