企业 AI 为什么卡在 Demo:先证明一个流程,再谈规模化
从客户痛点选出一个流程,开发前明确权限、责任、基线和评测;用真实数据取得证据,再决定是否扩大投入。试点留下的知识与运行能力,让下一个流程更容易起步。
- 企业 AI 卡在 Demo 与生产之间,通常不是模型不会回答,而是没有选定边界清楚的流程、预先约定证据,并让试点结果通向明确决策。
- 第一个流程应从客户等待、抱怨或流失的环节向内寻找;缺少真实用户、真实数据、可签定基线或明确所有者的候选项,在开发前就应淘汰。
- 基线、黄金集和失败标准必须先于 Agent;随后用真实数据与旧方式并行试跑 2–4 周,同时测吞吐、质量和经济性,再决定继续、调整、停止或扩展。
- 权限和负责人从开发前就要明确;证据支持扩展后再完善生产部署与运营交接。留下的上下文、评测和运行经验,让下一个流程不用从零开始。
企业在 AI 上最容易产生的错觉,是把“能演示”当成“值得部署”。Mark Ajzenstadt 在六周内与 20 位私募股权基金的运营合作伙伴交流后发现,大多数被投企业已经会用 AI 起草邮件、整理会议纪要,却说不清怎样把它放进真正影响客户和经营结果的工作流。
这道鸿沟有两个时间尺度:做出一个漂亮 demo 可能只需一周,证明它达到生产质量却可能耗上六个月。问题通常不在模型能不能回答,而在企业一开始就跳过了三件事:没有先找到一个边界清楚的流程,没有在开发前约定什么算有效,也没有让试点结果通向明确的继续或停止决策。
Ajzenstadt 是 AI 交付服务商 Limestone 的创始人。他提出的“AI 转型闭环”从一个客户痛点出发:筛出边界清楚的流程,在开发前约定基线和评测,用真实数据验证最小切片,再决定是否扩大投入。数据权限和负责人从一开始就要明确;证据支持扩展后,再完善生产部署与运营交接。每跑通一次,留下的上下文、评测、基础设施和业务知识又会降低下一次的成本。
第一步:从客户等待处找到一个合格流程
直接问业务团队“你们有哪些 AI 用例”,往往得不到好答案。运营人员每天在服务客户、维护关系和处理例外,客户也不会主动提出“下季度请给我 AI”。让一线人员暂停业务、凭空发明一张 AI 路线图,起点就错了。
更可靠的办法是从客户向内追:先找客户在哪个环节等待、抱怨或离开,再检查产生这次体验的工作、数据、证据和负责人。原文把这套检查拆成五个视角。

- 客户交互:找到会改变客户结果的地方。它可以提供过去没有的洞察,把几天的等待压到几分钟,或让产品在两次发布之间继续改进。Ajzenstadt 特别提醒,开户、资料审核和新客户接入这类 onboarding 环节经常被低估;客户迟迟用不上服务,就是值得向内追查的入口。
- 背后的工作:把步骤分成确定性、判断密集、例外驱动和关系依赖。机器适合接手确定性步骤、为判断准备材料;人继续负责决策、批准和例外。如果大部分工作依赖复杂判断或客户关系,就把它留到后面的试点,先选更容易建立清楚验收标准的流程。
- 上下文:确认事实存在哪里、由谁负责、字段究竟代表什么、敏感级别如何。若公司内部没人说得清数据含义,定义数据就是第一项工作。
- 证据:检查今天能否测量工作单元、处理量、周转时间、人工触达时间、返工、例外率和单位成本。没有当前基线,试点结束后就无从证明发生了什么变化。
- 所有者:提前指定流程负责人、数据负责人和高管赞助人。没有人愿意在试点后接手运行,也没有人愿意依据证据作出继续或停止的决定,这个流程就不合格。
企业可以先找出 3–5 个候选流程,再按价值、可行性、风险和后续复用价值排序,只选一个开始。没有真实用户、真实数据、可签定的基线或明确所有者,应该在开发前淘汰;“重新设计整个组织”这种无法在短周期内验证的目标,同样不合格。
选定后,要与实际操作者走一遍流程,收集代表性案例、例外、权限和未写下来的专家判断。先访谈,再盘点技术;在阅读代码之前,先问清每份数据由谁负责、字段究竟代表什么。Ajzenstadt 还要求写下一个业务结果和明确的非目标,因为团队很容易在第二周把一个小试点扩成整套系统。
第二步:在 Agent 之前签下基线和评测标准
Ajzenstadt 的十步法,关键不在“十”这个数字,而在动作不能颠倒。看过模型答案后才挑指标,人会自然保留模型擅长的部分;试点结束后才补基线,则无法判断变化究竟来自哪里。基线、黄金集和关键失败类别必须先于 Agent 存在。
双方先签下当前工作量、周转时间、人工处理时间、质量与返工、例外率、运行成本,以及用多长的窗口测量。今天怎样做、做到什么水平、改进怎样计算,都要在试跑前说清。
这里的“黄金集”是一组由客户自己的专家确认过结果的真实任务。评测还要包含这个业务最不能接受的失败,例如数字错误、受保护数据泄露,或在数据缺失时表现出虚假确信。成功案例和关键失败都进入标准,试跑结果才有资格进入决策。
这项准备需要企业内部的人参与。按 Limestone 的“证明月”安排,高管赞助人每周投入 30 分钟并在关口作决定,流程负责人每周投入 2–4 小时参与走读和验收,数据负责人在开始时投入 1–3 小时。供应商能开发系统,业务目标、字段含义和正确答案仍要由企业自己确认。
这也划出了预算边界。Limestone 自报的交付组合是一名带 Agent 的驻场开发工程师加一名兼职架构师,每月 15,000–20,000 美元;另一个运营 Agent 项目处理四组客户数据的基础设施费用约为每月 250 美元。两笔数属于不同口径:基础设施账单并不包含开发、验收和组织接手的全部投入。其不收前期诊断费、按月合作、首月不满意不付费的条款,是这家服务商的商业承诺,不能替代客户自己的验收标准。
Ajzenstadt 对证明月还有一条具体纪律:每项活动都必须留下一个决定、一个经过检验的假设、一个可运行增量或一项可复用资产。无法产出其中任何一项的活动,就不值得占用团队时间。这让走读、会议和开发都围绕实际结果展开。
第三步:并行试跑 2–4 周,让证据决定去留
试点不应一开始就替人作最终决定,也不应直接写入记录系统。更稳妥的最小切片是:Agent 给出建议,一名被明确指定的人作决定;它使用真实数据,与旧方式并行运行,每一次执行都留下别人能够检查的轨迹。
这 2–4 周需要同时回答三个不同的问题:做得更快了吗,做得更好吗,算上全部投入以后值得吗?
| 度量 | 需要看什么 | 不能偷换成什么 |
|---|---|---|
| 吞吐 | 每个周期完成多少工作、周转时间和人工触达时间 | “跑得更多”不能单独证明交付更好 |
| 质量 | 首次通过率、返工、人工覆盖、事故和关键失败类别 | 平均正确率不能遮住隐私泄漏、缺数据时虚假确信等尾部风险 |
| 经济性 | 单位运行成本,以及经验证的产能价值、避免返工、增量产出和风险调整后的避免损失 | 节省工时不能直接写成现金;还要扣除云、模型、支持和组织变革成本,并用区间报告 |
原文引用 Faros AI 对 22,000 名开发者的 2026 年遥测数据提醒读者:任务吞吐量提高 33.7% 的同时,每名开发者的缺陷增加 54%,每个 PR 的事故增加 242.7%。这组数字不能预测任何一家公司的结果,但它清楚说明,速度和质量必须分开测量。
试跑的出口有四个:继续、调整、停止或扩展。若结果没有越过事先签下的基线,四周后停止就能保住后续预算。需要调整时,应修改实现或流程方案,再按预先约定的标准验证;不能因为结果不好就降低门槛。如果任务范围本身变了,则需要重新明确验证条件,不能把新旧结果当作同一次比较。
图中把“试跑”和“三类度量”放在同一阶段:证据在运行中持续积累,最后由业务方与交付方共同决定下一笔投入。
试点怎样决定下一步
先取得证据,再决定投入
权限与负责人从起点明确;试跑结束后有四种去向。
-
选定一个流程
从客户痛点向内走读,锁定真实用户、数据、负责人和非目标。
留下:边界清楚的工作与一个业务结果 -
预设基线与评测
双方签下当前表现和测量窗口,由客户专家确认黄金集与关键失败标准。
留下:开发前就确定的验收依据 -
真实试跑,同时度量
与旧方式并行运行 2–4 周。Agent 提建议,人作决定;暂不写入记录系统。
留下:吞吐、质量、经济性与可读执行记录
按预先约定的标准,共同作决定
- 继续
- 在当前范围内继续验证,持续积累证据。
- 调整
- 修改实现或流程方案 → 再试跑;不因结果差而降低门槛。
- 停止
- 结束本次试点,保留证据,停止追加投入。
证据支持扩展,再完善生产部署与运营交接
一个通过试点的 Agent 仍需要稳定调度、观测、集成、失败回退、成本上限和持续评测,才能进入日常运营。每次修改都要重新评测,部署位置也不能依赖某位工程师的电脑。原文的七级采用阶梯,描述了从个人工具走向组织系统时需要具备的能力。
阶梯的位置不意味着可以推迟基础权限管理。Ajzenstadt 明确要求知识结构从第一天就有基于角色的访问权限;数据所有者、敏感级别和试点负责人也在开发前确定。试点过关后增加的是生产运行与扩展所需的保障,前期仍要守住数据和权限边界。

| 级别 | 增加的能力 | 常见状态 |
|---|---|---|
| 1 | 工具采用 | 人逐个启动 AI 工具;人休假或合上电脑,自动化随之消失 |
| 2 | 上下文层 | 部门知识分域管理,用明确接口跨部门查询,减少语义串线 |
| 3 | 评测、路由与质量门 | 先定义标准和分流,再选择模型;更换模型不必拆掉整套系统 |
| 4 | 脱离个人电脑的托管执行 | 按时间或条件触发,无需某个人每天登录后才开始 |
| 5 | 治理 | 知识结构有基于角色的权限,Agent 有生命周期;久不使用或评测下降的能力被退役 |
| 6 | Agent 之间的交接 | 一个 Agent 的输出交给下一个,中间设有质量门 |
| 7 | 半自动或全自动工作流 | Agent 处理大量常规任务,人集中处理例外和高风险判断 |
很多公司还停在第 1 级,却已经采购第 7 级的自动化能力。真正的卡点往往是第 4 级:先把脚本从个人电脑迁到能稳定触发、留下日志、处理失败并有明确所有者的服务上。没有稳定运行的服务,多 Agent 之间的交接也无法成为可靠的日常流程。
治理还需要具体的退出规则。Ajzenstadt 建议为每个 Agent 设置寿命,工具超过 100 个时落实生命周期管理,90 天未运行的能力退役,评测低于门槛的能力淘汰。这些是作者提出的管理规则;关键是有人负责停用过期能力,避免废弃 Agent 仍持有可用密钥。
最后要培训操作者、交付操作手册,并把能力嵌入已有流程。人的角色从逐个启动工具,转向验收结果、作出判断和处理例外;每次专家修正再回到黄金集。明确负责人只是起点,团队真正会用、会判断、能持续维护,才完成运营交接。
三个案例说明闭环能做什么,也说明它证明不了什么
Ajzenstadt 提供了三个客户案例。它们可以用来观察前面的闭环怎样运行,却不能直接证明这套方法会在所有企业产生同样回报:客户没有具名,原始基线、完整评测集和第三方复核材料也没有公开。
| 场景 | 闭环怎样运行 | 作者报告的结果 | 不能外推的部分 |
|---|---|---|---|
| 医疗账单拒付查询 | 用客户真实问题和专家答案建立黄金集,六周后由客户产品技术负责人验收 | 首次部署 59/60,拒付案例 15/15;在线数据库结构迁移后保持 97% 正确率,关键问题能对账到分 | Agent 只提建议,由人决定,不写入记录系统;评测集没有公开 |
| 物流平台账单重建 | 第一周不写代码,每项功能先有规格,每次合并前设置人工门 | 两名工程师在 90 天合并 122 个 PR,104 个少于 5 条审查意见,比客户估计早 50% 交付 | 软件开发的输入和验收门相对清晰,证据深度高于许多运营工作 |
| 硬件制造商试点 | 与规模约为 Limestone 十倍的另一家公司并行试跑四周 | 客户 CTO 认定 Limestone 表现更好,并规划先 50/50 共同交付,再到其他十个 Scrum 团队的 80/20 分工 | 没有公开统一量表;“表现更好”是客户 CTO 经作者转述的判断 |
原文也明确承认,企业不可能在一至三个月内完成转型;软件工程的证据最深,因为输入、测试和人工门相对明确。离开软件和简单重复流程后,没有放之四海而皆准的“明显用例”,每一种判断或关系密集的工作都要重新建立自己的基线、黄金集和失败标准。
这些限制没有削弱闭环,反而说明了它的用途:它不承诺事先知道答案,而是让企业用一个可控周期获得足够证据,决定是否继续投入。
真正的复利,是下一个流程不用从零开始
第一个流程的价值不只是一笔可能出现的节省。只要闭环完整跑过,企业会留下四类可以直接带进下一次试点的资产:
- 上下文层:数据定义、所有者、敏感级别和跨部门边界已经明确。
- 评测框架:黄金集、失败类别、路由逻辑和质量门可以扩展。
- 托管基础设施:调度、日志、回退、安全审查和成本上限不必从零搭建。
- 业务所有权:操作手册、审批关系和负责人已经进入日常运营,专家修正还会继续回流到黄金集。
模型会更换,今天流行的 Agent 框架也可能在下个季度被淘汰。工作流知识、评测标准、托管能力和运营责任却仍属于企业。正因为这些资产会保留下来,第二个流程才能从第一个流程已经达到的位置出发。
从客户正在等待、抱怨或流失的地方找出 3–5 个候选项,用五个视角选一个;在开发前明确权限、责任、基线和评测,用真实数据并行试跑 2–4 周;让吞吐、质量和经济性共同决定继续、调整、停止或扩展。证据支持扩展后,再完善生产运行与交接,把每次证明留下的资产带到下一个流程。
下一笔 AI 投入
先过证据这一关
Limestone 创始人 Mark Ajzenstadt 与 20 位私募运营合伙人交流后发现:企业已会用 AI 写邮件,却常卡在影响客户结果的真实流程前。
能演示 ≠ 值得部署
缺少流程边界、预设标准和去留决定,试点就难以跨进日常运营。
开发前,先走完两站
权限、数据归属和负责人,从起点明确。
01 选一个流程
从客户等待或抱怨处向内找;没有真实用户、数据、基线或所有者,就淘汰。
02 先签验收标准
约定当前表现、测量窗口和失败底线;用客户专家确认答案的真实任务建立黄金集。
03 并行试跑 2–4 周
真实数据,与旧方式同时运行。AI 提建议,人作决定;暂不写入记录系统。
吞吐
处理量 · 周转时间
更快不等于更好
质量
返工 · 关键失败
平均分不能盖住重大错误
经济性
价值减去全部投入
省下工时不能直接当现金
按预先约定的标准,共同决定
继续
保持当前范围
继续积累证据
调整
修改方案
返回试跑
停止
保留证据
停止追加投入
调整实现,不因结果差就降低门槛。
下一个流程,从已有资产出发
扩展后补齐稳定托管、持续评测、回退与成本上限,完成操作培训。留下的上下文、评测、基础设施与业务责任,带入下一次试点。
情景示意,非真实客户故事。方法来自 Mark Ajzenstadt;不承诺普遍收益。
演示结束后,客户还在等
AI 演示做出来了,客户却还在等。
只选一个流程:真实用户、数据、负责人,还有写清的非目标。
基线 · 黄金集 · 失败标准
先签基线和测量窗口;客户专家确认黄金集与失败标准。权限从起点明确。
吞吐 · 质量 · 经济性
并行试跑 2–4 周:Agent 提建议,人决定;暂不写入记录系统。
共同按原先标准决定。调整方案再验证,不能因为结果差就降低门槛。
若证据支持扩展:完善稳定托管、持续评测、回退、成本上限和操作培训;把上下文、评测与运行经验带入下一流程。
the AI transformation loop

In the last six weeks I've spoken with 20 PE operating partners about AI inside their portfolio companies.
The specifics are confidential, but the pattern repeats.
Most portcos use AI for email drafts and meeting notes, and most of the partners couldn't describe what comes after that.
The few pushing into claims, underwriting, or revenue operations hit the same wall: a demo takes a week, and proving it runs at production quality takes six months.
The survey data says the same thing.
Gallup asked 22,573 US employees in May 2026 what they use AI for. Writing and editing came first at 51%, search at 49%, and automating a process at 16%. Harvard Business Review Analytic Services found in April 2026 that 18% of organizations have AI integrated into their workflows. The rest are drafting emails.
The companies that failed at this ran AI like a consulting program.
They ran a long diagnostic, drew a target architecture, projected ROI on assumptions, and spent 18 months on integration before anyone measured a dollar. The last step on that roadmap is a final presentation.
The companies that shipped ran it as a loop.
They picked one workflow with real users, real data, and an outcome the business tracks, proved the smallest useful slice in two to four weeks against a measurement they built before the agent existed, and then made a decision.
This is the loop, written down so an operating partner can hand it to a portco CEO instead of a deck.
Why the portco can't hand you a use case
The people running a portfolio company were running it before AI.
They have clients to service and relationships to protect, and those clients aren't asking for AI by next quarter, so the week looks like last week and the team has no reason to stop.
Ask them for a list of AI use cases and you get a shrug, because you've asked them to stop running the business to answer you.
Accordion's 2026 benchmark asked 150 operating partners about AI in their portfolio companies' finance functions.
17% of the portco CFOs had claimed AI as a strategic mandate with budget and board visibility. 34% were still evaluating, 31% were piloting specific workflows, and 41% of the partners said they were scaling AI across the portfolio with no operational playbook.
The barriers they named were data infrastructure at 71%, talent at 63%, and legacy technology at 58%.
Gartner's April 2026 survey of 782 infrastructure and operations leaders found the same shape from inside the company.
28% of AI use cases fully succeed and meet ROI expectations, and the 77% of leaders who had at least one success credited integrating AI into existing workflows and securing full support from business executives.
The operators know where the process hurts.
Microsoft's 2026 Work Trend Index, 20,000 workers, put 67% of AI's measured impact down to organizational factors rather than individual skill, and found only 26% of AI users say their leadership is aligned on an AI strategy.
The operators need a way to look at their own operation, and the sponsor needs to own the accountability. That is what the five lenses are for.
How to look at a portco: five lenses
You go looking in one of two ways: you cut cost around the slow people, or you make the smart people faster. Both stay inside the building, and neither tells you where to start.
Start with the customer and work inward.
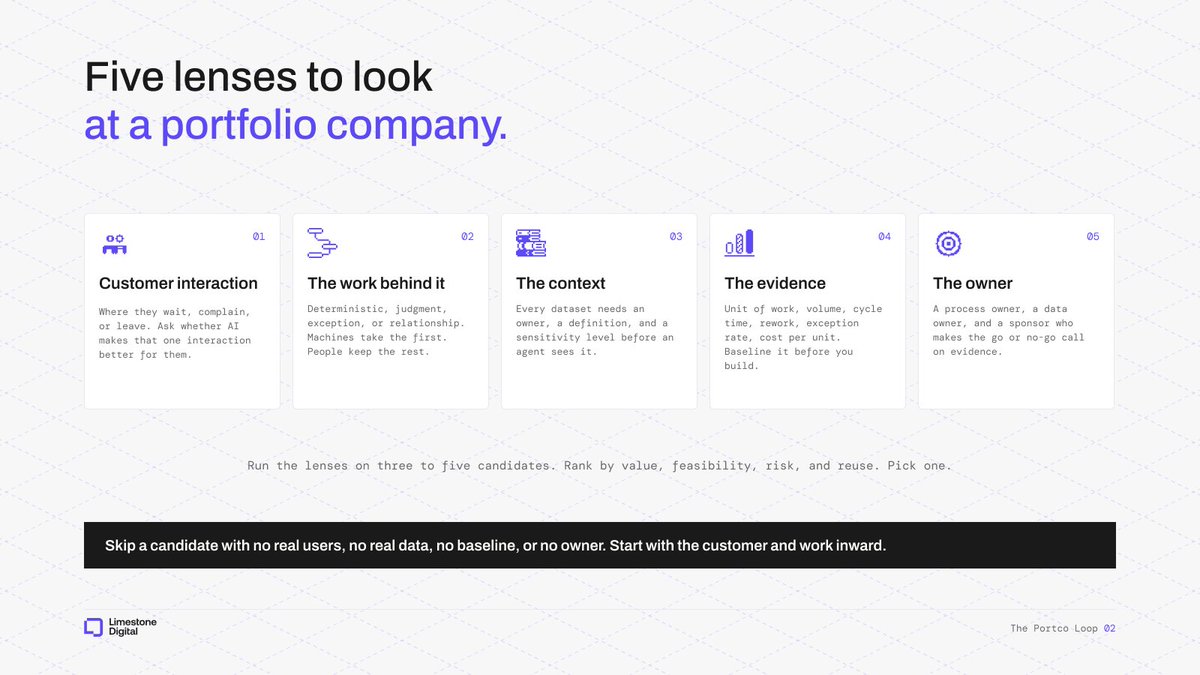
1. The customer interaction.
Find the interaction where the customer waits, complains, or leaves, and ask whether AI would make it better for them. The answer takes one of three shapes: an insight the customer didn't have, a process that runs in minutes instead of days, or a product that improves between releases. Onboarding is the interaction most companies underrate.
Encompass surveyed corporate treasurers in April 2026: 96% had abandoned a bank application because of how long it took, and 97% were considering switching banks over KYC friction.
OnRamp's 2026 onboarding report found 57% of customer-success leaders say onboarding friction hits revenue directly, and the teams that digitized onboarding cut time to value by 25% or more.
2. The work behind it.
Walk the process and sort the steps: deterministic, judgment-heavy, exception-driven, or relationship-dependent. Machines take the deterministic steps and prepare the judgment ones. People keep the decisions, the approvals, and the exceptions. If most of the work is judgment or relationship, save it for a later workflow.
3. The context.
Find where the truth lives, who owns it, and what it means. Every dataset in the workflow needs an owner, a definition, and a sensitivity level before an agent sees it.
Our delivery team puts context at 80% of an agent's success. If no one in the building can define the fields, defining them is the first deliverable.
4. The evidence.
Check whether you can measure the workflow today: unit of work, volume per period, cycle time, touch time, rework, exception rate, and cost per unit. Without a baseline you can't prove the change, and the sponsor won't fund a second workflow on a change you can't prove.
5. The owner.
Name who runs it after we leave: a process owner, a data owner, and an executive sponsor who will make a go or no-go call on evidence.
A workflow with no owner doesn't qualify.
Skip a candidate if it fails any of these: no real users, no real data, no baseline, no owner, or the ask is "redesign the organization." Two categories are obvious and don't need the lenses: software development, which is construction with a gate at every step, and work so repetitive a script could do it. Past the obvious, run the lenses on three to five candidates, rank them by value, feasibility, risk, and what they'd let you reuse next, and pick one.
How to do it: ten steps
1. Pick one workflow, one sponsor, one outcome, and the non-goals. Choose real users, real data, and a number the business tracks, and write the non-goals down, because the team will add scope in week two.
2. Walk the workflow with the people who run it. Collect representative cases, the exceptions, the permissions, and the expert judgment no one wrote down. Interview before you inventory: ask who owns each dataset and what it means before anyone reads the code.
3. Sign the baseline before you build. Agree volume, cycle time, touch time, quality and rework, exception rate, operating cost, and the measurement window, and have both sides sign it before the pilot, because a baseline written afterward measures nothing.
4. Build the evaluation harness before the agent exists. Assemble a golden set of real cases with outcomes the client's own experts agreed on, and add the failure classes that matter in this operation: wrong numbers, protected data exposed, false confidence about missing data. You can't trust a measurement you build after seeing the answers.
5. Ship the smallest useful slice on real data in two to four weeks. The agent proposes, a named person decides, and it writes to no system of record yet. Run it in parallel with the old way, and make sure every run leaves a trace someone can read.
6. Measure three numbers. Throughput is units completed per period and cycle time. Quality is first-pass acceptance, rework, overrides, and incidents. Economics is run cost per unit against verified capacity value, avoided rework, incremental output, and risk-adjusted avoided loss, minus cloud, model, support, and change costs. Report a range, and count hours saved as cash only when someone agrees where the cash shows up.
7. Decide together. Continue, adjust, stop, or expand on the evidence. If the numbers don't clear the baseline, stop and keep the budget. That outcome cost four weeks instead of four months.
8. Harden. Add evaluation on every change, a security review, observability, integration, fallbacks, cost caps, and a host that isn't someone's laptop. Put role-based access on every knowledge structure and a lifetime on every agent, so a dead agent doesn't survive as tech debt with a live API key.
9. Transfer ownership. Embed the capability in the workflow, train the operators, hand over the runbooks, and name the owner. Operators stop pressing buttons and start judging, and every correction they make goes back into the golden set.
10. Pick the next workflow with what you now have. The context layer, the harness, the hosting, and the governance all carry over, so each workflow reuses more of the last. That is the ladder from tool adoption to an org that runs on agent output, and you climb it one proven workflow at a time.
The ladder has seven rungs, shared below.
AI Adoption Ladder
There are seven main steps for your company to go from tool adoption to agentic org.

Step one: tool adoption. AI tools exist across the org, humans run each one. Developer closes the lid, automations die. Somebody goes on vacation, the workflow goes with them.
Step two: context layer. Knowledge graphs per department, each behind its own API gateway. Sales queries engineering through an API. Separated domains keep agents from hallucinating across departmental boundaries.
Step three: harness engineering. Build evaluation criteria, routing logic, and quality gates before you pick a model. The LLM comes in last. Your harness is your IP and your capex. The model underneath is a commodity you swap when something better ships. If changing the LLM breaks your system, you built a dependency, not a platform.
Step four: go headless. Host every automation outside a laptop. It fires on schedule, on conditions, without a human logging in at 9 AM. Companies stall here because nobody forces the migration from "script on my desktop" to "service that runs on its own."
Step five: governance. RBAC on every knowledge structure from day one. TTL on every agent. Dead agents are tech debt with active API keys. Past 100 tools, you need lifecycle management. Retire anything that hasn't run in 90 days. Deprecate anything whose eval scores drop below threshold.
Step six: agent-to-agent. Stitch headless instances together within a value chain. Agent A finishes, hands off to Agent B. An LLM sits between them as a quality gate, judging every handoff before it passes through.
Step seven: step functions. Orchestrated, semi or fully automated workflows. Agents handle volume. Humans handle exceptions. The org runs on agent output.
Most companies sit on step one, shopping for step seven technology. They need step four discipline.
What it takes from the portco
The proof month asks for an executive sponsor for 30 minutes a week and a go or no-go at the gate, a process owner for two to four hours a week in walkthroughs and acceptance testing, and a data owner for one to three hours at the start.
Our AI velocity pod is one FDE with agents plus a fractional architect, at $15,000 to $20,000 a month.
On the last operations agent we shipped, the infrastructure ran at $250 a month across four client datasets.
Our terms are the same for every portco: no discovery fee, month to month, and if you're not impressed at the end of the month, you don't pay.
Every activity in the month produces one of four things: a decision, a tested assumption, a working increment, or a reusable asset.
If it can't, it doesn't get your time.
What the loop has produced
A healthcare billing platform showed us how they worked before we touched anything. Their clients ask one question about claim denials more than any other, and the answer has to reconcile to the penny.
Six weeks from kickoff their chief product and technology officer was running acceptance tests against an agent that answers it. It scored 59 of 60 on the eval set at first deploy and 15 of 15 on the denial cases.
After a live schema migration it held 97% correctness, and the flagship question reconciled to the penny. The golden set came from the client's own questions, with their experts as the ground truth.
The agent advises, a person decides, and it writes to no system of record.
On a logistics platform's billing rebuild, two engineers merged 122 pull requests in the first 90 days, 104 of them with fewer than five reviewer comments, and delivered 50% ahead of the client's own estimate. Software is the obvious case, and we ran the loop there too: no code in week one, a spec before every feature, a human gate before every merge.
A hardware manufacturer's CTO ran our four-week pilot next to a second pilot from a firm about ten times our size. Four weeks in, he said ours was doing the better job, and he set the next phases himself: 50/50 with his people embedded, then 80/20 across his other ten Scrum teams.
The honest limits
The 2026 numbers on AI payback are consistent, and they are not kind.
McKinsey's August State of AI puts enterprise EBIT impact at 37% of companies, flat on the year, while 80% report individual productivity gains. KPMG's June pulse of 2,145 leaders found 49% had scaled back, narrowed, delayed, or paused agent deployments after costs outran value, and 7% had established ROI.
Gartner's April survey named the reason most leaders gave for their failures: they expected too much, too fast.
Bain's 2026 Global Private Equity Report sets the clock. A deal now needs 10 to 12% annual EBITDA growth to return 2.5x over five years, against 5% in the 2010s, and holding periods at exit hover around seven years. In FTI-Andersch's April survey of portfolio AI programs, 38% expected returns within 7 to 12 months and 31% within 13 to 24.
In Bain and StepStone's outlook, 39% of general partners expect no material financial impact from AI on their portfolio companies this year. A business does not transform in one to three months, and a sponsor who plans for that will fund a deck.
Two more limits.
Software is where the evidence runs deepest, because software development is construction: requirements in, tested code out, a gate at every step.
Our own pod on the billing rebuild merged 122 pull requests in 90 days and delivered 50% ahead of estimate.
The same 2026 data shows the price of skipping the gate.
Faros AI's April telemetry across 22,000 developers found task throughput up 33.7% while bugs per developer rose 54% and incidents per pull request rose 242.7%.
Outside software, the obvious case is work so repetitive a script could do it, like support answering the same questions, and even the obvious case plateaus.
Past the obvious cases there are no obvious answers, and anyone promising you one across eleven portfolio companies hasn't done it.
The loop compounds because you keep what each workflow builds.
After each proven workflow you keep the context layer, the harness, the hosting, and the owner, and you start the next one higher.
Models will change, and the vendor will deprecate this quarter's framework next quarter.
The workflow knowledge, the evaluation criteria, and the operating ownership your team builds while proving the first slice stay with you.
Instead of the deck
Hand the portco CEO this page.
It has five lenses to find the workflow, ten steps to prove it, and one decision at the end.
Book a free discovery call
One 30-minute call, not a discovery quarter.
Bring the workflow you'd start with, or the portfolio company you can't get moving. We run the five lenses on it live and tell you whether it qualifies.
If it does, the month starts on our terms: no discovery fee, month to month, and you don't pay if you're not impressed.
Book a discovery call: https://meetings-na2.hubspot.com/mark-ajzenstadt
— Mark Ajzenstadt, Founder @LimestoneHQ