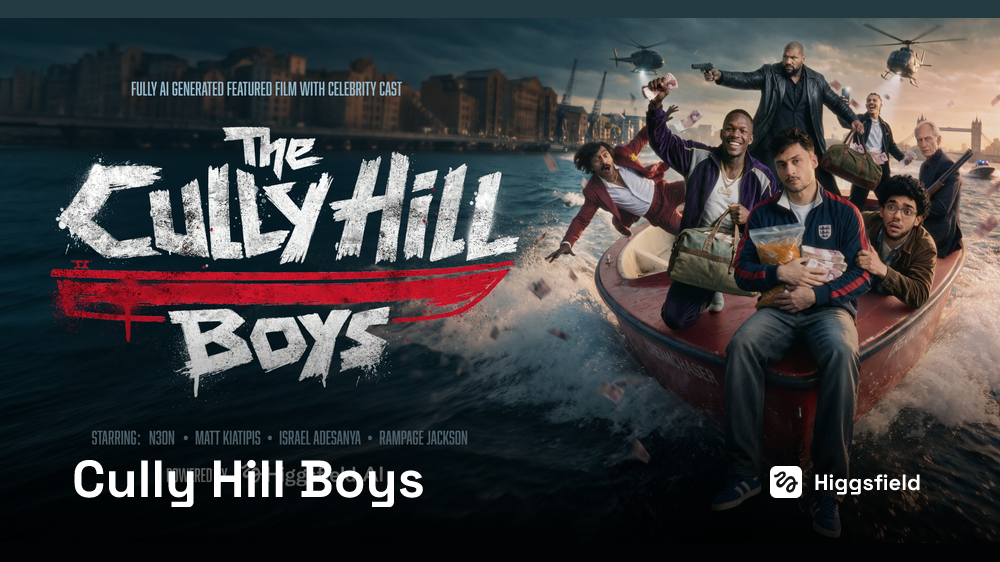
Higgsfield 使用真人演员形象 用 AI 拍摄了一部 110 分钟的完整故事影片 并公开了整本制作说明书和提示词方法
- 一部 1 小时 54 分的 AI 长片,把整套制作方法连同自用的三个 Claude 技能一起公开了。
- 整本手册只对付一件事:视频模型没有记忆,所以「让同一个人还是同一个人」就是全部工作。
- 最值钱的是那些反直觉的禁忌,设定表不许写 studio、全身图要去掉头、提示词不许写「不要」。
一部 AI 长片,把整本制作说明书公开了
过去两年,AI 视频基本停在几秒到几十秒,大家比的是画质、运镜和单个镜头够不够惊艳。Higgsfield(做 AI 视频生成平台的那家)这次拿出来的是另一种东西:一部 110 分钟的剧情长片,四位真人演员授权了肖像和声音,制作周期 4 周,成本 200 万美元。
他们同时还做了第二件事,对外宣布整部片子 100% 开源、所有提示词和资产现已公开。本站逐项点开核对下来,可直接下载的是三个 Claude 技能文件,其余材料分散在项目页正文和那张画布里,具体差在哪,文末那节写清楚了。
片子叫《The Cully Hill Boys》,动作喜剧,讲伦敦三个不得志的说唱歌手为了出名,误打误撞卷进一场毒品火并,8 月 5 日在纽约首映。
下面拆的是随片放出来的那份东西:一份完整的制作说明书。资产怎么建、提示词怎么写、表演怎么调、说唱段落怎么对口型、后期怎么盯梢,一路写到底,连他们自己用的三个 Claude 技能文件都给下载。

每一帧都是生成的,没有布景也没有摄制组,四位演员本人没有参与任何一次实拍,他们贡献的是被授权数字化的肖像和声音。全片只有一处例外,后面会讲到。
用什么做的:五个工具各管一段
全片的镜头、视频和人声,都在 Seedance 里生成。人脸和角色设定表交给 Soul Cinema。剪辑、反打镜头、视点变化用 Seedream 和 Nano Banana。
提示词全部由 Claude 写,而且刻意开两个聊天,一个只写图片提示词,一个只写视频提示词。理由是:一边的规矩会污染另一边。写图片那边需要平光、需要专门躲开 CG 味的措辞;写视频那边需要用度数写视场角、需要每一处光都有来源。混在一个聊天里,两套规矩会互相串味。
三个技能,按用到的顺序排
他们把常用规则打包成了 Claude 的技能,一份规则手册,Claude 自己加载,然后照着它干活。三个技能的 SKILL 文件都放出来了,文件名点开就能下(本文末尾也再列了一遍)。
另外四条,是从上一部片子里带过来的
这个团队之前做过一部叫 HELL GRIND 的片子,那次是一边做一边摸索出来的,这次开工第一天就已经在手上:
- 场景上下文:每个镜头开头先写清楚这一段戏剧上在发生什么、谁在场、多长。
- 首帧空间锁:第一帧就已经占好位,所有人各就各位,不要那种空荡荡的定场拍子。
- 每句台词后留一秒静音:片段内部留一条干净的尾巴,剪辑师得到一个接缝,而模型也没有空档去编造声音。
- 表情和表演逐拍写:脸和身体一拍一拍地写,不用形容词打发。
但所有规则都在对付一件事:模型没有记忆
这本手册厚成这样,起点却只有一句话:一致性就是全部工作。
视频模型没有记忆。你把人物描述得不全,下一个镜头他的长相、行为、声音就都变了。再加上空间会在镜头移动时散架、声音在片段之间漂移、场面丢掉方位关系,这些加起来,就是 AI 拍长片一路要对付的东西。
他们的基本盘是一句话:每个镜头由「参考 + 文字」生出来。资产负责画面,文字负责其余一切,包括几何关系,谁站在哪、机位在哪一侧、光往哪个方向打。
还有一条更硬的约束贯穿全片:只用文字生成视频,不给首帧,也不做图生视频。这条更难,但正因为如此,镜头之间才剪得到一起。
全片唯一一次破这条规矩,是凯迪拉克车里那场争枪的打斗:两个人一直在接触、抢同一把枪,生成出来的结果是四肢缠在一起、枪在这只手上消失又出现在另一只手上。最后他们请了特技演员编排动作,在真车里用手机拍了一天,把这段素材当运动参考喂进去,模型再把角色、内景和灯光叠上来。一天的手机素材,省掉了一周的反复重试。
一对东西:一段逐字进每条提示词的文字描述,加一张给模型锚定的参考图。角色、场地、道具各自都是资产。
像剧组的定妆照加人物小传,照片管长相,小传管性格和穿着,两样一起交给每个新来的摄影师。
而开拍前先把剧本拆成卡片
他们的拆本是把剧本变成一份已经把导演阐述装在里面的预备分镜表,而不只是列出要做哪些东西。每个镜头一张卡,卡上分四组。
| 卡上分组 | 写什么 |
|---|---|
| 素材 | 场地和内外景,以及覆盖它的那个资产;一天中的时间(因为它决定用哪个资产变体);画面里每个人,带标签和状态;道具车辆带标签;动作用一到三句话;台词逐字;时长多少秒;复杂度是简单、中等还是复杂 |
| 导演 | 本镜的目标,一句话;角色的任务用动词写,盘问、揭穿、羞辱;起止之间什么变了;相对摄影机的走位;表演上脸和身体做什么、角色在藏什么 |
| 摄影 | 景别、运动、镜头、角度 |
| 剪辑 | 用什么方式切、节奏多快、怎么接上下一个镜头 |
每张卡带着场次号加一个镜头字母,比如 50B、50C;同一个编号从卡片一路跟到版本日志和提示词文件,相邻两个镜头就永远不会被搞混。
这份版本日志最后记了 137 条,里面能看出哪些镜头反复重来过,最难的几个改到了 v15、v10、v9。没有这份记录,一个好镜头没法复现,也不知道某个修法自己是不是已经试过。
卡片填完,提示词几乎是机械地抄出来的。更要命的是窟窿会在花掉一次生成之前就露出来,一个没有目标的镜头、一个没有任务的角色、一场没有对应资产的戏,在卡片上一眼就看得见。
所以资产没锁死之前,一个镜头都不许拍
600 个审定资产的分项是这样的:主角和反派 74 张卡,配角与动物 52,只出现一两场的群众角色 90,道具 159,场地底图 200 多张。
状态本身就是资产。干净夹克的 Cal、落水湿透的 Cal、第三幕眉骨裂开血污的 Cal,这是三个资产,而不是一个资产后面加一句备注。
做新状态的办法也定死了:拿原来那张设定表,只改变了的部分,换身衣服、加道伤口、把布料弄湿,其余一律不动。这样皮肤质感才活得下来,因为整张图从来没有再完整过一遍模型。而且新版本不覆盖旧的,各有各的名字和版号。
场地照此办理,白天、夜晚、下雨是三个资产;道具也一样,一把枪有两个状态,一辆车的前排和后排内景分开算。

@char_CB_Kel_v9                — 角色、项目代号、名字、版本
@loc_CB_warehouse_s6_v2        — 场地 + 它是为哪场戏建的
@loc_CB_kal_street_s5-46_v3    — 一张底图服务第 5 和第 46 场
@prop_CB_gunTobin_s26_v2       — 道具、场次、版本
@prop_CB_sedan_interior_back   — 车内景算道具,不算场地
所有资产摊在一张画布上,规矩只有一条:资产不在画布上,就不在镜头里。
而设定表上那几条禁忌,都是失败换来的
角色设定表是一张图三格:正面全身、背面全身、一张大特写。特写用四分之三侧角度,一次给到正面和侧面两个方向的信息。
真正值钱的是下面这四条,每条背后都有一个具体的失败。

场地要斜着拍,影调在前期就定死
场地底图一律用四分之三的斜角生成中景或远景,不用正面。正面拍出来的房间像一张平的墙纸,模型读不出空间的进深,画面边缘之外每次都自己乱编;斜着拍它才有体积,人站得对,而且一张图能撑出接近一圈的角度。
- 每个场地留一个锚点,柱子、灯、沙发、一把歪椅子,然后把走位绑在它上面。「人在灯旁边、面朝门」是有效的;「人在房间里」是抽奖。
- 一套光逻辑:一个光源、一个阴影方向,绝不出现两个太阳。底图里不放人,也不放武器。
- 用真实表面的语言对抗渲染感:锈、裂缝、胶带、指纹、油渍、水痕。
还有一招:反打镜头可以从视频里抠出来。生成一段没有人、摄影机缓慢穿过空间的视频,模型会照着你那张底图把房间另外几面画出来;截下你要的角度,拿去 Seedream 或 Nano Banana 提一下质感和光。一张图,出一整套场地。
对话场地需要整套,斜角、正面、反打,还有每个角色各自的背景底图;只是路过的场地,一个角度就够。
影调不留到后期,在建资产的时候就定死
开拍前先写一本视觉圣经,每一张底图都照着它建。全片切成几个「世界」,一个世界一个色域:公屋区是浸透的卡其绿配湿沥青;说唱场景是水泥加一台显像管电视;母亲家是暖白配蜂蜜色橡木;一个老大的俱乐部是牛血红、桃花心木和失了光泽的金;另一个的世界是漆面绯红和镜面黄铜;泰晤士河是黑水;警察系统是灰水泥,一丝暖调都没有。
一个世界内部的画面比例也定死:八成到八成半是基底色,一成到一成半是一两个强调色,剩下大约半成是反调。
它必须是画面里一个有真实光源的实物:一扇绿门、一盏钠灯、一顶橙帐篷、显示器的光。调色调出来的强调色,在下一个镜头就对不上了。
同一个色相怎么区分两个场景?靠质感和年头,不靠色号。两个老大都活在红和金里:老的那个是包浆,干涸的牛血红、失泽的金、一盏旧灯;新的那个是抛光,饱和的绯红、镜面黄铜、一排对称的一模一样的灯。这样写,两个同样奢华的内景才不会看着像同一个厅。

光看着好不算数,要让资产跑十次还认得出
一张设定表本身好看,什么都证明不了。他们的验收办法是拿它去生成视频:跑十次,动作不同、景别不同、场地不同,十次都认得出是同一个人才算过。而且要用真实的提示词跑,让角色跑起来、说唱、打电话、哭、笑。
这才发现,一张脸只在角色平静的时候才稳定。
Cully Hill Boys 项目 brief
两条配套的规矩同样有用:
- 角色和场地必须一起测。两个资产会互相拉扯,单独测角色等于没测,所以绝不能在他的场地做好之前测他。还要和会同框的其他角色一起测,单独立得住的人,常常在双人镜头里崩掉。
- 崩了不一定是提示词的错。画面糊、人物演到一半化掉,同样可能是设定表或场地底图本身太弱。先改词;同一个地方再崩,就回去重建资产。
提示词分十五块,而且不许写「不要」
每个正经镜头都按同样的顺序写十五块,顺序不能乱。
SCENE CONTEXT · ACTIVE REFERENCES · LOCATION MAP ·
FIRST FRAME AND SPATIAL BLOCKING · FORMAT MODE ·
OPTICS · CAMERA · ACTION TIMING · PHYSICS · LIGHTING ·
AUDIO · CHARACTER ACTING · STYLE · QUALITY ·
POSITIVE CONSTRAINTS
末尾那块叫「正向约束」,因为整套骨架里没有否定块。禁止一律要写成期望的结果,「不要仰面摔倒」在模型那儿读起来就是「去想想仰面摔倒」,所以直接写「面朝下摔倒」。
另外两条关于参考的规矩,比什么都更容易毁掉一次生成:
- 每个标签只出现一次,而且只能出现在「启用的资产」那一块里。在提示词末尾又重复一遍标签,是生成直接拒绝启动最常见的原因。
- 场地资产必须显式写明不许继承构图。它只管几何、材质、光和氛围,绝不管画面怎么框。少这一句,模型还给你的就是一张近似复制的底图。
拿一条真提示词看,四个能直接抄的写法
官方挑了片中一条走廊戏的提示词做讲解:Oli 在画面外踹门,Cal 和 Horace 在画面里看着。这一条里有四个装置值得单拎出来。
还有一个容易被忽略的上限:一次生成最多带 9 张图、3 段视频、3 段音频参考。这个数直接决定了一个镜头里能同时出现几个有名有姓的角色。
光学用度数不用毫米,再用一秒远景钉死空间
画面横向能装下多大范围,用角度表示。角度越大装得越多、越像广角;角度越小画面越窄,远处的东西被压得挤在一起,也就是长焦的味道。
像从门缝看房间还是把门整个推开,缝越窄,看到的范围越小。
他们把镜头写成度数而不是毫米,用十档锚点:
180° · 135° · 107° · 84° · 63° · 47° · 29° · 18° · 12° · 8°
道理讲得很透:模型并不服从你写的那个数字,它是从画面里有什么反推镜头的。所以 135° 上的细节会垮,8° 上的人群会垮。而且镜头必须每个镜头单独钉死,否则它会一路滑回舒服的中间值。
用一秒钟把空间钉住
每场戏以一个 master shot 开场,固定走位的远景,大约一秒,没有台词也没有动作。模型把这个布局「拍」下来,在本场后面每个镜头里保持住。去掉这一秒,人物就开始换位置。
两个小窍门:让某人在这一秒里出一个短音(比如「嗯」),模型更容易把这个远景当成正经镜头;如果这场戏是在回应上一场,把上一段台词的尾巴喂进这第一秒,演员的语气和内容就接得上,两个片段在接缝处能粘住。
远景下面还压着一张空间地图,几行字的平面图,每场写一次,逐字贴进本场每一个镜头。它治好了早期最贵的毛病:人物瞬移、互相换位置、摄影机突然跳到房间另一边。
写法上有个反直觉的点:位置要绑在看得见的东西上,不能绑距离。米对模型没有意义,「在英雄左边」更没有意义,因为它压根不知道英雄在哪。
正确的写法是把每个人拴到一个它能在画面里看见的地标上:灯、第二排椅子、舞台边缘、门。再用「画面左 / 画面右」说方向,并写清摄影机在哪一侧、哪条线绝不跨越。
一张空间地图大致长这样:先定一句「摄影机永远在窗户这一侧,这条轴线不跨越」,再说清舞台在画面深处偏右、红色安全门紧挨着舞台、椅子排铺满中间朝向舞台;然后把每个人钉到看得见的东西上,某人站在第二排椅子旁、离过道一臂远,某人在舞台边缘、离安全门一大步,某人在调音台边;最后补一句「场内正好三个人,其余全空」。
还有一条经验:当生成结果和真实场地矛盾时,回去读那张资产,别再读提示词。他们有场笼式足球的戏,连着好几版都攻错了半场,原因是写提示词的人凭记忆写的。
而规则要写成法律,得能判废镜头
前面提到提示词库里有约 150 条命名锁。一条规则要够格叫「法律」,得同时具备三样:有名字、在画面里有看得见的证据、有一句话说清什么算废镜头。他们那些锁里,大约有 80 句是以「= 废镜头」收尾的。四条最常用的:
几个救活过镜头的具体办法
- 复杂动作绝不放在时间轴中间。那扇门怎么都踹不开,生成出来是主角在门边磨蹭然后僵住。改成让动作直接开篇:「他已经在挥腿的中途,门已经在裂」,而助跑的部分另起一个镜头。
- 人群算一个资产,给一个身高和服装的范围,再单独给一两个领头的群众配自己的资产供特写。超过十五个人,人群会塌成三到五个,所以拥挤的房间要写成「身体挤在舞台边缘、手臂在前景」,绝不写具体人数。
- 车内景是独立资产,跟车本身、跟场地都分开,是整个项目里最可复用的东西之一。
- 模型反复画你没要的东西,就点名禁掉。他们那张铁路底图老是自作主张变成一座车站,于是写一条锁,把站台、雨棚、成排泛光灯、停着的列车逐项列为「不存在」,再补一个确切的轨道数,就治住了。
表演不写形容词,写肌肉在干什么
写「悲伤」「愤怒」「震惊」,模型只会即兴发挥,给出来的东西浮在表面。要拿到深的东西,得写肌肉在干什么:颤抖、下颌咬紧又松开、颧骨绷紧、鼻腔里轻轻呼出一口气。肌肉之上再加一句标注为不说出口的内心独白,模型会从这句话往回推微表情,脸就开始在台词之间活着。
那句内心独白长什么样?比如同一个镜头里,一个角色标注的是「这屋子曾经就是我的全世界」,另一个是「别让他们看出来这事对我有分量」。「怀旧」「嫉妒」「难过」这些词一个都没出现在提示词里,但模型从这两句话往回推,一个人的脚步会在看到舞台时停住、手上的小动作死在半途,另一个人先摆出打量全场的架势、眼神却在舞台上多停了半秒。
更上一层是行为代替情绪:一场活的戏是「角色想要什么、有东西挡着、他动手去拿」。而且要让他在一场戏里换打法,开玩笑,失败了;施压,又失败;最后乞求。每次转变都得是看得见的事件:一个停顿、一次姿势变化、一次节奏变化。从头到尾只做一件事的戏,一定是平的。
声音也是同一个路子,而且声音不算资产,它是一组在写对白之前就定死的条件:音区、音色、语速、口音、腔调。一个角色的声音块大致是「二十五岁英国男性,松弛的中音,语气随意像没排练过,南伦敦街头口音,吞掉 h、喉塞音的 t、-ing 读成 -in',带一点怀旧的暖意」。
这段话此后逐字贴进每一条提示词的音频段落,连同义词都不换,换个说法就等于放宽了模型的取样范围,声音会漂。他们全片没有做过声音克隆,也没有重录。
还有两个手法,动作小但管用。一是把眨眼写成分阶段的:一次慵懒的眨眼,接一次快速双眨,再来一次用力的重置眨眼,比只写「他眨了眨眼」出来的东西活得多。二是静态镜头里每隔一两秒必须有一个看得见的微事件,因为写「没人动」会把画面本身冻住;静止要写成「绷住的张力」,不是写成没有动作。
所有角色都有一项默认设置,叫 eye-life:微小的眼球跳动、指名道姓的注视目标、真实的眨眼频率、活的眼神光。克制型的角色眨眼少而慢,那是选择的静止,不是死盯。

他们给了三个判断镜头活没活的标志,都能当场对照:
- 反应在对方话没说完时就开始。听的人中途就听懂了,脸已经在回答。重要事件之后,还要给他零点几秒消化再开口。
- 情绪不会瞬间关掉。重场戏之后呼吸不匀、手不稳,这个尾巴带进下一个片段,正好把两处剪辑点缝住。
- 手一直在忙。角色不是在「聊天」,他在修东西、数钱、倒水、把椅子摆正,一边干一边说。而一场戏最强的重音,就是这只手因为他刚听到的那句话而停下来的那一刻。
说唱段落的解法是把生成的声音关掉
先说问题:视频模型不会表演你的歌。让它说唱,得到的是一张嘴对着空气动;让它自己生成音乐,要么直接拒绝,要么给你一段剪辑里根本没法用的东西。
所以音乐一步都不经过模型。整套做法是五步:
几个细节决定成败。歌必须是录完混完的成品,完整段落、真人声、终混,因为嘴要锁到一段具体的波形上,拿占位小样是不行的。切块要落在人声的换气处,绝不能切在词中间,块与块之间才能在剪辑里对上。
最关键的是第四步。在设置里把生成的音频关掉:人声照样驱动对口型,因为嘴型本来就是从波形建的;但回来的片段是静音的。
片段静音,版权检测就没有东西可抓,也就不会把这一条拦下来。音乐留到剪辑里铺回静音画面下面,本来它也该在那儿。
老老实实解释工作流:「这是音频指南,仅用于同步」。每句都是真话,模型却完全不买账。
只说一件事:这就是那首歌,他正在唱它。不解释流程,不说「参考」,模型对工作流没兴趣,元描述只会让它困惑。
提示词里还要额外写清「嘴的归属」:每一个听得见的词都属于唱歌那个人;其他人的嘴是活的,大笑、欢呼、无声地喊,但绝不跟着对口型唱歌词。

剪辑边生成边拼,后期还有人专门盯
剪辑没有等生成做完,而是和它并行:镜头到一个拼一个,缺什么直接下单,「这儿要一个手部特写」「这个要再宽一点」。重拍只要几分钟,所以剪辑是在塑造生产,而不是在等它。
两条关于节奏的经验:生成出来的东西节奏几乎总是偏慢,所以下手要比感觉上更狠;另外计划好裁掉每个片段头尾各半秒,因为边缘总会漂。
定剪之后是单独一遍打磨。个别镜头需要逐帧修,招牌上的字、车牌、只在大银幕上才看得出的小瑕疵。真正坏掉的镜头不修,重新生成:从存下来的终版提示词改一行,这件事只有在提示词库完整、有版本记录的前提下才做得到。优先级第一位是脸和手的特写,全部在调色之前完成。
看片盯梢是一份独立的工作,不是一种指望。有人专门盯着已经拼好的片子,找那些「技术上存在、但就是不成立」的镜头,晚了一拍的眼神、读起来别扭的手、第三秒开始漂的脸,然后带着指名道姓的修法退回去。
理由是:漏到银幕上的垃圾镜头,代价是名声;在装配阶段抓到的,代价只是一条提示词。
调色的第一步是统一:每次生成都自带一套自己的影调,调色师得先把相邻镜头拉到同一个 look 上。而 look 本身在前期就烤进了场地资产,所以调色是在精修,不是在发明。
台词一句都没有重录,人声直接从生成结果里清理出来,降噪、把片段之间的音色拉平、把声音摆进空间里;只有个别片段实在没有可用人声时才进棚补录。
最后一条:声音设计和音乐建在连续的环境声之上,一层共享的氛围,能把一个个分开生成的镜头粘成同一个空间,哪怕画面本身有漂移。
也正因为如此,每一条提示词里都必须写死一句:只要音效,不要配乐。
而演员的授权,走在第一次生成之前
片中四个角色用的是真人肖像:Cal 是篮球运动员 Matt Kiatipis,Oli 是 UFC 选手 Israel Adesanya,Horace 是主播 N3on,Tobin 是 MMA 选手 Quinton「Rampage」Jackson。
关键在顺序。角色设定表是用合同摄影建起来的,所以表上那张脸就是演员本人的脸,而不是「找个长得像的类型」。此后进镜头的只有这张表。
肖像权和声音权在第一次生成之前就以合同关闭,平台要求确认授权,授权文件在演员出现在任何一帧之前先过合规。

那么公开的到底是什么,去哪拿
「开源」这两个字在这里不是指代码,指的是把这部片子做出来的整套材料。真正能点开就下载的是三个 Claude 技能文件,用的时候按这个顺序:
另外还有那张画布可以直接打开,600 个通过审定的资产按区分组摆在上面:角色设定表连同它们的各种状态、按时间分的场地底图、道具和车辆,旁边还留着团队的批注和那些没被选中的版本。它按幕分文件夹,一幕、二幕、三幕、尾声,各自再按场次拆开(光第一幕就是 36 个场次文件夹),另有一个 PRE PROD 放前期的资产、服装和角色测试,还有一个文件夹专门存重生成的镜头。
要提防一处落差:项目页的「附件清单」写的比实际能下载的多,视觉与配色圣经、五个世界的风格前缀、十档视场角的光学参考、含口音的声音系统、含对口型锁的音乐场景提示词,这些没有做成独立文件,内容写在项目页正文里;那份「每个镜头的完整提示词原文和版本历史」也不是一个打包下载,它散在画布的分幕文件夹里,按场次逐个翻。
上手建议是先拿 CINEDANCE 技能、再打开画布,然后从一场戏开始:一个锁好的角色、一张场地底图、一条提示词骨架。
结果收在五条法则,和一句「一个人也跑得动」
整本手册收在五条法则上:
这里的每一条规则都存在,是因为曾经有一个镜头,没有它就失败了。
Cully Hill Boys 项目 brief
最后他们给了一个判断:这套管线不需要大团队,缩得到一个人。
同一份说明书里出现过剪辑师、调色师、一位专职盯着装配片找问题的人,以及编排那场打斗的特技演员。两头都摆在这儿,怎么算读者自己判断。
成本和工期倒是有数:200 万美元,4 周做完。但这笔钱怎么花的、多少人参与、总共跑了多少次生成,说明书里没有拆开。全片的效果也只有制作方自述,没有第三方复核。
AI 拍出一部 110 分钟长片,制作方把「怎么防止穿帮」的整套手册全公开了
Higgsfield Studio 把《The Cully Hill Boys》的资产、提示词、表演、对口型全套方法摊开,连自用的三个 Claude 技能都给下载
↓ 一页读完 · 有一张会动的图
一部全 AI 生成的长片,随片公开了整本制作说明书
Higgsfield Studio 拍了《The Cully Hill Boys》,一部 1 小时 54 分钟的动作喜剧:伦敦三个不得志的说唱歌手误入毒品火并,8 月 5 日在纽约首映。四位真人演员授权了肖像和声音,画面全部由 AI 生成,没有布景,也没有摄制组。
随片公开的不只是片子,还有一份完整的制作说明书:资产怎么建、提示词怎么写、表演和对口型怎么调,连自用的三个 Claude 技能文件都能下载。
这本手册厚成这样,起点只有一句话:视频模型没有记忆。人物描述写得不全,下一个镜头长相、行为、声音就都变了;空间在镜头移动时散架,声音在片段之间漂移。整套方法,都在对付这一件事。
以上数字均来自 Higgsfield Studio 自己的项目说明,未经第三方复核。
一个镜头 = 资产管画面 + 文字管其余一切
他们的基本盘是一句话:每个镜头由参考和文字生出来。资产负责这个人长什么样,文字负责其余一切,谁站哪、机位在哪一侧、光怎么打,这些几何关系全靠文字写清楚,模型自己推不出来。
所以第一条法则摆在最前面:资产没有锁定、命名、版本化,也没通过压力测试之前,一个镜头都不许拍。压力测试是让资产跑十次视频生成,换不同动作、景别、场地,十次都要认得出是同一个人。
- 全身图去掉头,宽幅上脸小而软,模型会把这张脸复制进远景;去掉后脸只剩特写一个来源,更稳。
- 特写做两版,一笑一不笑,否则角色第一次笑时,模型自己编牙齿和下颌,笑容长成别人的嘴。
- 不写「studio」,模型会真的画出影棚和灯架,还会把主光烤进之后每次生成,改写「没有影棚、没有器材、没有墙」。
- 禁轮廓光,手上必须空着,道具一旦生在设定表里,就再也拿不下来、扔不掉。
提示词分十五块,不许写「不要」;镜头用度数钉死
十五块骨架顺序不能乱,从这场戏在演什么一路写到画质、正向约束。骨架里没有否定块:禁止一律要写成期望的结果,「不要仰面摔倒」在模型那儿读起来就是「去想仰面摔倒」,所以直接写「面朝下摔倒」。
空间也一样:每场戏先用一秒固定远景开场,模型把布局记住,后面镜头才不跑位;远景下面压一张几行字的空间地图,位置绑在灯、椅子这类看得见的地标上,不绑距离,「米」和「在英雄左边」对模型都没意义。
说唱段落的解法:把生成的音频关掉
视频模型不会表演真实的歌:让它说唱,得到的是一张嘴对着空气动;让它自己生成音乐,要么拒绝,要么给一段剪辑里根本用不上的东西。所以音乐一步都不经过模型。
拿走的是整套方法,团队规模和成本没说全
手册收在五条法则上:资产优先、每次完整描述、一次只改一样、给模型更少自由;同一个镜头改了十几二十次还不成,问题通常出在镜头本身,拆成两个、去掉一个动作、换角度。
四个角色用的是真人肖像和声音:Matt Kiatipis、Israel Adesanya、N3on、Quinton Jackson,授权在第一次生成之前就以合同关闭。
小互刷到一条新闻
110 分钟,全 AI 生成
8 月 5 日纽约首映,没有布景没有摄制组
真人演员
只出了肖像和声音
随片公开的
是一整本失败手册
小互翻开说明书
这镜头写漏一句
下镜头他就变成别人
资产管画面
文字管其余一切
小互画设定表
脸小会被模型
复制进远景,越描越花
咚
设定表还不许写「studio」,模型会把灯架焊死进每一镜
说唱那场戏最难
生成时
把音频关掉
口型照样对得上,嘴早从真人的波形里建好了
小互合上说明书
每一条规则背后
都有一个失败的镜头
同一份手册里,还站着剪辑师、调色师、看片盯梢的人
效果与成本均为 Higgsfield Studio 自述,没有第三方复核
終
小互解读站 · best.xiaohu.ai