如何用决策模型给 AI 做自动化质检:六款模型实测
默认 0.5 为什么会漏检?用租赁 Agent 的真实记录,讲清报警阈值、模型选型与概率校准。
如何将决策模型(Decision Models)用作 AI 自动化评估工具(Evals)?
通常评估一个 AI 系统(比如客服对话、工作流)表现好坏时,一种常见做法是让一个调用成本较高的大语言模型充当“裁判”(LLM Judge)来打分。而决策模型及相关分类接口(如 TypeSafe Jev、Perplexity Decider、Liquid d1、Cloudflare Clef、OpenAI Decisions API 等)把任务聚焦于分类与判断,直接输出一个“是否出错”的概率分数,主打以更低成本、更快速度完成这类评估。
解决了什么问题与行业痛点
-
大模型裁判成本高、速度慢
使用 GPT、Claude 等大语言模型逐条检查客服对话、工作流时,调用费用与等待时间会随着评估规模累积。决策模型主打压缩这类判断任务的推断开销与延迟,降低大规模自动化测试的门槛。
-
盲目使用默认阈值(0.50)导致性能浪费
直接拿官方默认的 0.50 分数作为切分合格与失败的阈值,可能漏掉大量错误。如果某个模型将所有失败样本打分为 0.40、合格样本打分为 0.10,用 0.50 就会漏掉所有错误;把阈值调到 0.30,却能把两类样本完全分开。有时不用换模型,只要根据实际业务调对阈值,就能显著改善评估结果。
-
模型输出的概率“不可信”
模型输出“0.80 的失败概率”,并不意味着真实世界中就有 80% 的概率会失败。这个数字是否可信,需要用实际结果检验;不能不加检验地直接当作置信度使用。
什么是决策模型
假设系统要对一段客服对话做自动化质检:程序向模型输入完整对话记录,并附带明确问题“助手是否未按规定转接人工”。决策模型及专用判断接口把任务收紧到预先定义好的问题,直接返回程序能用的结构化结果:该条件成立的分数、从给定选项中选出的类别,或按既定标准给出的评分。程序随后按业务规则处理:比如分数达到报警阈值,就把这段对话送入人工复核队列。模型负责判断,程序负责决定下一步动作。
这就是决策模型充当 Evals 裁判的逻辑:它本质上是嵌入代码中的分类、选择与评分组件。虽然各产品底层不同——例如 Jev 是专为结构化决策打造的模型,OpenAI Decisions 则是 GPT-6 Luna 的判断接口——但它们都让程序可以直接使用判断结果驱动业务。
从公寓租赁 Agent 的 98 条生产轨迹说起
为了检验决策模型在实战中的表现,机器学习评估专家 Hamel Husain 与 Antaripa Saha 调取了真实部署中的公寓租赁 AI 客服助手日志。
该 Agent 通过电话和即时通讯处理租客业务,包括预约看房、确认取消、转接人工客服等。评测任务是进行二元判定:判断某次对话轨迹中,AI 助手的行为或工具调用是否存在实质性故障。
评测数据集共 100 条记录,在排除 2 条内部 QA 样本后,正式评估了 98 条轨迹。原始对话属于私有数据。评测时,模型读到的是遮去了人工标签和审阅备注的完整记录:
- 61 条包含已知故障(标签为 1):包含原有人工审阅确认的 39 条故障,以及通过 Braintrust 和 Arize 工具筛查后再经人工核验确认的 22 条故障。评测准则将预约失败、未按规定转接人工、工具调用失败却谎称完成、违背系统指令或向客户暴露内部占位符等情况判定为实质性故障。
- 37 条未标记故障(标签为 0):在本次基准中未被标记包含实质性故障,但这并不代表轨迹完全毫无瑕疵。
测试覆盖了 6 款决策模型方案:Jev 1.13、Perplexity Decider 1.1 (27B)、Liquid d1、Liquid d1-ultra、Cloudflare Clef Flash 以及使用 GPT-6 Luna 的 OpenAI Decisions。Perplexity、Liquid、Clef 与 OpenAI 接收相同的文字提示词与序列化输入;Jev 则通过其结构化 API 接收等价准则。各模型针对每条轨迹输出一个 0 到 1 之间的故障倾向分。
默认 0.50 阈值为什么会让评测“睁眼瞎”?
API 通常约定:若分数 ≥ 0.50,就判定该轨迹为“故障”并报警,否则放行。但不同模型的打分尺度千差万别。
假设一个模型把所有真故障的轨迹都打了 0.40 分,把所有正常轨迹都打了 0.10 分。在这个假设情境下,只要把及格线切在 0.30,它就能完美区分两类样本。然而,一旦按默认的 0.50 阈值切分,它就会把所有故障全部判为正常,故障检出率直接变为 0。
在实际业务中,故障轨迹与正常轨迹的打分往往相互重叠,但不同模型的数值区间依然差异巨大。

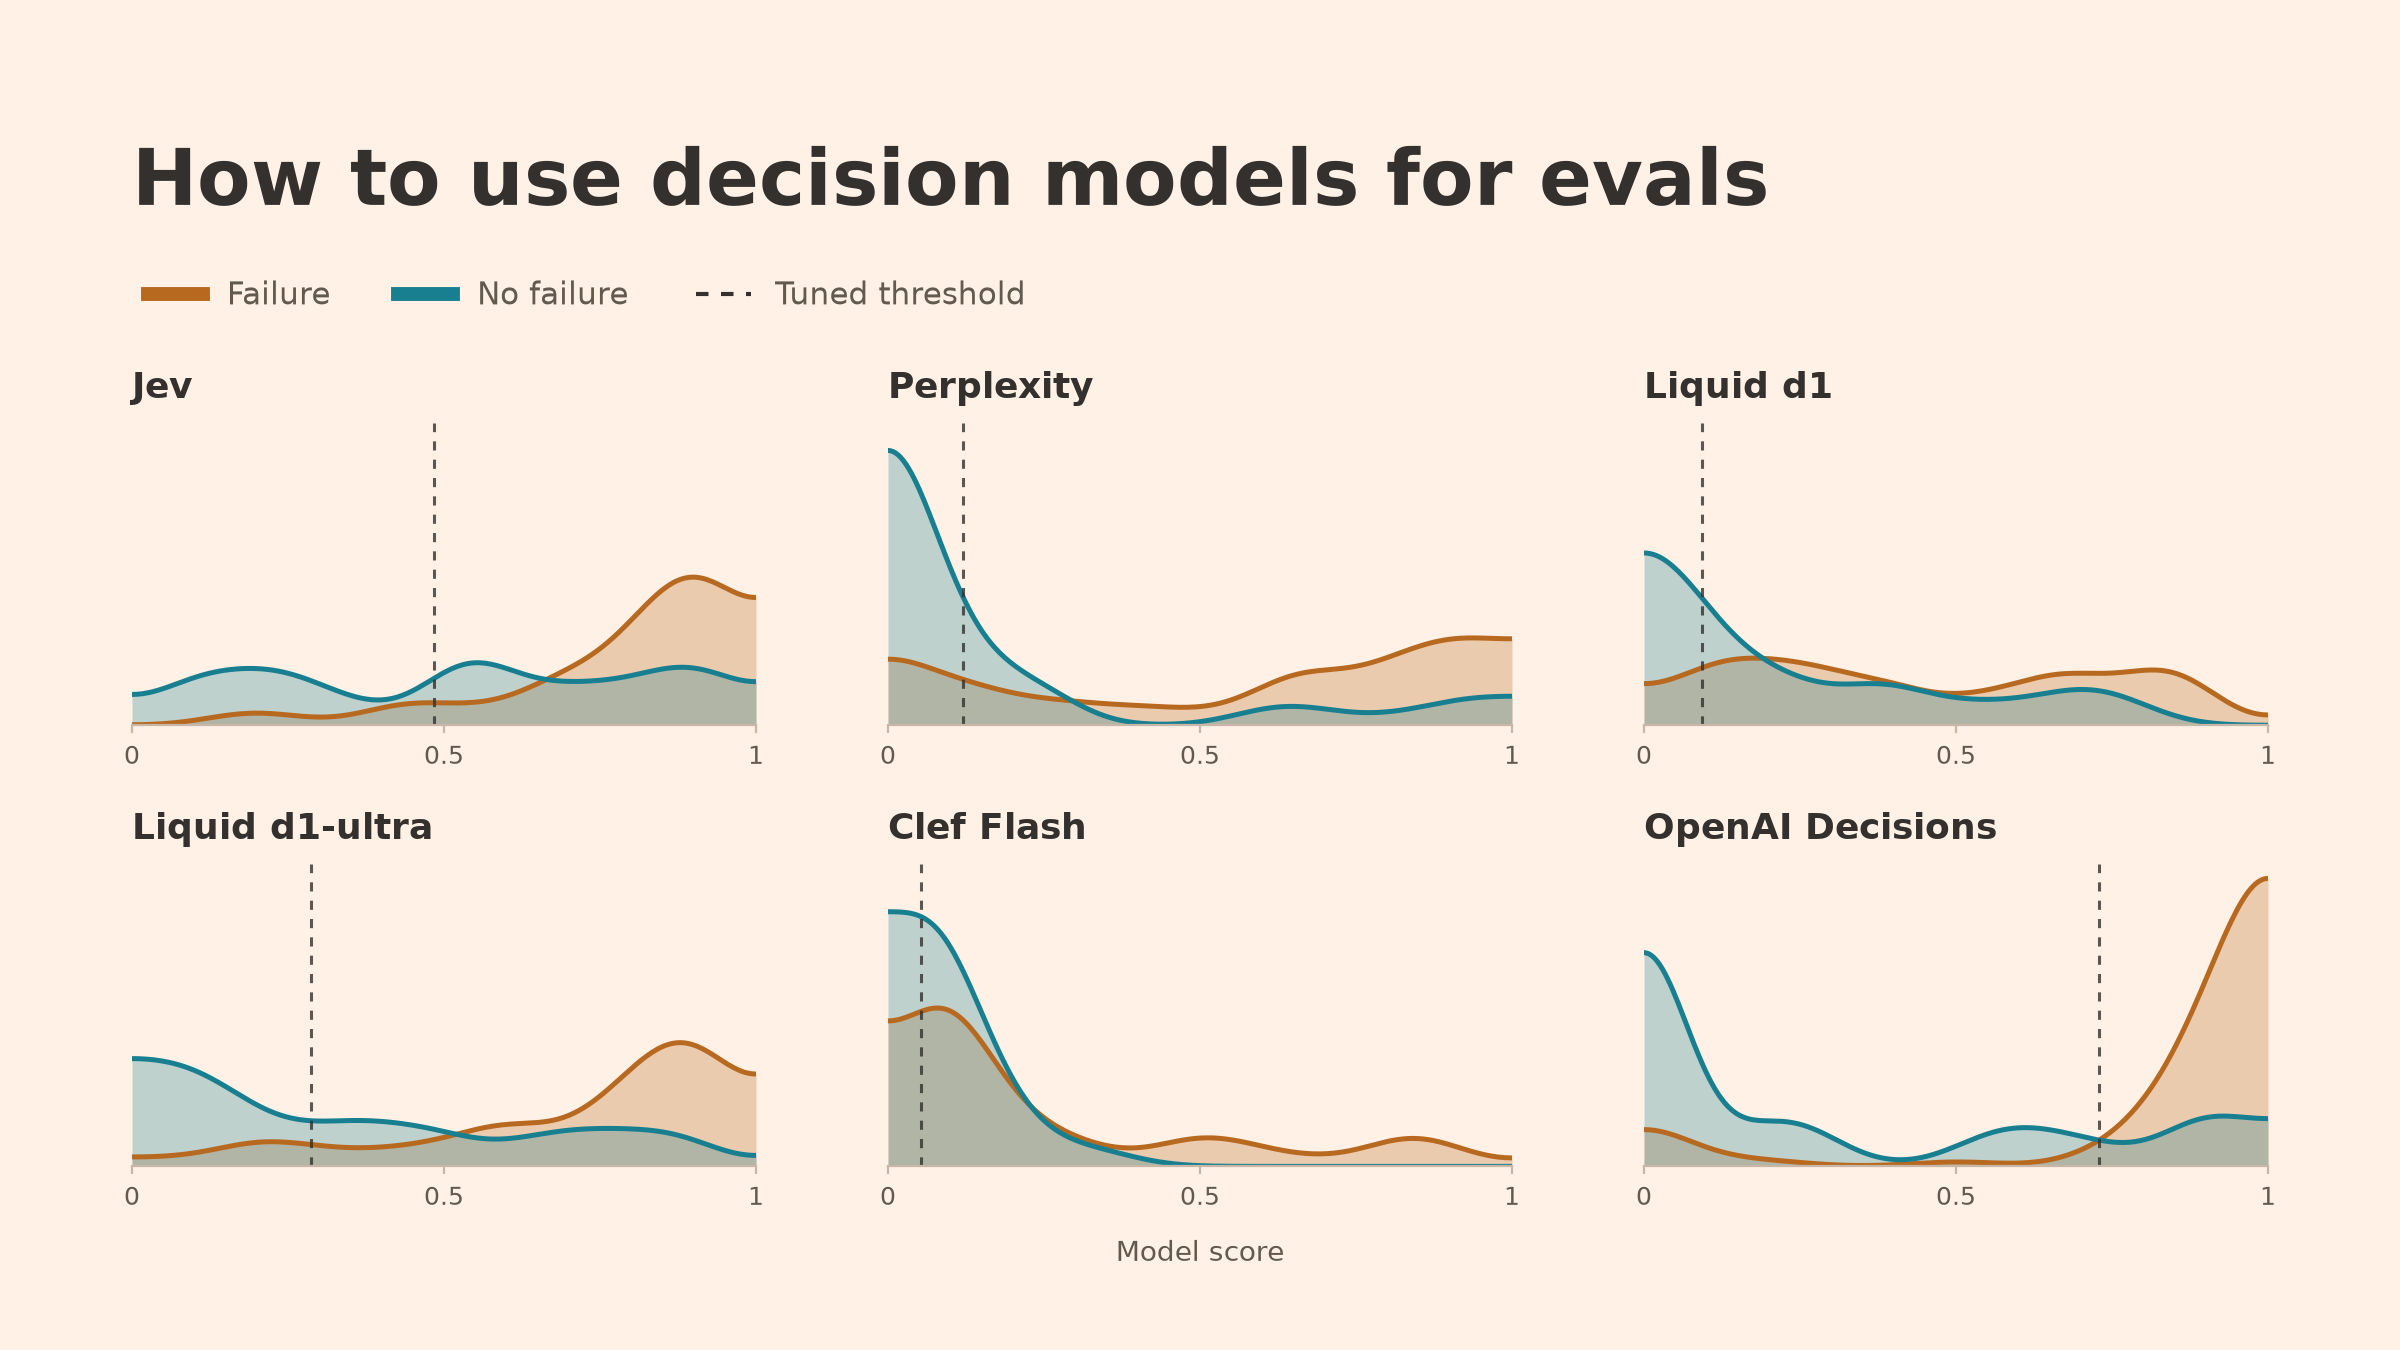
橙色为已知故障轨迹的打分密度,蓝色为未标记故障的轨迹;每类曲线下面积各归一化为 1。Clef Flash 与 Liquid d1 的打分集中在接近 0 的极低区间;Perplexity 在 0.50 处漏报较多,而 OpenAI 对两类轨迹的分离较为明显。
看一下在默认 0.50 阈值下,各模型的实际表现:
- Cloudflare Clef Flash:打分整体偏低。在 0.50 阈值下,全量数据中只发出 13 次报警,虽然 13 次全部为真故障(精确率 100%),但漏掉了 61 个已知故障中的 48 个,召回率仅 21.3%(F1 为 0.35)。
- Liquid d1:打分同样偏低,0.50 阈值下抓出 28 个故障,漏掉了 33 个,召回率 45.9%(精确率 77.8%,F1 为 0.58)。
- Perplexity Decider:0.50 阈值下抓出 39 个故障,遗漏 22 个,召回率 63.9%(精确率 84.8%,F1 为 0.73)。
- Liquid d1-ultra:0.50 阈值下抓出 49 个故障,误报 12 次,精确率 80.3%,召回率 80.3%(F1 为 0.80)。
- OpenAI Decisions:两类分数拉得较开,0.50 阈值下抓出 55 个故障(召回率 90.2%),但误报了 15 次未标记故障的轨迹(精确率 78.6%,F1 为 0.84)。
模型分数的绝对高低并不代表好坏,核心在于它能否把故障轨迹与正常轨迹在数值轴上拉开距离。绝不能在未检验打分分布的情况下,直接拿 0.50 当作评测系统的报警线。
精确率与召回率:报警器不能只有“好坏排序”
在设计自动化质检或报警系统时,工程师必须权衡精确率(Precision,查准率)与召回率(Recall,查全率)。
两个概念的核心分母不同:
- 精确率(Precision / 查准率):抓到的真故障数 / 系统发出的全部报警数。只要系统拉响报警,里面到底有多少次是真的故障?以 Clef Flash 为例,报警 13 次且 13 次全是真故障,精确率就是 13 / 13 = 100%。如果精确率过低,虚警频发,值班人员很快会陷入警报疲劳。
- 召回率(Recall / 查全率):抓到的真故障数 / 全部已知故障数。在全部 61 个已知故障中,系统到底拦截到了多少?Clef Flash 只抓到了 13 个,召回率就是 13 / 61 ≈ 21.3%。如果召回率过低,大量故障就会从系统眼皮底下溜走。
F1 分数是精确率与召回率的调和平均值,用于综合评估两者的平衡,但它不是常规意义上的准确率。在实际业务中,不能脱离最低底线去盲目追求高 F1。
例如,对于自动化工单报警系统,作者在本次评测中设定了一组示例底线:精确率不低于 80%,且召回率不低于 80%。这意味着系统发出的报警里至少 8 成是真问题,同时已知故障中至少 8 成被当场拦截。这属于具体的业务约束示例,并非放之四海皆准的行业统一红线。

横轴为召回率(Recall),纵轴为精确率(Precision)。右上角阴影区代表精确率与召回率同时达到或超过 80% 的区间。在全样本阈值扫描中,仅 OpenAI Decisions、Liquid d1-ultra 和 Perplexity 曾进入阴影区成为候选模型;Jev、Liquid d1 和 Clef Flash 全程未能进入。
在 98 条样本的全量扫描中,只有 3 款模型在某个阈值区间内能同时达到“双 80%”的门槛,它们被列为候选模型(Candidates):
- OpenAI Decisions:表现最好,大面积处于阴影区内;
- Liquid d1-ultra:在阈值 0.525 附近能够触碰双 80%;
- Perplexity Decider:在将阈值下调至约 0.127 时触达。
而 Jev、Liquid d1 和 Clef Flash 无论把阈值调到哪里,在这 98 条全样本扫描中都无法同时满足双 80% 的要求。
动手推拉滑块:观察移动阈值如何改变误报与漏报
为了直观观察移动阈值对误报和漏报的影响,交互演示载入了这 98 条记录的公开标签与对应模型的原始预测分数。
你可以自由切换模型,拖动滑块查看误报(虚警)与漏报如何在天平两端此消彼长。
固定 0.50 对照:查准率 78.6% · 召回率 90.2% · 抓到 55 条 · 误报 15 条 · 漏报 6 条。
当前阈值 0.50:抓到 55 条,误报 15 条,漏报 6 条。
从上面的即时重算中可以观察到一个关键事实:当把阈值推到极高、导致报警总数为 0 时,精确率在数学上未定义(0/0),绝不能误标为 100%。 同时也需注意:这属于全样本教学重算,它直观展示了阈值的杠杆作用,但在全样本上挑选出的阈值,并不保证在未见样本上也能完全重现相同表现。
交叉验证的真实动作:为什么训练集达标,留出验证集还会下滑?
在手头数据上挑出一个看似合规的阈值,并不等于系统上线后也能稳定达标。
为了评估阈值的泛化表现,作者在实验中采用了分层五折交叉验证(Stratified 5-Fold Cross-Validation)方法:
- 分折隔离:将 98 条轨迹按已知故障与未标记故障记录的比例均匀切成 5 份。在每一轮中,拿出 4 份(约 78 条)作为训练集,剩下 1 份(约 20 条)作为留出验证集。
- 带约束搜寻阈值:对三款候选模型,在训练折上寻找满足“精确率 ≥ 80% 且召回率 ≥ 80%”的前提下使 F1 最大的阈值;非候选模型则直接进行无约束 F1 调优。
- 回退策略与留出核验:当候选模型在某个训练折中找不到任何满足双 80% 的阈值时,实验规则回退至无约束寻找 F1 最大值,并记录该折不可行。选定阈值后套用到对应的留出验证折记录结果。实验将全部留出折预测(包括回退折)均计入报告。
实验进行了 20 轮五折交叉验证,共计 100 个训练切分:
- OpenAI Decisions:在全部 100 次训练切分中均成功找到满足双 80% 的阈值;在留出验证集上的平均表现为:精确率 86.9%、召回率 86.2%、F1 达到 0.865。这是跨切分的平均表现,每一折及实际部署的表现仍会变化。
- Liquid d1-ultra:在训练折中有 29 次切分未能找到满足双 80% 的阈值,按规则回退至无约束调优;最终在验证集上的平均留出精确率滑落至 75.9%(召回率 81.7%,留出 F1 为 0.787)。
- Perplexity Decider:在训练折中有 36 次切分未能达标而触发回退;最终验证集平均留出精确率为 75.4%(召回率 82.5%,留出 F1 为 0.787)。
训练集上选出的阈值无法消除样本扰动带来的边界波动,面对未见数据时,指标出现下滑是常见现象。

空心圆代表 98 条样本在默认 0.50 阈值下的成绩,实心圆代表交叉验证调优后的平均留出 F1 分数;前三项为候选模型,后三项灰色为未达双 80% 约束的模型。Clef Flash 的留出 F1 从 0.35 提升至 0.78,Liquid d1 从 0.58 提升至 0.79;OpenAI 从 0.84 提升至 0.87。但 Jev 从 0.79 微降至 0.78,Liquid d1-ultra 从 0.80 微降至 0.79。这表明在训练集上调优阈值并不保证在留出验证集上一定获得改善。
此外,F1 并非唯一的优化目标。如果业务对误报或漏报有明显偏好,可以采用 F-beta 分数(当 beta 小于 1 时赋予精确率更高权重,beta 大于 1 时赋予召回率更高权重),根据具体业务目标挑选阈值。
让编程 Agent 调优阈值的完整提示词
如果你手头已经积累了一批打好标签的轨迹和模型给出的原始分数,可以直接参考作者建议的提示词,让编程 Agent 自动执行交叉验证。需要注意:该示例提示词要求在没有达标阈值时直接报告而非放宽条件,与本文实验采用的回退策略不同。
英文提示词原件:
Using my saved model scores and binary labels (1 means failure), tune a decision threshold to maximize F1 while requiring at least 80% precision and 80% recall. Use stratified five-fold cross-validation, choosing thresholds on the training examples and measuring performance on the remaining examples. If comparing models, use the same splits for each. Only select thresholds that meet both minimums on the training examples. If none qualifies, report that rather than relaxing either requirement. Report validation precision, recall, and F1, along with any splits where no threshold qualified or validation performance fell below my minimums. Compare with the default threshold of 0.50. Reuse the saved scores without making new model calls.完整中文翻译:
利用我保存的模型分数和二元标签(1 表示故障),在要求精确率至少 80% 且召回率至少 80% 的前提下,微调决策阈值以最大化 F1 分数。采用分层五折交叉验证,在训练样本上选择阈值,并在剩余的验证样本上测量表现。如果要对比多个模型,请对每个模型使用相同的切分折。只在训练样本上选择同时满足这两项最低要求的阈值。如果没有符合条件的阈值,请直接报告该情况,而不要放宽任何一项要求。报告验证集的精确率、召回率和 F1,并指出哪些折没有合格阈值或验证表现跌破了我的最低要求。与默认阈值 0.50 进行对比。直接复用已保存的分数,不要发起新的模型调用。
性能与费用权衡:候选模型怎么选?
调优各模型的专属阈值后,模型选型就落到了性能与费用权衡(Performance vs. Cost)上。
本次费用统计基于 100 次评测的 API Token 消耗与实验中的费率快照计算(性能基于 98 条生产轨迹,不含 2 条内部 QA 样本)。其中,Liquid 的费率按文中说明进行了重新核定,d1 从每百万输入 token 0.04 美元更新为 0.02 美元,d1-ultra 为 0.042 美元;其余模型沿用实验时的费率记录,并非统一的现行市场报价。

横轴为每 100 次评测的 API 费用(美分),纵轴为五折留出验证的平均 F1 表现。实心圆为候选模型,虚线连接 Perplexity 与 OpenAI Decisions,标出候选中的费用与 F1 前沿。灰色叉号为未达到双 80% 约束的模型。Perplexity 以 0.82 美分/100次成为最低成本候选,而 OpenAI 达到最高 0.87 F1 但成本为 3.72 美分。这一前沿仅对应当前评测任务,不能直接推广到未来的所有场景。
拆解这三款候选模型的具体表现:
- Perplexity Decider 1.1:每 100 次评测花费 0.82 美分,留出平均 F1 为 0.79(保留六位小数为 0.787289),留出平均精确率 75.4%、召回率 82.5%。它是候选模型中调用成本最低的方案。
- Liquid d1-ultra:每 100 次评测花费 1.52 美分,留出平均 F1 同样舍入为 0.79(保留六位小数为 0.786636,与 Perplexity 略有细微差异),留出平均精确率 75.9%、召回率 81.7%。在这三款候选的前沿对比中,其单位费用高于留出 F1 相近的 Perplexity。
- OpenAI Decisions (GPT-6 Luna):每 100 次评测花费 3.72 美分,留出平均 F1 达到 0.87(保留六位小数为 0.865463),留出平均精确率 86.9%、召回率 86.2%。其费用约为 Perplexity 的 4.5 倍,但在本次实验中平均精确率与召回率均保持在 80% 以上。
在非候选模型中,Liquid d1 调优后虽然在 98 条样本上能取得 0.79 的留出 F1 且费用极低(0.72 美分),但由于在前述 98 条全样本阈值扫描中无法同时达到精确率与召回率双 80%,因此未被列为候选模型。
本实验没有在统一条件下比较模型延迟。在实际生产部署中,响应延迟高度取决于请求是否批处理或并发、距离供应商基础设施的物理位置、并发限制、尾延迟以及吞吐量等外部因素,不能仅凭单次实验的平均响应时间来对模型快慢排榜。
分数能当概率用吗?模型校准与 Platt 缩放
除了进行“是非”分类外,有些团队还希望把决策模型的打分直接当作置信度或故障概率使用。
校准的实际含义是:如果一个模型打出了 0.80 的故障分,那么在许多获得类似分数的轨迹中,应当有大约 80% 确实存在故障。但在实际测试中,部分模型的原始打分与真实发生概率存在较大偏差。

左图为原始打分,右图为经过 Platt 缩放调整后的概率。横轴为模型预测的故障概率,纵轴为该分组内实际观察到的故障比例,虚线对角线表示完美校准。每个数据点代表打分相近的约 20 条轨迹。校准后,Clef Flash、Perplexity 和 Liquid d1 明显向对角线收拢。
看一下原始分布中的偏差现象:
- 样本按预测概率从低到高分成 5 组(每组 19 或 20 条轨迹)。图中的点若落在对角线上方,说明模型低估了故障风险;若落在下方,说明高估了风险。
- Cloudflare Clef Flash:在其中一个分组中,模型预测的平均故障概率仅约 8%,但在该组样本中实际有 60% 包含故障。这个比例描述的是该分组,未来单条记录的风险仍需新数据检验。
- Perplexity 与 Liquid d1:同样在多个分组区间内存在低估故障风险的情况。
为了修正这类偏差,常见的方法是普拉特缩放(Platt Scaling)。它的具体操作动作是:利用训练折的模型原始打分与 0/1 标签,拟合一条将打分映射为概率的平滑曲线(基于对数几率的逻辑回归);然后将这条拟合好的曲线应用到未参与拟合的留出验证折上,完成概率转换。通过循环各折并汇总留出预测结果,避免拿同一批数据自拟合自评。
使用校准时需要注意以下现实:
- 部分模型在此数据集上调整较少:Jev 1.13 与 Liquid d1-ultra 在这批数据上的原始打分已经比较贴近对角线,缩放带来的调整很小。这属于本批数据的表现,并非两款模型天然通用的性质。
- 拟合方法对结果较为敏感:检验校准通常使用布里尔分数(Brier Score),即预测概率与真实 0/1 标签之差的平方再取平均值,数值越低越好,它同时受区分能力与校准程度的影响。在本实验展示的对数几率 Platt 拟合下,OpenAI Decisions 的布里尔分数从 0.159 微升至 0.164,这表明概率误差有所增大,但并不能证明模型的排序区分能力受损。作为对比,如果直接在概率尺度上进行探索性重拟合,OpenAI 的布里尔分数可以降至 0.154,这说明校准效果对拟合形式十分敏感,且不能保证在未知新数据上一定最优。
让编程 Agent 评估校准度的完整提示词
英文提示词原件:
Using my saved failure probabilities and binary labels (1 means failure), test whether Platt scaling improves each model’s probabilities. Use stratified five-fold cross-validation with the same splits for every model. Fit the calibration mapping on each training split and apply it to the remaining traces. Fit on log-odds, clipping probabilities away from 0 and 1 first. Plot predicted probabilities against observed failure rates before and after calibration. Report Brier scores (lower is better), and explain which models improved or got worse. Reuse the saved scores without making new model calls.完整中文翻译:
利用我保存的故障概率和二元标签(1 表示故障),测试普拉特缩放(Platt scaling)是否能改善各个模型的概率输出。对所有模型使用切分一致的分层五折交叉验证。在每个训练折上拟合校准映射,并应用到该折剩余的轨迹上。基于对数几率(log-odds)进行拟合,拟合前先将概率限制在稍大于 0 且稍小于 1 的范围(clip)。绘制校准前后的预测概率与实际观测故障率对比图。报告布里尔分数(Brier score,越低越好),并解释哪些模型改善了、哪些模型变差了。直接复用已保存的分数,不要发起新的模型调用。
生产落地的实践法则
在把决策模型用于实际 AI 系统的自动化评测前,可以参考以下实践经验:
- 窄化评测范围(One Judge per Failure Mode):本实验使用的是较为宽泛的总评判规则。在实际落地中,建议针对每一种具体故障模式分别构建专职裁判(例如单独设立预约失败裁判、人工转接合规裁判)。任务目标越聚焦,作者预期大小模型之间的性能差距越可能收窄。
- 先大后小探索替代方案:先找到在本任务上表现可接受的大模型,再测试小模型能否以更低费用达到接近的效果。高质量的人工标注是评测的基石;在进行提示词开发或优化时,务必保留一份独立的测试集用于最终检查。
- 根据业务需求调优专属阈值:不要直接沿用默认的 0.50 阈值。明确业务对精确率和召回率的要求,在训练集上通过交叉验证寻找合适阈值。如果后续修改了提示词或更换了模型,需要重新检查阈值与校准状况。
- 解耦区分能力、判定阈值与概率解释:模型能有效排开好坏不代表默认阈值可用,训练集达标不代表验证集不会下滑,打分高低更不能直接等同于真实故障概率。
读者可复用的练习路径
如果你想亲自体验上述分析流程,原作者公开了图表对应的 JSON 数据(包含 98 条轨迹一一对应的 0/1 标签与各模型的预测打分):
- 将公开分数与标签保存为本地文件
chart-data.json(labels为 0/1 标签,models[].scores按相同顺序对应每条记录); - 将数据交给编程 Agent,先发送阈值调优提示词(中文或英文原件任选一种),观察交叉验证下的留出精确率、召回率与阈值选择;
- 若业务需要将打分转换为置信概率,再发送校准提示词,评估 Platt 缩放是否能降低各模型的布里尔分数。
原客服对话未公开,外部读者可用公开的分数与标签练习阈值调优和概率校准;重新调用模型评错仍需要对话原件。
附录:实验评测提示词
测试中,Perplexity、Liquid d1/d1-ultra、Clef Flash 与 OpenAI Decisions 接收的是统一的文本提示词;Jev 则通过其专用 API 接收结构化的 JSON 指令。
查看通用评测提示词(英文原件与中文对照)
通用文本提示词原件 (General Prompt)
Decide whether `messages` contains at least one substantive failure, risk, or quality problem in the AI assistant's behavior or tool use. This is one complete production trace from an AI that handles apartment-leasing customer support over phone or messaging. The trace includes the conversation plus any tool calls and tool outputs.

Evaluate the AI assistant and its tool use, not the customer. Treat system messages inside `messages` as the instructions governing the assistant's behavior and allowed capabilities. Inspect the full trace, including final turns and all tool calls and outputs. Base the judgment only on evidence visible in this trace. Do not assume external policies, channel behavior, or business requirements that are not present. Do not assume every trace failed. A short, ambiguous, or inconclusive trace is not an issue unless visible evidence establishes a substantive failure.

Return the probability that at least one substantive issue is present; the issue does not need to be named or clustered.

Count as an issue when supported by the trace: the assistant contradicts an applicable system instruction or tool result; makes an unsupported factual or operational claim; misses, misuses, repeats, or falsely claims completion of a required tool action, transfer, booking, cancellation, follow-up, or confirmation; materially misunderstands or leaves an explicit user request unresolved; or exposes internal actions, placeholders, or broken content to the customer in a way that materially harms the interaction.

Do not count as an issue: a minor stylistic preference with no meaningful effect; a failure caused only by the customer's behavior; internal tool metadata that was not exposed to the customer and did not cause an incorrect response; a hypothetical concern requiring information outside the trace; or insufficient evidence and inconclusive conversations.
通用文本提示词中文对照翻译
判断 `messages` 中是否包含至少一个关于 AI 助手行为或工具调用的实质性故障、风险或质量问题。这是一段来自通过电话或即时通讯处理公寓租赁客户服务的 AI 助手的完整生产轨迹。该轨迹包含完整的对话以及所有工具调用与工具输出。

仅评估 AI 助手及其工具调用,不要评估客户。将 `messages` 内部的系统消息视为规范助手行为和允许能力的操作指令。检查完整轨迹,包括最终轮次以及所有的工具调用与输出。仅依据本轨迹中可见的证据作出判断。不要臆测此处未出现的外部策略、渠道特性或业务需求。不要预设每个轨迹都必定失败。除非可见证据确凿证实了实质性失败,否则简短、模棱两可或无定论的轨迹不视为存在问题。

返回至少存在一个实质性问题的概率;无需指明该问题的具体名称或进行归类。

在有轨迹证据支持的情况下,以下情况计为问题:助手违背了适用的系统指令或工具结果;提出了未经支持的事实性或操作性断言;遗漏、误用、重复或谎称完成了必需的工具操作、转接、预约、取消、跟进或确认;实质性误解或未解决用户的明确诉求;或者向客户暴露了内部操作、占位符或损坏内容,从而对交互造成了实质性损害。

以下情况不计为问题:无实质性影响的轻微语言风格偏好;完全由客户自身行为导致的失败;未暴露给客户且未导致错误响应的内部工具元数据;需要轨迹外信息才能证实的假设性隐患;或者证据不充分且无定论的对话。
查看 TypeSafe Jev 专用结构化提示词(JSON 原件与中文对照)
Jev 结构化提示词原件 (Structured JSON)
{
  "version": "nurtureboss-any-issue-v1",
  "question_id": "has_substantive_issue",
  "type": "noul",
  "instructions": {
    "task": "Does `messages` contain at least one substantive failure, risk, or quality problem in the AI assistant's behavior or tool use?",
    "context": "This is one production trace from an AI that handles apartment-leasing customer support over phone or messaging. The trace contains the complete conversation plus any tool calls and tool outputs.",
    "evaluation_rules": [
      "Evaluate the AI assistant and its tool use, not the customer.",
      "Treat system messages inside `messages` as the instructions governing the assistant's behavior and allowed capabilities.",
      "Inspect the full trace, including the final turns and all tool calls and outputs.",
      "Base the judgment only on evidence visible in this trace. Do not assume external policies, channel behavior, or business requirements that are not present.",
      "Do not assume every trace failed. A short, ambiguous, or inconclusive trace is not an issue unless the visible evidence establishes a substantive failure.",
      "Return the probability that at least one substantive issue is present. The issue does not need to be named or clustered."
    ]
  },
  "criteria": {
    "true": {
      "definition": "At least one substantive problem is supported by evidence in the trace.",
      "examples_of_qualifying_evidence": [
        "The assistant contradicts an applicable system instruction or a tool result.",
        "The assistant makes an unsupported factual or operational claim.",
        "A required tool action, transfer, booking, cancellation, follow-up, or confirmation is missing, incorrect, repeated, or falsely claimed as complete.",
        "The assistant materially misunderstands or leaves an explicit user request unresolved.",
        "Customer-facing text exposes internal actions, placeholders, or broken content that materially harms the interaction."
      ]
    },
    "false": {
      "definition": "No substantive assistant problem can be established from the visible trace.",
      "do_not_count_as_an_issue": [
        "A minor stylistic preference with no meaningful effect.",
        "A failure caused only by the customer's behavior.",
        "Internal tool metadata that was not exposed to the customer and did not cause an incorrect response.",
        "A hypothetical concern that requires information outside the trace.",
        "Insufficient evidence or an inconclusive conversation."
      ]
    }
  }
}
Jev 结构化提示词中文对照翻译
{
  "version": "nurtureboss-any-issue-v1",
  "question_id": "has_substantive_issue",
  "type": "noul",
  "instructions": {
    "task": "`messages` 中是否包含至少一个关于 AI 助手行为或工具调用的实质性故障、风险或质量问题?",
    "context": "这是一段来自通过电话或即时通讯处理公寓租赁客户服务的 AI 助手的生产轨迹。该轨迹包含完整的对话以及所有工具调用与工具输出。",
    "evaluation_rules": [
      "仅评估 AI 助手及其工具调用,不要评估客户。",
      "将 `messages` 内部的系统消息视为规范助手行为和允许能力的操作指令。",
      "检查完整轨迹,包括最终轮次以及所有的工具调用与输出。",
      "仅依据本轨迹中可见的证据作出判断。不要臆测此处未出现的外部策略、渠道特性或业务需求。",
      "不要预设每个轨迹都必定失败。除非可见证据确凿证实了实质性失败,否则简短、模棱两可或无定论的轨迹不视为存在问题。",
      "返回至少存在一个实质性问题的概率。无需指明该问题的具体名称或进行归类。"
    ]
  },
  "criteria": {
    "true": {
      "definition": "轨迹中的证据支持存在至少一个实质性问题。",
      "examples_of_qualifying_evidence": [
        "助手违背了适用的系统指令或工具结果。",
        "助手提出了未经支持的事实性或操作性断言。",
        "必需的工具操作、转接、预约、取消、跟进或确认出现遗漏、错误、重复或谎称完成。",
        "助手实质性误解或未解决用户的明确诉求。",
        "面向客户的文本暴露了内部操作、占位符或损坏内容,从而对交互造成了实质性损害。"
      ]
    },
    "false": {
      "definition": "从可见的轨迹中无法确立任何实质性的助手问题。",
      "do_not_count_as_an_issue": [
        "无实质性影响的轻微语言风格偏好。",
        "完全由客户自身行为导致的失败。",
        "未暴露给客户且未导致错误响应的内部工具元数据。",
        "需要轨迹外信息才能证实的假设性隐患。",
        "证据不充分或无定论的对话。"
      ]
    }
  }
}
如何用决策模型给 AI 做自动化质检:六款模型实测
检查 AI 客服是否办错事,常见做法是请大模型当“裁判”。决策模型及分类接口尝试以更低成本,给每段对话打一个故障倾向分。分数到手后,还要处理两个问题。
分数达到哪条线才报警?移动这条线,会改变误报和漏报。
0.80 分能否理解为八成风险?要看同类分数的记录中,是否约八成真有故障。
模型没换,只移动报警线
教学假设:正常对话全得 0.10 分,故障全得 0.40 分。分数 ≥ 阈值就报警。
报警全对,也可能漏掉多数故障
Clef Flash 在默认 0.50 下,报警 13 次全对,却漏掉 61 个已知故障中的 48 个。
全部报警数
全部已知故障数
全样本入围,还要看未见数据
98 条全样本上,下面三款曾同时达到精确率、召回率“双 80%”,成为候选。再用每轮 4 折选阈值、剩下 1 折验证,重复 20 轮五折:
| 候选模型 | 留出均值 精确率/召回率 | 费用 美分/100次 |
|---|---|---|
| OpenAI Decisions | 86.9%/86.2% | 3.72 |
| Liquid d1-ultra | 75.9%/81.7% | 1.52 |
| Perplexity Decider | 75.4%/82.5% | 0.82 |
校准能调整刻度,仍需留出检验
Platt 缩放用训练折的分数和人工标签拟合“分数→概率”的映射,再在留出折检验。部分模型改善,OpenAI 的概率误差却略增:
越低越好
用自己的数据照着做
- 准备人工 0/1 标签与模型原始分数。
- 交给编程 Agent,分折调阈值并报告留出成绩。
- 需要风险概率时,再拟合校准并检查误差。
正文提供两段完整中英文提示词;复用已保存分数,无需重新调用模型。
How To Use Decision Models for Evals
How to choose a decision model for your task, tune its threshold, and interpret its scores.
Decision models have exploded onto the scene recently, starting with TypeSafe’s Jev, followed by Perplexity’s Decider, Liquid’s d1, Cloudflare’s Clef, and OpenAI’s Decisions API1. These models promise fast, inexpensive classification.
Decision models are an appealing low-cost alternative to LLM judges2 for automated evals. But whether they’re the right choice depends on the cost, performance, and latency requirements of your use case.
We’ve also noticed people using the default decision threshold of 0.50 without checking whether it works well for their task. This can leave a lot of performance on the table.
In this post, we’ll start by showing how to tune thresholds to get the best results from decision models. With those thresholds tuned, we’ll compare cost and performance to help you assess which model fits your use case. Finally, we’ll explore how to interpret model scores when deciding whether to act, and how calibration can make them more useful as confidence estimates.
What we tested
We used 100 traces, or logs of conversations and actions, from an apartment leasing agent. The task is to identify traces containing an error, such as a failed booking or a missed handoff to a human.3 We used the same dataset and broad failure-finding task in our prior post on automated evals. Here, each decision model returns a failure probability for each trace.
We tested Jev 1.13, Perplexity Decider 1.1 27B, Liquid d1 and d1-ultra, Cloudflare Clef Flash, and OpenAI Decisions (GPT-6 Luna)1. Each model received the same evaluation criteria. The appendix shows the prompt and the structured version used for Jev.
We compare models on two dimensions:
- Performance: We compare each model’s predictions with traces that people have reviewed and labeled as passing or failing. This measures how well the model catches failures while avoiding false alarms.
- Cost: We calculate API cost from token usage and the provider’s prices.4
For brevity, we leave latency aside because it depends on factors outside this experiment’s control.5
Understanding decision thresholds
We assign each trace one of two labels, pass or fail. This is a binary pass/fail eval, which we recommend because it encourages clear criteria and is easier to align with human preferences.
Each decision model returns a score from 0 to 1 that estimates how likely a trace is to contain a failure. The APIs turn this score into a decision using a default decision threshold of 0.50. Traces with scores at or above the threshold are flagged as failures. Using this default without checking it against your data can give you subpar results.
For example, a model could assign every failure a score of 0.40 and every passing trace a score of 0.10. Even though this model classifies traces perfectly at a threshold of 0.30, the default threshold of 0.50 would catch nothing.
In practice, scores for failures and passing traces will overlap. Lowering the threshold catches more failures but can also raise more false alarms. Choosing a threshold means balancing:
- Precision: The share of flagged traces that contain a known failure.
- Recall: The share of known failures that the model catches.
The right tradeoff depends on your business goals. For example, criminal trials set a high bar for conviction to avoid convicting innocent people, emphasizing precision. Cancer screening may emphasize recall, accepting more false alarms to miss fewer cases.6 For this comparison, we’ll give precision and recall equal weight using the F1 score, their harmonic mean. F1 ranges from 0 to 1, and higher is better.
The curves below show how each model scores failures (orange) and passing traces (blue). Taller parts of a curve mean more scores from that class fall in that range. Scores at or above the dashed threshold line are flagged. Use the toggle to compare 0.50 with Optimized for best F1, which chooses a threshold for each model.7
OpenAI separates the two classes best on this task, which is also reflected in its higher F1 score.
It’s also important not to blindly maximize F1 without thinking about your minimum requirements for the classifier to be useful. For example, if this classifier is used for an automated alerting system, I would want a minimum of 80% on both precision and recall so that I’m minimizing false alarms while catching a sufficient number of failures.
The chart below shows how precision and recall change at different thresholds.8 The shaded region marks where both reach at least 80%.
Perplexity, Liquid d1-ultra, and OpenAI Decisions meet our requirements, but we still need to choose a decision threshold within the shaded region for each model. In the next section, we’ll discuss how to tune those thresholds.
Tuning the decision threshold
For this example, we’ll optimize F1. For our candidates, we’ll restrict tuning to thresholds that meet both 80% minimums on the training data whenever possible. We leave the other models unconstrained to illustrate the effect of tuning.9
With labeled traces and saved model scores, you can ask a coding agent to tune the thresholds. Below is an example prompt you can modify for your use case:
Using my saved model scores and binary labels (1 means failure), tune a decision threshold to maximize F1 while requiring at least 80% precision and 80% recall. Use stratified five-fold cross-validation, choosing thresholds on the training examples and measuring performance on the remaining examples. If comparing models, use the same splits for each. Only select thresholds that meet both minimums on the training examples. If none qualifies, report that rather than relaxing either requirement. Report validation precision, recall, and F1, along with any splits where no threshold qualified or validation performance fell below my minimums. Compare with the default threshold of 0.50. Reuse the saved scores without making new model calls.
Here’s how tuning for F1 changed each model’s performance. We group the three candidates from the precision-recall chart together and show the other models in gray to illustrate how much tuning can help.
Our candidate models gained less from F1 tuning than Liquid d1 and Clef Flash, which fell below our minimums. However, even a small shift in precision and recall can affect business costs or the user experience, so choose the tradeoff deliberately. In practice, it’s unlikely that precision and recall are equally important (as we assumed in this post with F1). For example, the F-beta score lets you give precision more weight with beta below 1, or recall more weight with beta above 1. Optimizing a different metric could lead to different thresholds and results.
Performance versus cost
The chart below compares each model’s F1 (after tuning) against cost, focused on our remaining candidates:
The dashed line shows the Pareto frontier among our remaining candidates. For any given F1 score, it identifies the cheapest candidate that meets or exceeds that score. This particular chart is a bit silly as there are only three options, but it’s a useful illustration for how to think about cost vs. performance.
Perplexity was the cheapest of these candidates at 0.82 cents per 100 eval runs, with an F1 of 0.79. OpenAI Decisions reached an F1 of 0.87 at 3.72 cents per 100 eval runs, about 4.5 times the cost.
Can we trust the probabilities?
Beyond pass/fail evals, you may want to use a decision model’s score as a confidence estimate. But can you take that number literally? For a score of 0.80 to mean an 80% chance of failure, roughly 80% of traces with similar scores should contain failures.
The chart below shows each model’s probability calibration: how closely its predicted probabilities match observed outcomes.10 Each point represents about 20 traces with similar scores. A point on the diagonal means the predicted probability matches the failure rate in that group. Above the line, the model underestimates the risk of failure. Below it, the model overestimates that risk.
If the predicted probabilities don’t match the observed outcomes, we can adjust them using another model. The second panel shows one method, Platt scaling, which fits a simple curve to make that adjustment.11
Perplexity, Liquid d1, and Clef Flash move closer to the diagonal after calibration. For example, one group of Clef Flash traces had an average predicted failure probability of about 8%, but 60% contained failures.
Jev and Liquid d1-ultra were already well calibrated on this dataset and needed little adjustment.
Platt scaling isn’t always the best fit. For example, OpenAI’s probabilities got slightly worse with the version of Platt scaling we used.12 You can direct your coding agent to perform calibration with the following prompt:
Using my saved failure probabilities and binary labels (1 means failure), test whether Platt scaling improves each model’s probabilities. Use stratified five-fold cross-validation with the same splits for every model. Fit the calibration mapping on each training split and apply it to the remaining traces. Fit on log-odds, clipping probabilities away from 0 and 1 first. Plot predicted probabilities against observed failure rates before and after calibration. Report Brier scores (lower is better), and explain which models improved or got worse. Reuse the saved scores without making new model calls.
Prompt tuning and evaluator scope
We kept the eval task in this post broad to make the differences between models easier to see. In practice, we recommend building a separate judge for each failure mode. With a narrower task and more specific guidance, we expect the performance gaps between models to shrink.
I like to start with a larger model that has acceptable performance on a task and then try smaller models to see if they can match the larger model’s performance for less cost. Prompt tuning can also be helpful if you have high-quality labels.13 I discuss how to craft a good judge prompt in this post.
Putting these ideas into practice
For this particular dataset, OpenAI had breakout performance at a higher cost. Perplexity and Liquid d1-ultra offer lower-cost options with lower performance. We have observed that model performance varies substantially across tasks and datasets, which means it’s important to measure things yourself.
To recap:
- Once you’re satisfied with your judge’s prompt, set minimum precision and recall requirements for your use case. Rule out models that cannot meet these.
- Tune each model’s decision threshold before comparing performance. Choose a precision-recall tradeoff that fits your business goals. Be intentional, don’t just use F1 score because this post did!
- If you want to use scores as confidence estimates, check whether the probabilities match observed outcomes. Calibration can help, but you need to measure whether it improves them.
- Weigh performance against cost and latency for your workload.
This process is iterative. You may improve the prompt, then need to tune the threshold again or revisit calibration. In this post, we focused on threshold tuning and calibration because we’ve seen many people use decision models off the shelf without considering these factors.
You might also be wondering how decision models stack up to LLMs. OpenAI Decisions uses GPT-6 Luna, which delivered our highest F1 at the highest cost, suggesting that harder eval tasks may justify paying more for an LLM. In a broader comparison, Randy Olson found that decision models could match LLMs on classification and routing at lower cost, while LLMs pulled ahead on tasks requiring knowledge and reasoning.
None of the ideas discussed in this post are new. Choosing a precision-recall tradeoff, tuning thresholds and comparing performance vs. cost are part of evaluating any classifier. To learn more about these fundamentals, I recommend Machine Learning with Python Cookbook, 2nd Edition by Kyle Gallatin and Chris Albon.
Finally, if you’re a data scientist or ML engineer wondering where you belong in the AI age, these are skills you already have. It’s time to get revenge 🙂.
Appendix: Evaluation prompt
Perplexity, Liquid d1 and d1-ultra, Clef Flash, and OpenAI Decisions received the prompt below. Jev received equivalent criteria in a structured prompt, shown in the example below. The scores and labels used in the charts are available as JSON.
Decide whether `messages` contains at least one substantive failure, risk, or quality problem in the AI assistant's behavior or tool use. This is one complete production trace from an AI that handles apartment-leasing customer support over phone or messaging. The trace includes the conversation plus any tool calls and tool outputs.

Evaluate the AI assistant and its tool use, not the customer. Treat system messages inside `messages` as the instructions governing the assistant's behavior and allowed capabilities. Inspect the full trace, including final turns and all tool calls and outputs. Base the judgment only on evidence visible in this trace. Do not assume external policies, channel behavior, or business requirements that are not present. Do not assume every trace failed. A short, ambiguous, or inconclusive trace is not an issue unless visible evidence establishes a substantive failure.

Return the probability that at least one substantive issue is present; the issue does not need to be named or clustered.

Count as an issue when supported by the trace: the assistant contradicts an applicable system instruction or tool result; makes an unsupported factual or operational claim; misses, misuses, repeats, or falsely claims completion of a required tool action, transfer, booking, cancellation, follow-up, or confirmation; materially misunderstands or leaves an explicit user request unresolved; or exposes internal actions, placeholders, or broken content to the customer in a way that materially harms the interaction.

Do not count as an issue: a minor stylistic preference with no meaningful effect; a failure caused only by the customer's behavior; internal tool metadata that was not exposed to the customer and did not cause an incorrect response; a hypothetical concern requiring information outside the trace; or insufficient evidence and inconclusive conversations.
NoteExample: A structured prompt
This is how we structured the prompt for Jev’s requests, with separate fields for instructions and evaluation criteria.
{
  "version": "nurtureboss-any-issue-v1",
  "question_id": "has_substantive_issue",
  "type": "noul",
  "instructions": {
    "task": "Does `messages` contain at least one substantive failure, risk, or quality problem in the AI assistant's behavior or tool use?",
    "context": "This is one production trace from an AI that handles apartment-leasing customer support over phone or messaging. The trace contains the complete conversation plus any tool calls and tool outputs.",
    "evaluation_rules": [
      "Evaluate the AI assistant and its tool use, not the customer.",
      "Treat system messages inside `messages` as the instructions governing the assistant's behavior and allowed capabilities.",
      "Inspect the full trace, including the final turns and all tool calls and outputs.",
      "Base the judgment only on evidence visible in this trace. Do not assume external policies, channel behavior, or business requirements that are not present.",
      "Do not assume every trace failed. A short, ambiguous, or inconclusive trace is not an issue unless the visible evidence establishes a substantive failure.",
      "Return the probability that at least one substantive issue is present. The issue does not need to be named or clustered."
    ]
  },
  "criteria": {
    "true": {
      "definition": "At least one substantive problem is supported by evidence in the trace.",
      "examples_of_qualifying_evidence": [
        "The assistant contradicts an applicable system instruction or a tool result.",
        "The assistant makes an unsupported factual or operational claim.",
        "A required tool action, transfer, booking, cancellation, follow-up, or confirmation is missing, incorrect, repeated, or falsely claimed as complete.",
        "The assistant materially misunderstands or leaves an explicit user request unresolved.",
        "Customer-facing text exposes internal actions, placeholders, or broken content that materially harms the interaction."
      ]
    },
    "false": {
      "definition": "No substantive assistant problem can be established from the visible trace.",
      "do_not_count_as_an_issue": [
        "A minor stylistic preference with no meaningful effect.",
        "A failure caused only by the customer's behavior.",
        "Internal tool metadata that was not exposed to the customer and did not cause an incorrect response.",
        "A hypothetical concern that requires information outside the trace.",
        "Insufficient evidence or an inconclusive conversation."
      ]
    }
  }
}
Footnotes
- Versions tested: Jev 1.13 (announced September 15, 2026), Perplexity Decider 1.1 27B, Liquid d1 and d1-ultra, Cloudflare Clef Flash, and OpenAI Decisions. OpenAI Decisions uses GPT-6 Luna. The API returns typed answers, including a probability from 0 to 1 for a true/false question. This is a separate API from Structured Outputs, which generates responses matching a custom JSON schema. We include it because it serves the same classification task.↩︎
- An LLM judge uses a prompt to evaluate an AI system’s output or behavior. We recommend asking it for a binary pass/fail decision about a specific failure mode. This encourages clear criteria and makes it easier to compare the judge’s decisions with human labels.↩︎
- We scored 98 production traces after excluding two internal QA examples from the 100-trace dataset. The frozen reference contains 61 known failures and 37 traces without a labeled failure: 39 failures from the original human review plus 22 discoveries from Braintrust and Arize that we manually validated. Models received masked traces without human labels or reviewer notes. Perplexity, Liquid, Clef Flash, and OpenAI received the same instructions and serialized inputs; Jev received equivalent criteria through its structured API. The original conversations are private.↩︎
- API cost covers 100 eval runs, one per trace. We use Liquid’s prices as of October 17, 2026, $0.02 per million input tokens for d1 and $0.042 for d1-ultra. The experiment recorded d1 at $0.04; we have repriced its saved token usage. Other models use the rates in the experiment’s operational metrics. Performance excludes two internal QA traces. Threshold tuning uses saved scores and requires no additional model calls.↩︎
- Latency depends on how you batch or parallelize requests, your arrangement with the vendor, and your distance from its infrastructure, among other factors. Batching and concurrency can also change cost and throughput. See TypeSafe’s multi-question requests and client performance guidance. Its launch discussion also notes the location of its latency tests relative to its service. Mean response times were 4.33 seconds for Jev, 7.85 for Perplexity, 7.38 for Liquid d1, 1.56 for Liquid d1-ultra, 2.09 for Clef Flash, and 2.77 for OpenAI. These came from separate runs and do not establish comparative throughput or tail latency.↩︎
- These examples illustrate how the consequences of mistakes affect the tradeoff. In U.S. criminal trials, proof beyond a reasonable doubt sets a high bar for conviction. In cancer screening, a missed case can delay care, while a false alarm can lead to anxiety and unnecessary procedures. A positive screening result usually requires further testing. The NCI explains both risks; the appropriate balance depends on the screening test and population.↩︎
- The density plots show unconstrained F1 tuning, before we introduce minimum precision and recall requirements. The later comparison charts apply those requirements to candidate models where feasible. All use the same five-fold cross-validation splits. Thresholds were chosen on training traces, and precision, recall, and F1 were measured on separate traces. We average those measurements across repeated splits. In the optimized density plots, the dashed line shows the average selected threshold. The displayed scores come from the individual splits, rather than applying that average threshold to the full dataset. The density curves use Gaussian smoothing with bandwidth 0.07 and reflection at 0 and 1. Each class has an area of one. Smoothing affects only the display.↩︎
- A precision-recall curve plots precision against recall as the decision threshold changes. It shows the tradeoffs available for a model across thresholds. Scikit-learn’s precision-recall guide explains how to read and plot these curves.↩︎
- We identify candidates from the full-sample precision-recall curves. In each training split, we choose the highest-F1 threshold among those reaching at least 80% precision and 80% recall. When no threshold qualifies, we use the unconstrained F1 optimum and record the split as infeasible. This occurred in 36 of 100 training splits for Perplexity and 29 for Liquid d1-ultra, and never for OpenAI. Non-candidates always use unconstrained F1 tuning. We keep all validation predictions, including those from fallback splits, in the reported averages. The minimums apply during selection and do not guarantee the same performance on new examples. The threshold-selection audit records each split without trace IDs.↩︎
- A calibrated failure probability of 0.80 means that, among many examples receiving scores near 0.80, roughly 80% contain failures. Platt scaling and isotonic regression use labeled examples to learn an adjustment from model scores to probabilities. Platt scaling fits a sigmoid curve. Isotonic regression fits a more flexible mapping that preserves score order, but is more prone to overfitting with small datasets. Neither guarantees improvement on new examples. Scikit-learn’s probability calibration guide explains both methods and how to assess them.↩︎
- The reliability chart groups each model’s scores into five groups of 19 or 20 traces, sorted by probability. The adjusted scores are each trace’s mean out-of-fold probability from the saved cross-validation results. We fit Platt scaling to the log-odds of the original probabilities. Each mapping is fitted without the traces it predicts. The chart summarizes this small sample and does not establish an exact failure rate for a future trace. The plotted calibration results are available as JSON.↩︎
- On the saved out-of-fold probability summaries, Jev’s Brier score was 0.187 before adjustment and 0.188 afterward. Liquid d1-ultra’s was 0.173 and 0.172, while OpenAI’s was 0.159 and 0.164. Brier score measures average squared probability error, so lower is better. It reflects discrimination as well as calibration. These results describe the log-odds Platt fit shown in the chart. An exploratory refit directly on probabilities, using the same folds, gave OpenAI a Brier score of 0.154. This illustrates sensitivity to the fitting method. It does not establish which method will work best on new data.↩︎
- GEPA uses feedback from model runs to propose prompt revisions and test them against labeled examples. It retains candidates with different strengths, so a prompt that helps a difficult example can remain in consideration. Incorrect labels can steer this search toward the wrong changes. Keep a separate test set outside prompt development for the final check. In our small manual Jev experiment, F1 at the default threshold rose from 0.78 with a simple prompt to 0.80 with a checklist of failure types. That experiment did not use GEPA or establish how much systematic optimization would help. Our FAQ on choosing an eval model discusses prompt optimization and model comparison.↩︎