Karpathy:让 AI 把复杂问题讲清楚的四种方法
从简明文字到交互网页和定制视频,深入解释如何让 AI 的输出变成可理解、可判断的结果。
AI 干得更多,我们怎样看懂它的结果?
随着 AI 输出的内容越来越长、涉及的代码或技术论述越来越复杂,读者需要耗费大量时间去梳理文本脉络、辨析代词指代并核验逻辑。
针对这一痛点,Andrej Karpathy 在原帖中提出了一个前瞻判断:随着 AI 自主承担越来越多的基础执行工作,人类的工作重心将转向监督与理解,我们将花多得多的时间去努力弄懂 AI 的输出。本文所引用的六段英文均为该原帖的关键摘录。

Karpathy 原帖要点译文(节选)
- 写作:我试过一个有效的做法:让你的 AI 用 ASD-STE100 规范解释某件事。
- 图解/图像:与其写文字,不如让你的 AI 画一张图。图解可能更容易处理、解析和理解。
- 网页:要求“以 HTML 格式”输出,得到一个美观、可交互的网页。
- 讲解视频:我最看好的输出形式,是针对任意主题生成完全定制的讲解视频。
他在原帖最后总结道:
- 随着 AI 越来越强,它们会自主完成越来越多的基础执行工作,而我们的更多工作会转向更高的抽象层次——监督与理解。
- 幸运的是,AI 在这方面也能帮忙。随着智能与代码越来越充裕,你可以要求它生成规模可观、按需定制、用完即可丢弃的软件产物,例如网页应用和讲解视频。这些东西在过去可能根本不值得专门制作。多试着突破现有用法,你会感到惊讶。
下面从最容易直接使用的文字方法开始,逐一展开这六个理念背后的机制、用法与具体案例。
1. 用清楚的语言,减少读者猜意思
原文摘录:Ask your LLM to explain something in ASD-STE100
中文译文:让你的 AI 用 ASD-STE100 规范解释某件事。
1. 深入解释:为什么只说“简单一点”还不够?
当我们觉得 AI 输出晦涩时,通常会习惯性追问“请再解释得通俗简单一点”。这句话没有说明你卡在哪里,也没有给出具体的改写规则。原因在于,“通俗”或“简单”是非常主观且缺乏操作边界的抽象要求。AI 可能把“简单”理解为删掉细节,也可能改用比喻。文字变短、听起来亲切,并不代表条件和因果已经讲清。
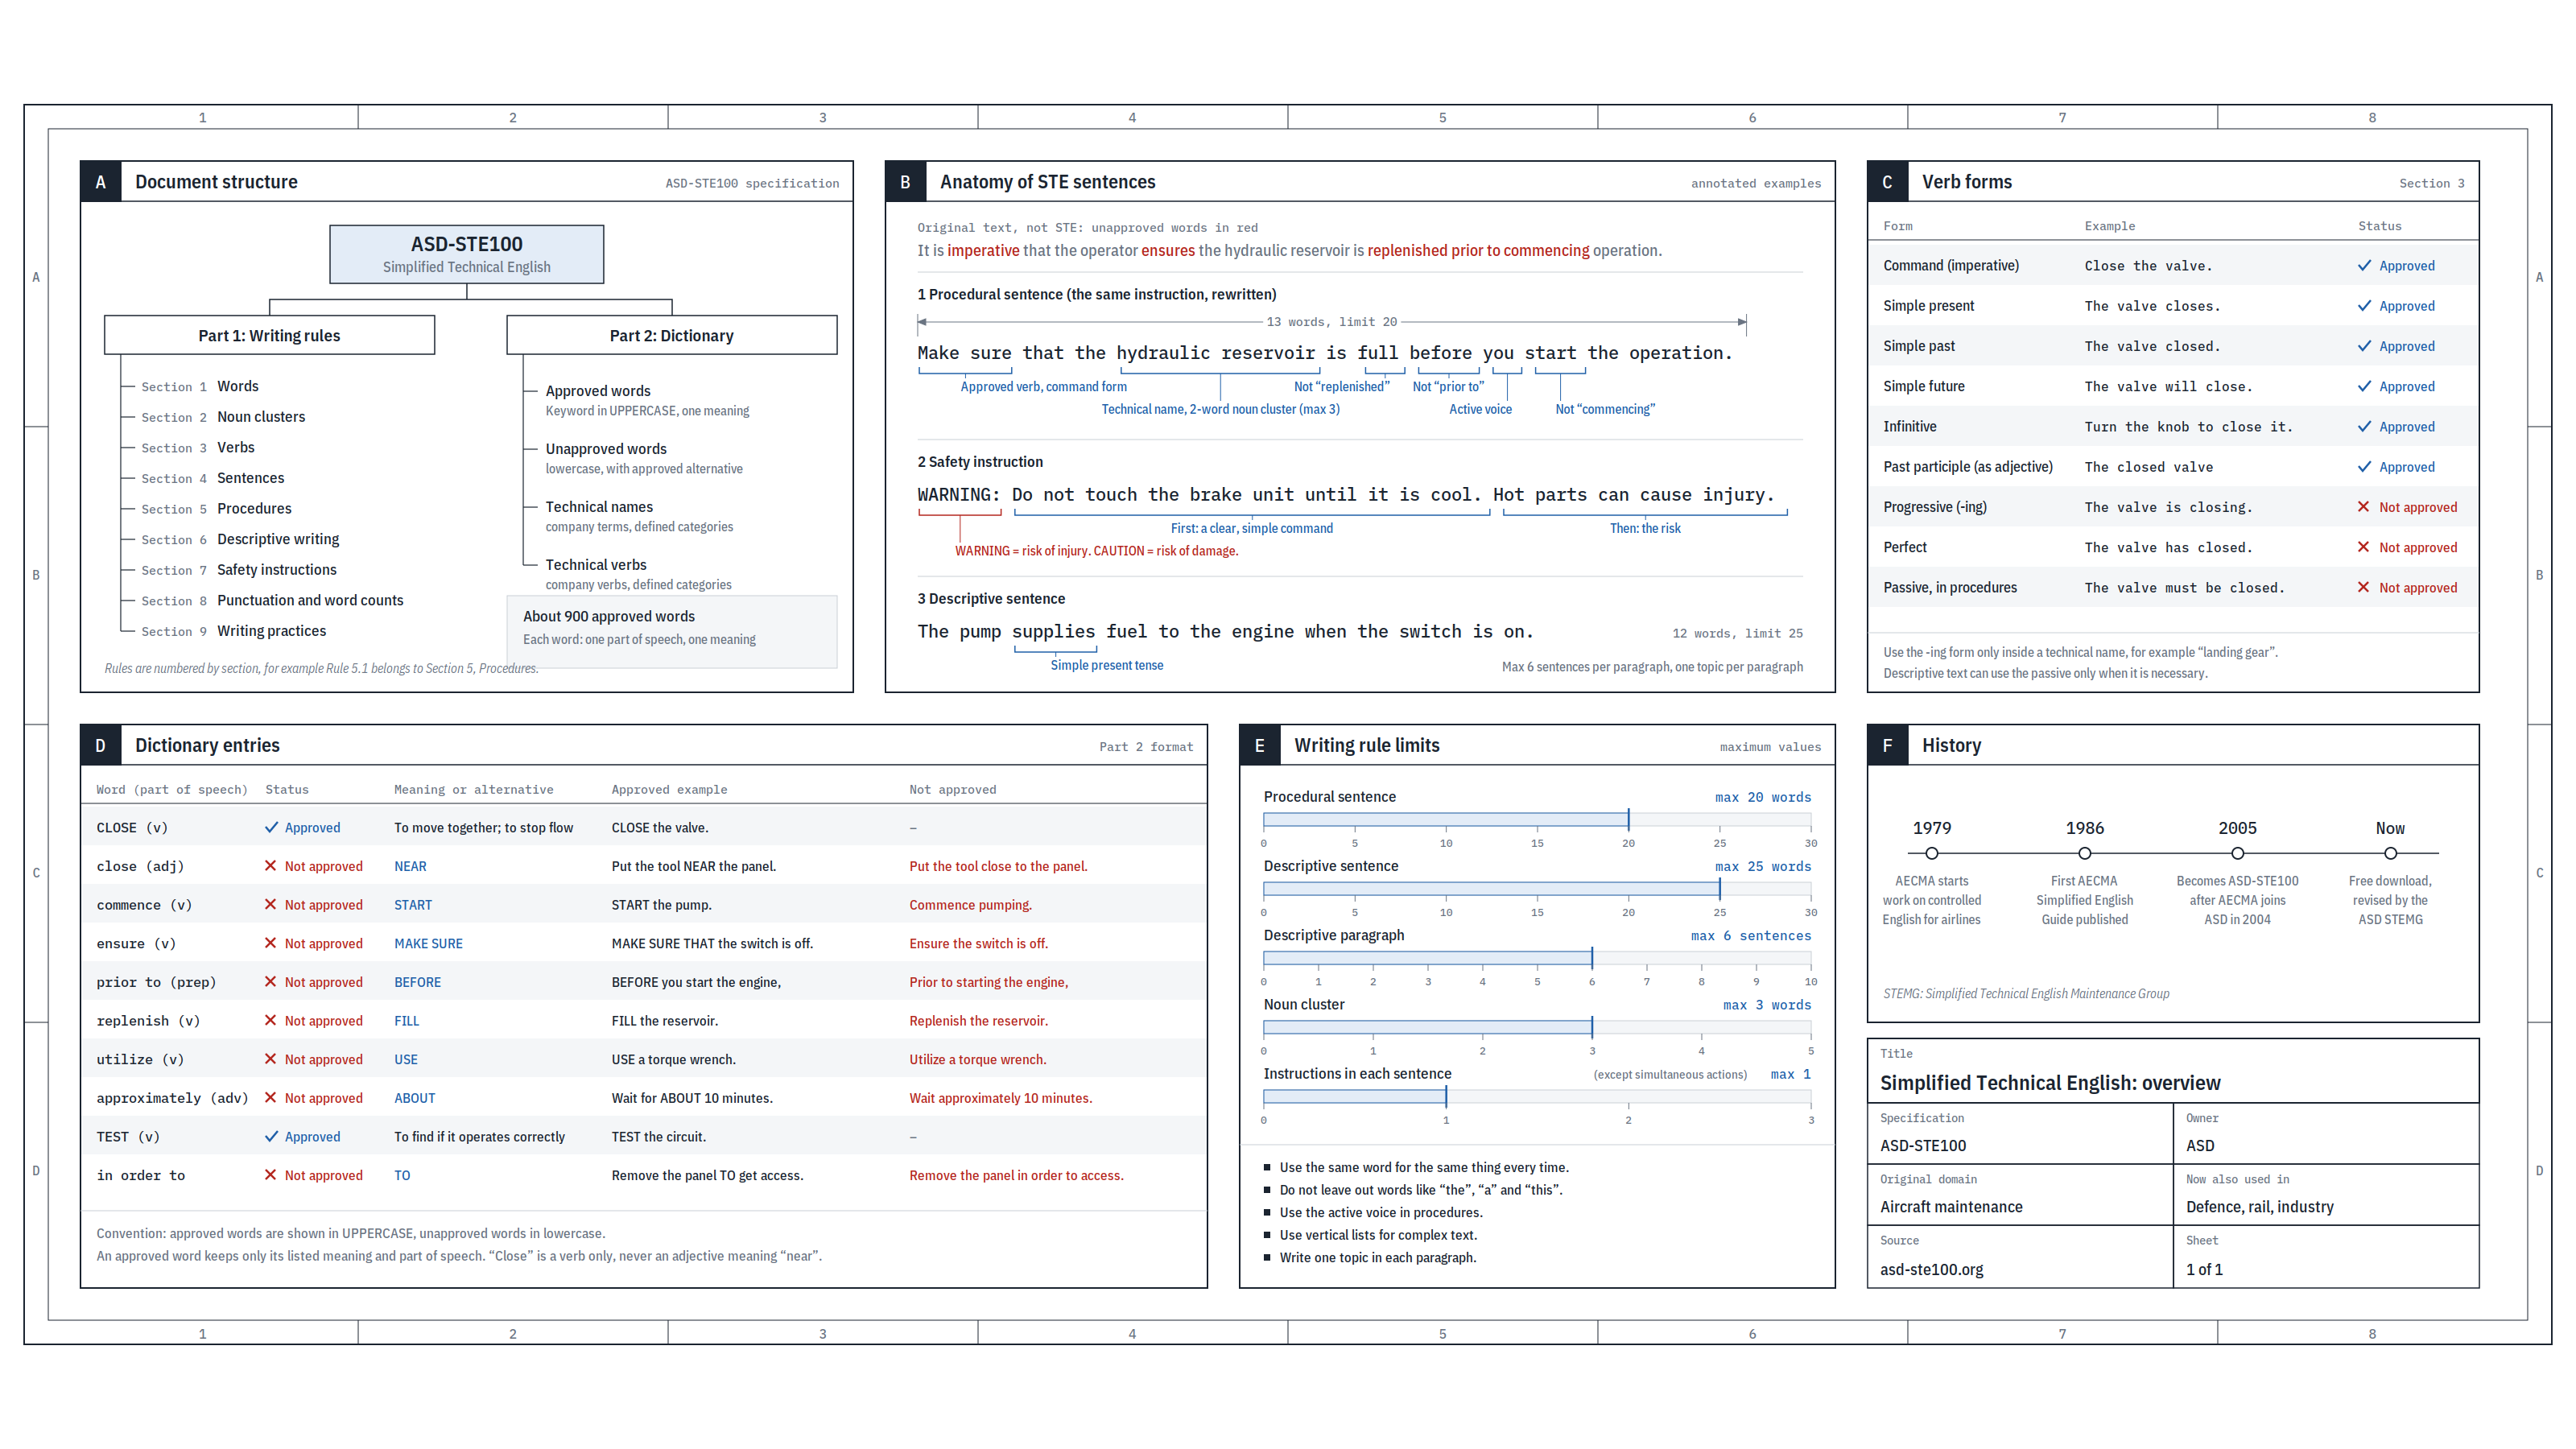
相比之下,给 AI 一套具体的写作规则,能让它知道该怎样改。Karpathy 推荐的 ASD-STE100 最初是航空工业为维护文档制定的受控自然语言国际标准。Karpathy 说 AI 熟悉这种规范,他自己用它获得了更易读的解释。比起只要求“通俗”,指定规范给出了词汇和句子结构上的明确约束;输出后仍需检查事实与步骤有没有写错。

背景补充:ASD-STE100 的核心机制
ASD-STE100(Simplified Technical English,简化技术英语)由受控词典与写作规则两部分组成:
- 同词同义与固定词性:通用词典中核准词通常仅保留单一含义与批准词性(例如
close只能作动词“关闭”,不能作形容词“接近”),减少多义词带来的猜测。- 限制句长与单句指令:程序性指令原则上不超过 20 词,描述性句子原则上不超过 25 词;一句话通常只表达一条指令,同时发生的动作可以合写。
- 主动语态:程序性文本直接写出动作,让读者知道要做什么。中文操作说明还可以把条件放在动作前,例如“网络恢复后,重试一次”,方便先判断条件。
- 保留技术事实:受控规范绝不是删去技术事实,而是在通用词汇之外,允许按规则使用专业技术名词与技术动词。
短句的核心目的是减少读者在长句中对主谓宾嵌套与从句修饰的猜测,不能为了凑字数,删掉动作成立的条件和必要的技术事实。
2. 关键辨析:理解与应用的边界
- “80%”是口语化调优,不是标准版本:Karpathy 提到若觉得 STE 规范过于严苛生硬,可要求达到其八成水平。这是他尝试用来放宽限制、兼顾表达流畅度的提示方式,标准本身并没有 80% 的合规档位。
- 中文借鉴的是组织原则,而非套用英文词典:ASD-STE100 是针对美式英语建立的词汇与语法体系,中文语法机制完全不同。中文实践中应当吸纳其“短句、主动语态、一事一句、条件前置”的思维,而不是机械宣称中文符合该国际标准。
3. 具体展示案例:操作文档改写对比
以下为本篇制作的假设案例。
- 提示词参考:
借鉴 STE 原则,在中文环境中可以这样提示 AI:“请用简明技术说明风格改写以下操作指引。要求:1. 一句话只表达一个事实或动作;2. 使用主动语态祈使句;3. 步骤的前提条件必须放在动作前面;4. 保持因果逻辑与事实完整,删除多余客套修饰。”
场景:改写网页文件上传失败的处理流程
- 【改写前:冗长版本】
“当用户在前端界面执行文件上传操作却遭遇系统报错提示上传失败的时候,第一步应当先对本地设备的网络连接通畅情况进行排查确认。为了避免向后台服务器发送多余请求并加重系统阻塞负担,用户切记不要在短时间内连续反复地点击提交按钮。一旦确认本地网络已经完全恢复正常,可以尝试重新点击提交按钮进行一次重试。如果在此之后文件依然无法顺利完成上传,请务必将界面弹出的具体错误代码完整截屏或复制保存下来,随后联系技术支持团队以获取进一步协助。”
- 【改写后:清楚版本】
- 上传失败时,先检查本地网络连接。
- 不要重复点击提交按钮。
- 网络恢复后,重试提交一次。
- 如果上传仍然失败,保存错误代码并联系技术支持。
对比分析: 改写后的文本没有删去任何操作前提,而是严格落实了“先判断条件再行动”。例如第 3 步“网络恢复后,重试提交一次”,如果丢失了前半句条件,直接写成“重试提交”,读者就可能在网络尚未恢复时继续提交。句子短了,操作逻辑却丢了。“条件前置”确保读者每次执行动作前都先核实环境是否允许,读者因此更容易找到该做的动作,同时保留了原有处理顺序。
2. 把关系画出来,少在脑中拼流程
原文摘录:Instead of writing, ask your LLM to create a diagram.
中文译文:与其让 AI 写文字,不如让它画一张图。
1. 深入解释:为什么图表有助于理解?
当技术内容涉及多模块协作、数据流向或先后次序时,读者需要边读边记住每个模块,再自己把它们连接起来。读到后面,还得回头确认前面哪个节点与它有关。Karpathy 指出,与其让 AI 输出大段文字,不如让它生成一张图表,因为图形结构在视觉上能直接呈现模块间的关联,更容易被解析与理解。
解释型图表的价值,在于保留关键的处理分支、汇合节点与流转方向。在实践中,可以让 AI 直接生成 Mermaid 流程图或 SVG 架构图。
2. 具体展示案例:AI 检索增强生成(RAG)流程
以下为本篇制作的假设案例。
- 提示思路:
借鉴原帖思路,在中文环境中可以这样提示 AI:“请用 Mermaid 流程图展示 AI 检索增强生成(RAG)的运行流程。标明用户提问、检索、重排、上下文合并与 AI 回答等环节,展示数据流向。”
RAG 运行机制与图表透视
在查看图表前,先通过简明逻辑理清 RAG 的核心链路:
- 检索:用户提出问题后,系统在知识库中搜索可能相关的参考文档片段。
- 重排:初筛片段的相关程度可能不同,重排模块对片段相关性重新打分,选出最贴近问题的高质量片段。
- 问题与片段合并:将原始问题与筛选出的背景片段装配在一起,构成一段包含外部参考资料的提示词。
- 生成回答:AI 阅读带有上下文的完整提示词,据此生成答案。
流程图中展示的“从 20 个召回片段中重排筛选出 3 个片段”仅为教学示意用的假设配置,并非固定工程标准。
问题与资料在这里汇合
原始问题保留到装配环节,并非只剩检索数字。箭头表示资料流转;有资料可用仍需核对回答是否正确。
读者从图上能发现什么?
顺着图看,尤其要分清两件事:原始问题要保留,检索得到的材料也要送入最终提示词。它们的用途不同:
- 原始问题告诉 AI 用户究竟在问什么,装配提示词时仍然保留;
- 检索环节使用问题的表示去找资料,重排筛选片段,再把片段与原始问题合并。示意配置是从 20 段中保留 3 段。
把各阶段摆在一起后,读者可以顺着流程追问:如果最终回答出错,究竟是初始检索没搜到(召回环节缺口)、重排把对的片段漏掉了(排序失真),还是资料已经送进去,AI 却没有正确利用?图表能提示检查哪个环节;确定原因,还需要查看实际输入和输出。
3. 让读者改变条件,看见结果如何变化
原文摘录:Ask for output "in HTML"
中文译文:要求 AI 以 HTML 格式输出。
1. 深入解释:让软件成为辅助理解的交互工具
Karpathy 给出的第三个技巧是直接要求 AI 输出 HTML,也就是网页代码。他认为 AI 越来越擅长前端开发,可以制作包含控件、动画与交互的页面。HTML 决定内容结构,CSS 负责外观,JavaScript 可以把读者的操作与计算结果连起来。
静态文本只能单向陈述“如果 A 变化,B 就会变化”;而包含滑块、输入框的交互式网页,允许读者自己动手调整参数,实时看到输出随输入连续变化的因果过程。通过主动探索边界,读者可以对照同一算法在不同条件下的行为。
2. 具体展示案例:交互网页的设计与逻辑
以下演示使用假设分数,按明确公式计算。
- 提示词参考:
借鉴原帖思路,在中文环境中可以这样提示 AI:“请输出 HTML(含 CSS 与 JS),制作一个通俗解释温度参数(Temperature)如何影响 AI 选词概率的交互页面。要求:1. 顶部提供 Temperature 滑块(范围 0.1 到 2.0);2. 展示候选词‘公园、散步、图书馆、火星’在假设 logit 分数 [3, 2, 1, 0] 下的概率柱状图;3. 拖动滑块时根据公式实时更新各词概率与说明。”
交互组件形态与工作过程演示
-
数学公式与计算基准:
假设 AI 在当前语境下对四个候选词生成的原始打分(logit 分数)分别为:公园 z₁ = 3、散步 z₂ = 2、图书馆 z₃ = 1、火星 z₄ = 0。系统通过带温度参数的 Softmax 公式计算每个词的选取概率:
pᵢ = exp(zᵢ / T) ÷ Σ exp(zⱼ / T),其中 exp 是指数函数,分母将四个候选的数值相加,让概率总和为 1。
请注意:这里的原始分数为教学假设值,演示重点在于算法变换机制,而非真实 AI 的实际预测概率。 -
固定输入下追踪计算差异:
在交互设计中,四个词的原始打分被严格固定,唯一发生变动的变量是温度滑块 T。读者通过滑动滑块,可以清晰追踪“输入参数 → 公式计算 → 概率分布”的完整差异:- 当滑块拉至 T = 0.1 时:小温度让原始分数差在除以 T 后变大,再经过指数计算,概率差距被进一步放大,各词概率分别约为:公园 99.995%、散步 0.00454%、图书馆 0.000000206%、火星 0.00000000000936%。下方说明显示:概率分布极度陡峭,几乎总会选中最高分候选词。
- 当滑块拉至 T = 1.0 时:得到 T=1 时的基准概率分布,分别约为:公园 64.39%、散步 23.69%、图书馆 8.71%、火星 3.21%。
- 当滑块拉至 T = 2.0 时:较大的温度平滑了指数差距,各词概率分别约为:公园 45.51%、散步 27.60%、图书馆 16.74%、火星 10.15%。低分词的入选几率明显上升。
-
读者如何从比较中建立理解:
只看公式时,读者可能知道“要除以 T”,却不知道这一项会让结果怎样变化。而在交互演示中,通过固定基准分数、连续拖拽滑块,读者能亲眼目睹柱状图从“极度悬殊”逐渐变得平缓。这让读者切实体会到:温度参数本身并不给 AI 注入新知识或改变打分排序,它改变的是各候选被选中的机会:温度越高,低分候选也越有机会。此外,T=0 时公式不能直接计算;当 T 从正值逐渐接近 0,最高分候选的概率趋近于 1(工程中通常退化为贪心选取最高分词);高温不等于凭空捏造,低温也不保证答案正确。
改变温度,观察同一组候选词
示意分数:公园 3、散步 2、图书馆 1、火星 0。仅演示四个候选,非真实模型输出。
概率 = exp(分数 ÷ T) ÷ 所有候选的 exp(分数 ÷ T) 之和。
候选按分数分配概率;最高分仍占优势。
更高温度使概率分布更平坦;它不补充知识,也不保证答案正确。关闭脚本时保留 T=1 的数值。
4. 用定制视频,把变化过程展开给人看
原文摘录:fully custom / bespoke explainer videos generated on any arbitrary topic
中文译文:针对任意主题生成完全定制的讲解视频。
1. 深入解释:从静态阅读到动态演化
在所有输出形式中,Karpathy 表示他最看好的是针对任意主题生成完全定制的讲解视频。他在原帖中介绍了具体实现思路:指示 AI 制作 3Blue1Brown 风格的主题讲解视频,使用 ElevenLabs 密钥进行旁白配音,或者让 AI 寻找利用本地算力的免费替代工具。Karpathy 认为这一方向已经开始行得通,并极具探索价值。
3Blue1Brown(常缩写为 3b1b)是用动画解释数学的科普频道。这里借鉴的是用画面展示数学关系的讲解方式。
要把这一想法做成可以播放的影片,自动生成视频包含多个串联环节:确定要解释的关系、编写分镜脚本、生成几何动画代码、渲染画面、合成语音旁白并对齐字幕。视频的关键价值在于,它能将抽象的数学推导表现为可以观察的连续变化。
2. 具体案例:点积为什么会变成负数?
本篇用 Claude Code 中的 Opus 5.5 制作了一段约 63 秒的数学示意视频,配上豆包“刘飞”音色的中文旁白。它把连续转动、投影和数值放在同一画面里,展示点积怎样变成负数。固定向量 A=(2,0),向量 B 长度为 1;B 在水平方向的带符号投影为 cosθ,乘上 A 的长度 2,得到点积 2cosθ。
- 原帖方法中文转述:
制作 3Blue1Brown 风格的主题讲解视频,使用 ElevenLabs 密钥进行旁白配音,或寻找本地免费替代方案。 - 中文提示词参考:
“请为我设计一段一分钟左右的 3Blue1Brown 风格数学动画短片脚本,通俗解释【主题:二维向量点积的几何意义】。要求:以固定向量 A=(2,0) 和长度为 1 的转动向量 B 为例,展示 B 在 A 方向的带符号投影乘以 A 的长度(2cosθ);按照时间轴拆解画面几何变化与对应的口语解说词。”
视频中发生了什么?
| 时间(约) | 画面变化 | 对应含义 |
|---|---|---|
| 0–7 秒 | B 从锐角转到钝角,投影和数值同步变化 | 先看到点积可以由正变负 |
| 7–19 秒 | 标出 A 的长度 2、B 的长度 1,显示水平投影 | 点积等于带符号投影乘以 A 的长度 |
| 19–25 秒 | A 和 B 同向,右侧对照表亮起 0° | 投影为 1,点积为 2 |
| 25–29 秒 | B 转到 60°,投影缩短到一半 | 点积为 1 |
| 29–34 秒 | B 转到 90°,投影缩到原点 | 点积为 0 |
| 34–48 秒 | B 越过 90°,再转到 120°,投影落到负半轴 | 投影为 -0.5,点积为 -1 |
| 48–53 秒 | B 转到 180°,两向量完全反向 | 投影为 -1,点积为 -2 |
| 53–63 秒 | 再扫过同向、垂直和反向,保留对照表 | 把方向与点积正负连起来理解 |
连续变化与同步讲解怎样帮助理解?
静态图通常只能展现某个孤立角度下的切片投影,读者即使记住公式 A·B = |A||B|cosθ,也未必知道负号从哪里来。而在连续视频中:
- 逐帧显示负号的由来:当向量 B 旋转越过 90 度时,它在水平轴上的投影经过原点,随后落在负半轴。“投影落在左侧”与“数值小于零”出现在同一个过程中,读者可以把方向与负号联系起来。
- 旁白、字幕与画面对应:讲到 120 度时,画面显示投影 -0.5,点积为
2 × (-0.5) = -1。旁白解释为什么变负,字幕保留关键数值,图形显示位置变化。读者无需一边读完一段文字,一边另找图中的对应状态。点积的具体含义取决于向量代表的对象。
怎么选:取决于你卡在哪一步
1. 媒介选择取决于具体认知任务
Karpathy 在原帖中连续使用递进修辞,展现了从文字到视频的表达潜力。但在实际应用中,不同媒介各有所长,并不存在适用一切场景的万能方案:
- 受控文本(STE 规范):查阅迅速、检索直接,适合排查错误、接口定义与安全操作规程,读者无需等待播放。
- 结构图表:直观呈现模块关系、时序与分支拓扑,便于读者在头脑中建立全局架构。
- 可交互网页:适合多变量探索与参数动态响应,读者通过亲手调节输入观察输出变化,建立因果直觉。
- 动态视频:适合展现连续运动与几何演化过程,但线性时间轴导致倒查与信息定位成本相对较高。
5. 人的重心转向监督,理解决定你能检查什么
原文摘录:oversight and understanding
中文译文:监督与理解。
1. 深入解释:为什么“能运行”不等于“业务正确”?
Karpathy 指出的核心趋势是:随着 AI 能力不断增强,基础的编写与执行工作将越来越多地由 AI 自主完成,人类的工作重心会更侧重监督与理解。
一个退款按钮可以正常点击,请求也可以发送成功,仍可能出现多退一次、金额超限或把未知状态当成失败的问题。界面正常只证明了一部分行为。AI 需要明确的业务要求,你也需要知道哪些条件必须成立,才能检查它的实现有没有满足要求。你对业务规则的理解深度,直接决定了你能设计出怎样的测试用例去检验 AI 的产出。例如不理解“超时后结果未知”,就可能只测试成功与失败,漏掉最需要处理的中间状态。
2. 具体案例:电商网站退款功能的实现与审核
以下为教学假设案例,不接入真实支付,亦非原帖原有案例。
当要求 AI 快速生成一套退款界面的前后端处理逻辑时,你可以让 AI 编写表单、校验和请求处理代码,再依据具体业务规则检查三个场景:
- 防止同一订单重复退款:
- 测试输入:对已完成全额退款的订单,再次点击发起退款。
- 业务要求:服务端应依据已确认的退款记录拦截重复申请,返回“订单已退款,不可重复提交”,仅把前端按钮置灰不足以处理重复请求;服务端也要防止同时到来的请求重复执行。
- 退款金额上限与部分退款校验:
- 测试输入:某订单实付金额为 100 元,输入退款金额 120 元;或在已退款 60 元后,再次申请退款 50 元。
- 业务要求:系统必须校验累计退款总额不得超出实付总额,拦截超额退款并提示错误。
- 网络超时下的状态一致性与请求标识:
- 测试输入:向支付网关发送退款请求时模拟网络超时(未收到明确响应)。
- 业务要求:网络超时意味着“结果未知”:对方可能已经退款,只是响应没回来。系统应保留这笔退款的唯一业务标识,将状态设为“处理中/待对账”,再按支付服务的接口规则查询结果。需要重试时,也要按接口规则复用同一请求标识,避免把重试当成新的一笔退款;这需要服务端与支付接口共同支持。
在这个过程中,AI 承担了写代码的执行活,而人通过明确规则、设计边界输入、核对实际结果完成监督。你理解的越具体,测试就越能指出“哪里不对、应该改成什么”。
6. 为一次理解制作软件,用完就可以丢弃
原文摘录:large, custom, discardable software artifacts
中文译文:规模可观、按需定制、用完即可丢弃的软件产物。
1. 深入解释:为什么一次性软件在过去不切实际,现在值得尝试?
过去,为一次决策专门制作软件,往往要考虑投入是否值得:想清需求、写界面、实现计算、调试和交付,都要花时间。任务只做一次时,手算或表格可能更合算。
Karpathy 看重的变化是:代码更容易生成后,一些过去不值得专门开发的工具,现在值得尝试。你可以围绕眼前的问题提出需求,让 AI 制作适合这一次任务的网页或讲解视频。软件的价值可以来自它帮助你看懂一个问题,而不一定来自长期使用。这里的“规模可观”也说明,临时工具可以承载较多内容和交互;“用完可弃”说的是使用寿命,开发和核对仍然需要投入。
2. 具体案例:活动场地 A/B 方案的成本比选
以下为教学假设案例。
某团队需要为一场活动在两个备选场地中做决策,但最终参会人数尚未完全确定:
- 场地 A:固定场租 1000 元,每人费用 80 元,总成本公式为
1000 + 80x。 - 场地 B:固定场租 4000 元,每人费用 50 元,总成本公式为
4000 + 50x。
为了帮助决策,可以让 AI 生成一个临时的双方案成本对比网页:
- 当人数为 50 人 时:场地 A 为 1000 + 80 × 50 = 5000 元,场地 B 为 4000 + 50 × 50 = 6500 元,场地 A 便宜 1500 元。
- 当人数为 100 人 时:场地 A 为 1000 + 80 × 100 = 9000 元,场地 B 为 4000 + 50 × 100 = 9000 元,两者费用完全相同。
- 当人数为 150 人 时:场地 A 为 1000 + 80 × 150 = 13000 元,场地 B 为 4000 + 50 × 150 = 11500 元,场地 B 便宜 1500 元。
为这一次活动算场地费用
假设报价:A 固定 1000 元,每人 80 元;B 固定 4000 元,每人 50 元。只比较这些费用。
A: 元
1000 + 80 × 人数
B: 元
4000 + 50 × 人数
100 人时,两家费用相同。
50 人:A 5000 元,B 6500 元。150 人:A 13000 元,B 11500 元。容量、交通、取消条款需另查。
如何从结果理解决策边界?
这个临时小工具直观展示了双方的费用平衡拐点(100 人):在人数少于 100 人时场地 A 费用更低,多于 100 人时场地 B 费用更低。这个结果回答了费用问题。要选场地,还需结合其他条件:
- 如果团队预估到场人数在 90 到 110 人 的波动区间内,结论会随人数轻微变动而发生逆转;
- 如果实际人数可能跨过 100 人,便宜的一方也会改变。还应查看容量、交通和退订条款:场地容不下人或不能满足活动需求,费用再低也不适合。
做完这次场地评估后,这个网页就可以直接关闭丢弃,无需维护。“用完即弃”是指软件的使用寿命仅针对单次任务,并不等于其中的逻辑可以偷工减料;背后的数学边界与输入前提仍然需要人工严格核查。
可以直接复用的提示词
| 目标维度 | 提示思路中文转述 | 中文提示词参考 |
|---|---|---|
| 文本极简克制 | 建议使用 ASD-STE100 规范或要求达到其八成水平 | 请用借鉴 ASD-STE100 原则的技术说明风格解释【主题】。要求:一句话只讲一个事实或动作,使用主动语态,前置条件放在动作前,保持因果完整,删除客套修饰。 |
| 结构关系图表 | 与其让 AI 写文字,不如让它输出结构图表 | 请不要使用大段文字,用 Mermaid 流程图直观展示【主题】的核心结构与数据流向,标明各处理节点与先后流转关系。 |
| 参数交互网页 | 直接要求以 HTML 格式输出交互网页 | 请输出 HTML 制作一个交互页面,用来解释【主题】。提供参数滑块或控制项,让我通过操作实时观察计算结果或图形变化。 |
| 定制视频讲解 | 制作 3Blue1Brown 风格的主题讲解视频,使用语音配音 | 请为【主题】设计一份 3Blue1Brown 风格的动画短片方案,输出逐镜头分镜脚本(包含几何图形动态演化与旁白口语解说),并附核心代码框架。 |
Karpathy:让 AI 把复杂问题讲清楚的四种方法
AI 能替我们做更多工作,理解结果仍要花时间。Karpathy 提出四种具体做法:规范文字、画图、生成交互网页、制作定制视频。选择取决于你卡在哪里。
把理解难点,变成合适的表达
01 / WRITING文字难懂
→ 写清楚
原帖建议让 AI 按 ASD-STE100 解释。这套简化技术英语规范用受控词汇与句子规则减少歧义。
① 检查网络。② 不要连续点提交。③ 网络恢复后,重试一次。④ 仍失败时,记录报错。
02 / DIAGRAM关系难追
→ 画出来
原帖建议让 AI 画图。把阶段与连接同时摆出来,读者就不必在脑中重新拼流程。
03 / HTML变化难想
→ 动手调整
原帖建议要求“以 HTML 格式”输出。网页可把输入控件与计算连起来,让你改一个条件、立即看结果。
T=0.1:最高分词概率约 99.995%。
T=2.0:最高分词约 45.51%,低分词机会增加。
04 / VIDEO过程难看
→ 连续展示
原帖最看好按主题定制讲解视频。画面、旁白与字幕同步,能把变化过程展开给人看。
夹角 60° → 水平投影 0.5 → 点积 1。
夹角 90° → 投影 0 → 点积 0。
夹角 120° → 投影 −0.5 → 点积 −1。
总结一:人的重心转向监督与理解
Karpathy 判断,AI 越来越强后,会自主承担更多基础执行工作。人需要看懂结果,才能检查它是否满足要求。
检查重复申请是否被服务端拦截;累计退款是否超过实付;网络超时是否被误当成失败。
超时表示结果未知。保留唯一业务标识,标记“处理中/待对账”,按支付接口规则查结果。重试是否复用标识,也要符合接口规则。
总结二:软件可以只服务一次理解
代码更容易生成后,过去不值得专门开发的工具,现在值得尝试。为一次决策生成网页,看清边界后就可以关闭。
场地费用假设:A=1000+80n;B=4000+50n,n 为人数。
B 6500 元
A 便宜
B 9000 元
费用相同
B 11500 元
B 便宜
人数跨过 100,便宜的一方就改变。选场地还要核对容量、交通与退订条款。
把解释做成工具,是为了帮助你理解和判断。图表、网页与视频的计算和前提,仍需检查。
四种方法与两条总结来自 Karpathy 原帖;上传、RAG、温度、点积、退款及场地案例均为本篇解释与演示,不是原帖案例。
We'll be spending a lot more time trying to understand the outputs of language models. A few thoughts, tips & tricks:
Writing. Something I've had success with: Ask your LLM to explain something in ASD-STE100, it's a controlled language specification originally developed for aerospace maintenance documentation. LLMs well-versed in this language and it comes with heavy constraints on clean writing style that I often find a lot more readable. Sometimes I've tried to soften it a bit e.g. ask for "80% of the way to ASD-STE100" because the spec is quite stringent. But even better:
Diagrams / images. Instead of writing, ask your LLM to create a diagram. These can be a lot easier to process, parse, and understand. But even better:
Web pages. Ask for output "in HTML" to get a beautiful, interactive webpage. LLMs are getting really good at frontend and can create beautiful experiences, animations, etc. But even better:
Explainer videos. The output format I am most bullish on is fully custom / bespoke explainer videos generated on any arbitrary topic. Experiment with things like "Create a 3b1b style video explainer on X. Use my ElevenLabs API key for audio narration". (you'd need an API key for the latter or you can ask your LLM to find you decent free alternatives that use your local compute). This is actually starting to work!
In summary: - As LLMs get better, they will do more and more of the legwork autonomously, and a lot more of our work will rise up the abstractions into oversight and understanding. - Luckily, LLMs can help here too because as intelligence and code are increasingly abundant, you can ask for large, custom, discardable software artifacts (e.g. web apps, video explainers) that would have never made sense to create before. Push the boundaries here and you'll be surprised.
